1 计算机网络课堂笔记:第一章习题讲解
1.1 R1: 主机 (Host) 与端系统 (End System)
- 问题: “主机”和“端系统”之间有什么不同?列举几种不同类型的端系统。Web 服务器是一种端系统吗?
- 解答:
- 主机和端系统之间没有本质不同,它们是同义词,指的是连接到互联网的计算设备。
- 常见的端系统类型包括:
- 个人计算机 (PC)
- 服务器 (如 Web 服务器、邮件服务器)
- 智能手机
- 平板电脑
- 物联网设备等
- Web 服务器是一种提供 Web 内容的服务器,它连接到网络并运行网络应用程序,因此它是一种端系统。
1.2 R9: 住宅接入技术与速率
-
问题: 拨号调制解调器、HFC、DSL 和 FTTH 都用于住宅接入。对于这些技术,给出每种技术的传输速率的范围,并讨论它们的传输速率是共享的还是专用的。
-
解答:
- Dial-up modem over telephone line (拨号调制解调器):
- 速率范围:大约几十 kbps,通常在 30 kbps 到 56 kbps 之间。
- 特性:通常是专用连接(点对点),但速率很低。
- HFC (Hybrid Fiber Coax, 混合光纤同轴电缆):
- 速率范围:通常提供不对称速率,例如下行可达 30 Mbps 或更高,上行约 2 Mbps 或更高。速率因服务提供商和方案而异。
- 特性:带宽是共享的。同一区域的用户共享同轴电缆部分的带宽。
- DSL (Digital Subscriber Line, 数字用户线路):
- 速率范围:通常提供不对称速率 (ADSL),例如下行可达 24 Mbps 或更高,上行约 2.5 Mbps 或更高。速率受距离电话局的距离影响。
- 特性:通常是用户到电话局的专用线路。
- FTTH (Fiber To The Home, 光纤到户):
- 速率范围:通常提供对称或不对称的高速率,可达几十 Mbps、几百 Mbps 甚至 Gbps 级别 (例如,视频中提到 20 Mbps 仅为一个示例,实际远高于此)。
- 特性:通常是专用光纤连接到用户家中,提供非常高的带宽。
- Dial-up modem over telephone line (拨号调制解调器):
-
补充:
- 移动网络接入技术:4G LTE 可达百 Mbps 级别,5G 可达 Gbps 级别。
1.3 R11: 单交换机存储转发时延计算
- 问题: 假定在发送主机 A 和接收主机 B 之间只有一台分组交换机。A 到交换机以及交换机到 B 的传输速率分别是 和 。假设该交换机使用存储转发分组交换方式,发送一个长度为 的分组的端到端时延是什么?(忽略排队时延、传播时延和处理时延。)
- 场景: 主机 A 交换机 主机 B
- 解答:
- 存储转发意味着交换机必须完整接收整个分组,然后才能开始向下一链路转发。
- 在第一段链路上(A 到交换机)的传输时延为 。
- 在第二段链路上(交换机到 B)的传输时延为 。
- 由于是存储转发,第二个传输必须在第一个传输完成后才能开始(在交换机上)。
- 因此,总的端到端时延(仅考虑传输时延)为 。
- 注意: 此计算忽略了其他所有时延(传播、排队、处理)。
1.4 R12: 电路交换与分组交换,TDM 与 FDM
- 问题: 与分组交换网络相比,电路交换网络有哪些优点?在电路交换网络中,TDM 比 FDM 有哪些优点?
- 解答:
- 电路交换的优点 (相比分组交换):
- 资源预留: 为通信双方预留专用的端到端带宽和资源。
- 性能保证: 一旦电路建立,可以保证恒定的传输速率和时延(如果发送速率不超过预留带宽),性能稳定可预测。适用于对实时性要求高的应用(如传统电话)。
- TDM (Time Division Multiplexing, 时分复用): 将时间划分为固定长度的帧,每个帧内再划分为固定数量的时隙,每个连接周期性地获得一个时隙来传输数据。
- FDM (Frequency Division Multiplexing, 频分复用): 将链路的总频带划分为多个较窄的频段,每个连接分配一个专用的频段进行传输。
- TDM vs FDM: 视频中未详细展开 TDM 相对于 FDM 的优点,但通常认为 TDM 在数字系统上实现更简单,抗干扰性可能更好,而 FDM 更适用于模拟信号。实现上,TDM 需要同步,FDM 需要防止频率干扰。
- 电路交换的优点 (相比分组交换):
1.5 R13: 电路交换与分组交换的用户容量及排队分析
- 问题: 假定用户共享一条 2Mbps 链路。每个用户传输时以 1Mbps 速率连续传输,但仅传输 20% 的时间 ()。
- a. 电路交换能支持多少用户?
- b. 分组交换,为什么 2 个或更少用户时基本无排队时延?
- c. 某用户正在传输的概率?
- d. 3 个用户时,所有用户同时传输的概率?队列增长的时间比率?
- 参数:
- 链路总带宽
- 每个用户传输速率
- 用户活跃概率
- 解答:
- a. 电路交换: 需要为每个活跃用户预留 。总带宽 。因此,最多能支持 个用户。
- b. 分组交换 (≤ 2 用户):
- 如果只有 1 个用户传输,所需带宽为 1 Mbps,小于链路容量 2 Mbps。
- 如果有 2 个用户同时传输,所需总带宽为 1 Mbps + 1 Mbps = 2 Mbps,等于链路容量。
- 由于总需求带宽不超过链路容量,到达速率不超过服务速率,因此基本上不会产生排队时延。
- c. 单用户传输概率: 或 20%。
- d. 3 个用户:
- 所有 3 个用户同时传输的概率 (假设用户行为独立):。
- 队列增长发生在总需求带宽超过链路容量时。这仅在 3 个用户都同时传输时发生(总需求 3 Mbps > 2 Mbps)。
- 因此,队列增长的时间比率等于所有 3 个用户同时传输的概率,即 0.008 或 0.8%。
1.6 R18: 传输时延与传播时延计算
- 问题: 一个 1000 字节的分组,经 2500km 链路传播,速率 ,传输速率 Mbps。求总时间?更一般情况 L 字节,距离 d,速率 s,传输率 R,求总时间?时延与传输速率的关系?
- 参数:
- 解答:
- 传播时延 (Propagation Delay): 。
- 传输时延 (Transmission Delay): 。
- 总时延 (Total Delay) (忽略排队和处理): 。
- 一般公式: 。
- 关系:
- 传播时延 取决于距离 和传播速率 ,与传输速率 无关。
- 传输时延 取决于分组长度 和传输速率 ,与传播速率 和距离 无关。
1.7 R19: 吞吐量与文件传输时间
- 问题: 主机 A 到 B 路径有 3 段链路,速率分别为 , , 。
- a. 无其他流量时,吞吐量是多少?
- b. 传输 4MB 文件需要多长时间?
- c. 若 降为 100kbps,重复 a 和 b。
- 参数:
- Case 1: , , (bps)
- Case 2: , , (bps)
- File size
- 单位约定:k=1000, M=1,000,000, 1 Byte = 8 bits
- 解答:
- a. (Case 1) 吞吐量: 吞吐量由路径上的瓶颈链路决定,即速率最小的链路。Throughput 。
- b. (Case 1) 文件传输时间: 。
- c. (Case 2) 吞吐量和时间:
- 新的瓶颈速率 。
- 新的传输时间 。
- 注意: 实际计算中需注意 k、M、G 等前缀代表 (通常用于速率) 还是 (通常用于存储容量),以及 B (Byte) 和 b (bit) 的转换。课堂中按 和 1B=8b 计算。
1.8 R23: 因特网协议栈的五个层次
- 问题: 因特网协议栈中的 5 个层次有哪些?在这些层次中,每层的主要任务是什么?
- 解答: 因特网协议栈(TCP/IP 模型通常描述为五层):
- 应用层 (Application Layer): 为网络应用程序提供服务。任务包括定义应用协议 (如 HTTP, SMTP, DNS),数据表示等。直接面向用户。
- 运输层 (Transport Layer): 提供端到端(进程到进程)的数据传输服务。主要任务包括分段与重组、端口寻址、连接管理 (TCP)、可靠传输 (TCP)、流量控制 (TCP)、拥塞控制 (TCP)。UDP 提供无连接、不可靠的服务。
- 网络层 (Network Layer): 负责将分组从源主机路由到目的主机(主机到主机)。主要任务包括逻辑寻址 (IP 地址)、路由选择、分组转发。
- 链路层 (Link Layer): 在相邻节点(主机或路由器)之间的链路上移动数据帧。主要任务包括物理寻址 (MAC 地址)、帧封装、差错检测、介质访问控制 (MAC)。
- 物理层 (Physical Layer): 负责在传输介质上传输原始比特流。任务包括定义接口特性、电压电平、比特编码、传输速率等。
1.8.1 1. 请简述 TCP/IP 五层模型的各层功能。
TCP/IP 五层模型(也常被称为五层参考模型)自下而上包括:
- 物理层 (Physical Layer):
- 功能: 负责在物理媒介(如电缆、光纤、无线电波)上传输原始的比特流(0和1)。它定义了物理设备的电气、机械、过程和功能特性,如电压、引脚布局、接口标准等。
- 数据链路层 (Data Link Layer):
- 功能: 负责在同一网络中的相邻节点之间(例如,同一局域网内的两台电脑)可靠地传输数据。它将网络层的数据包封装成帧 (Frame),使用 MAC 地址进行寻址,并进行错误检测(CRC 校验)。
- 网络层 (Network Layer):
- 功能: 负责在不同网络之间实现主机到主机的通信。它使用 IP 地址来唯一标识网络上的主机,并通过路由 (Routing) 算法选择最佳路径来转发数据包 (Packet)。
- 运输层 (Transport Layer):
- 功能: 负责提供端到端(即进程到进程)的通信服务。它通过端口号来区分不同的应用程序。本层主要有两个协议:
- TCP (传输控制协议): 提供面向连接的、可靠的字节流服务。
- UDP (用户数据报协议): 提供无连接的、不可靠的数据报服务。
- 功能: 负责提供端到端(即进程到进程)的通信服务。它通过端口号来区分不同的应用程序。本层主要有两个协议:
- 应用层 (Application Layer):
- 功能: 直接为用户的应用程序提供网络服务。它定义了应用程序之间通信的规则和格式。常见的协议包括 HTTP(网页)、FTP(文件传输)、SMTP(电子邮件)、DNS(域名解析)等。
1.9 R25: 网络设备处理的层次
- 问题: 路由器处理因特网协议栈中的哪些层次?链路层交换机处理的是哪些层次?主机处理的是哪些层次?
- 解答:
- 路由器 (Router): 主要工作在网络层(第三层)。它需要检查分组的网络层头部(如 IP 地址)来进行路由决策和转发。它也需要处理链路层和物理层(第一、二层)来接收和发送分组。因此,路由器通常处理 物理层、链路层、网络层。
- 链路层交换机 (Switch): 主要工作在链路层(第二层)。它检查帧的链路层头部(如 MAC 地址)来进行转发决策。它也需要处理物理层(第一层)。因此,交换机通常处理 物理层、链路层。
- 主机 (Host): 作为通信的端点,需要实现协议栈的所有层次,从应用数据产生到物理比特传输都需要处理。因此,主机处理 物理层、链路层、网络层、运输层、应用层 (所有五层)。
1.10 P2: 分组交换中的流水线效应 (Pipelining)
- 问题: 考虑 条速率均为 的链路组成的路径( 台路由器),从源到目的地发送 个长度为 的分组。推导端到端时延公式。
- 场景: 源 Rtr1 … Rtr(N-1) 目的 (共 N 段链路)
- 解答:
- 传输时延 (每跳): 。
- 第一个分组到达目的地所需时间: 第一个分组需要经过 N 次传输(每段链路一次)。由于存储转发,总时间为 。
- 流水线效应: 当第一个分组到达第 跳的输出端时(时刻 ),第 个分组刚开始从源发送。
- 当第一个分组到达目的地时(时刻 ),源主机已经发送完了前 个分组,并刚开始发送第 个分组(如果 )。
- 计算方法 1 (最后一个分组): 最后一个(第 P 个)分组在时刻 开始从源发送。它还需要 的时间才能到达目的地。所以总时间 = (开始发送最后一个分组的时刻) + (最后一个分组穿越网络的时间) = 。
- 计算方法 2 (第一个分组 + 后续): 第一个分组到达时间为 。此后,每隔 时间,就有一个新的分组到达目的地。总共有 个后续分组。所以总时间 = (第一个分组到达时间) + (后续 P-1 个分组到达所需时间) = 。
- 公式: (忽略传播、排队、处理时延)。
1.11 P3: 应用特性与网络选择、拥塞控制
- 问题: 考虑一个稳定速率、长时间运行的应用(每 时间单元产生 比特)。
- a. 分组交换和电路交换哪个更适合?为什么?
- b. 若用分组交换,且总应用速率 < 链路容量,需要拥塞控制吗?为什么?
- 解答:
- a. 网络选择: 电路交换 更适合。
- 原因: 该应用以稳定速率(恒定比特率 CBR)产生数据且持续时间长。电路交换能提供预留的、恒定的带宽和较低且稳定的时延,非常匹配这种应用的需求。分组交换虽然能提高链路利用率,但可能引入时延抖动,对于这种稳定速率的应用可能不是最优选择。
- b. 拥塞控制: 不需要。
- 原因: 问题假设所有流量都来自此类应用,并且总的应用传输速率之和小于每条链路的容量。这意味着网络资源(带宽)是充足的,数据包的到达速率始终低于链路的服务速率。在这种情况下,路由器队列不会无限增长,不会发生拥塞。拥塞控制机制主要是为了在网络资源不足、需求超过供给时进行调节,此处不存在这种情况。
- a. 网络选择: 电路交换 更适合。
1.12 P6: 传播时延与传输时延的深入理解
- 问题: 两主机 A, B 相距 米,链路速率 bps,传播速率 m/s,发送 比特分组。
- a. 传播时延 ?
- b. 传输时延 ?
- c. 端到端时延?
- d. 时,最后一个比特在哪?
- e. 若 , 时第一个比特在哪?
- f. 若 , 时第一个比特在哪?
- g. , bit, kbps,求使 的距离 m。
- 解答:
- a.
- b.
- c.
- d. 在时刻 ,最后一个比特刚刚离开发送主机 A。
- e. (传播时间 > 传输时间): 在时刻 ,第一个比特已经传播了 的时间,距离 A 为 米。由于 ,所以 ,即第一个比特仍在链路上,还未到达 B。
- f. (传播时间 < 传输时间): 第一个比特在时刻 就到达了 B。因为 ,所以在时刻 ,第一个比特早已到达接收主机 B。
- g. 令 ,即 。 。
1.13 P13:平均排队时长推导
1.13.1 (a)
Suppose packets arrive simultaneously to a link at which no packets are currently being transmitted or queued. Each packet is of length and the link has transmission rate . What is the average queuing delay for the packets?
a) The queuing delay is 0 for the first transmitted packet, for the second transmitted packet, and generally, for the transmitted packet. Thus, the average delay for the packets is:
Note that here we used the well-known fact:
1.13.2 (b)
Now suppose that such packets arrive to the link every seconds. What is the average queuing delay of a packet?
b) It takes seconds to transmit the packets. Thus, the buffer is empty when each batch of packets arrive. Thus, the average delay of a packet across all batches is the average delay within one batch, i.e., .
1.14 补充推导为啥课本讲的流量强度1则时间无穷而这里的流量强度不是无穷(关于P13)
很高兴能为您进行这个推导。您老师提到的现象,是排队论中一个非常经典和重要的结论。
您提到的“泊松分布 (Poisson)”是用来描述数据包到达的随机模式。为了建立一个完整的随机模型,我们通常还需要假设数据包的服务时间(即传输时间 )也是随机的,并且服从“指数分布 (Exponential)” 。
这种模型被称为 M/M/1 排队模型:
- M (Markovian/Memoryless): 指数据包的到达遵循泊松过程(随机到达)。
- M (Markovian/Memoryless): 指服务时间遵循指数分布(随机服务时长)。
- 1: 指系统中只有一个服务台(即一条链路)。
1.14.1 M/M/1 模型推导
我们将使用以下变量来证明当流量强度 时,排队时延 。
1.14.1.1 1. 定义变量
- (lambda): 平均到达率 (packets/sec)。这是泊松分布的参数。
- (mu): 平均服务率 (packets/sec)。即链路每秒平均能传输多少个包。
- (Service Time): 平均服务时长。。在您之前的题目中,服务时间是固定的 ,在这里我们将其视为一个平均值。
- (rho): 流量强度 (Traffic Intensity) 或称系统利用率。
- 为了使队列系统保持稳定(即队列不会无限增长),必须满足 ,即 。
1.14.1.2 2. 关键公式(推导结果)
在 M/M/1 模型中,通过对系统状态(队列中的数据包数量)进行数学分析(通常使用马尔可夫链),可以得出两个关键的公式:
- 系统中数据包的平均数量 ():
- 利特尔定律 (Little’s Law):
- : 系统中的平均包数
- : 每个包在系统中的平均总停留时间(排队时间 + 服务时间)
1.14.1.3 3. 推导平均排队时长 ()
我们的目标是求平均排队时长 ()。
- 一个包的总停留时间 等于它排队的时间 加上它被服务的时间 。
现在我们来推导 :
步骤 1:求总停留时间 根据利特尔定律 ,我们可以得到 。 代入 :
步骤 2:用 和 替换 我们知道 :
步骤 3:求排队时间 我们知道 :
步骤 4:将公式用 重新表示(关键步骤) 我们得到了 。让我们把 从分母中提出来:
因为 ,所以我们得到 M/M/1 平均排队时延的最终公式:
1.14.2 结论与分析
现在我们来分析这个公式:
- 是平均服务时间(例如 ),这是一个固定 的正常数。
- 是流量强度。
我们要考察的是当流量强度 趋近于 1 时会发生什么:
- 分子 ():当 时,分子趋近于 ,这是一个有限的正常数。
- 分母 ():当 从下方(例如 0.9, 0.99, 0.999…)趋近于 1 时,分母趋近于 (一个非常小的正数)。
一个有限的正常数除以一个趋近于 0 的正数,结果将趋向于正无穷大。
证明完毕。
1.14.3 为什么会这样?(直观解释)
- 在您之前的 D/D/1 确定性模型中, 意味着到达和离开是完美同步的。系统刚好在处理完最后一个包时,下一批包才到达。
- 在 M/M/1 随机模型中,到达是不规律的。即使平均到达率 略小于服务率 (例如 ),也总会存在一段“坏运气”时期,即数据包暂时性地“扎堆”到达(瞬时到达率 > ),导致队列迅速累积。
- 由于系统利用率 已经非常高(接近 100%),服务器几乎没有“空闲时间”来消化这些突发累积的队列。
- 因此,当 时,这种由随机性导致的“队列累积”效应会变得极其严重,任何一点风吹草动(几个包同时到达)都会导致队列长度和等待时间急剧飙升,直至趋于无穷。
1.15 P14: 流量强度与排队时延
- 问题: 考虑排队时延。流量强度 。
- a. 写出总时延(排队+传输)公式。
- b. 以 为函数画出总时延图。
- 参数:
- : 流量强度 (Traffic Intensity)
- : 分组长度 (bits)
- : 分组平均到达速率 (packets/sec)
- : 链路传输速率 (bps)
- 解答:
- a. 总时延公式【也叫】:
- 传输时延: 。
- 排队时延 (基于 M/M/1 或 M/G/1 近似): 。(注意:这是一个简化或特定模型下的公式)
- 总时延 。
- 化简: 。
- b. 总时延图:
- 令 (即传输时延)。则 。
- 总时延 。
- 作图:横轴为 ,纵轴为 。
- 该函数在 且 (即 ) 的区间内有意义。
- 当 时,。
- 当 (即 ) 时,。
- 图形是一条非线性的曲线,随着 (或流量强度 ) 接近其上限,总时延急剧增长,趋向无穷大。这表明当链路利用率接近 100% 时,排队时延会变得非常大。
- a. 总时延公式【也叫】:
1.16 P15 用和来表示P14的答案
P15. Let denote the rate of packets arriving at a link in packets/sec, and let denote the link’s transmission rate in packets/sec. Based on the formula for the total delay (i.e., the queuing delay plus the transmission delay) derived in the previous problem, derive a formula for the total delay in terms of and .
P16 Little公式
Consider a router buffer preceding an outbound link. In this problem, you will use Little’s formula, a famous formula from queuing theory. Let denote the average number of packets in the buffer plus the packet being transmitted. Let denote the rate of packets arriving at the link. Let denote the average total delay (i.e., the queuing delay plus the transmission delay) experienced by a packet. Little’s formula is . Suppose that on average, the buffer contains 100 packets, and the average packet queuing delay is 20 msec. The link’s transmission rate is 100 packets/sec. Using Little’s formula, what is the average packet arrival rate, assuming there is no packet loss? 这是一个经典的排队论问题,利用利特尔法则 (Little’s formula) 求解。
题目翻译
“考虑一个出站链路前的路由器缓冲区。在这个问题中,你将使用排队论中一个著名的公式:利特尔法则 (Little’s formula)。
设 表示缓冲区中的平均数据包数量,加上正在传输的数据包。 设 表示到达该链路的数据包速率。 设 表示一个数据包所经历的平均总延迟(即排队延迟 加上 传输延迟)。
利特尔法则为: 。
假设平均而言,缓冲区中包含 100 个数据包,并且平均数据包排队延迟为 20 毫秒 (msec)。链路的传输速率为 100 包/秒。
使用利特尔法则,假设没有丢包,平均数据包到达速率 是多少?”
解题步骤
利特尔法则 () 不仅适用于整个系统,也适用于系统中的任何稳定子系统。
在这个问题中,我们可以只关注路由器缓冲区(即队列本身),并对其应用利特尔法则。
1. 识别相关变量
利特尔法则应用于缓冲区(队列)时,公式变为:
- (或 ) 是指在缓冲区中排队的平均数据包数量。
- 是数据包进入缓冲区的速率(即到达速率)。
- 是数据包在缓冲区中等待的平均时间(即排队延迟)。
2. 从题目中提取已知值
- = 100 packets (题目:“缓冲区中包含 100 个数据包”)
- = 20 msec (题目:“平均数据包排队延迟为 20 msec”)
- = ? (这是我们要找的)
3. 单位换算
为了使单位统一,我们将排队延迟从毫秒 (msec) 换算成秒 (s):
4. 求解到达速率
我们将已知值代入公式:
现在,求解 :
答案: 平均数据包到达速率是 5000 包/秒。
关于 “100 包/秒” 传输速率的说明:
你可能注意到题目中给出了 “链路的传输速率为 100 包/秒”,但在我们的计算中并没有使用它。
- 这是因为题目同时给了我们排队子系统的平均排队数 () 和平均排队时间 ()。
- 根据利特尔法则,仅凭这两个值就可以直接计算出到达速率 。
- 因此,“100 包/秒” 在这个特定的问题设置中是一个多余信息(或称为“干扰项”)。(注:如果题目没有给 而是给了总延迟 ,我们就需要用这个传输速率来计算了。)
1.17 P22: 多跳链路丢包概率与重传次数
- 问题: 分组经过 N 条独立链路,每条链路丢包率为 p。
- (1) 分组成功到达的概率 是多少?
- (2) 平均需要重传多少次才能成功?
- 解答:
- (1) 成功概率:
- 一个分组要成功到达,必须在 所有 N 条 链路上都不丢失。
- 单条链路不丢失的概率是 。
- 由于各链路独立,N 条链路都不丢失的概率是 。
- (2) 平均重传次数:
- 这是一个几何分布问题:每次尝试成功的概率是 。
- 设 为成功传输所需的总尝试次数(包括第一次尝试)。 服从参数为 的几何分布。
- 其期望值为 。
- 平均重传次数 是总尝试次数减去第一次尝试的次数:。
- 推导 :
- (前 i-1 次失败,第 i 次成功)。
- 。
- 这是一个等比数列求导得到的级数求和, (当 )。
- 令 ,则 。
- (1) 成功概率:
1.18 P25: 带宽-时延积 (BDP) 的计算与理解
- 问题: A, B 相距 km,链路 Mbps,传播速率 m/s。
- a. 计算 BDP = 。
- b. 发送 bit 文件,链路上最大比特数?
- c. BDP 的解释?
- d. 比特的宽度(米)?比足球场长吗?
- e. 比特宽度的一般表达式?
- 解答:
- a. 计算 BDP:
- 。
- BDP = (或 160 kbit)。
- b. 链路上最大比特数: 文件长度 。因为 ,发送方发送完整个文件之前,第一个比特已经到达接收方很久了,链路会被数据“填满”。在任何时刻,链路上容纳的最大比特数等于带宽-时延积,即 。
- c. BDP 解释: 带宽-时延积表示在任何给定时刻,能够存在于从发送方到接收方的传输链路上的最大比特数量。可以将其视为链路这条“管道”的容量(以比特为单位)。
- d. 比特宽度: 一个比特在链路上占据的空间长度。
- 发送 1 比特所需时间 = 。
- 在此时间内,比特在链路上传播的距离 = 。
- 125 米通常比一个标准足球场的长度(约 100-110 米)要长。
- e. 比特宽度一般表达式: (米/比特)。
- a. 计算 BDP:
1.19 P27: 高带宽下的 BDP 与文件传输
- 问题: 同 P25,但链路速率 Gbps。
- a. 计算 BDP。
- b. 发送 bit 文件,链路上最大比特数?
- c. 比特的宽度?
- 解答:
- a. 计算 BDP:
- 。
- (不变)。
- BDP = (或 80 Mbit)。
- b. 链路上最大比特数: 文件长度 。现在 。这意味着在发送方发送完整个文件时,第一个比特还未到达接收方。整个文件可以完全容纳在链路管道中。因此,在传输过程中,链路上存在的最大比特数就是文件的总长度,即 。
- c. 比特宽度: (或 25 厘米)。比特宽度大大减小。
- a. 计算 BDP:
1.20 P31: 报文交换 vs 分组交换的时延对比
- 问题: 源到目的地经过 2 个交换机(3 段链路),链路带宽均为 Mbps。报文大小 bits。忽略传播、排队、处理时延。
- a. 报文交换(整个报文作一个分组),传输时间?
- b. 分组交换,报文分 800 组,每组 bits。第一个分组到达时,第二个分组在哪?
- c. 分组交换的总传输时间?
- d. 其他时延有哪些?
- e. 哪种交换方式时延短?
- 解答:
- a. 报文交换:
- 传输时延(每跳): 。
- 总时间(3 跳存储转发): 。
- b. 分组交换 - 第一个分组到达时第二个分组的位置:
- 分组传输时延(每跳): 。
- 第一个分组到达目的地 B 的时间(经过 3 跳): 。
- 第二个分组在时刻 ms 开始从 A 发送,在 ms 到达 S1 并开始转发,在 ms 到达 S2 并开始转发。
- 因此,在第一个分组到达 B 的时刻 (ms),第二个分组刚刚完成在 S2 的接收并开始向 B 传输(或说最后一个比特刚离开 S2)。
- c. 分组交换总时间:
- 使用流水线公式: 。
- d. 其他时延: 传播时延、排队时延、处理时延。这些在本题中被忽略了。
- e. 时延比较: 分组交换的总时延 (4.01s) 远小于报文交换的总时延 (12s)。这是因为分组交换允许流水线传输,提高了链路利用率和传输效率。
- a. 报文交换:
1.21 往年题
如图所示,A向C传输数据,其中经过交换机B,现忽略处理时延和排队时延。
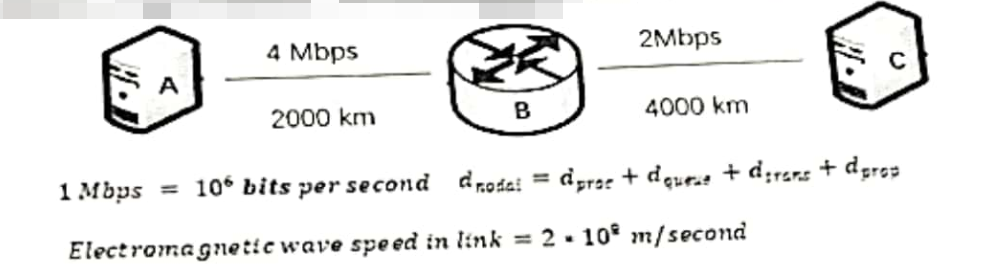
bits per second
Electromagnetic wave speed in link = m/second
若采用分组交换:
- (1) 若A向C发送一个500byte数据包且B使用存储转发传输(store-and-forward),求总时延。
- (2) 若A向C发送500byte数据包,B使用直通式交换(cut-through 即B收到数据包的前50个byte后就开始转发该数据包),求总时延。
若采用虚(virtual)电路交换,在首次使用时需要发送信息包建立链路,先采用存储转发的分组交换传输链路信息包,再使用电路交换回传信息包,从而建立直连链路。假设开始时链路信息包的大小为100byte:
- (3) 建立(A→B→C)的链路,求建立这条链路所需总时延。
- (4) 链路建立完成后,求A向C发送500byte数据所需要的总时延。
若一家互联网公司有一份30TB的紧急数据需要传输,这家公司有足够多的可移动硬盘,且可使用遍布全国的运营商链路:
-
(5) 若这家公司需要将这份数据从南京传到北京(链路距离大约900km),运营商提供最高10Gbps的链路,紧急快递服务承诺任何包裹24h内可送达,请问你建议这家公司采用何种方法传输这份紧急数据?
1.21.1 解题准备
首先,我们根据题意计算出所有基础时延值(注意:题目忽略处理时延和排队时延)。
常量:
- 传播速度
- 1 Mbps =
数据包 (Q1, Q2, Q4):
- 包大小
- (A→B 传输时延) =
- (B→C 传输时延) =
链路信息:
- (A→B 传播时延) =
- (B→C 传播时延) =
1.21.2 (1) 存储转发 (Store-and-Forward) 总时延
存储转发要求交换机 B 必须接收完整个 500B 的数据包后,才能开始向 C 转发。
总时延 = (A→B 的总时延) + (B→C 的总时延) 总时延 = 总时延 = 总时延 =
答: 总时延为 33 ms。
1.21.3 (2) 直通式交换 (Cut-Through) 总时延
直通式交换允许交换机 B 在接收完前 50 B 数据后,立即开始向 C 转发。
-
B 开始转发的时刻: B 必须先收到 A 发来的 50 B 数据。这 50 B (400 bits) 的最后一个 bit 到达 B 的时刻是:
- (A 传输 50B) =
- B 开始转发时刻 =
-
最后一个 bit 到达 C 的时刻:
- 从 B 开始转发(10.1 ms 时刻)起,B 需要花费 (2 ms) 的时间将整个 500B 包推上 B→C 链路。
- 最后一个 bit 离开 B 的时刻 =
- 最后一个 bit 到达 C 的时刻 = (最后一个 bit 离开 B 的时刻) +
- 总时延 =
答: 总时延为 32.1 ms。
1.21.4 (3) 虚电路 (Virtual Circuit) 建立时延
建立链路需要一个往返:
- A C:发送 100 B 建立包 (存储转发)
- C A:回传 100 B 确认包 (存储转发)
计算 100 B (800 bits) 包的相关时延:
- =
- =
- =
- =
- 传播时延不变 ()
1. A C (去程) 时延:
2. C A (回程) 时延:
3. 总建立时延:
答: 建立这条链路所需总时延为 61.2 ms。
1.21.5 (4) 链路建立后 500B 数据包的总时延
链路建立后,A→B→C 的路径已固定。题目中“电路交换”的描述意味着数据包将像在真正的电路中一样传输,整个路径的速率受限于瓶颈链路。
- 瓶颈带宽 =
- 总传播时延 =
- 传输 500B 包的有效传输时延(按瓶颈带宽计算):
在电路交换模型中,总时延 = (总传播时延) + (有效传输时延) 总时延 = 总时延 =
答: 链路建立完成后,发送 500B 数据包所需的总时延为 32 ms。
1.21.6 (5) 紧急数据传输建议
这道题需要我们比较网络传输和物理运送(“人肉快递”,Sneakernet) 哪种方式更快。
1. 计算网络传输时间:
- 数据总量:
- 网络带宽:
- 传输时间:
- 换算为小时:
2. 物理运送时间:
- 快递服务承诺时间: 24 小时内可达。
3. 比较与建议:
- 网络传输时间 ( 小时) 远小于 物理运送时间 (24 小时)。
答: 建议这家公司采用 10 Gbps 的网络链路来传输这批紧急数据。
原因如下:
- 网络传输耗时: 传输 30 TB 数据在 10 Gbps 链路上的理论最快时间为 24000 秒,约等于 6.67 小时。
- 物理运送耗时: 使用快递服务(移动硬盘)承诺的送达时间为 24 小时。
- 结论: 。对于 30TB 这个数据量,使用网络传输明显快于物理运送。