1 Internet介绍
1.1 网络和计算机网络
网络→计算机网络→互联网是递进的关系
- 网络不仅仅是计算机网络,比如蜘蛛网,神经网络
- 计算机网络是联网的计算机所构成的系统
这里要区分的概念
- 网络不仅仅计算机网络
- 计算机网络 ≠ Internet
- Internet(网际)是网络的网络
2 Internet组成
- Network edge: hosts, access network, physical media
- Network core: packet/circuit switching, internet structure
- Performance: loss, delay, throughput
2.1 (1) 构成的角度
从零件的角度来看:
- 互联网包括 节点 、 边(链路) 和 协议
- 节点包括主机节点和数据交换节点、边包括接入链路和骨干链路
2.1.1 网络互联设备
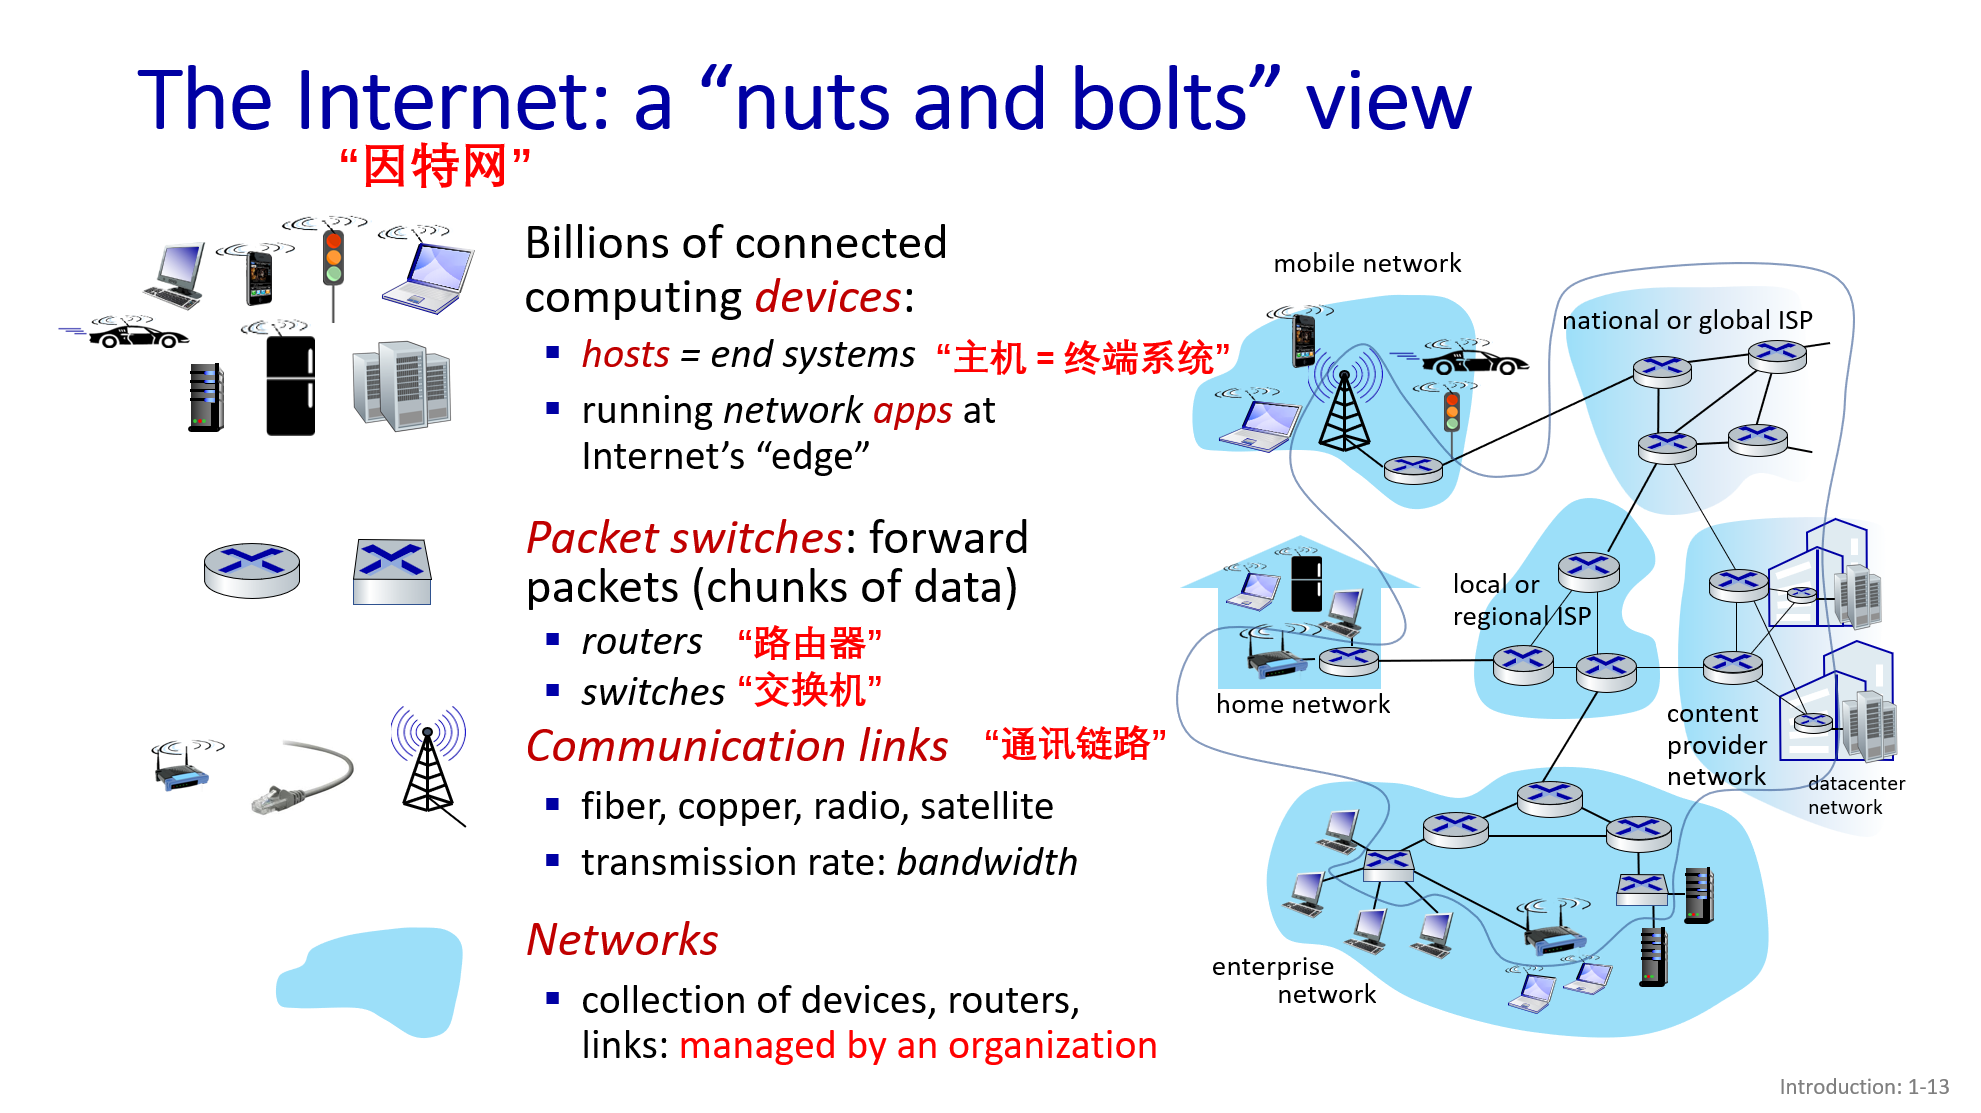
- 数以亿计的、互联的计算设备:
- 主机 = 端系统
- 运行网络应用程序
- 通信链路
- 光纤、同轴电缆、无线电 、卫星
- 传输速率 = 带宽(bps)
- 分组交换设备:转发分 组 (packets)
- 路由器和交换机
来自张渊的课件
从硬件或组件角度出发,互联网是一个规模庞大、互联互通的系统,其核心组成部分包括:
- 计算设备:又称主机(host) 或终端系统(end system),涵盖笔记本电脑、智能手机、服务器乃至智能冰箱等设备。这类设备位于网络“边缘”,主要运行网络应用程序。
- 分组交换机:用于转发数据块(即分组(packet))的设备,主要分为路由器(router) 和交换机(switch) 两类,是构成网络“核心”的关键组件。
- 通信链路:连接各类设备的物理线路,材质多样,包括光纤(fiber optic cable)、铜线(copper wire) 或采用无线电波(radio waves)的无线链路。
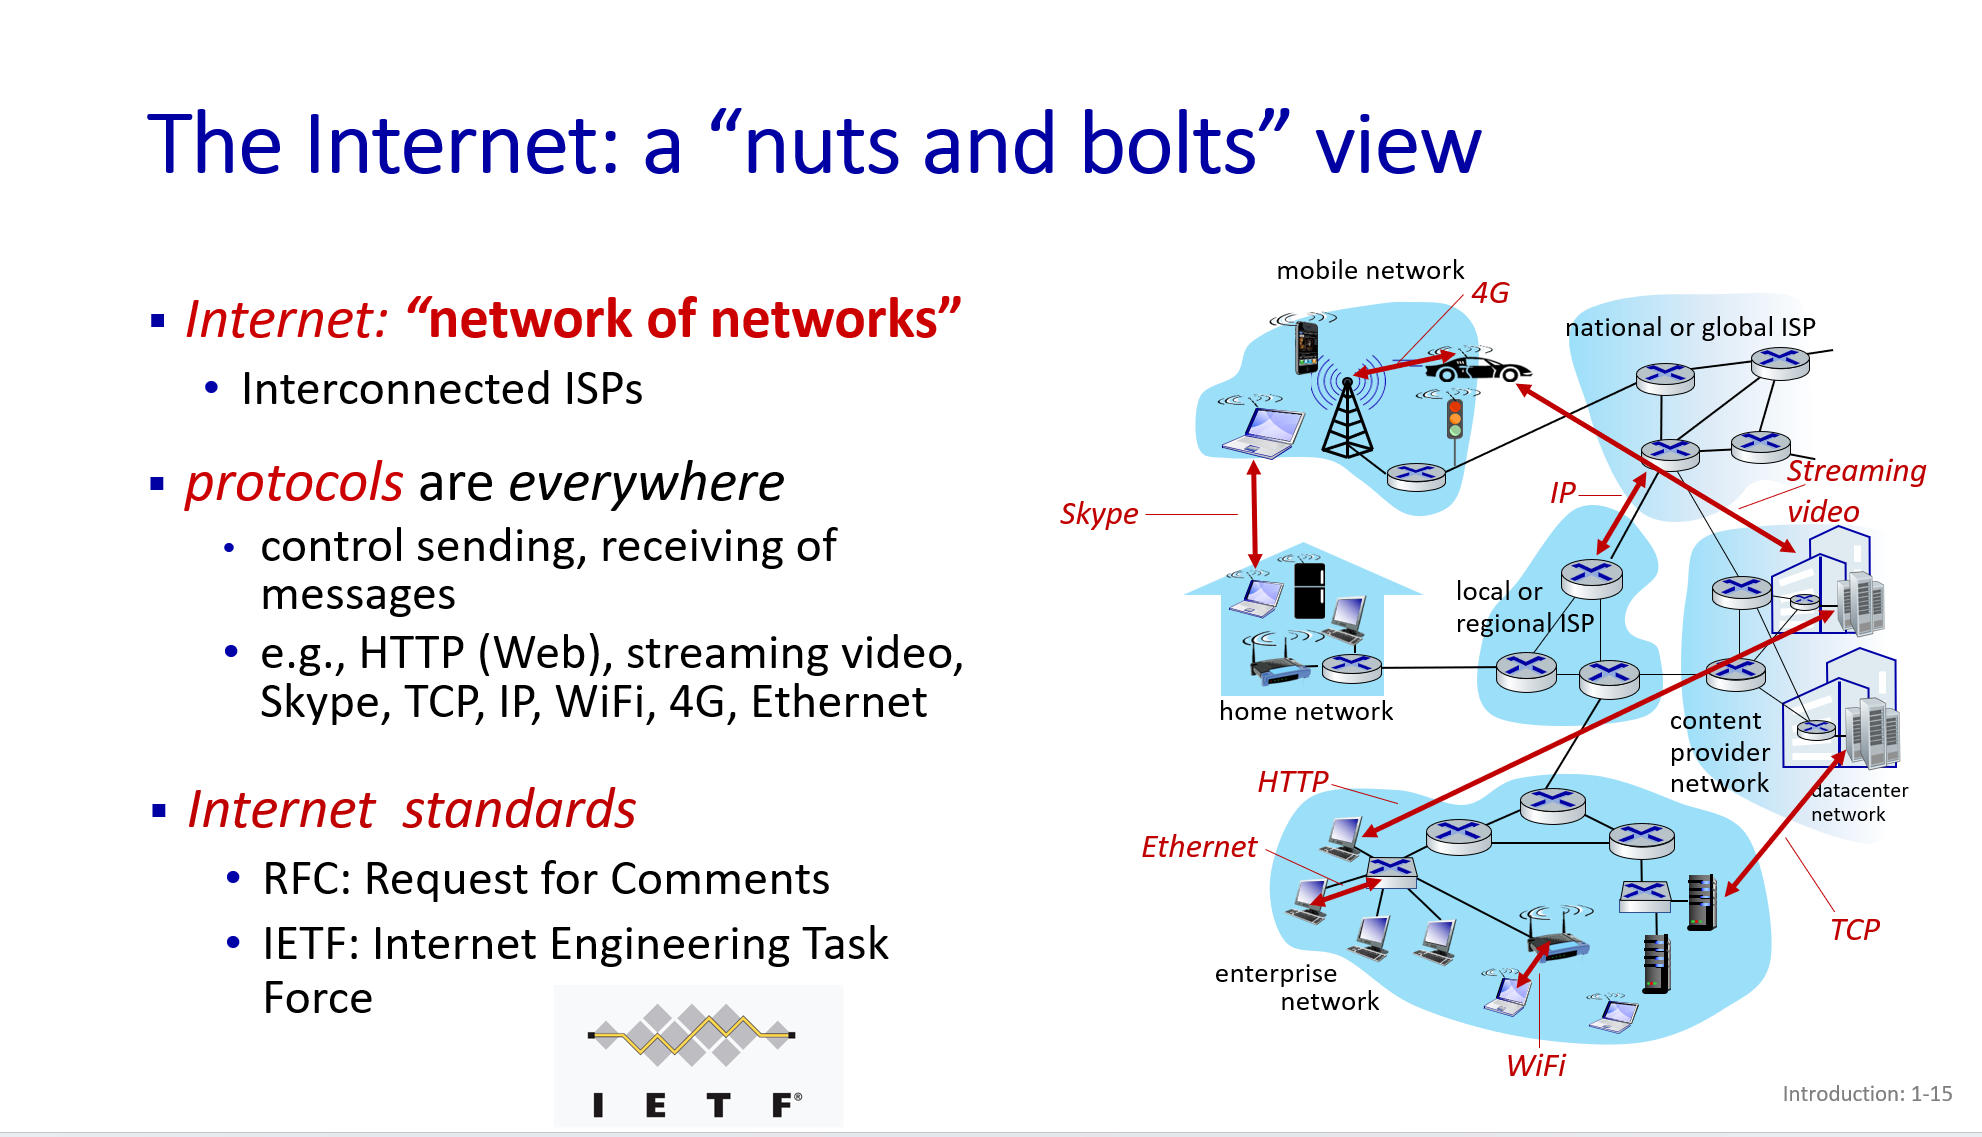
- 网络集群:互联网本质是“网络的网络(network of networks)”,它将数千个小型独立网络(如南京大学校园网、某企业内部网络)连接成一个全球性系统,堪称人类历史上规模最大、结构最复杂的工程项目之一。
要让上述硬件协同工作,需依托协议(protocol) 这类软件规则。协议用于控制互联网中信息的发送与接收,常见例子包括用于网页浏览的HTTP协议、基础通信协议TCP/IP以及无线通信协议Wi-Fi。
这些协议通过名为“互联网标准(Internet standards)”的文档进行定义,其中多数标准由互联网工程任务组(IETF, Internet Engineering Task Force) 以请求评论(RFC, Request for Comments) 文档的形式发布。
2.1.2 节点
1. 节点的分类
-
主机节点 (Host / End System):网络的端点,是数据的源头或目的地。
- 例子:笔记本电脑、智能手机、智能冰箱、Web服务器等。
-
数据交换节点:负责在网络中转发数据的中转设备,它们本身不是数据的源或目标。
- 例子:中继器、路由器、交换机、负载均衡设备等。
2. 节点的构成 (端节点)
一个“端”或主机节点是一个综合体,不仅仅是硬件设备,它包括:
- 设备本身 (硬件)。
- 设备上的网络操作系统 (软件,为应用程序提供通信基础)。
- 运行在设备上的网络应用程序 (例如浏览器、邮件客户端等)。
3. 常见术语与表示
- 节点表示:
- 通常用 方形 表示主机节点。
- 通常用 圆形 表示数据交换节点。
- 链路 (Link):连接两个节点之间的边。
2.1.3 关于链路 (边)
1. 链路的分类
- 接入链路 (Access Link):连接 主机节点 和 数据交换节点 的链路。
- 骨干链路 (Backbone Link):连接 数据交换节点之间 的链路。
2. 链路的构成
通信链路不仅指物理介质,它包括:
- 物理介质:如网线、光纤等。
- 支持协议:在物理介质之上,使其能够工作的网络协议。
3. 链路的重要指标
- 传输速度:衡量链路性能的关键指标。
好的,这是为您整理后的协议相关笔记:
2.1.4 关于协议 (Protocol)
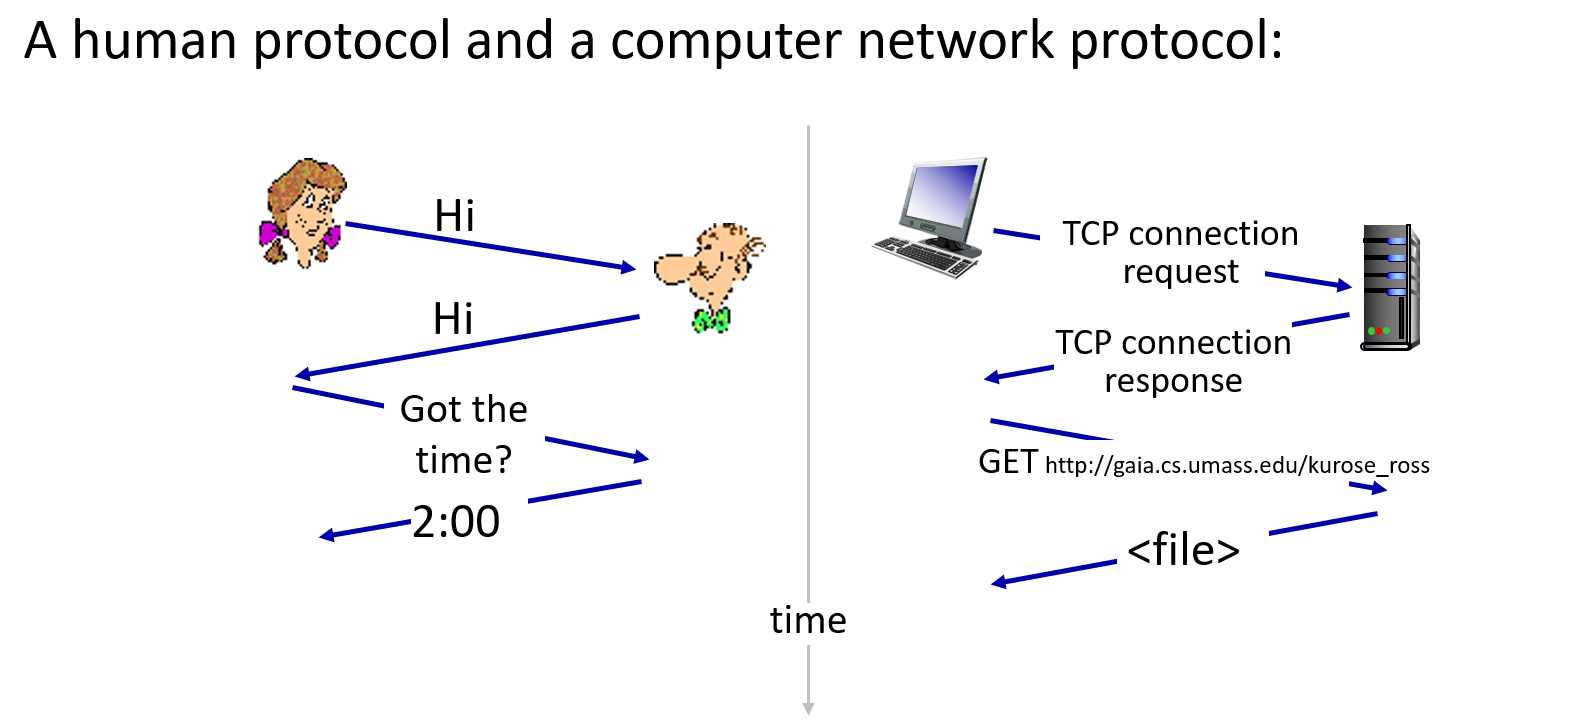
Protocols define the format, order of messages sent and received among network entities, and actions taken on message transmission, receipt
 1. 核心定义
协议是对等实体在通信过程中需要遵守的一系列规则(或标准)的集合。它主要规定了三个要素:
- 语法:报文的格式。
- 语义:报文的含义以及如何解析。
- 时序:报文交换的次序和采取的动作。
2. 作用与范围
- 实现互操作性:协议是支持互联网工作的标准,它使得不同厂商生产的网络设备能够相互通信和协同工作。
- 构成网络的基础:
- 互联网 (Internet):特指以 TCP/IP协议簇 为基础构建的全球性网络。
- 内部网 (internet):如果一个网络同样使用TCP/IP协议,但与外部互联网隔离,则称为内部网。
3. 关键概念:对等实体通信
- 协议是为 对等层实体 之间通信制定的标准。
- 例子1 (应用层):Web浏览器(客户端应用层)和Web服务器(服务器端应用层)都遵循HTTP协议进行通信。
- 例子2 (传输层):发送方主机的TCP模块与接收方主机的TCP模块作为对等实体,遵循TCP协议进行数据传输。
简单来说,协议详细定义了对等实体之间交换的报文格式、发送与接收的次序,以及收到报文或发生特定事件后应采取的具体动作。
2.2 (2) 层次的角度
- Internet:“网络的网络” (网际)
- 松散的层次结构 ,互连的ISP
- 公共Internet vs. 专用intranet
- 教育网、军事网都是网络,互联网就是将这些网络都连起来
- 从构成的角度来看,互联网是节点和边连起来的
- 从层次的角度来看,互联网是由多个网络连接起来的,每个网络之内还包含更小的网络,网络还有更小的网络,更小的网络之间可能连接,还可能与其他网络之间的小网络连接
从层次角度:
- 互联网是一对网络通过网络互联设备连起来的 网络的网络
2.2.1 从服务角度看互联网
从服务的角度来看,互联网可以被理解为一个由两部分组成的整体:
- 运行在其上的分布式应用。
- 为这些应用提供通信服务的网络基础设施。
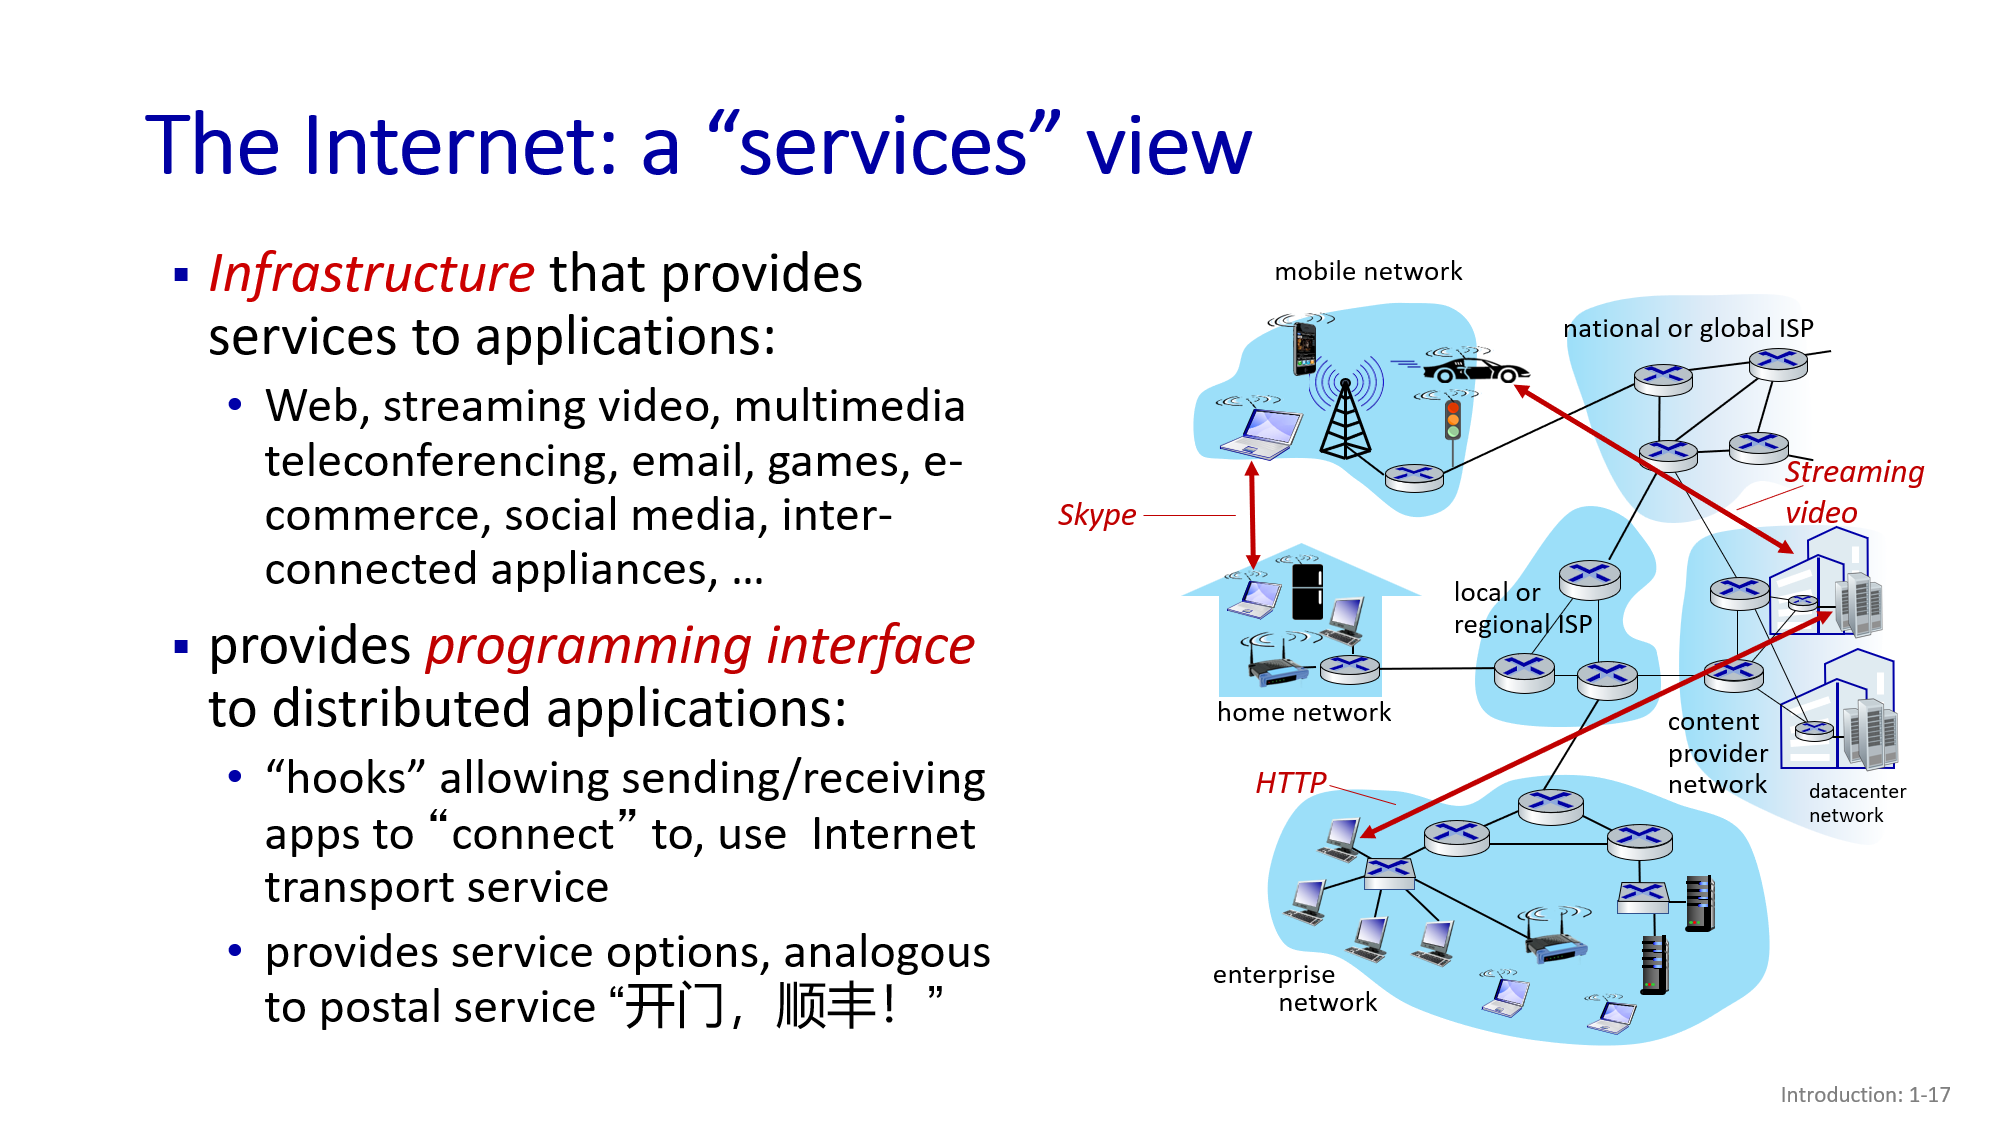
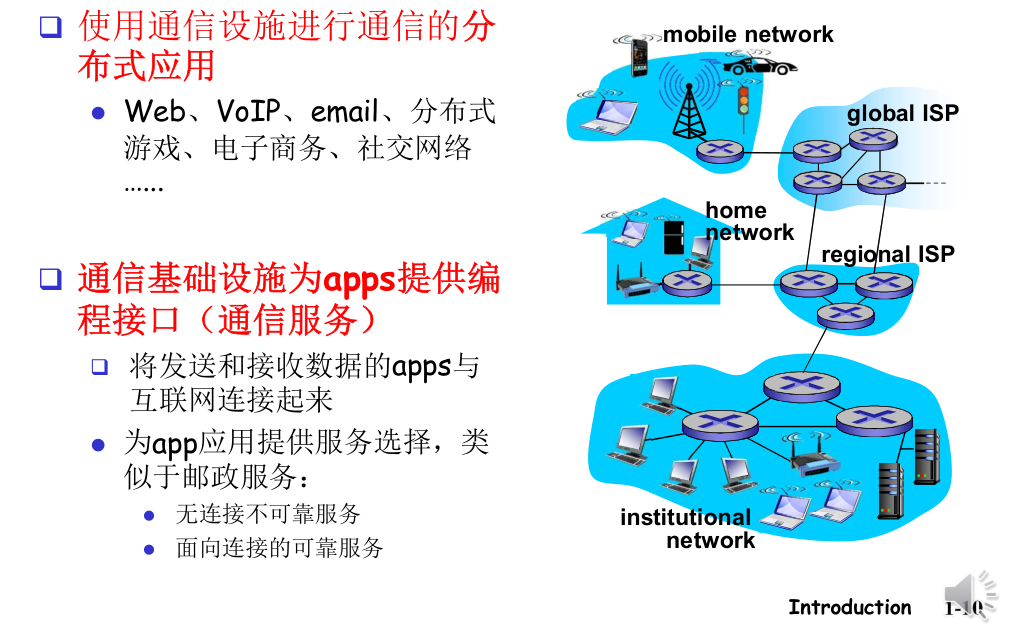
2.2.1.1 1. 分布式应用 (应用进程)
这是用户直接感知到的互联网。它包含了各种各样使用网络进行通信的分布式应用程序。
- 例子:Web网页浏览、流媒体视频 (Streaming video)、VoIP网络电话、电子邮件 (email)、网络游戏、电子商务、社交媒体等。
2.2.1.2 2. 通信基础设施 (为应用提供服务)
这部分是互联网的底层基础,它的核心任务是为上层的分布式应用提供通信能力。
-
如何提供服务:通过向应用程序提供一个编程接口 (API)。应用程序可以利用这个接口(就像一个“钩子”)连接到互联网,并使用其传输服务来发送和接收数据。
- 最典型的例子就是操作系统提供的 Socket API,应用程序通过调用它来实现网络通信。
-
提供两种服务选择:这个基础设施提供的服务类似于邮政服务,有不同的选项可供应用选择。
- 面向连接的可靠服务 (TCP):在通信前先建立连接,确保数据能够准确、按序地到达。适用于对数据完整性要求高的场景(如文件传输、网页浏览)。
- 无连接的不可靠服务 (UDP):不建立连接,直接发送数据,不保证数据一定或按序到达。适用于对实时性要求高、能容忍少量丢包的场景(如视频通话、在线游戏)。
2.3 Internet标准
- RFC: Request for comments (一个互联网的文档)
- IETF: Internet Engineering Task Force(非联网的互联网组织,有任何想法都以RFC文档的形式发送到IETF的网站上,包括TCP和IP等都是如此,全球参与)
2.4 互联网的结构组成
之前从零件的角度分为节点,链路、协议等。这里有另外的方式
从结构上,可以将互联网划分为三个主要部分:网络边缘 (Edge)、网络核心 (Core) 和 接入网 (Access Network)。
2.4.1 1. 网络边缘 (Network Edge)
这是用户直接交互的部分,是互联网存在的根本理由。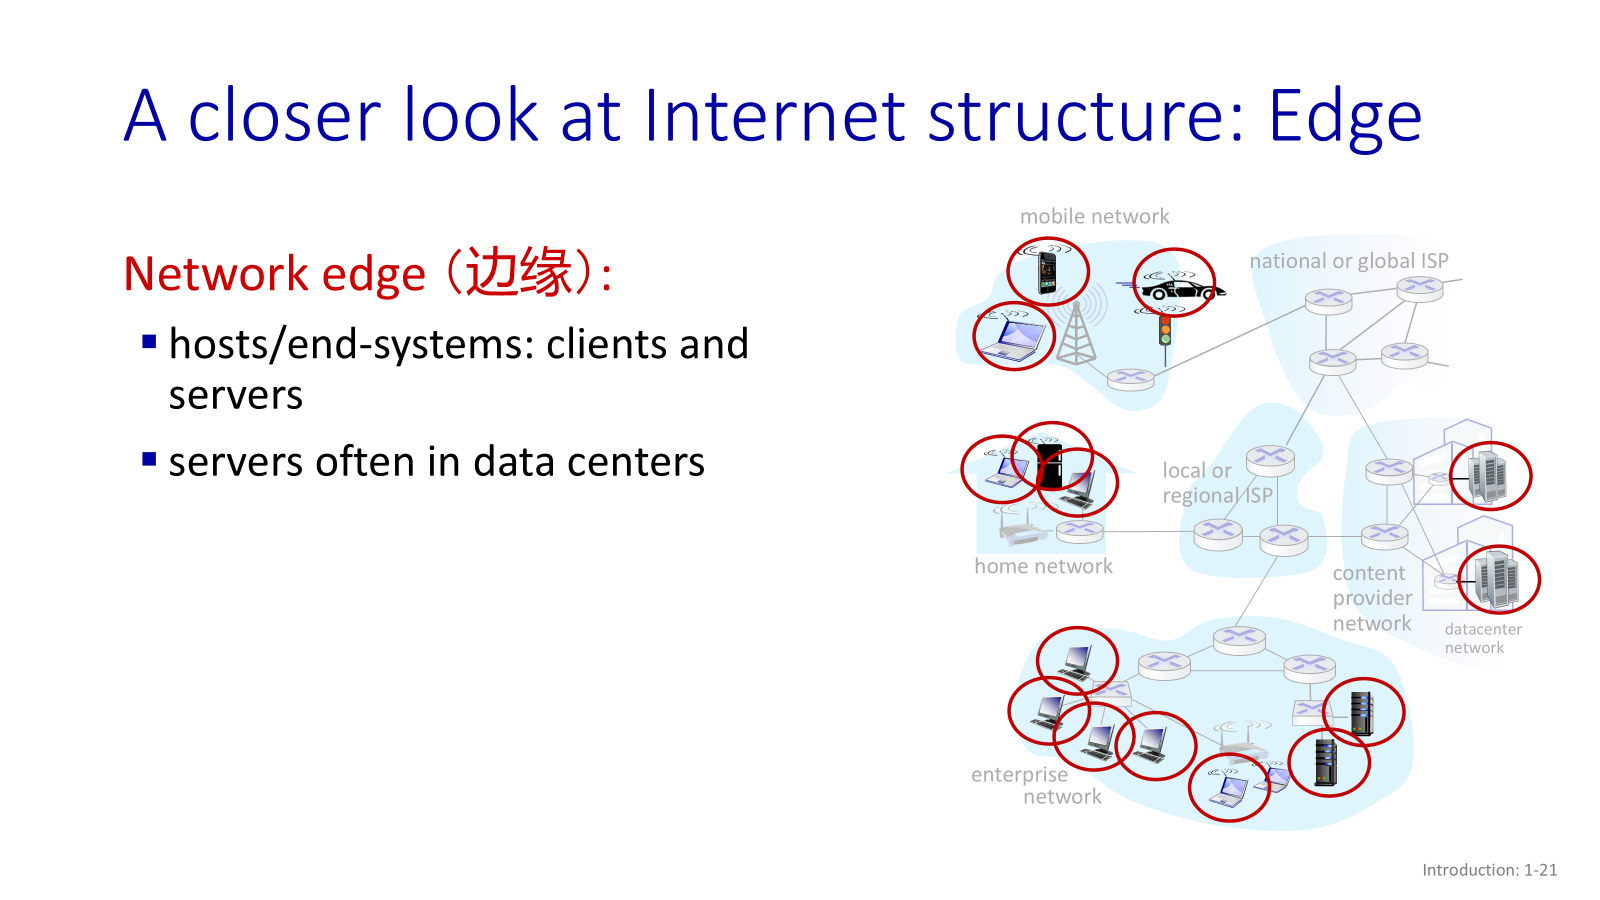
- 构成:由主机 (Host/End-system) 及其上运行的应用程序组成。
- 主机:包括客户端 (Clients) 和服务器 (Servers),例如个人电脑、手机、Web服务器等。服务器通常集中在数据中心。
- 应用程序:如浏览器、邮件客户端 (客户端程序) 和 Web服务程序 (服务器程序)。
- 作用:作为各种网络应用的载体。
2.4.2 2. 网络核心 (Network Core)
网络核心是连接所有边缘设备、负责数据交换的复杂网络。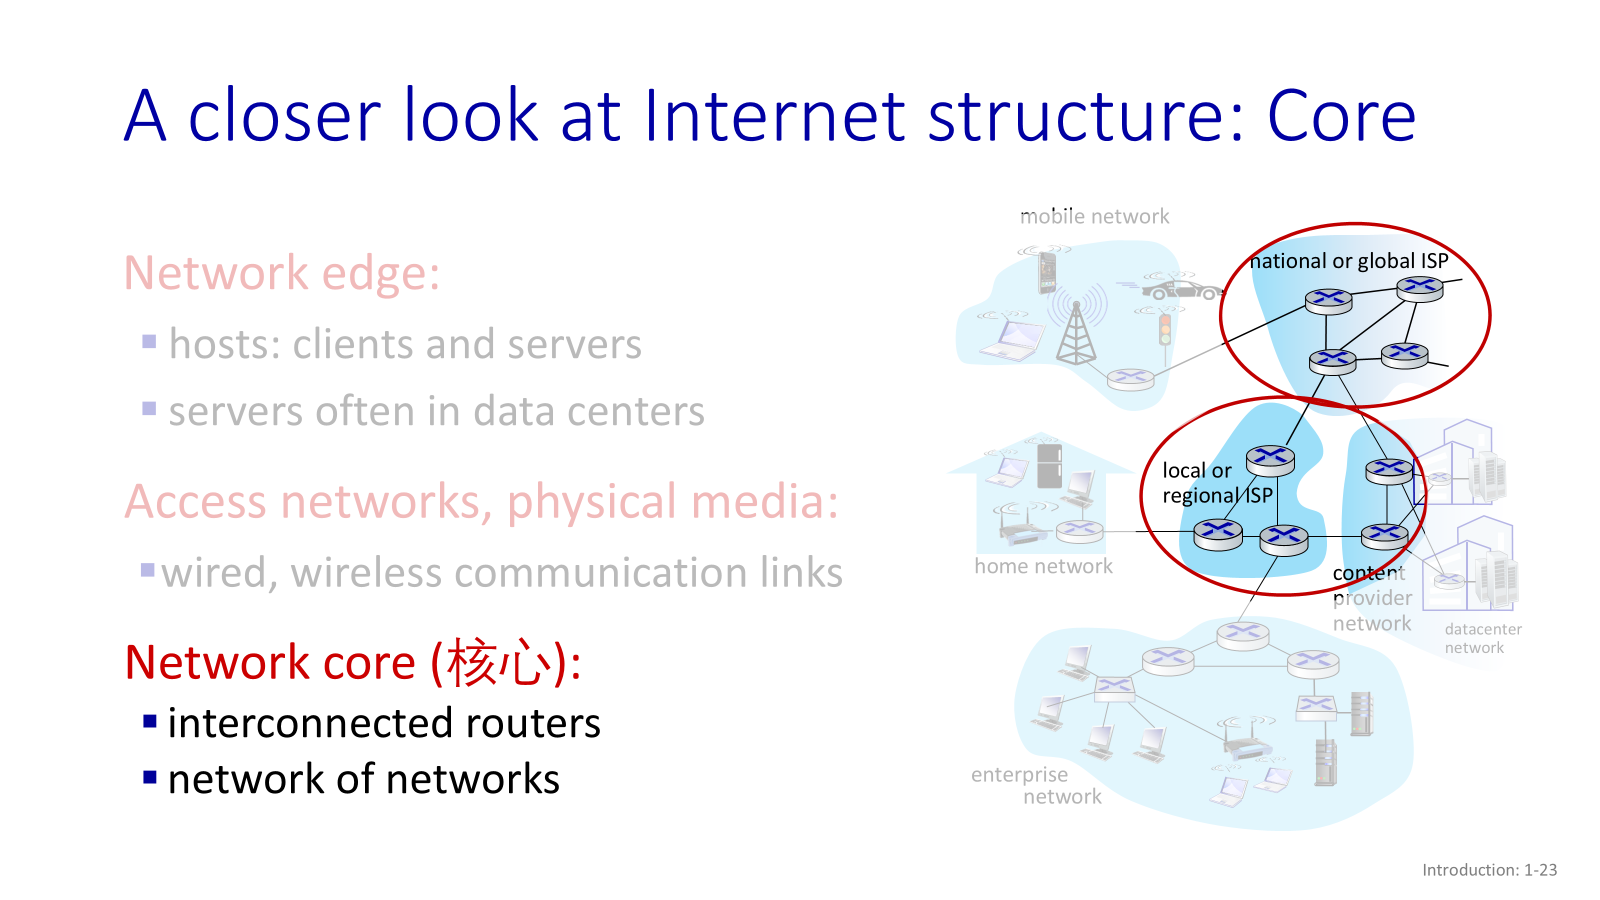
- 构成:由大量互连的路由器 (Router) 组成。
- 本质:“网络的网络 (network of networks)”。
- 作用:为边缘设备之间的通信提供数据交换(转发)服务。它构建了一个 可复用的高效网络,使得任意两个边缘设备都无需直接物理连接,而是通过核心网进行数据中转。
2.4.3 3. 接入网与物理媒体 (Access Networks & Physical Media)
接入网是连接“边缘”与“核心”的桥梁。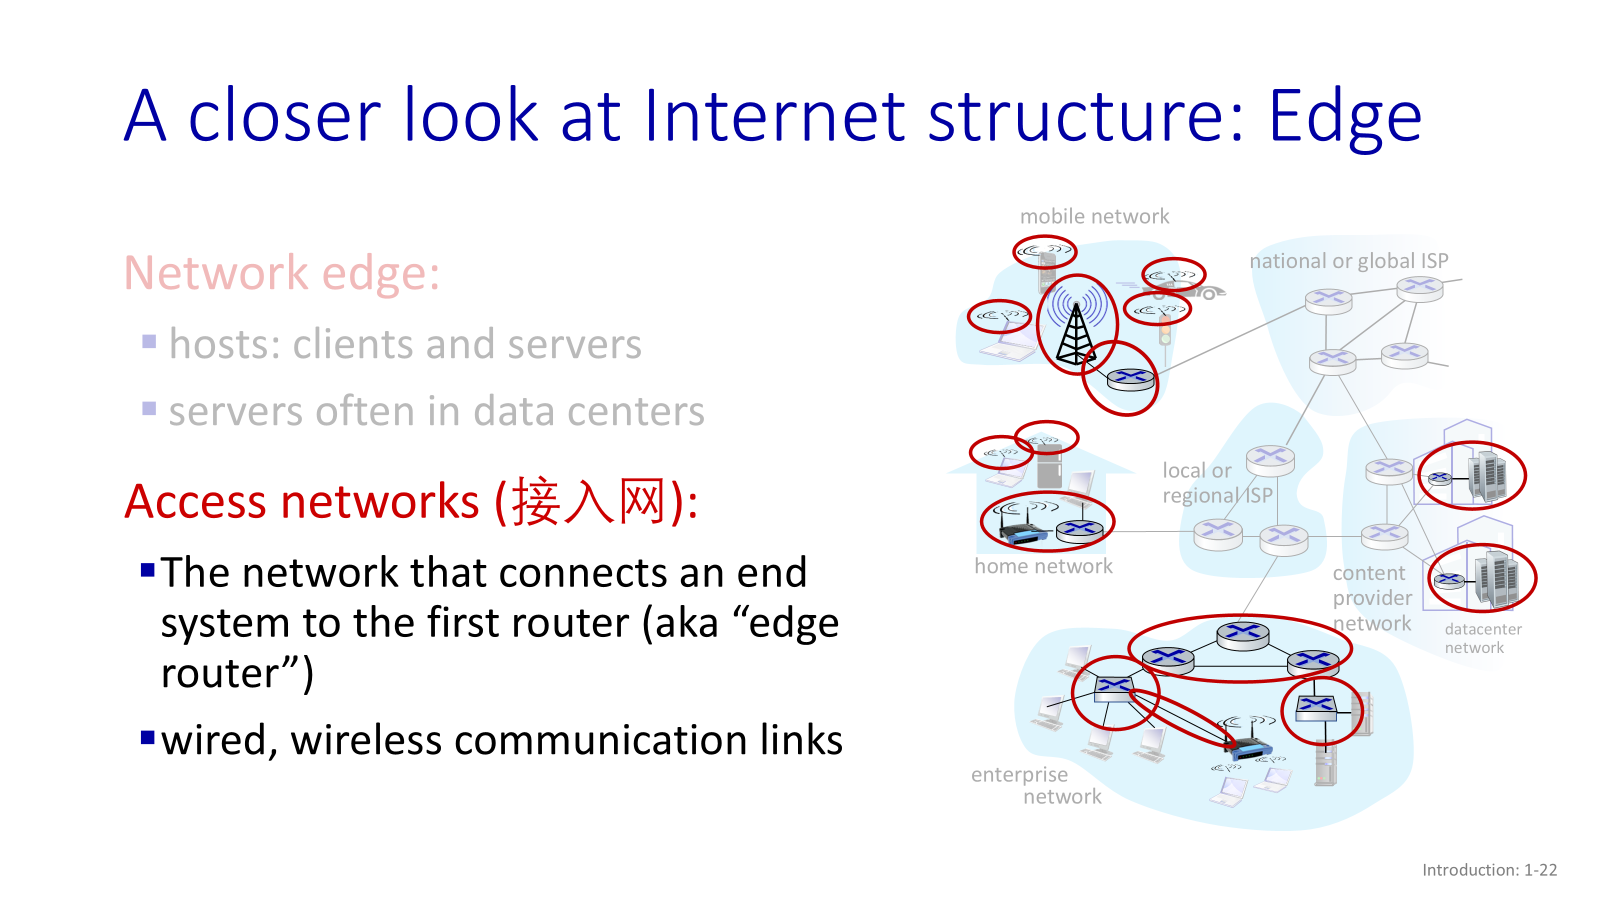
- 定义:将网络边缘的终端系统(主机)连接到网络核心的第一个路由器(也称“边缘路由器”)的网络。
- 构成:由各种有线或无线的通信链路组成。
- 例子:家庭网络中的DSL/光纤、校园网中的以太网、移动设备使用的蜂窝网络 (4G/5G) 等。
- 作用:提供从边缘到核心的接入通道。
3 网络边缘
- 分布式的应用以及支持分布式应用通信的基础设施(应用层下方的部分)
3.1 网络边缘的应用通信模式
在网络边缘,应用程序(进程)之间主要通过两种模式进行通信:
3.1.1 1. 客户/服务器 (Client/Server, C/S) 模式
这是一种主从 (Master-Slave) 模式,角色分工明确。
- 工作方式:
- 客户端 (Client):主动向服务器请求服务。
- 服务器 (Server):始终在线,被动地等待并响应来自客户端的请求,提供服务和资源。
- 特点:
- 所有资源都集中在服务器上。
- 是一种非对等的、中心化的架构。
- 例子:
- Web 应用:浏览器 (客户端) 向 Web 服务器请求网页。
- 电子邮件:邮件客户端 (如 Outlook) 向邮件服务器请求收发邮件。
- 缺点:
- 单点故障:如果服务器宕机,所有客户端都将无法获得服务。
- 可扩展性差:随着客户端数量激增,单一服务器容易成为性能瓶颈。
3.1.2 2. 对等 (Peer-to-Peer, P2P) 模式
这是一种去中心化的分布式模式。
- 工作方式:
- 网络中几乎没有或完全没有专用的服务器。
- 每个节点 (Peer) 的地位都是平等的,既可以作为客户端向其他节点请求服务,也可以作为服务器为其他节点提供服务。
- 特点:
- 分布式:资源和服务分散在各个节点上。
- 自扩展性:新加入的节点不仅带来服务需求,也带来了新的服务能力。
- 例子:
- 经典文件共享软件:Gnutella, KaZaA, Emule (电驴)。
- 现代下载工具:迅雷 (Thunder)。
- 优点:
- 鲁棒性高:不存在单点故障,单个节点的离线不影响整个网络的运行。
- 带宽聚集实现高效下载:以下载文件为例(如迅雷),客户端可以同时从多个持有该文件的其他对等节点 (A, B, C…) 分别下载文件的不同部分,将多个节点的上传带宽汇集起来,从而实现远超从单一服务器下载的速度。
下面讲讲基础设施给网络应用提供的服务的类型
3.2 基础设施为网络应用提供的通信服务
网络基础设施为上层的网络应用提供两种核心的通信服务方式:一种是面向连接的服务,另一种是无连接的服务。应用可以根据自身的需求来选择使用哪一种。
3.2.1 面向连接的服务 (TCP)
面向连接的服务,在应用进程之间正式通信前,需要先“握手”来建立连接。
这个准备过程不仅仅是两个应用打个招呼,更重要的是,底层的协议栈(如TCP协议实体)会为后续的通信分配并准备好必要的资源。这包括准备缓冲区、设置控制变量、配置超时定时器等。
3.2.1.1 面向连接 vs. 有连接
教师在这里进行了一个重要的区分:面向连接和有连接是有差别的。
面向连接(例如TCP)指的是连接状态仅仅由通信的两个端系统来维护。中间网络核心的路由器等设备并不知道这条连接的存在。
有连接则是一个更强的概念,它意味着不仅端系统,连同中间路径上的网络节点(路由器)也都会为这条通信维护状态。这个概念我们之后会再详细介绍。
3.2.1.2 TCP:传输控制协议
在互联网的协议中,TCP (Transmission Control Protocol) 就是提供面向连接服务的典型代表。它向上层应用提供了几个关键的特性。
3.2.1.2.1 1. 可靠的数据传输
TCP的核心目标是实现可靠性。下层网络(物理链路)的传输本身是不可靠的,信号在传输中可能会出错、丢失。TCP的职责就是依靠自身的努力,将下层不可靠的服务,转变为对上层应用可靠的服务。
可靠性意味着数据传输不重复、不丢失、不乱序。简单来说,就是发送方发的是什么,接收方收到的就是什么。
为了实现这一点,TCP内部有一系列复杂的机制,例如:对发送的数据进行缓存以便超时重传,对数据包进行编号以便接收方确认和排序等。这些机制我们会在后续传输层的课程中详细学习。
3.2.1.2.2 2. 流量控制
流量控制是用来协调发送方和接收方速度不匹配问题的。
老师举了一个例子:一个性能强大的服务器(至强)和一个五六年前的、处理能力很弱的旧手机(小强)通信。如果服务器发送速度太快,手机完全来不及处理,数据就会丢失。
TCP的流量控制机制能够让接收方的协议实体向发送方反馈自己的处理能力。如果接收方处理不过来,就会通知发送方“你慢点发”;如果接收方缓冲区很空闲,就会告诉发送方“你可以发快点”。
3.2.1.2.3 3. 拥塞控制
流量控制只考虑了端到端两者之间的关系,而拥塞控制则要考虑整个网络路径的状况。
网络中的链路是所有通信共同使用的公共资源。即便发送方和接收方处理能力都很强,但如果它们通信所经过的中间网络链路非常拥堵,数据包依然会被路由器丢弃。
TCP的拥塞控制特性能够感知网络路径的拥塞情况。如果路径通畅,它就允许应用发送得快一些;如果路径拥堵,它就会主动降低发送速率,告诉应用“路堵了,你慢点发”。
因此,采用TCP通信的应用,不仅通信前需要握手,通信过程中也自动具备了可靠性、流量控制和拥塞控制这三个重要特性。
3.2.1.3 使用TCP的应用
许多对可靠性要求高的应用都构建在TCP之上,因为TCP的可靠性让应用开发者无需再自己处理数据传输的复杂问题。
- HTTP (Web浏览)
- FTP (文件传输)
- Telnet (远程登录)
- SMTP (电子邮件)
3.2.2 无连接的服务 (UDP)
与TCP不同,无连接服务在通信前不需要握手建立连接。应用进程有数据时,直接就发送出去。
3.2.2.1 UDP:用户数据报协议
UDP (User Datagram Protocol) 是互联网中提供无连接服务的主要协议。它的特点可以概括为:
- 无连接:通信前不打招呼,上来就发。
- 不可靠:发出去了就不管了,“管他三七二十一”,丢了就丢了。
- 无流量控制:不管接收方处理能力如何。
- 无拥塞控制:不管网络路径是否拥堵。
3.2.2.2 为什么需要UDP?
听到UDP有这么多“缺点”,我们可能会问:“那要你何用?”。其实,这些特点对某些特定应用来说,恰恰是优点。协议没有好坏之分,只有适合与不适合。
1. 简单、快速、开销小 TCP为了做到可靠和“体贴”(考虑对方和网络),自身需要付出很多努力(编号、排序、重传等),这些都会消耗时间。老师将TCP比作一个“多愁善感”的协议。对于实时多媒体应用(如视频电话),这种时间代价是无法接受的。
2. 适合事务性应用 对于一些交互非常简短的应用,比如DNS域名查询,就是一次请求、一次应答。如果使用TCP,为了这一次简单的交互,却要先进行三次握手建立连接,结束后还要挥手断开连接,显得非常浪费和笨重。
3. 应用层拥有更多控制权 UDP没有流量和拥塞控制,这意味着上层应用产生数据的速度有多快,数据就能以多快的速度被注入网络。这对于实时多媒体应用非常合适,因为这类应用的数据产生速率是相对固定的,它不希望被协议层“卡脖子”。
虽然UDP本身不可靠,但它提供了一个最基础的服务:通过端口号,将主机到主机的通信细化为了进程到进程的通信。
3.2.2.3 使用UDP的应用
- 流媒体
- 远程会议、Internet电话
- DNS (域名系统)
4 网络核心
4.1 网络核心简介
网络核心由交换节点(如路由器)和连接它们的链路组成,其最主要的作用是实现数据交换。简而言之,就是确保由源主机发出的数据能够被正确地传送到目标主机。
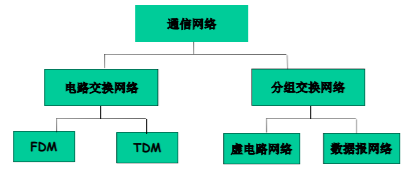
实现数据交换功能主要有两种方式:
- 电路交换 (Circuit Switching):这是一种较为传统的方式,主要应用于电话网。
- 分组交换 (Packet Switching):这是现代互联网和几乎所有计算机网络采用的方式。
虽然我们主要学习分组交换,但了解电路交换能帮助我们进行对比,从而更深刻地理解分组交换的工作原理。
4.2 电路交换 (Circuit Switching)
电路交换的工作方式类似于拨打固定电话。在双方正式通信之前,网络必须首先为这次通话建立一条专用的、独享的物理线路。只有当这条线路建立完毕后,双方才能开始通信。
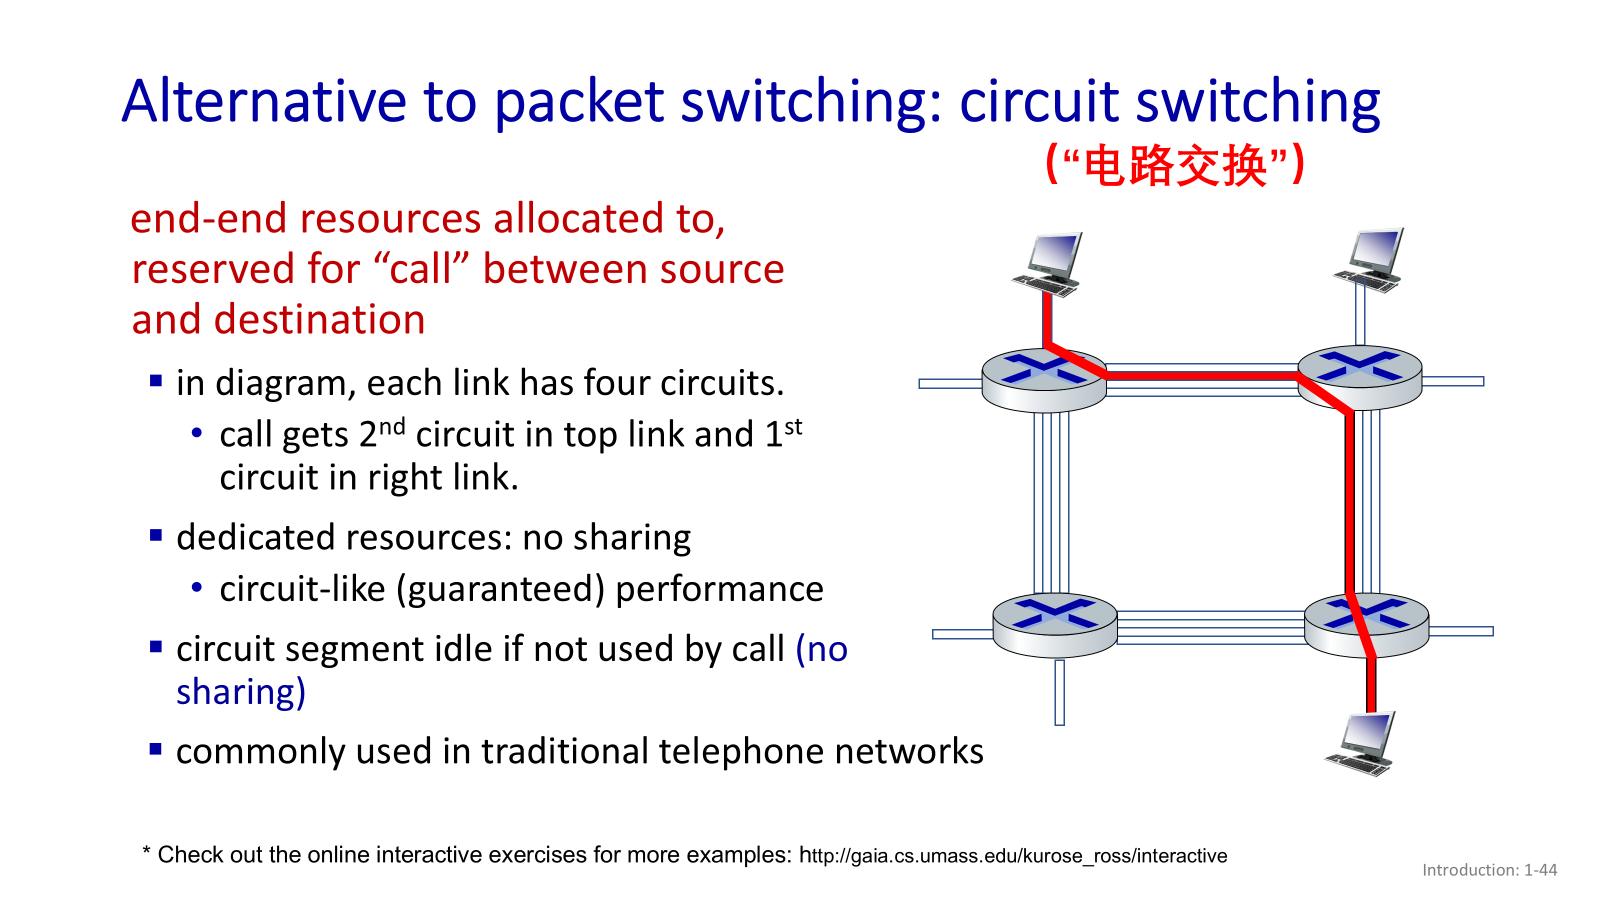
end-end resources allocated to, reserved for “call” between source and destination
- in diagram, each link has four circuits.
- call gets 2nd circuit in top link and 1st circuit in right link.
- dedicated resources: no sharing
- circuit-like (guaranteed) performance
- circuit segment idle if not used by call (no sharing)
- commonly used in traditional telephone networks
4.2.1 工作原理与资源分配
在电路交换网络中,通信资源(如带宽)是预先分配的。网络会通过一个“信令系统”(例如,我们拨号的过程)在核心网络中为通信双方分配并连接出一条独享的端到端线路。
节点之间的链路通常拥有很高的带宽,网络会通过特殊技术将其“切”成若干个小片 (pieces)。当需要建立连接时,信令系统会在每一段链路上挑选一个当前空闲的“小片”,并将它们串联起来,构成一条完整的、从源到目标的独享通路。
- 独享资源:一旦这条线路分配给某次通话,它就完全归这次通话使用,其他任何人都无法使用,即使通话双方沉默不语,线路也会被持续占用。
- 性能保障:因为资源是独享的,所以不存在资源竞争。如果分配的带宽是 64Kbps,那么用户就能稳定地获得 64Kbps 的速率,性能有绝对的保障。
4.2.2 资源分片 (Multiplexing)
将一个高带宽的链路切分成多个小片(即多个信道)的技术称为多路复用。主要有以下几种方式:
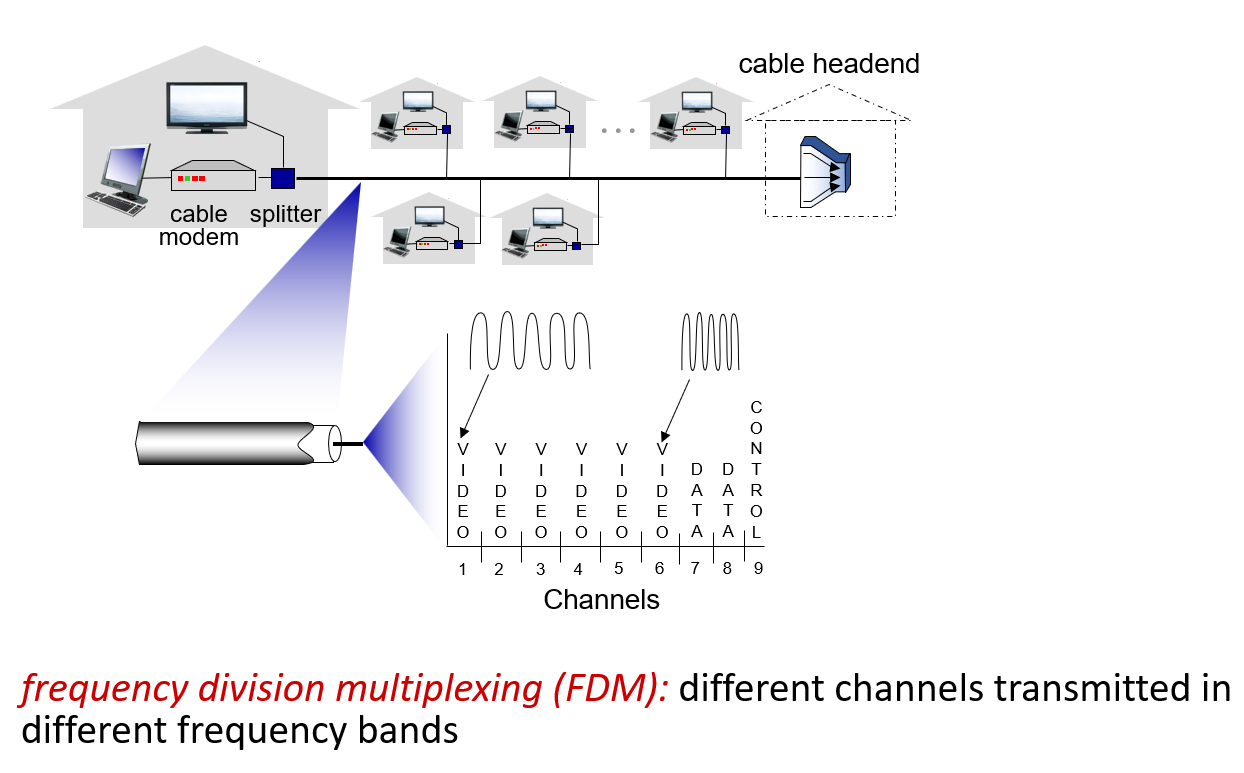
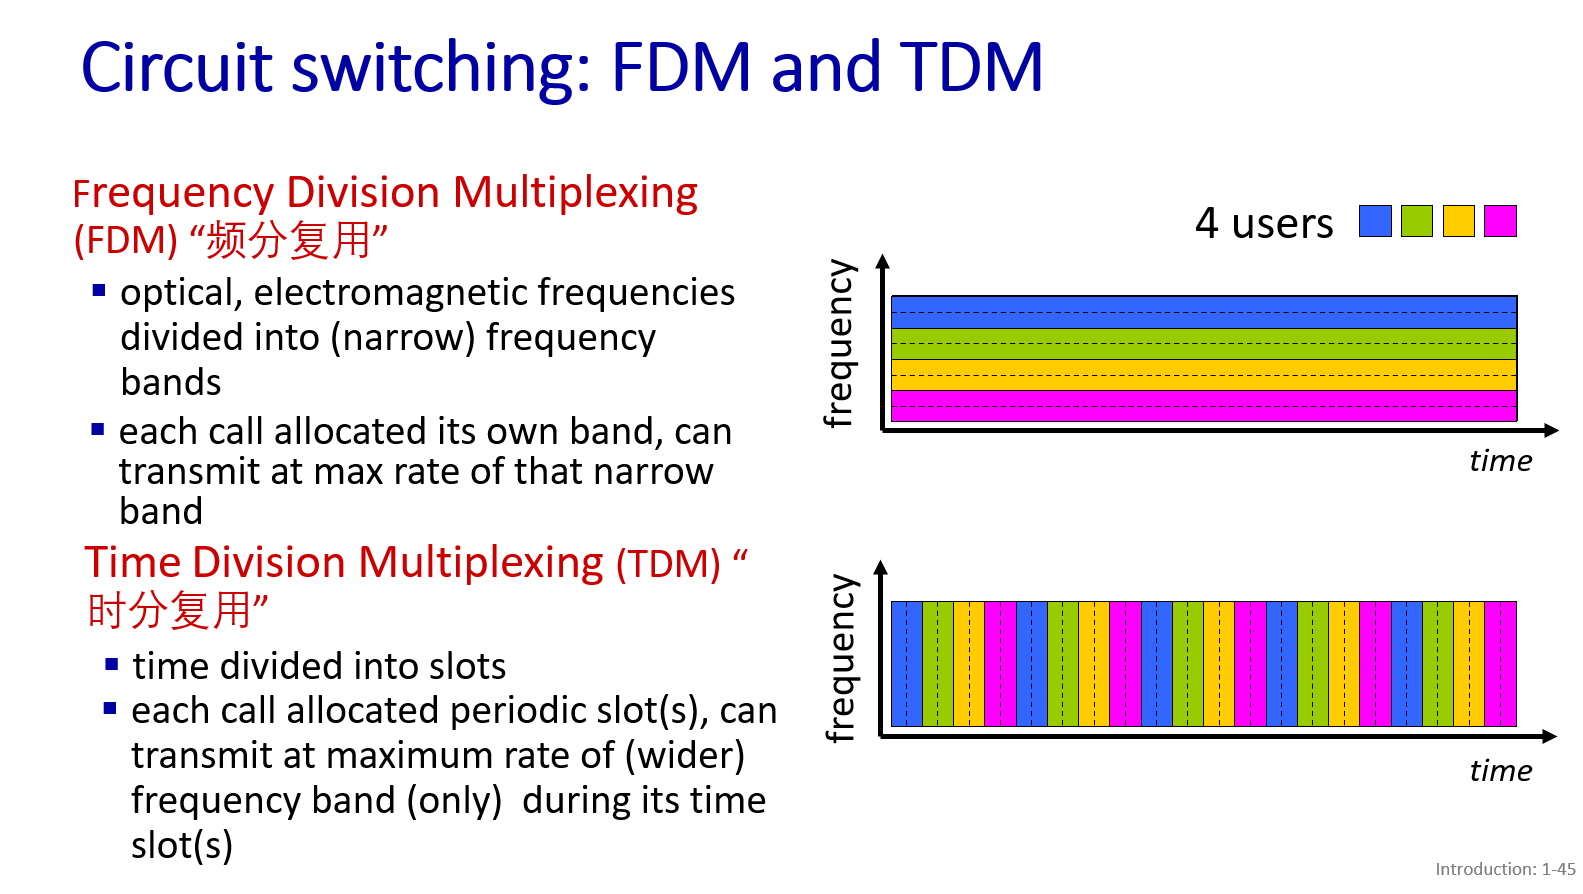
- 频分多路复用 (FDM - Frequency-Division Multiplexing):将链路的总频率范围分割成若干个较小的频段,每个频段分配给一个用户。
- 时分多路复用 (TDM - Time-Division Multiplexing):将通信时间划分为循环的周期(或帧),每个周期再分割成若干个时间片(时隙),每个用户固定使用其中一个时间片。
其他补充的
波分多路复用 (WDM - Wavelength-Division Multiplexing):应用于光纤通信,将不同波长(颜色)的光信号在同一根光纤中传输,每个波长可承载一路独立的通信。
码分多路复用 (CDM - Code-Division Multiplexing):主要用于接入网(如3G移动通信的CDMA),通过为每个用户分配独特的编码来区分信号。
4.2.3 优点与缺点
优点:性能保障
- 由于线路是独享的,分配到的带宽(如64 Kbps)是恒定且有保障的,通信性能稳定,没有不确定性。因为没有其他用户与你争抢资源。
缺点:资源浪费
-
一旦电路建立,无论双方是否在通话或传输数据,资源都会被持续占用。例如,通话中的沉默或者误拨通的电话,都会持续计费,因为独享的线路资源被占用了。
-
这对于具有“突发性”的计算机通信尤其不适合。用户上网时,并非持续不断地传输数据,而是在点击链接、加载页面时产生突发流量。在浏览、阅读等无数据传输的间隙,独享线路就会被闲置和浪费。
4.2.3.1 为何不适用于计算机通信?
电路交换非常不适合计算机之间的通信,主要原因有两点:
-
连接建立时间过长:电路交换的连接建立时间通常是秒级的。对于持续数分钟或数小时的通话,这点时间可以忽略。但计算机通信往往是短暂的,可能建立连接花了500毫scss,而数据传输本身只需要1毫秒,这显得非常低效。
-
计算机通信的突发性 (Bursty):计算机的网络活动不是持续的,而是时断时续的。例如,你点一个链接时会产生大量流量,但阅读网页时则几乎没有流量。如果为这种突发性通信建立一条独享线路,那么在没有流量的绝大部分时间里,宝贵的网络资源都会被闲置和浪费。
4.2.4 计算举例:文件传输时间
问题:在一个电路交换网络上,从主机A到主机B发送一个640,000比特的文件需要多长时间?
- 所有链路的总速率为 1.536 Mbps
- 每条链路使用时分多路复用 (TDM),且划分为24个时隙 (time slots)
- 建立端到端电路所需时间为 500 ms
解答:
- 计算单个用户可用带宽:由于采用了TDM将总带宽分给24个用户,每个用户实际获得的带宽是总带宽的1/24。
- 可用速率 = 1.536 Mbps / 24 = 0.064 Mbps = 64 kbps
- 计算传输时间:用文件大小除以可用速率。
- 传输时间 = 640,000 bits / 64,000 bps = 10 秒
- 计算总时间:总时间是电路建立时间和数据传输时间之和。
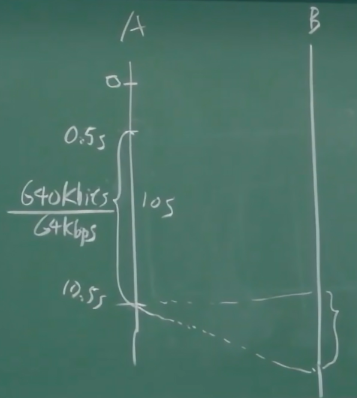
- 总时间 = 500 ms + 10 s = 0.5 s + 10 s = 10.5 秒
原笔记
看到TDM,分成多个时槽,每个用户使用一个时槽
- bps就是每秒的字节数,分成时槽之后就按照时槽的数目进行划分即可
- 每条链路的速率(一个时间片): 1.536Mbps/24 =64kbps传输时间:640kb/64kps = 10s
- 共用时间:传输时间+建立链路时间=10s + 500ms = 10.5s
- 10.5s并不一定传完,还要加上最后电磁波传输的时间(传播延迟)
时间上的传输图如下
4.2.5 拓展内容:传输延迟与传播延迟
教师特别指出,上述计算出的10.5秒,指的是发送方A将文件的最后一个比特发送出去所花费的时间。这并不意味着接收方B在10.5秒时就收到了所有数据。
这里需要区分一个重要概念:传播延迟 (Propagation Delay)。它是指电磁波信号在物理介质(如光纤、铜缆)中传播所花费的时间,等于 距离 / 传播速率(传播速率约等于光速)。
- 在局域网(LAN)中,距离很短,传播延迟可以忽略不计。
- 在广域网(WAN)或卫星通信中,距离很长(几千甚至几万公里),传播延迟则不可忽略。
因此,接收方B接收到最后一个比特的准确时间,应该是 10.5秒 + 传播延迟。
4.3 分组交换 (Packet Switching)
分组交换是为应对计算机通信的突发性而设计的。它不预先分配独享资源,而是采用按需共享的方式。
4.3.1 工作原理
- 不划分资源:节点间的链路不再被细分为小片。当一个用户需要传输数据时,它可以使用链路的全部带宽。
- 数据分包:待传输的大块数据(如文件)被分割成一个个较小的数据单元,称为分组 (Packet)。
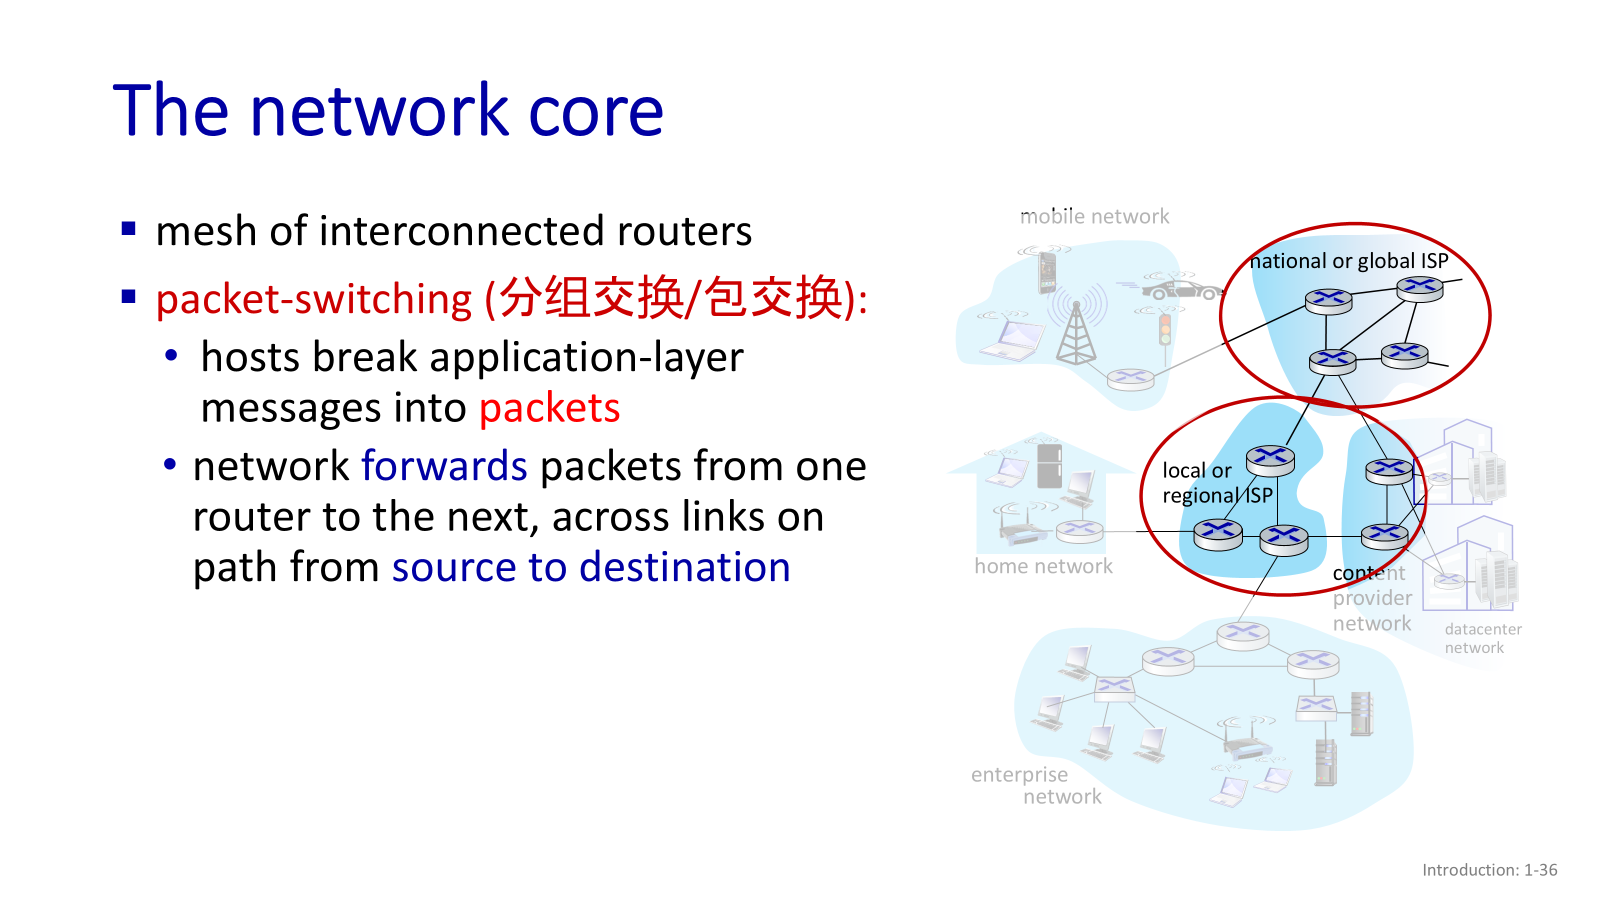
- 存储转发 (Store-and-Forward):每个分组在网络中的交换节点(如路由器)被独立处理。节点必须完整地接收整个分组,将其存储下来,然后根据分组的目标地址查询路由表,决定下一步发往哪个节点,最后再将其转发出去。
鉴于电路交换的种种弊端,现代计算机网络普遍采用分组交换。它不再为通信双方预留独享资源,而是让所有用户共享网络资源,并按需使用。
传输延迟的定义
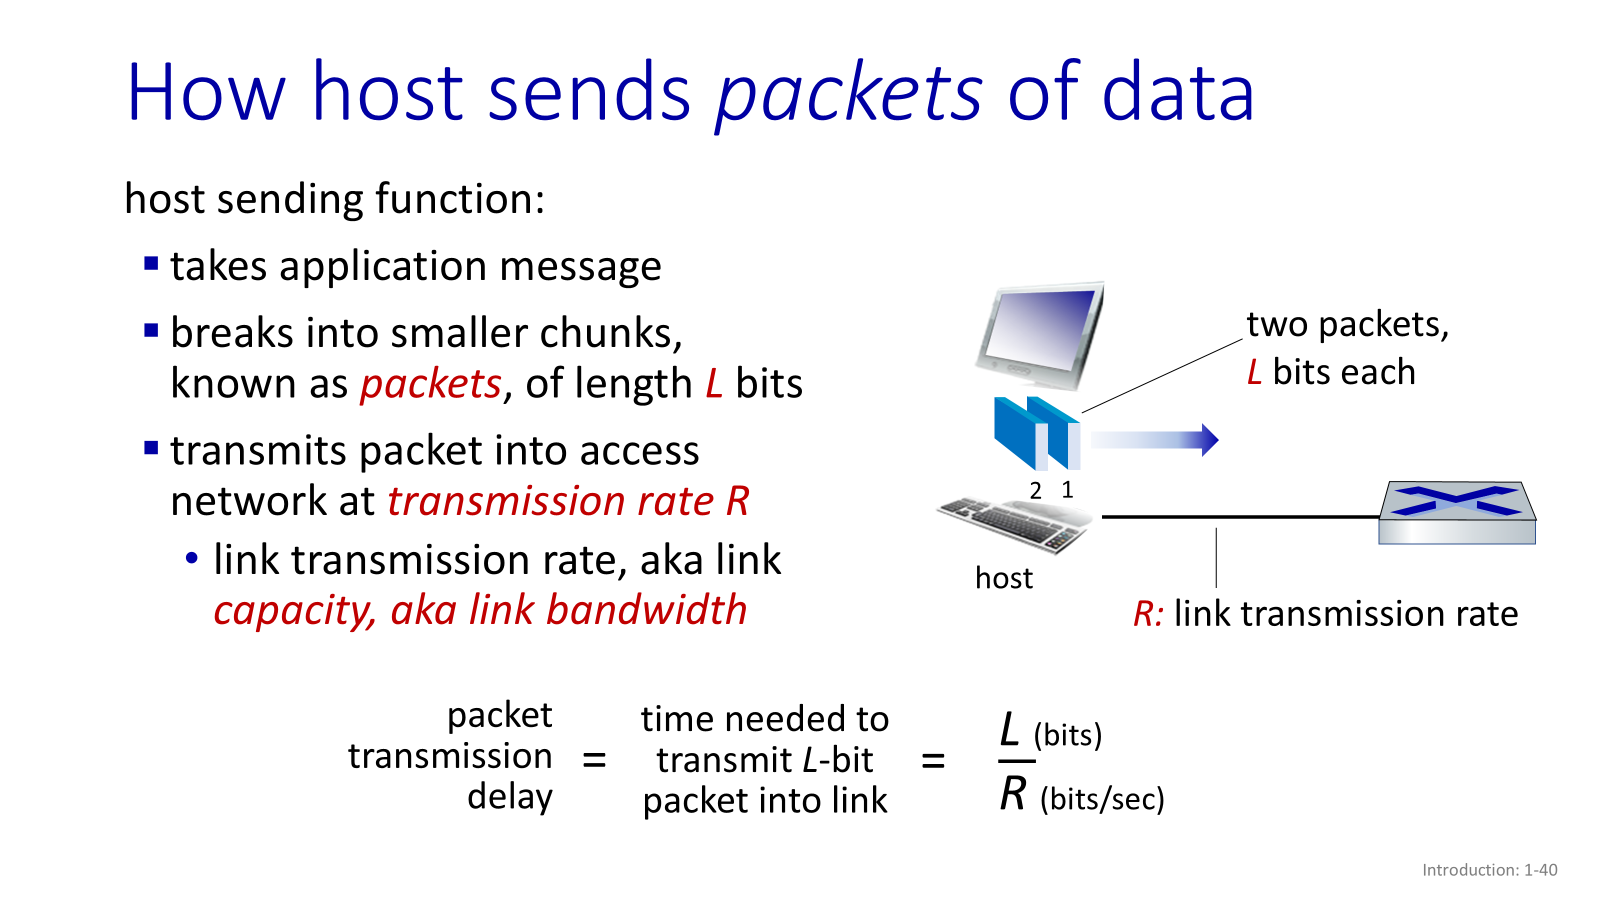
host sending function:
- takes application message
- breaks into smaller chunks, known as packets, of length bits
- transmits packet into access network at transmission rate
- link transmission rate, aka link capacity, aka link bandwidth
计算举例:存储转发的耗时
问题:一个大小为 7.5 Mbits 的分组,通过两个路由器(即三段链路)从A发送到B。所有链路的带宽都是 1.5 Mbps。总共需要多长时间?
解答:
- 计算一跳的传输时间:在一小段链路上,传输一个分组所需的时间为 分组大小 / 链路带宽。
- 单跳时间 = 7.5 Mbits / 1.5 Mbps = 5 秒
- 计算总时间:由于采用存储转发机制,每一跳都需要花费完整的5秒钟。分组必须先用5秒到达第一个路由器,然后这个路由器再用5秒把它发给第二个路由器,最后第二个路由器再用5秒发给B。
总时间 = 3 跳 * 5 秒/跳 = 15 秒
教师在这里强调了一个易错点:不能将发送和接收的时间重复计算。一个链路上的传输耗时5秒,这既是发送方花费的发送时间,也是接收方花费的接收时间,它们是同一个过程的两个方面。
张渊课件的例子
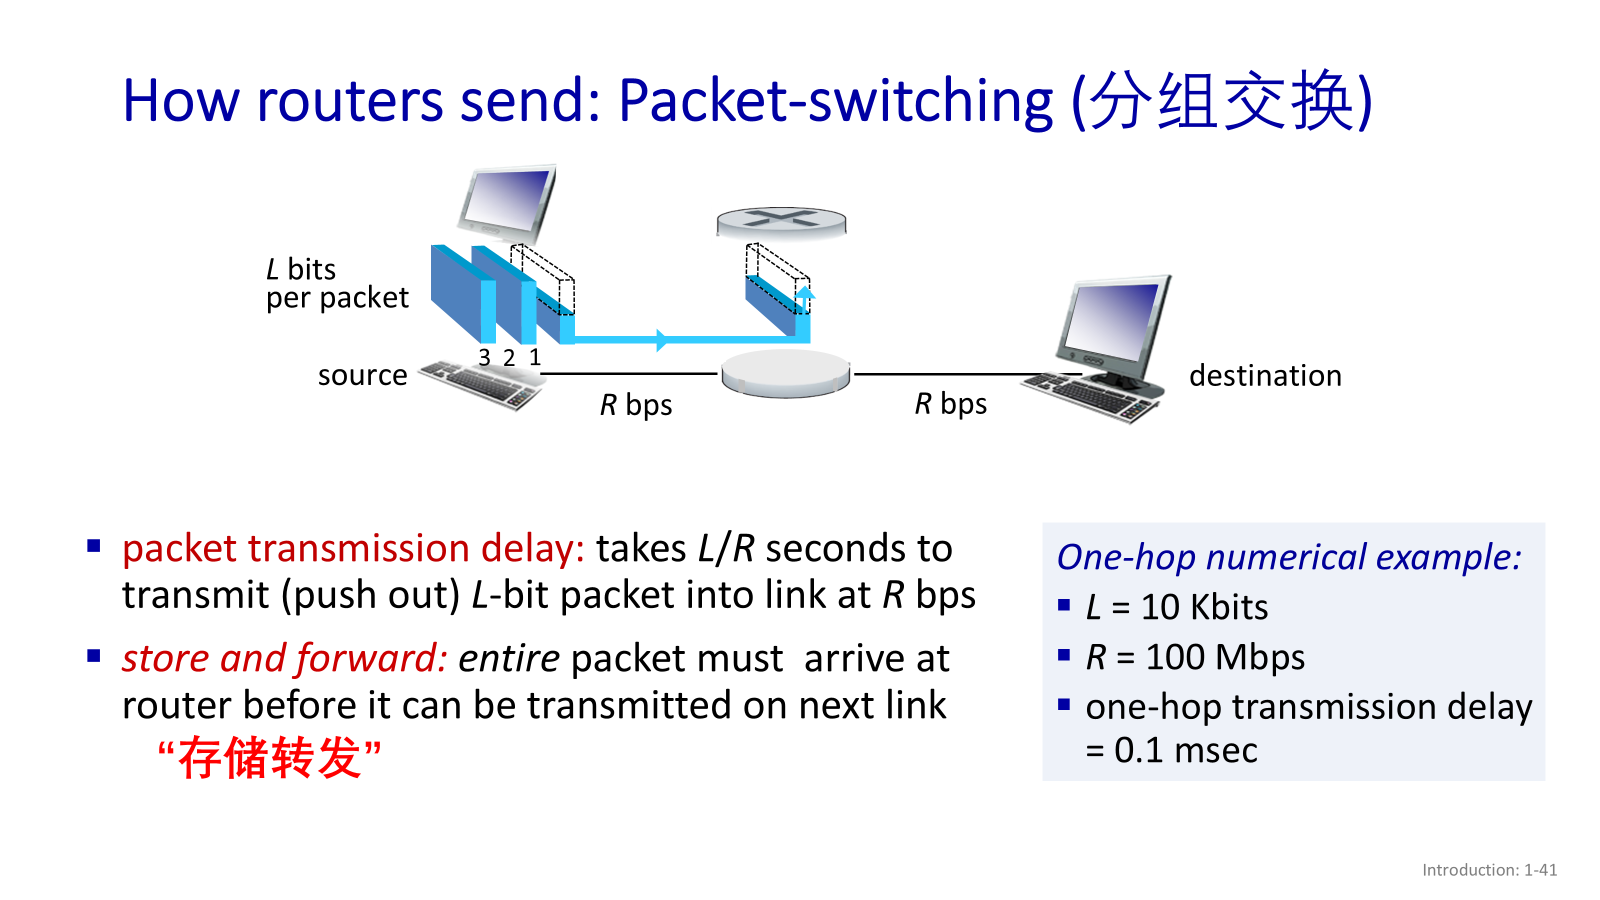
- packet transmission delay: takes seconds to transmit (push out) -bit packet into link at bps
- store and forward: entire packet must arrive at router before it can be transmitted on next link
“存储转发”One-hop numerical example:
- Kbits
- Mbps
- one-hop transmission delay = 0.1 msec
4.3.2 优缺点
优势
- 分组交换最大的优势就是资源共享和高效性。网络资源是按需分配的,只有当你有数据要发送时,你才会占用网络资源。这极大地提高了网络利用率,使得同样规模的网络可以支持更多的用户。
缺点:延迟与丢失
为了换取资源共享的高效性,分组交换也付出了相应的代价,主要体现在两个方面:
- 排队延迟 (Queuing Delay):由于资源是共享的,当多个分组在同一时间到达同一个路由器,并希望从同一个出口链路转发出去时,它们必须排队等待。这个排队等待的时间是不确定的、可变的,取决于当时网络的拥堵情况。
- 分组丢失 (Packet Loss):路由器的缓存空间(用于存储排队分组的内存)是有限的。如果网络瞬间过于拥堵,导致到达的分组数量超过了路由器的处理能力,缓存被占满,那么新到达的分组就会被路由器丢弃 (drop)。
总而言之,不可预测的排队延迟和可能发生的分组丢失,是分组交换为实现网络共享而必须付出的代价。
- 适合于对突发式数据传输
- 资源共享
- 简单,不必建立呼叫
- 过度使用会造成网络拥塞:分组延时和丢失
- 对可靠地数据传输需要协议来约束:拥塞控制
- Q: 怎样提供类似电路交换的服务?
- 保证音频/视频应用需要的带宽
- 一个仍未解决的问题(chapter 7)
4.3.3 Packet-switching: queueing(排队)
Queueing occurs when work arrives faster than it can be serviced:
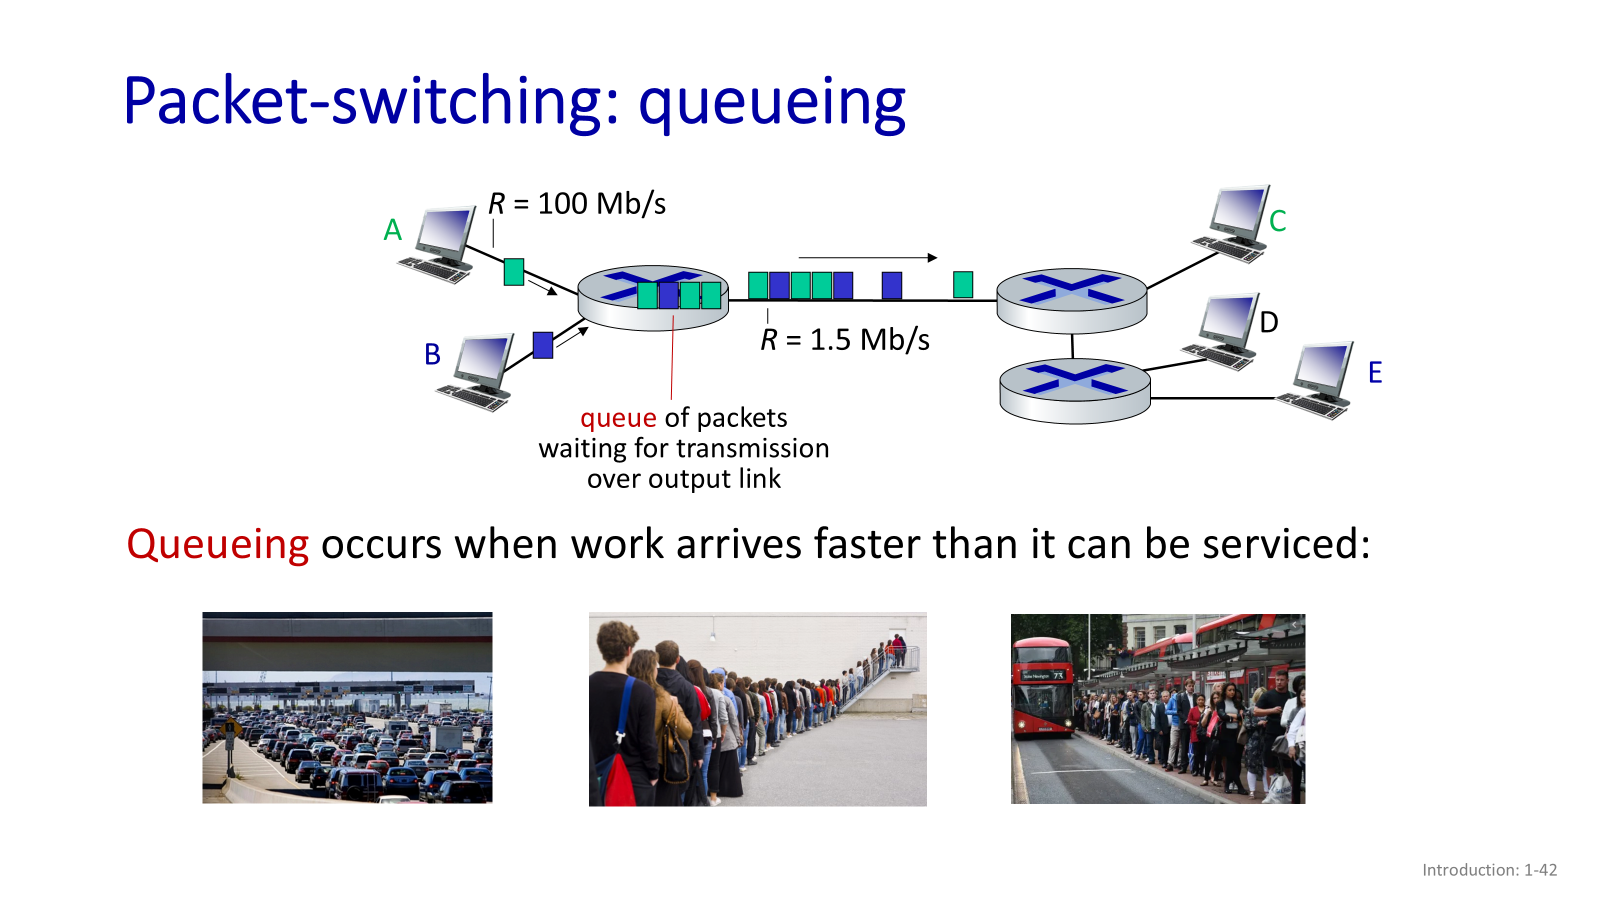
Packet queuing and loss: if arrival rate (in bps) to link exceeds transmission rate (bps) of link for some period of time:
- packets will queue, waiting to be transmitted on output link
- 丢包: packets can be dropped (lost) if memory (buffer) in router fills up
4.3.4 网络核心的关键功能:转发与路由
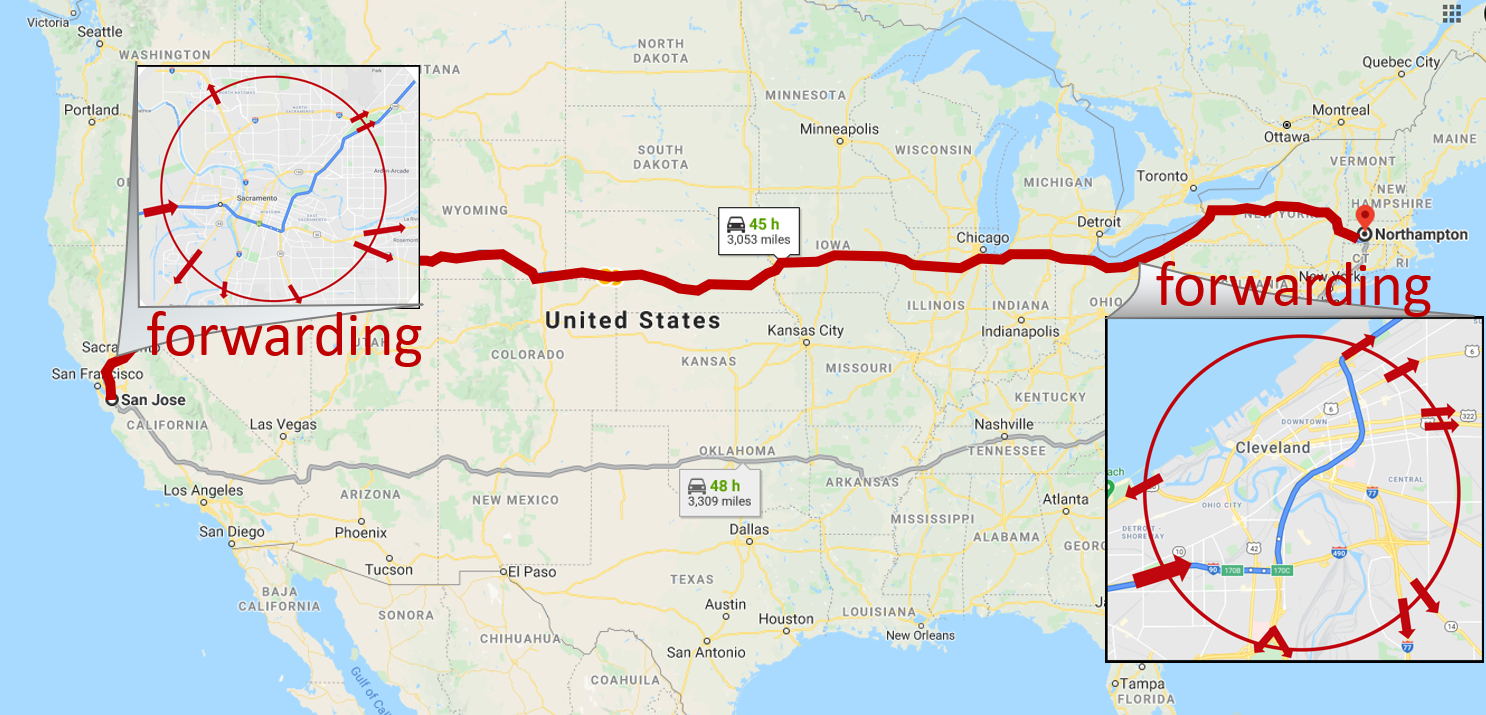
在像IP网这样的分组交换网络中,网络核心设备(如路由器)主要执行两个核心功能:转发 (Forwarding) 和 路由 (Routing)。
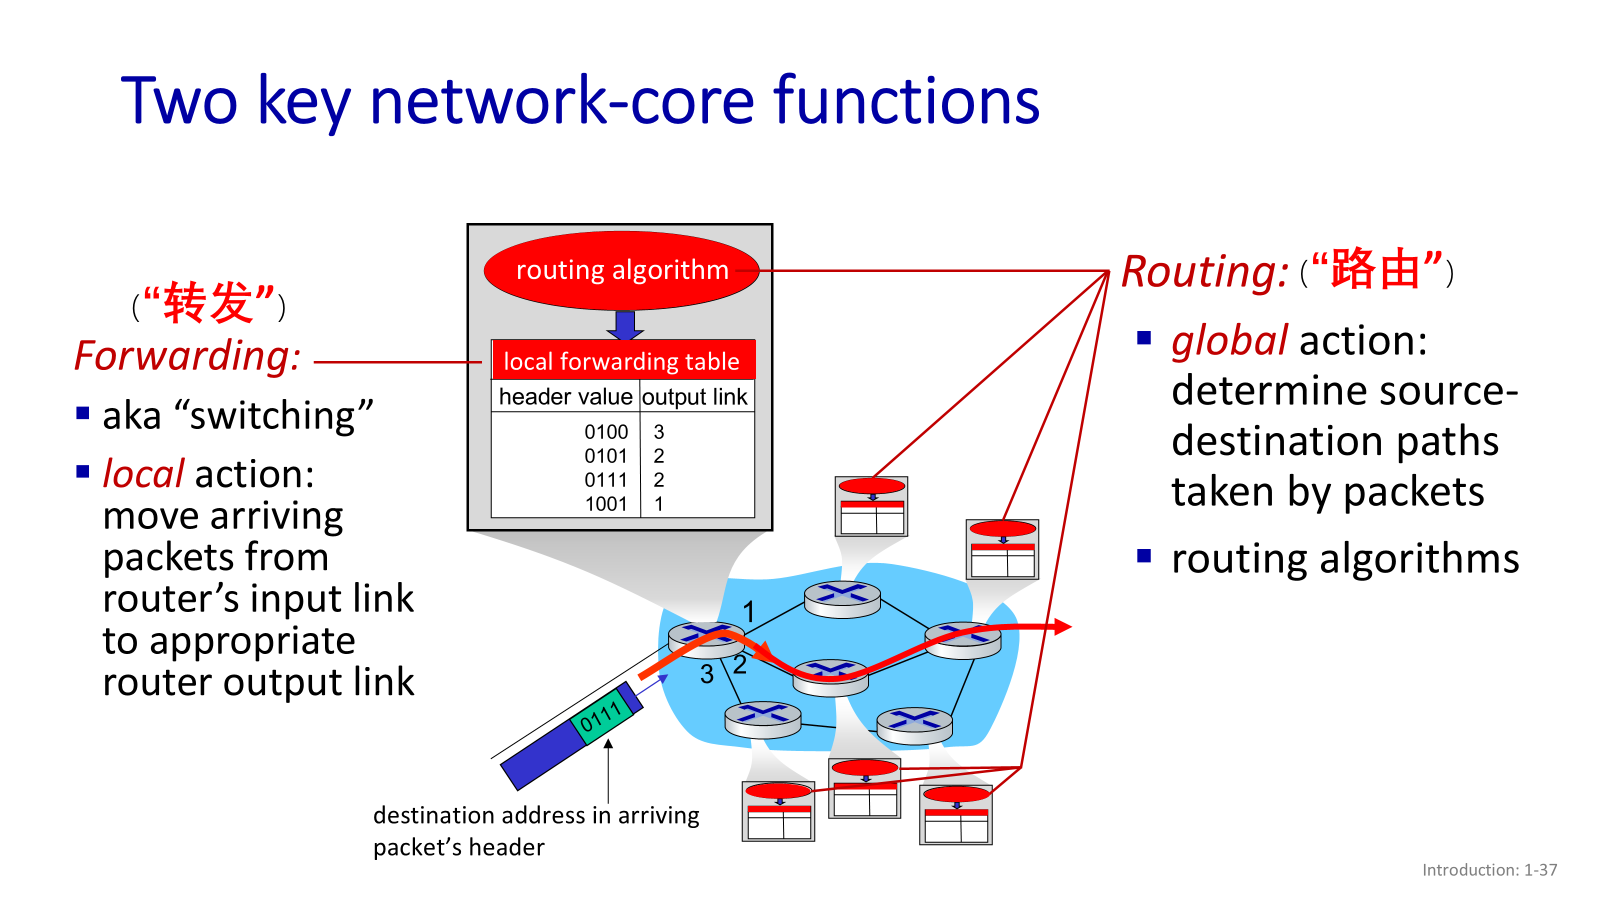
转发是一个局部的、具体的操作。当一个数据分组(Packet)到达路由器的某个输入端口时,路由器会检查分组的头部信息,查询一个名为“转发表”的表格,并根据查表结果,将该分组从正确的输出端口发送出去。这个过程可以理解为“存储-转发”,即先把分组完整地接收并存储下来,然后决定其去向并发送。
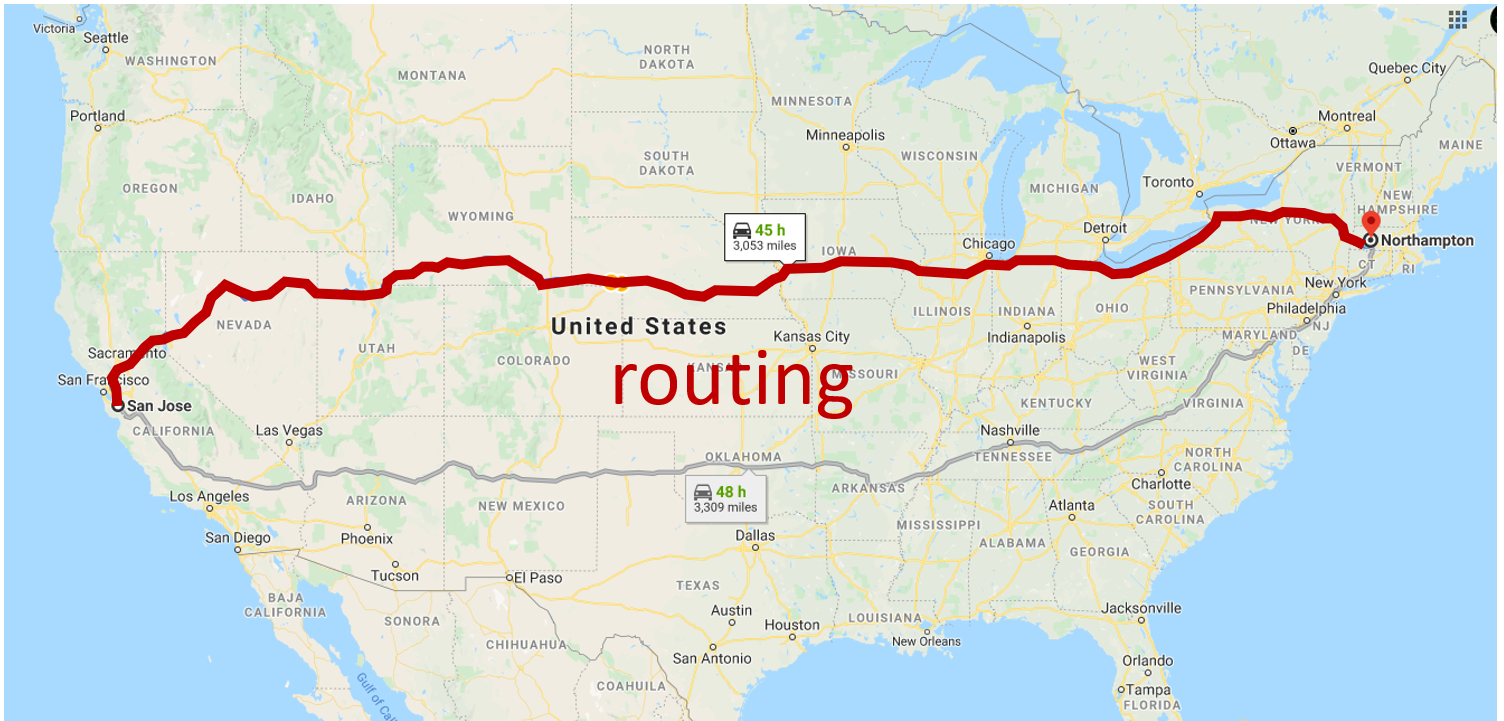
路由则是一个全局性的、宏观的过程。网络中的所有路由器会通过运行特定的路由算法(Routing Algorithm),彼此交换网络状态信息(例如哪些链路是通的,代价是多少等)。基于这些信息,每个路由器会计算出到达网络各个目的地的最佳路径,并依据这些路径来构建或更新自己的“转发表”。
因此,路由负责“决定路径”并生成“地图”(转发表),而转发则负责根据这份“地图”来“引导”每一个到达的分组。正是通过网络中所有路由器上转发和路由功能的相互配合,数据才能从源主机成功地送达到目标主机。
4.3.5 统计多路复用
分组交换本质上也是一种时分复用,但它与TDM的固定时间片分配不同。在分组交换中,链路的时间资源是按需分配的:某个时间段可能传输A的分组,下一个时间段传输B的分组,再下一个时间段可能空闲。
这种基于需求的、动态的资源分配方式被称为统计多路复用 (Statistical Multiplexing)。
4.4 对比
4.4.1 比较电路交换与分组交换
| 特性 | 电路交换 (Circuit Switching) | 分组交换 (Packet Switching) |
|---|---|---|
| 核心思想 | 资源预留。通信前必须建立一条专用的端到端物理(或逻辑)路径。 | 存储转发与统计复用。数据被切分成“分组” (Packet) 进行传输。 |
| 连接建立 | 必须。在数据传输前有明确的“呼叫建立”阶段,用于预留资源。 | 不一定。<ul><li>数据报 (Datagram) 方式:无需建立连接,每个分组独立选路。</li><li>虚电路 (Virtual Circuit) 方式:需要建立逻辑连接。</li></ul> |
| 资源分配 | 独占资源。一旦连接建立,该连接将独占所分配的带宽,无论是否在发送数据。 | 共享资源。所有用户动态共享网络资源。仅在需要发送分组时才占用链路。 |
| 带宽利用率 | 低。即使用户没有数据发送,预留的信道也处于空闲状态,造成带宽浪费。 | 高。通过统计复用(Statistical Multiplexing),链路带宽被多个用户高效共享。 |
| 服务质量 (QoS) | 有保证。由于资源独占,一旦连接建立,时延固定且无拥塞,数据传输速率恒定。 | 无保证(尽力而为 Best-Effort)(特指数据报方式)。时延可变(有排队时延),可能因网络拥塞导致分组丢失或延迟抖动。 |
| 数据传输 | 数据以连续比特流的形式在专用路径上传输,中间节点不进行存储。 | 数据以离散的分组进行“存储-转发”,每个中间节点(路由器)接收整个分组,检查后,再转发到下一跳。 |
| 主要应用 | 传统电话网 (PSTN)、ISDN。 | 互联网 (Internet)、以太网 (Ethernet)、ATM、帧中继。 |
| 计费方式 | 通常按连接时长和距离计费(如传统电话费)。 | 通常按传输的数据量计费(如手机流量费)。 |
总结:
- 电路交换适用于需要实时、固定速率通信的业务(如传统语音电话),但代价是资源利用率低。
- 分组交换通过资源共享,极大地提高了网络利用率,非常适合突发性的数据通信(如网页浏览、电子邮件),是现代计算机网络(尤其是互联网)的基石。
4.4.2 举例分析
一个核心的结论是:在同样的网络资源下,分组交换比线路交换(或电路交换)能支持更多的用户。这个优势在用户的通信行为具有突发性 (Bursty) 的情况下尤其明显。
场景设定:
- 有一条带宽为 1 Mb/s 的共享链路。
- 每个用户在“活跃”时,需要 100 kb/s 的传输速率。
- 用户的通信是突发性的,每个用户只有 10% 的时间是活跃的 (即活跃概率 p = 0.1)。
1. 采用线路交换 (Circuit Switching)
在线路交换模式下,系统必须为每个用户预留其活跃时所需的全部带宽。因此,该链路最多能支持的用户数量为:
一旦10个用户连接,无论他们是否在传输数据,网络资源就已耗尽,无法再接纳新的用户。
2. 采用分组交换 (Packet Switching)
在分组交换模式下,资源是共享的。我们来分析一下,当网络中有35个用户时会发生什么。
因为链路总带宽是 1 Mb/s,所以只要同时活跃的用户数量不超过10个(10 * 100 kb/s = 1 Mb/s),网络就能正常处理。只有当活跃用户数达到11个或更多时,所需的总带宽才会超过链路容量,从而产生问题。
利用概率论,我们可以计算出有11个或更多用户同时活跃的概率。这个概率非常小,计算结果约为 0.0004(即0.04%)。
这意味着,在有35个用户的情况下,网络有 99.96% 的时间是能够正常运行的(即同时活跃的用户数 ≤ 10)。仅仅在约0.04%的极小概率下,网络才会面临超出负荷的风险。由此可见,分组交换极大地提高了网络资源的利用率,支持了远超线路交换的用户数量。
拓展与深入理解
教师在讲解中补充了两个非常重要的现实考量:
流量强度与实际容量(解释为啥是上标是10)
教师提到,在实际网络中,当流量强度 (Traffic Intensity) 等于1时,即数据包的到达速率恰好等于链路的处理速率时,系统会变得极不稳定,延迟会趋向于无穷大,最终导致网络“挂掉”。
因此,在设计和评估网络时,不能满打满算。一个健康的系统需要留有余量。所以,在前面的例子中,更严谨的计算应该以确保不超过9个用户同时活跃为目标,而不是10个。
队列在拥塞中的作用
你可能会问:“即使只有0.04%的概率会出问题,那不还是会出问题吗?” 教师解释说,分组交换设备(如路由器)内部有队列 (Queue),也就是缓存。
在网络面临那0.04%的“艰难时刻”,即瞬间到达的数据量超过了链路的处理能力时,超出的数据包并不会立即被丢弃,而是会被暂时存放在队列中排队等待。
而在那99.96%的“轻松时刻”,链路的负载较低,路由器就可以利用空闲时间,将队列中积压的数据包发送出去。通过这种“削峰填谷”的方式,队列帮助网络平稳地度过短暂的突发拥塞,使得系统在宏观上依然能够稳定支持35个用户。
Packet switching versus circuit switching(张渊)
example:
- 1 Gb/s link
- each user:
- 100 Mb/s when “active”
- active 10% of time
Q: how many users can use this network under circuit-switching and packet switching?
- circuit-switching: 10 users
- packet switching: with 35 users, probability > 10 active at same time is less than.0004 *
Q: how did we get value 0.0004?
A: HW problem (for those with course in probability only)
Is packet switching a “slam-dunk winner”? (张渊)
- great for “bursty” data – sometimes has data to send, but at other times not
- resource sharing
- simpler, no call setup
- excessive congestion possible: packet delay and loss due to buffer overflow
- protocols needed for reliable data transfer, congestion control
- Q: How to provide circuit-like behavior with packet-switching?
- “It’s complicated.” We’ll study various techniques that try to make packet switching as “circuit-like” as possible.
4.4.3 过度使用的风险:网络拥塞
教师通过一个例子强调了过度使用分组交换的风险:如果一个支持35个用户运行良好的网络,用户数激增到35000个,那么网络超过负载上限(例如,超过10个用户同时活跃)的概率将不再是微不足道的0.04%,而是会变得非常大。
结论是,我们不能滥用分组交换的共享特性。用户的无节制使用会导致网络拥塞 (Congestion)。因此,网络需要设计相应的机制,使得网络核心与主机之间能够协同工作,对拥塞进行预警和控制,并让网络在发生拥塞后能够恢复到正常状态。
4.4.4 现代网络的悖论:让分组交换模拟线路交换
教师提出了一个当前网络面临的有趣挑战。我们今天所使用的互联网,是基于分组交换构建的,因为它具备各种优点。但与此同时,网络上的应用越来越丰富,特别是像视频点播这样的多媒体应用。
这类应用需要网络能提供类似线路交换的特性,例如带宽保障 (Guaranteed Bandwidth),以确保流畅的播放体验。
这就产生了一个悖论:我们如何能让一个基于分组交换构建的网络,在某些时候表现得像一个线路交换网络?教师用了一个生动的比喻:“你怎么样让牛表现得像骆驼一样?” 这个问题反映了现代网络为了支持多样化应用而产生的新的需求。【后续章节会讲到】
4.5 分组交换的两种模式
分组交换技术根据在网络层是否需要建立连接,可以分为两种主要的工作方式:数据报 (Datagram) 和 虚电路 (Virtual Circuit)。
4.5.1 数据报网络 (Datagram Networks)
数据报网络是一种无连接 (Connectionless) 的分组交换方式,我们今天所使用的互联网 (Internet) 就是最典型的例子。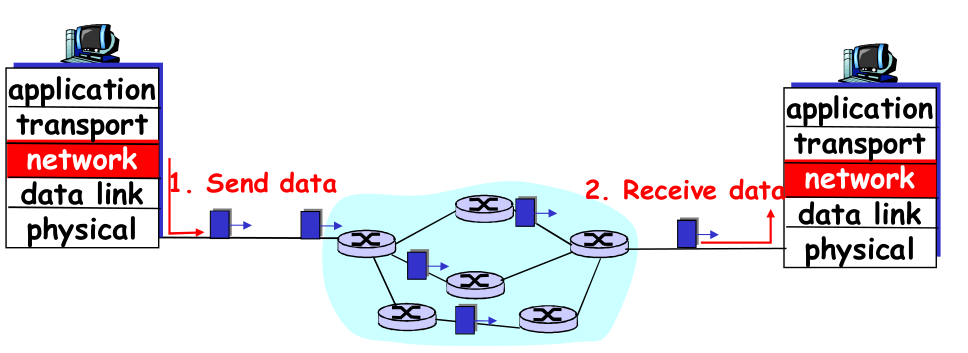
它的工作原理如下:
- 在通信开始前,主机之间不需要预先建立任何连接或进行“握手”。
- 每一个数据分组(被称为数据报)都必须携带目标的完整地址(例如,目标IP地址)。
- 网络中的每个路由器都独立地处理每一个到达的数据报。它会提取数据报中的目标地址,查询自己的路由表,然后决定下一跳的路径。
- 路由器是无状态的 (Stateless)。也就是说,它们不记录、不维护任何关于主机之间通信连接的信息。路由器的任务非常纯粹:收到分组、查询路由表、转发分组。
这种方式就像我们通过邮局寄信。每一封信都写有完整的收件人地址,并且邮局对每一封信都是独立处理的。一个重要的推论是,由于路由表可能会动态变化,从同一源发送到同一目标的多个数据报,可能会经过不同的路径,甚至可能出现后发送的包先到达的“失序”情况。
4.5.2 虚电路网络 (Virtual Circuit Networks)【课本没讲】
虚电路网络是一种面向连接 (Connection-oriented) 的分组交换方式。它的工作过程更像打电话。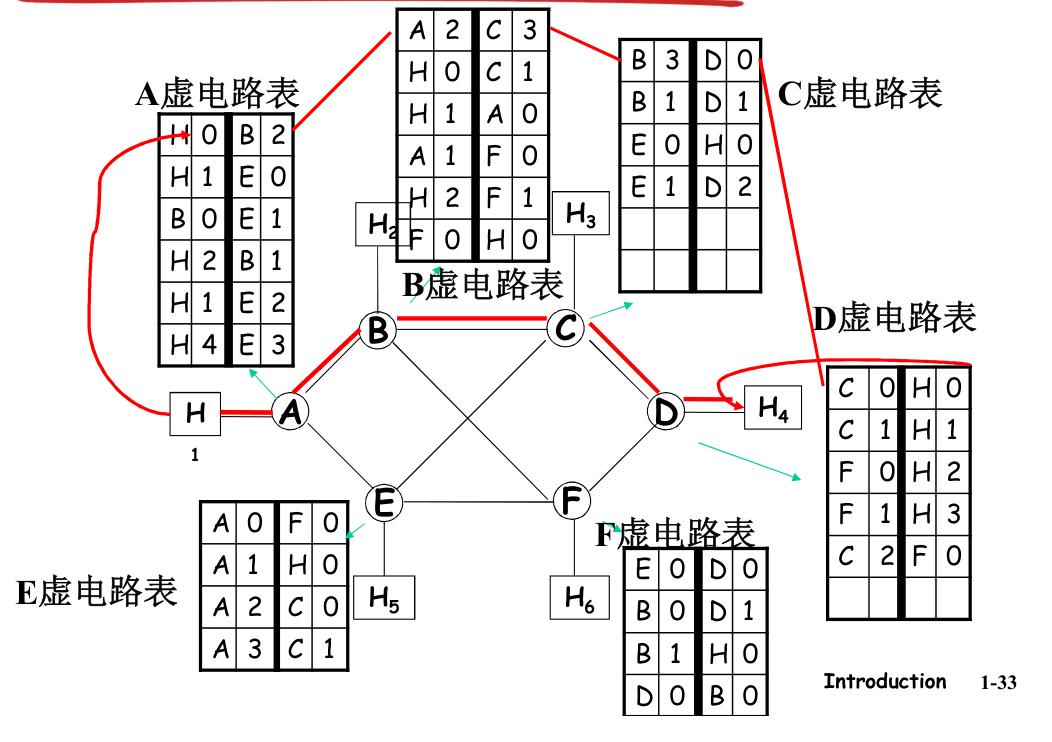
其工作原理分为两个阶段:
-
虚电路建立:在发送数据之前,源主机首先会通过发送信令 (Signaling) 消息,在网络中建立一条从源到目标的逻辑路径,这条路径被称为虚电路 (VC)。在这个过程中,沿途的每一个交换节点(路由器)都会记录下这条虚电路的信息,并为其分配一个虚电路号 (VC ID)。
-
数据传输:虚电路建立后,所有的数据分组就不再需要携带完整的目标地址了。它们只需要携带一个代表这条虚电路的、长度较短的VC ID。沿途的交换节点收到分组后,只需根据VC ID查询本地的转发表,就能快速地将其转发给下一跳。
在这种模式下,来自同一个连接的所有分组都会沿着同一条预先建立好的路径进行传输。交换节点必须为每一条经过它的虚电路维护状态信息,因此是有状态的 (Stateful)。值得注意的是,分组在不同链路上传输时,其VC ID可能会发生改变。
4.5.3 总结与概念辨析:“有连接” vs. “面向连接”
教师最后对网络中的“连接”概念做了一个重要的澄清。
-
虚电路 (VC) 是真正的有连接 (has a connection)。因为这个连接的状态信息不仅存在于通信的两个端点主机上,同样也存在于中间路径上的所有交换节点中。这是一个贯穿网络层的连接。
-
而我们在传输层学习的 TCP,被称为 “面向连接” (connection-oriented)。这是因为TCP的连接状态(如TCB)只存在于通信的两个端系统内部。中间网络里的路由器对这个TCP连接的存在是完全无感知的,它们依然是按照无连接的数据报方式在工作。
5 接入网
5.1 接入网:连接边缘与核心
我们首先来探讨如何将网络的边缘部分,也就是我们的终端设备,连接到网络的核心。负责这个连接的部分被称为 接入网 ,而支撑接入网运作的基础则是 物理媒体 。
需要明确的是,物理媒体不仅存在于接入网,也同样存在于网络核心,例如骨干链路所依赖的光纤等。本次课程只是以接入网为契机,对物理媒体进行介绍。
5.1.1 接入网的作用
接入网的核心作用,是让边缘的端系统能够接入到网络核心。当所有端系统都通过各自的接入网连接到核心后,网络核心便能执行数据交换功能,从而实现源主机和目标主机之间的通信。
5.1.2 接入方式的分类
从使用场景来看,接入方式主要可以分为 住宅接入 和 单位(企业、学校)接入 。
从技术上划分,又可以分为 有线接入 和 无线接入 。而无线接入还可以进一步细分为 无线局域网 (WLAN) 和 无线广域网 (WWAN) 。
5.2 衡量接入网的关键指标
评估一个接入网络时,有两个非常重要的指标:
5.2.1.1 带宽 (Bandwidth)
带宽指的是网络的数据传输速率,通常用 BPS (bits per second) 来衡量,即每秒钟能传输多少个比特。
5.2.1.2 共享与独享 (Shared/Dedicated)
第二个关键指标是你的接入方式是共享的还是独享的。
-
独享接入 :指你的设备到最近的网络交换设备(如电信的光纤交换机)之间的链路是专用的,带宽有保障。
-
共享接入 :指你和其他许多用户共同使用同一段接入带宽。例如,通过有线电视公司提供的网络服务。
一个常见的例子是,服务商可能宣传提供数百兆BPS的接入带宽。但实际上,你可能是与数百个其他用户共享这几百兆的带宽。
这意味着在凌晨两三点,当网络用户很少时,你或许能体验到接近宣传的速率。但在晚上八九点的高峰时段,由于所有用户都在共享,你实际获得的带宽可能只有宣传速率的1%。
5.2.1.3 “独享”的相对性
需要注意的是,“独享”通常是相对的。即使你通过光纤独享了连接到大楼交换机的1Gbps带宽,但如果整个大楼连接到电信机房的总出口带宽只有10Gbps,那么这栋楼里的所有用户实际上是在共享这10Gbps的出口。所以,独享通常指的是“最后一公里”的连接。
5.3 有线接入技术
5.3.1 1. 拨号调制解调器 (Modem) Dial-up modem over telephone line
早期的互联网服务提供商(ISP)面临一个巨大的挑战:将网络铺设到千家万户的成本极高。直接为每家每户铺设专线,前期投入巨大,收益缓慢,很多公司难以支撑。
为了解决这个问题,运营商想到利用一个现成的资源——覆盖到每家每户的电话线。
5.3.1.1 技术原理
电话线最初是为传输语音设计的,其保证的带宽非常窄,只有大约4K赫兹(Hz),因为人类语音的频率主要集中在300到3400赫兹之间。
为了在这样窄的音频信道上传输数字数据,调制解调器 (Modem) 应运而生。它的名字来源于 Modulator(调制器)和 Demodulator(解调器),在中国常被谐音称为“猫”。
它的工作方式是:
- 调制 (Modulate): 将计算机的数字信号(1和0)加载到音频载波信号上。这可以通过改变音频信号的幅度(调幅)、频率(调频)或相位(调相)来实现。
- 可以调制幅度:幅度比较高的持续一段时间代表1,幅度比较低的代表0
- 可以调频率:2K、3K都可以是音频,2K一段时间代表1,3K一段时间代表0
- 调相位
- 综合调制等
- 传输: 经过调制的音频信号通过电话线传输到ISP的机房。
- 解调 (Demodulate): 在ISP端,一个“Modem池”接收信号,并将其中的数字数据解调出来,再送入互联网。
这个过程就像数据在音频波浪上“冲浪”,这也是早期“上网冲浪”这个词的由来。
5.3.1.2 缺点
- 带宽极窄:速率通常在56Kbps以下,如果线路质量不好,可能只有30多Kbps。
- 独占线路:上网时不能打电话,打电话时则无法上网。
由于这些显著的缺点,这种接入方式已经被淘汰。
5.3.2 2. 数字用户线路 (DSL) DSL over telephone line
DSL技术同样使用电话线,但做出了关键改进,允许电话和上网同时进行。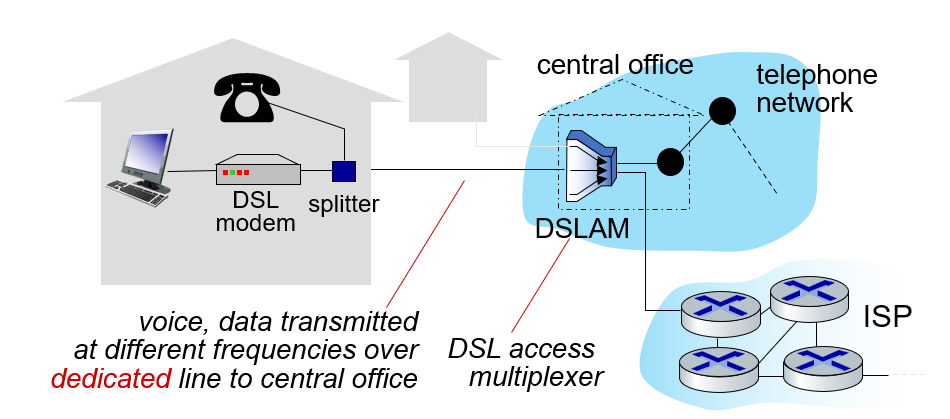
5.3.2.1 技术原理
DSL将电话线的可用频率进行划分: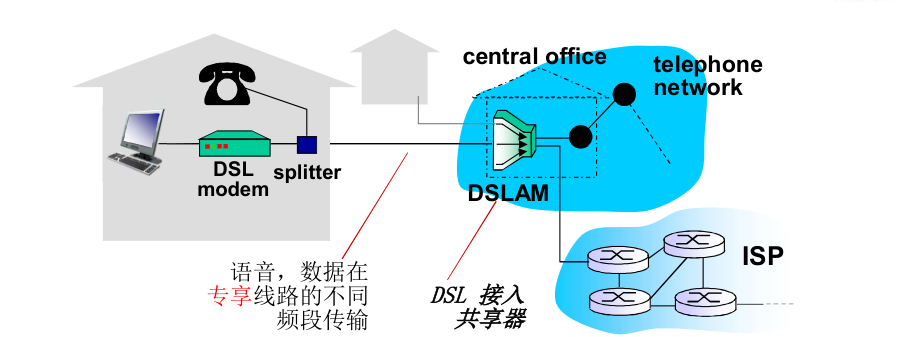
- 0-4KHz:保留给传统的语音通话。
- 4KHz以上:用于传输互联网数据。
- 这部分带宽还会被进一步划分为上行(从用户到网络)和下行(从网络到用户)两个通道。
- 现在还有的家庭使用IDSL modem 这种划分方式,特别是 非对称DSL (ADSL),下行带宽远大于上行带宽,更符合普通用户的下载多、上传少的网络使用习惯。
DSL的实现依然依赖于调制解调技术,但运用了更复杂的技术来利用4KHz以上的带宽资源。这之所以可行,是因为城市中用户家到电信交换机的电话线距离通常较近,线路质量也较好,使得高频带宽资源有被挖掘的潜力。
5.3.2.2 性能
- 上行速率:通常可达1Mbps。
- 下行速率:通常可达10Mbps。
如今,仍有许多家庭采用ADSL猫通过电话线上网。
5.3.3 3. 有线电视网络 (Cable Network)
与电信运营商利用电话线类似,有线电视公司也利用其现有的同轴电缆网络提供互联网接入服务。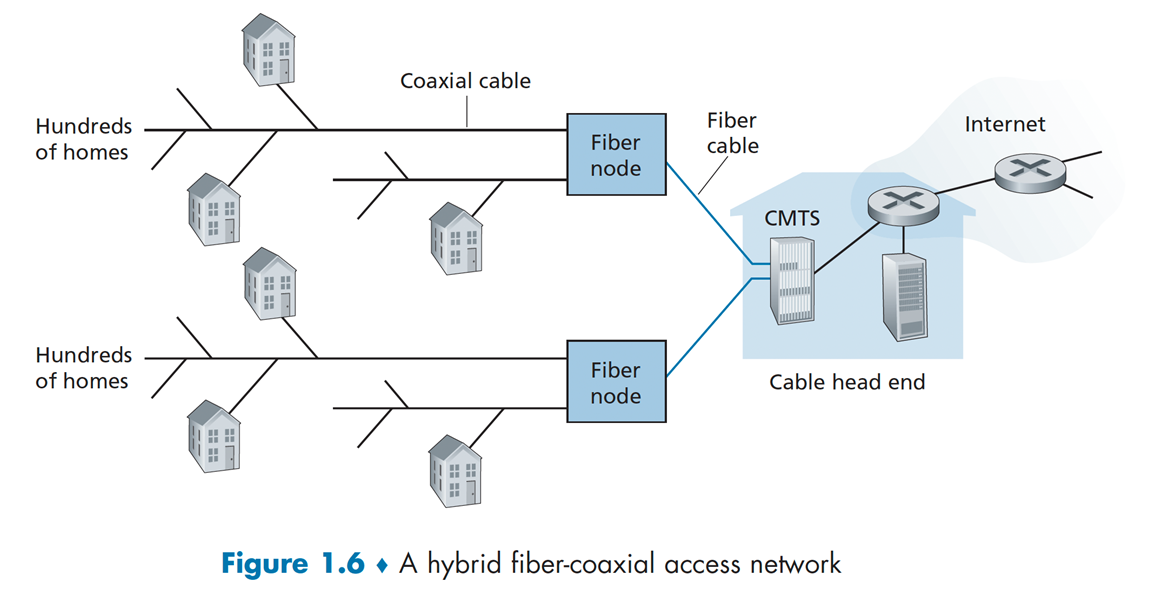
5.3.3.1 技术原理
传统的有线电视网络是单向的,即信号从电视台(头端)广播给所有用户。为了提供互联网服务,需要对其进行双向改造。
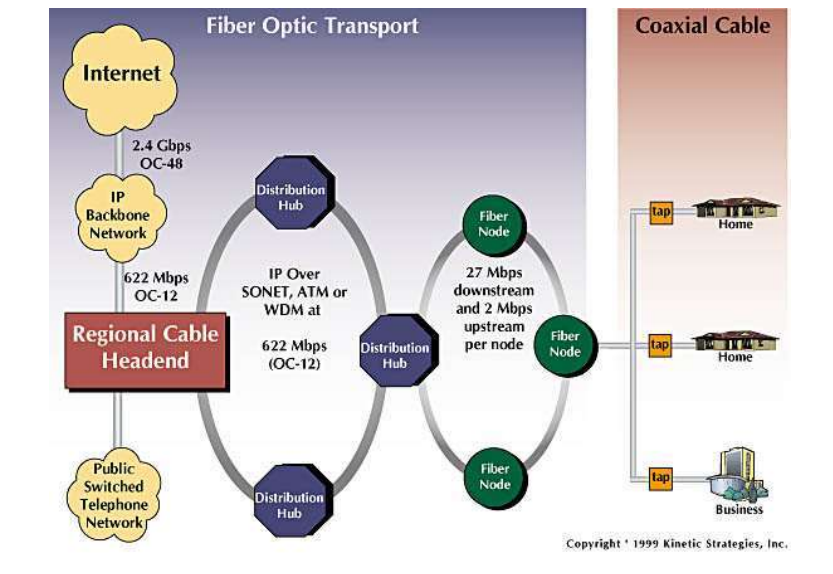
改造后的网络采用 混合光纤同轴电缆 (HFC) 架构,即主干网络使用光纤,而连接到用户家的最后一段则使用同轴电缆。
- 非对称:典型的速率为下行30Mbps,上行2Mbps。
- asymmetric: up to 40 Mbps – 1.2 Gbps downstream transmission rate, 30-100 Mbps upstream transmission rate
其带宽通过 频分复用 (FDM) 技术进行划分:
- 一部分频段用于传输传统的数字电视广播。
- 一部分频段用于互联网数据的下行传输。
- 一部分频段用于互联网数据的上行传输。
- 还有一部分频段用于控制信令。
5.3.3.2 关键特性:共享网络
与DSL每个用户独享到交换局的线路不同,通过有线电视上网的所有用户 共享 从电缆头端到社区的这段带宽。
NOTE
理论上,电力网络也连接了千家万户,因此可以通过在电线上安装“电力猫”(Power Modem)来实现上网。不过,这种方式在中国国内应用较少。
5.3.3.3 有线电视接入的现状
随着中国移动、中国电信等运营商大力推广 光纤到户 (FTTH),用户可以通过光纤获得更高质量的上网和网络电视 (IPTV) 服务。因此,传统的有线电视业务和其提供的互联网接入业务都在逐渐萎缩。
5.4 现代家庭与企业网络接入
5.4.1 家庭网络
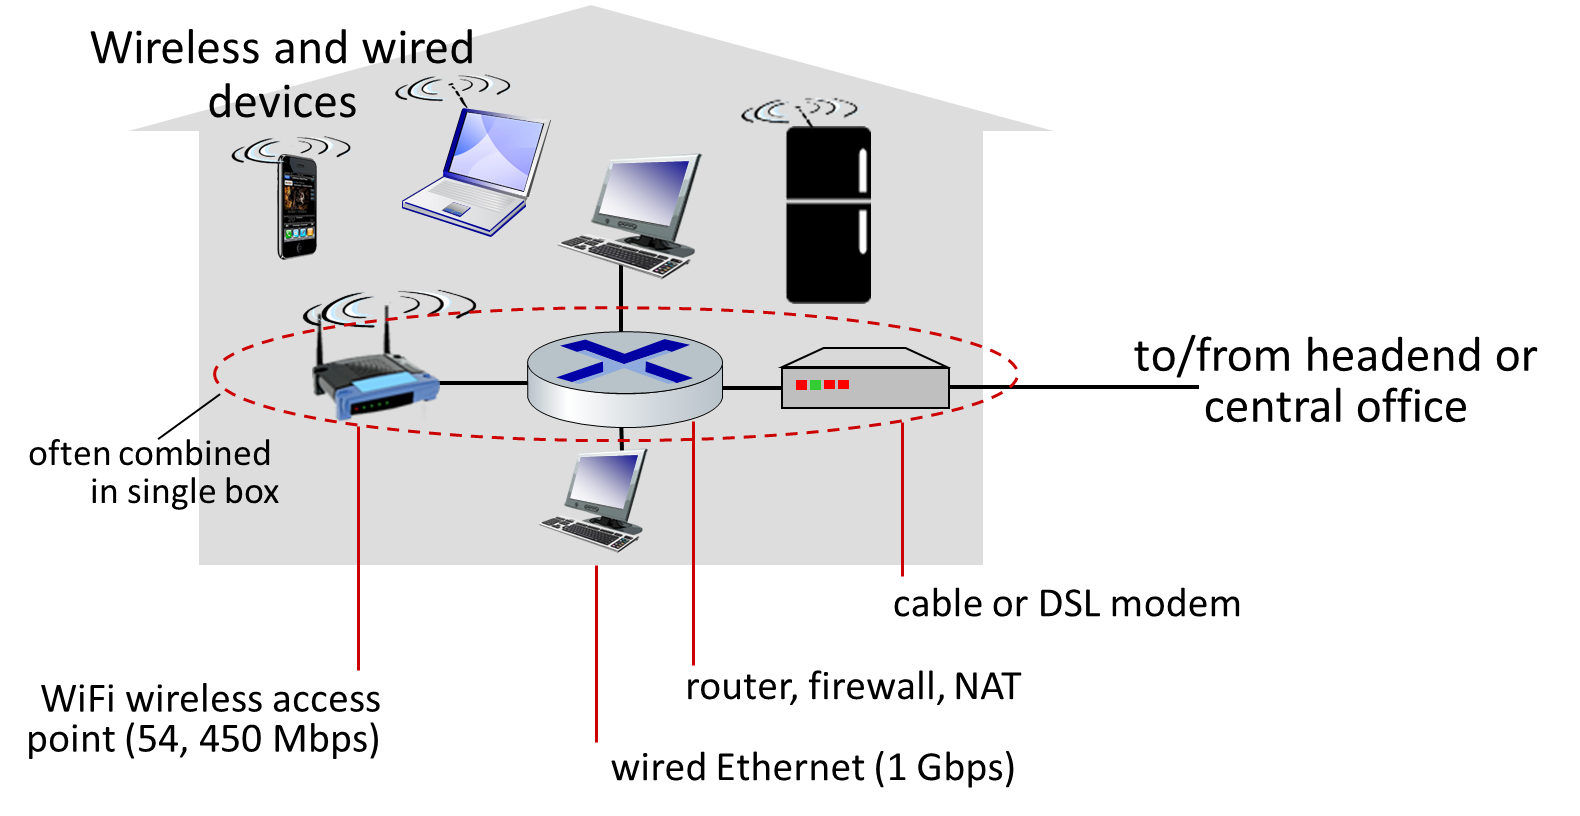 典型的现代家庭网络由一个 无线路由器 组合设备为中心。这个设备集成了多种功能:
- 路由器:连接家庭内部网络和外部互联网。
- 交换机:让家里的有线设备(如台式机)可以互相通信。
- 无线接入点 (AP):让手机、平板等无线设备连入网络。
- 防火墙与NAT:提供网络安全和地址转换功能。
数据流向是:家庭内部设备间的通信由交换机在本地完成;需要访问互联网时,数据通过路由器和猫(Modem或光猫)流向ISP。
5.4.2 企业网络Ethernet
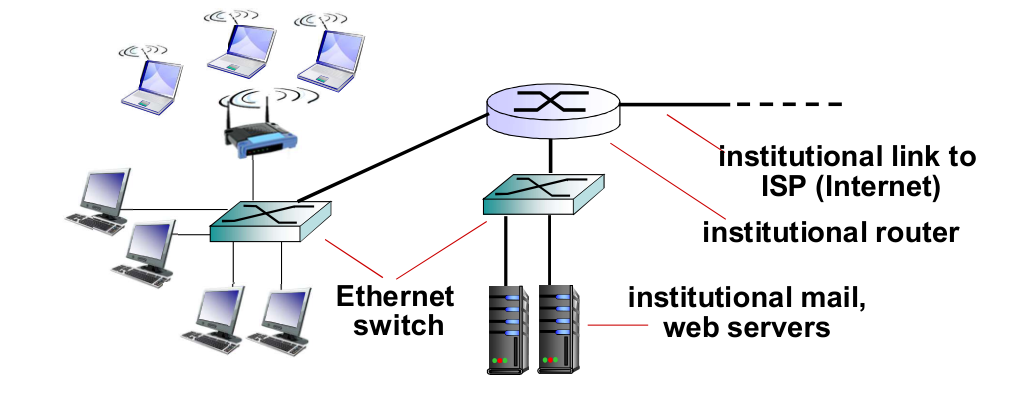 企业或大学的网络通常采用层级化的交换机结构:
- 终端设备(有线或通过无线AP)连接到 楼层交换机。
- 楼层交换机级联到 大楼交换机。
- 大楼交换机再连接到园区的 核心交换机。
- 最终,通过机构的 路由器 接入互联网。
大型机构通常有多个出口,连接到不同的ISP(如中国电信、中国移动、教育网等),以确保网络的稳定和高效。
就是交换机一直网上级联,然后通过路由器进行连接
5.4.3 data center networks
high-bandwidth links (10s to 100s Gbps) connect hundreds to thousands of servers together, and to Internet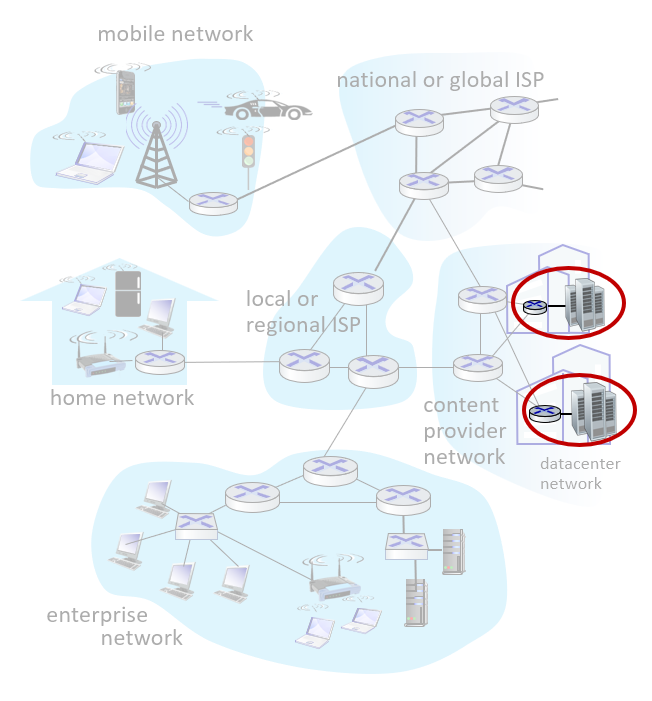
5.5 无线接入网络
无线接入主要分为两大类:
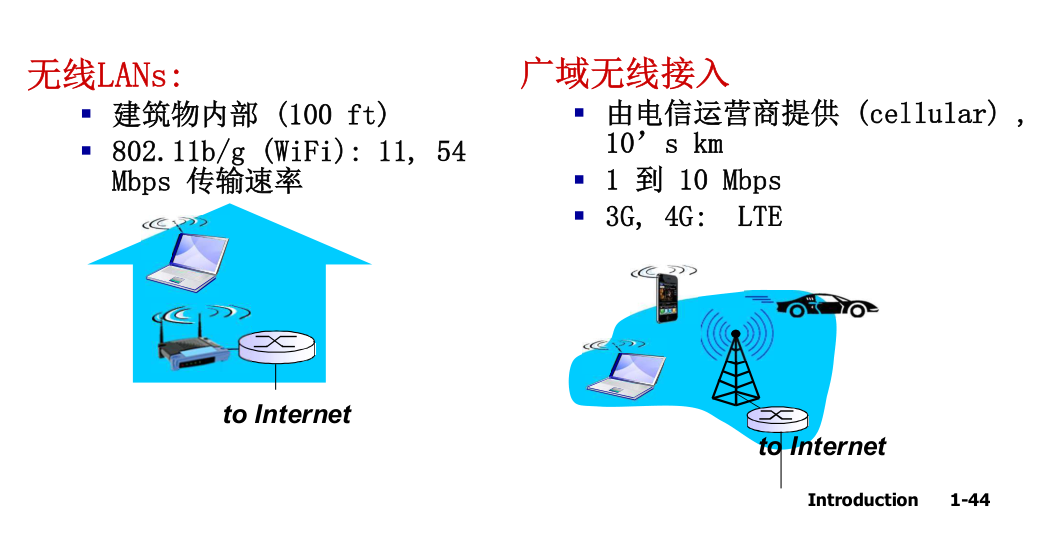
5.5.1 1. 无线广域网 (WWAN)
这就是我们日常使用的 蜂窝移动网络,如4G和5G。它通过基站覆盖十几公里的范围,为手机等移动设备提供互联网接入。
5.5.1.1 关于5G的探讨
中国在5G网络设备和技术上处于世界领先地位,这是一个值得自豪的重大历史成就。然而,5G的推广也面临挑战:
- 部署成本高:5G基站密度更大,耗电量也更高。
- 缺少杀手级应用:目前尚未出现能完全发挥5G超高带宽优势的现象级应用。
这就好比修好了高速公路,上面跑的却还是拖拉机。运营商投入巨大,但用户需求和应用场景未能同步跟上,导致其部署积极性受到一定影响。网络的发展需要与应用创新相互驱动。
5.5.2 2. 无线局域网 (WLAN)
这就是我们熟知的 Wi-Fi,它在一个较小的范围(如百英尺内)通过一个无线AP将家庭或办公室内的设备连接起来。
Wi-Fi的标准也在不断演进(如802.11b, g, n等),其接入带宽从最初的11Mbps、54Mbps,发展到现在的数百兆甚至更高。
5.6 课后题补充
List four access technologies. Classify each one as home access, enterprise access, or wide-area wireless access.
- Dial-up modem over telephone line: home;
- DSL over telephone line: home or small office;
- Cable to HFC: home;
- 100 Mbps switched Ethernet: enterprise.
6 物理媒体
6.1 物理媒体的定义与分类
物理媒体,是指在发送方和接收方这两个节点之间实际承载和传播比特(bit)的介质。连接这两个节点的介质,就构成了物理链路。
这些介质可以是光纤、同轴电缆、以太网线,甚至是开放的空间。根据其物理形态,我们可以将物理媒体分为两大类。
6.1.1 1. 导引型媒体 (Guided Media)
导引型媒体是指那些有形的、看得见摸得着的固体媒介。信号(无论是光信号还是电磁波信号)在这些媒体中传播时,会被严格地限制和引导在导体内部。
【下面的分类看看就行,不会了百度】
6.1.1.1 双绞线 (TP)
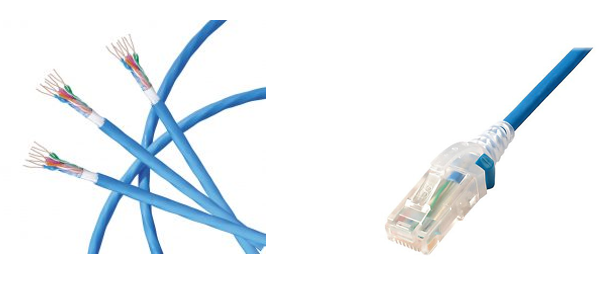
- 两根绝缘铜导线拧合
- 5类:100Mbps 以太网 ,Gbps 千兆位以太网
- 6类:10Gbps万兆以太网
6.1.1.2 同轴电缆:
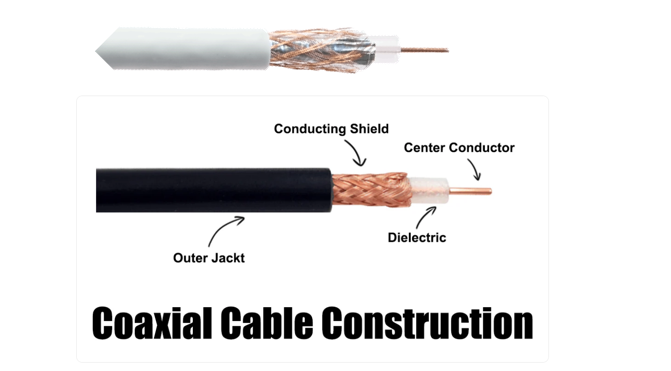
- 两根同轴的铜导线
- 双向
- 基带电缆:
- 电缆上一个单个信道
- Ethernet
- 宽带电缆:
- 电缆上有多个信道
- HFC
6.1.1.3 光纤和光缆
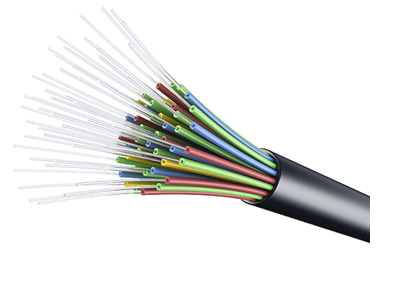
- 光脉冲,每个脉冲表示一个 bit,在玻璃纤维中传输
- 高速: 点到点的高速传输(如10 Gps-100Gbps传输速率 )
- 低误码率:在两个中继器之 间可以有很长的距离,不受 电磁噪声的干扰
- 安全
光纤与光缆 (Optical Fiber)
光纤技术是一项革命性的发明,其发明者是华人科学家 高锟(Charles K. Kao) 教授,他也因此获得了诺贝尔物理学奖。
工作原理:全反射
光纤传输数据的基本原理是 全反射。光纤由两种折射率不同的介质构成(内层的纤芯和外层的包层)。当光以满足特定条件的角度从纤芯射向包层边界时,会发生全反射,光信号被完全束缚在纤芯内部传播,从而实现极低损耗的远距离传输。
光纤的分类
- 单模光纤:纤芯非常细,只允许一种模式(近似垂直入射)的光传播。它的加工难度大、成本高,但信号衰减极小,可以传输非常远的距离。
- 多模光纤:纤芯较粗,允许多种模式(不同入射角度)的光在其中传播。它的成本较低,但传输距离相对较短。
光纤的优势
- 极高带宽:光的频率极高,因此传输带宽远超铜质电缆。
- 极低误码率:光信号作为传输载体,不受外界电磁波的干扰,因此数据传输的错误率非常低。
- 高安全性:由于全反射原理,光信号被封闭在光纤内部,不会向外辐射。
光缆
光缆是将许多根光纤捆绑在一起,并加上加强用的钢芯和保护外层构成的线缆。无论是跨越太平洋的海底光缆,还是国家内部电信运营商的骨干网络,都采用光缆来承载海量的通信和互联网数据。
来自张渊
Links: physical media
- bit: propagates between transmitter/receiver pairs
- physical link: what lies between transmitter & receiver
- guided media:
- signals propagate in solid media: copper, fiber, coax
- unguided media:
- signals propagate freely, e.g., radio
Twisted pair (TP) “双绞线”
- two insulated copper wires
Category 5: 100 Mbps, 1 Gbps Ethernet
Category 6: 10Gbps Ethernet
Coaxial cable: “同轴电缆”
- two concentric copper conductors
- Supports bidirectional transmission
- broadband:
multiple frequency channels on cable
100’s Mbps per channel
Fiber optic cable: “光纤电缆”
- glass fiber carrying light pulses, each pulse a bit
- high-speed operation:
- high-speed point-to-point transmission (10’s-100’s Gbps)
- low error rate:
- repeaters spaced far apart
- immune to electromagnetic noise
6.2 非导引型媒体(无线)
非导引型媒体通过在开放空间中传播电磁波来传输数据,无需铺设物理线缆。
特点
- 环境影响:信号在传播中会遇到物体发生反射或被吸收。
- 干扰:如果多个设备在同一区域使用相近的频率,它们之间会产生相互干扰。
- 快速衰减:信号强度随距离增加而迅速下降。
无线光通信:Li-Fi(课堂补充)
教师特别提到了其所在学院的一个重点实验室——无线光通信实验室。这项技术在开放空间中传输光信号,例如,利用LED灯源的快速闪烁来编码数据,再由接收端的摄像头捕捉并解码。
这项技术结合了光的高带宽和无线的便捷性,被称为 Li-Fi。未来,家里的灯具或许就能在你毫无察觉的情况下,为你提供高速的网络接入。
6.2.1 无线网络的类型
- 地面微波
- 一种点对点的无线通信方式。
- e.g. up to 45 Mbps channels
- 广域无线网络 (WWAN)
- 即我们熟知的蜂窝网络,通过基站覆盖十几公里的范围。它不仅可以打电话,还能接入移动互联网。如今,通过移动设备进行的电子商务等活动数量已超过了传统PC端。
- 卫星通信
- 地球同步静止卫星 (GEO):这类卫星在数万公里的高空轨道,与地球自转同步,看起来静止在地球上空。它能实现全球通信,但缺点是延迟非常大(可达270毫秒),因为信号往返距离极长。
- 近地轨道卫星 (LEO):教师提到了马斯克的“星链(Starlink)”项目。它由大量在低轨道高速运行的卫星组成。由于距离近,它的延迟远低于同步卫星。但教师也指出,该技术能服务的用户数量有限,更可能适用于军事等特殊领域,难以完全取代5G。
张渊课件补充
Wireless radio
- signal carried in various “bands” in electromagnetic spectrum
- no physical “wire”
- broadcast, “half-duplex” (sender to receiver)
- propagation environment effects:
- reflection
- obstruction by objects
- Interference/noise
Radio link types:
- Wireless LAN (WiFi)
- 10-100’s Mbps; 10’s of meters
- wide-area (e.g., 4G cellular)
- 10’s Mbps over ~10 Km
- Bluetooth: cable replacement
- short distances, limited rates
- terrestrial microwave
- point-to-point; 45 Mbps channels
- satellite
- up to 45 Mbps per channel
- 270 msec end-end delay
7 互联网的结构与ISP
7.1 互联网结构:网络的网络
- 端系统通过 接入ISPs (Internet Service Providers)连接到互联网
- (比如移动设备通过移动的ISP接入到互联网,联通的通过联通的ISP接入到互联网,端系统都是通过接入ISP接入到互联网)
- 住宅,公司和大学的ISPs
- 接入ISPs相应的必须是互联的
- 因此任何2个端系统可相互发送分组到对方
- 接入ISP需要互联,否则双方无法通信
- 导致的“网络的网络”非常复杂
- 发展和演化是通过 经济的和国家的政策 来驱动的
- 让我们采用 渐进方法 来描述当前互联网的结构
7.1.1 演化阶段一:全局ISP的诞生
一种看似直接的方案是让每个接入ISP都与其他所有ISP直接连接(即全连接)。然而,这种方式存在严重的可扩展性(Scalability) 问题。如果有N个接入ISP,就需要大约N²规模的连接数量。当N达到几十万时,连接的成本和管理的复杂度将是天文数字,因此这种方案是不可行的。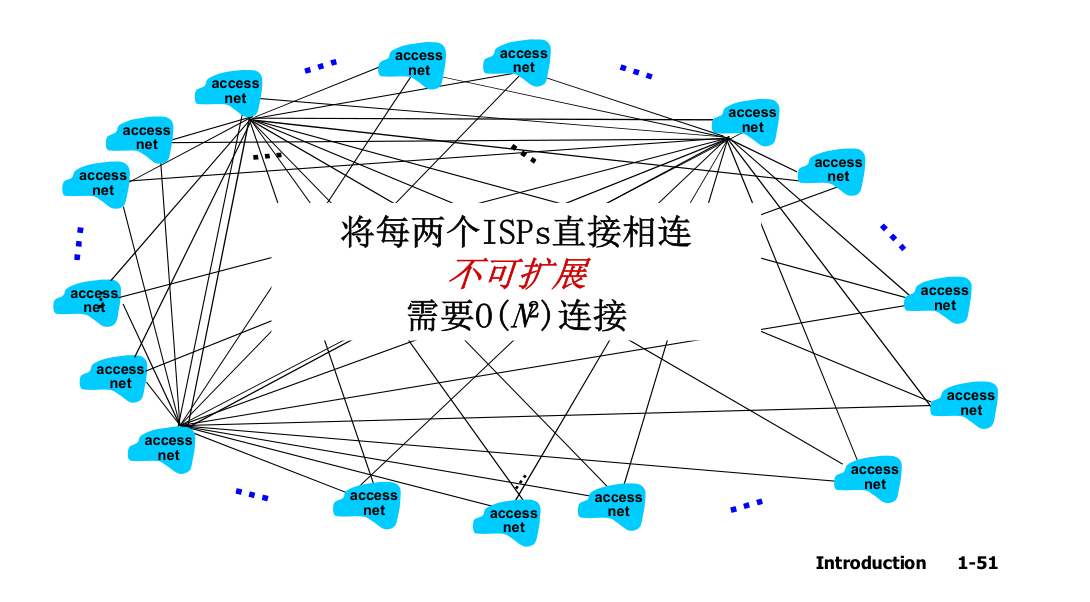
这里的商业机会应运而生:既然存在巨大的连接需求,那么一定会有运营商愿意投资,在全球范围内铺设路由器和高速链路,构建一个全局ISP。这个全局ISP的目标就是为所有接入ISP提供连接服务。接入ISP通过与全局ISP签订经济合约,就能让自己的用户访问到连接在该全局ISP上的其他所有网络。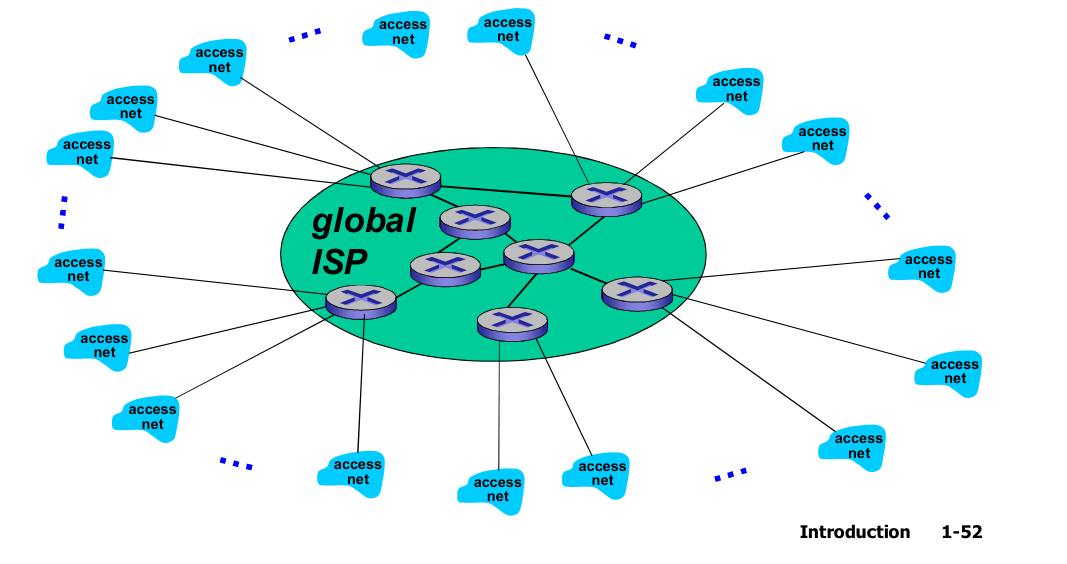
7.1.2 演化阶段二:竞争、合作与IXP
当一个全局ISP的业务被证明是有利可图的时,必然会吸引来竞争者。于是,市场上出现了多个全局ISP,它们各自连接一部分接入ISP客户。
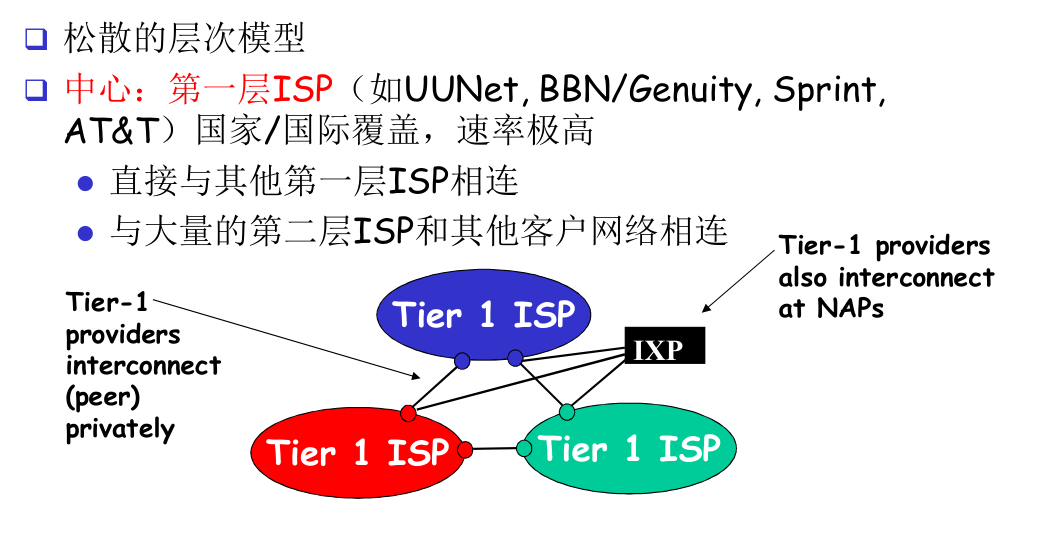
这时,这些全局ISP之间面临着竞争,但更看到了合作带来的巨大利益。一个ISP要将全球所有接入ISP都变成自己的客户,需要耗费巨大的时间和成本。相比之下,与另一个全局ISP进行互联,就能立刻让自己的用户访问对方网络中的所有客户。这种合作的连接方式被称为对等连接(Peering),通常发生在流量规模相当的ISP之间,可能不涉及费用结算,极大地扩展了各自的业务范围。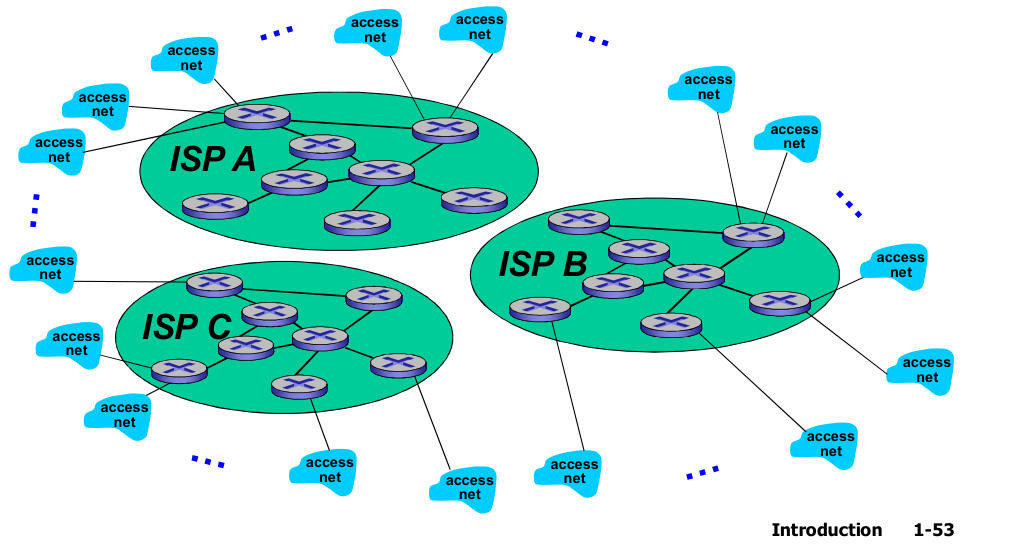
除了两个ISP之间直接用线缆进行对等连接外,还出现了一种更高效的互联方式,即互联网交换点(IXP, Internet Exchange Point)。IXP就像一个大型交换中心,多个ISP可以将自己的网络接入到这里,从而方便地与所有其他接入该IXP的ISP实现流量交换。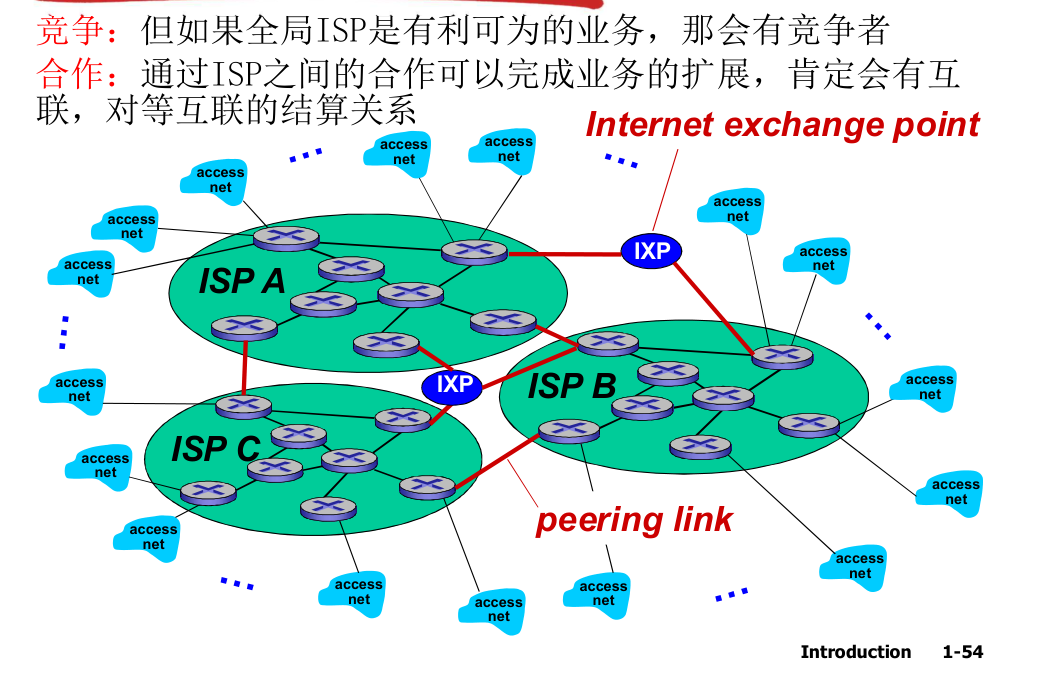
7.1.3 演化阶段三:业务细分与区域网络
随着网络规模的扩大,业务开始出现细分。除了提供全球覆盖的全局ISP(也被称为 第一层ISP 或 Tier-1 ISP),还出现了一些区域网络(Regional ISP)。这些ISP专注于一个国家、一个省份或几个大洲等特定区域,为该区域内的接入ISP提供服务,并将它们连接到更高层的全局ISP。这样就逐渐形成了一个层次化的结构。
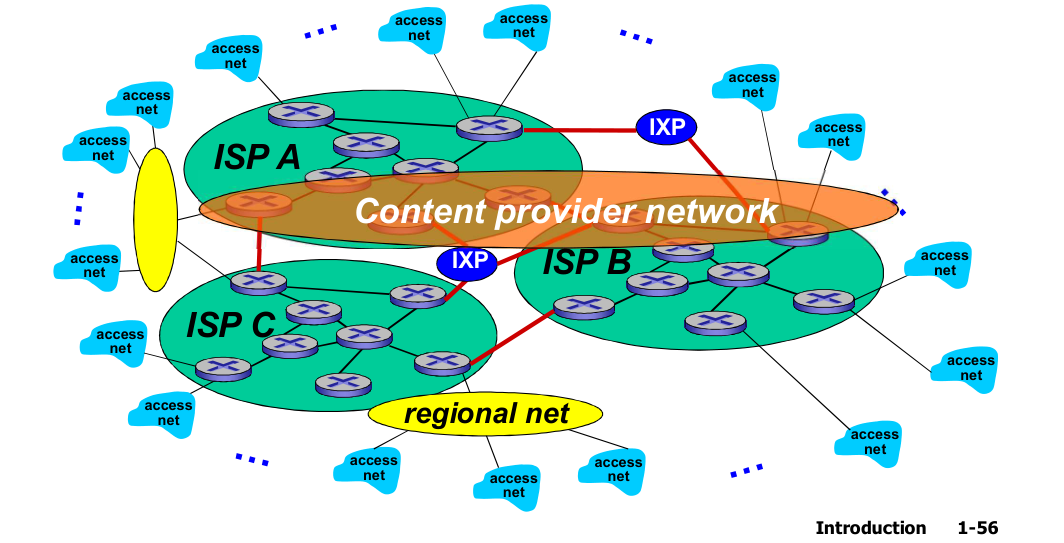
- “tier-1” commercial ISPs (e.g., Level 3, Sprint, AT&T, NTT), 国家或者国际 范围的覆盖
- content provider network (e.g., Google): 将它们的数据中心接入ISP,方便周边 用户的访问;通常私有网络之间用专网绕过第一层ISP和区域
ISP的链接
- POP: 高层ISP面向客户网络的接入点,涉及费用结算
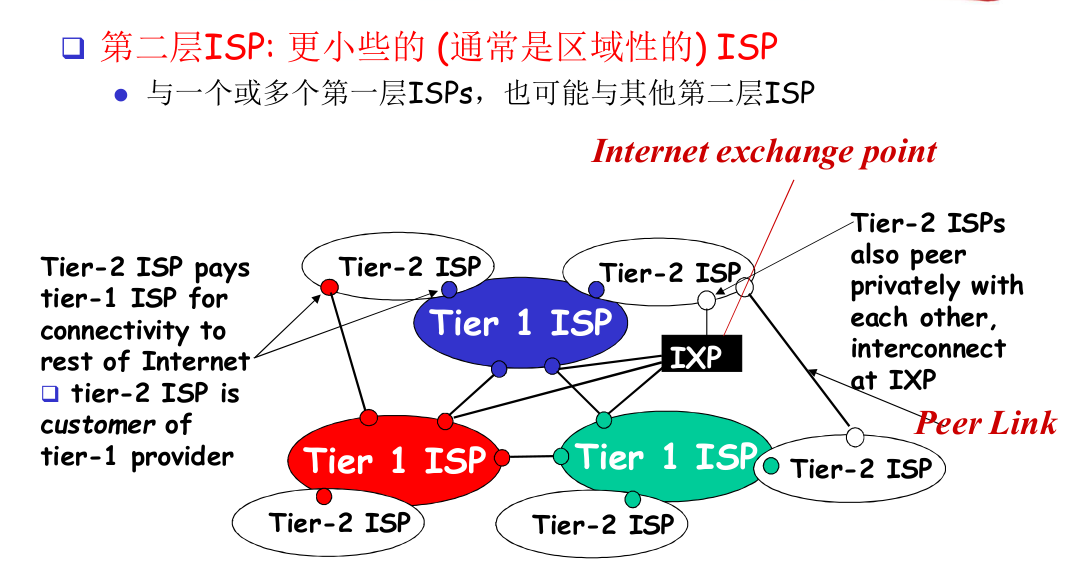
- 如一个低层ISP接入多个高层ISP,多宿(multi home)
- 对等接入:2个ISP对等互接,不涉及费用结算
- IXP:多个对等ISP互联互通之处,通常不涉及费用结算
- 对等接入
- ICP自己部署专用网络,同时和各级ISP连接
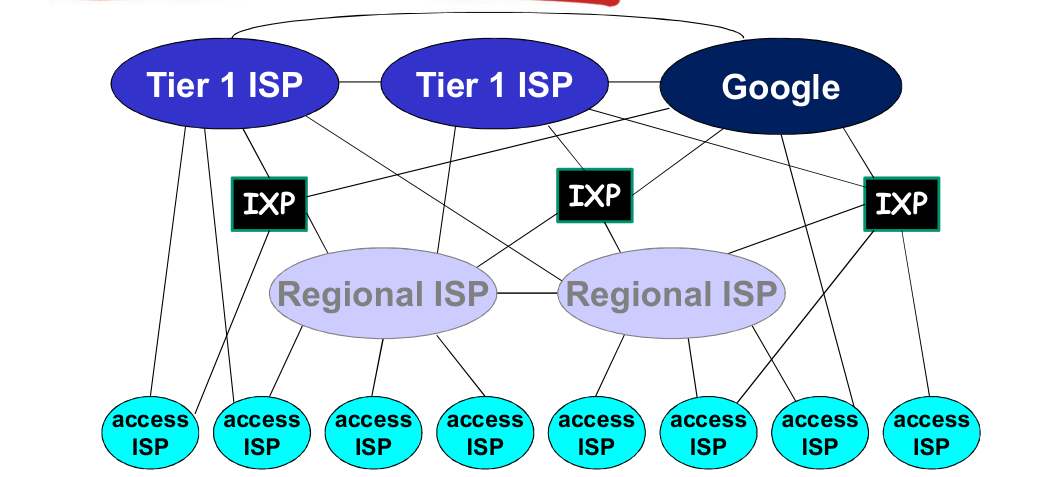
7.2 新的角色:互联网内容提供商(ICP)
在ISP构建的网络之上,还有一个重要的角色——ICP(Internet Content Provider,互联网内容提供商),例如谷歌、百度、腾讯等。ISP提供的是网络接入服务(如同“管道”),而ICP提供的是运行在网络之上的内容与应用服务(如同“管道”里流动的水)。
最初,ICP像普通用户一样,需要通过向ISP支付高昂的费用来接入互联网,并向全球用户提供服务。但这种模式很快暴露了两个主要问题:
- 成本问题:随着用户量和流量的剧增,支付给ISP的带宽费用成为一笔巨大的开销。
- 服务质量问题:用户访问ICP的体验受限于ISP的网络质量。例如,一个南非用户访问位于美国的服务器,数据需要跨越多个不同的ISP网络,延迟高且不稳定。
ICP自建全球网络
为了解决成本和服务质量问题,像谷歌这样的大型ICP开始在全球范围内部署自己的数据中心(Data Center, DC),并使用自己铺设或租用的专用高速光缆,将这些数据中心连接起来,形成一个私有的全球骨干网。
这些数据中心的位置经过精心选择,通常会靠近各大ISP的核心节点,以便用户可以快速地从本地ISP网络接入到ICP的私有网络。当用户发起请求时:
- 请求首先通过用户的接入ISP,快速到达离用户最近的ICP数据中心。
- 如果所需内容在该数据中心,则直接返回,响应极快。
- 如果内容在其他数据中心,请求会通过ICP的高速私有网络传输到相应的数据中心,获取数据后再通过私有网络返回,最后再经由本地ISP网络送达用户。
通过这种方式,ICP不仅大幅降低了向ISP支付的带宽成本,还能绕开公共互联网中不稳定的部分,为全球用户提供高质量、低延迟的服务。
同时,除了技术手段,在国内,ICP也会通过向政府建言等方式推动“提速降费”政策,这也是一种降低运营成本、提升服务质量的途径。
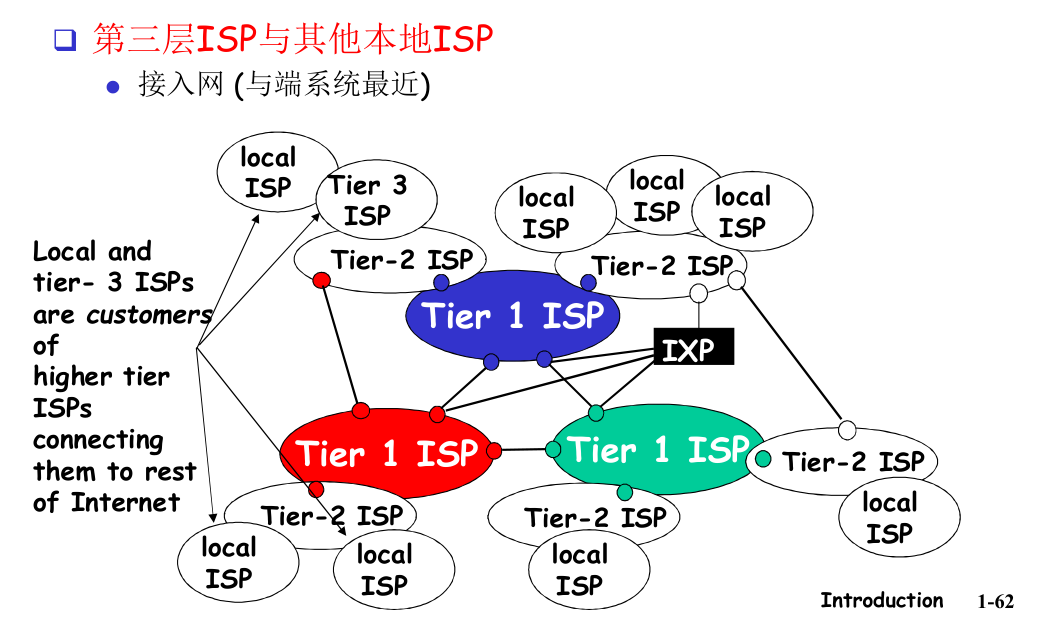
7.3 现代互联网的松散层次结构
综上所述,现代互联网是一个由ISP网络和ICP网络共同构成的、结构复杂但存在一个松散层次化的生态系统。
- 第一层ISP (Tier-1 ISP):少数几个拥有全球或国家级覆盖范围的顶级运营商,它们之间通过对等连接或IXP互联,构成了互联网的核心骨干。它们的网络节点不多,但带宽极高。
- 第二层和第三层ISP (Tier-2 & Tier-3):通常是区域性或地方性的ISP,它们作为客户接入到一个或多个上层ISP。同时,同级的ISP之间也可能存在对等连接。
- 接入ISP (Access ISP):处在层次结构的最末端,直接为终端用户提供互联网接入服务。
- 内容提供商网络 (ICP Networks):大型ICP自建的全球性网络,它们通过在各地部署数据中心,并与各层级的ISP进行连接,以优化自身服务。
一个用户的数据包从源主机到目的主机,往往需要穿越本地接入ISP、区域ISP、第一层ISP等多个不同的网络,这正是“互联网是网络的网络”这一概念的直观体现。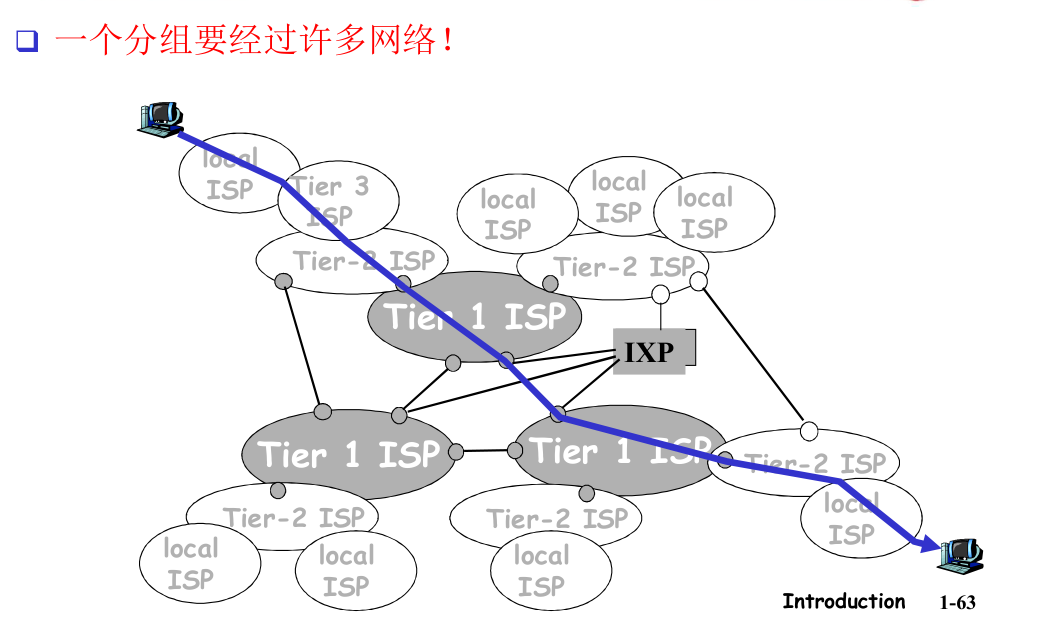
- and content provider networks (e.g., Google, Microsoft, Akamai) may run their own network, to bring services, content close to end users
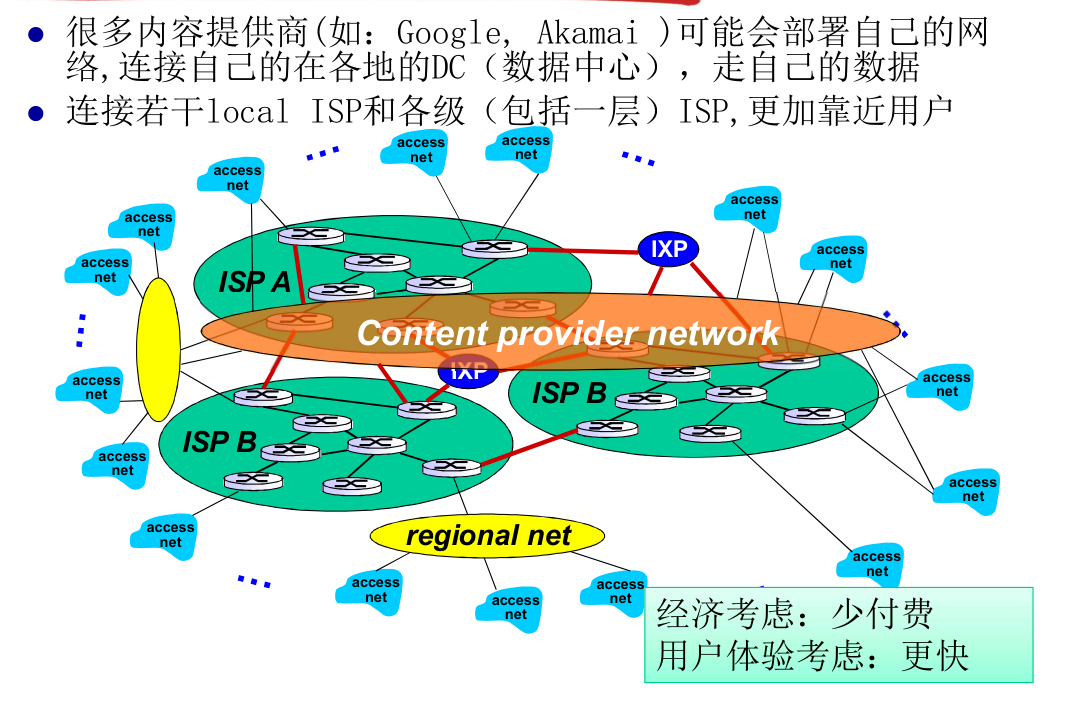
7.4 第八版术语补充(见中文p22最下面一段和英文版p62)
7.4.1 PoP (Point of Presence - 接入点)
- 是什么? PoP 是服务提供商 (ISP) 网络中的一个物理位置,里面包含了一组或多组路由器。
- 作用? 它是下游客户 ISP 或客户网络接入该服务提供商网络的连接点。你可以把它想象成 ISP 在某个地区的“入口”或“存在点”。
- 连接方式? 客户网络(如一个本地 ISP 或一个公司)可以通过租用高速线路(例如来自第三方电信公司)连接到服务提供商的 PoP 中的路由器。
- 分布? PoP 存在于 ISP 网络的各个层级(除了最低的接入 ISP 级别),地理位置分散。
7.4.2 Multi-homing (多宿 / 多归属)
- 是什么? 指的是一个 ISP(通常不是最高级别的 Tier-1 ISP)同时连接到 两个或多个 上游服务提供商 ISP。
- 例子?
- 一个接入 ISP (Access ISP) 可能同时连接到两个不同的区域 ISP。
- 一个区域 ISP (Regional ISP) 可能同时连接到多个 Tier-1 ISP。
- 主要目的? 提高网络的可靠性和冗余性。如果其中一个上游提供商的连接发生故障,该 ISP 仍然可以通过其他连接继续发送和接收互联网数据包,保证服务的连续性。
7.4.3 Peering (对等互联)
- 是什么? 指的是两个 ISP(通常处于相同层级,例如两个区域 ISP 或两个 Tier-1 ISP)之间建立直接的网络连接。
- 作用? 允许这两个 ISP 之间直接交换彼此客户产生的流量,而不需要通过他们的上游(通常是付费的)ISP 来中转。
- 目的? 主要是为了降低成本和提高性能(减少延迟)。
- 特点? Peering 通常是免费的(称为 “settlement-free”),即双方 ISP 之间不为交换的流量付费,这与客户需要向上游 ISP 付费购买“互联网接入(Transit)”不同。
7.4.4 IXP (Internet Exchange Point - 互联网交换点)
- 是什么? IXP 是一个物理基础设施(通常是一个拥有自己交换机的数据中心或专用建筑),它提供一个集中的**“会面点”**。
- 作用? 允许多个不同的 ISP 在这个点互相连接并进行对等互联 (Peering)。它极大地简化了大量 ISP 之间建立对等连接的过程。与其每个 ISP 都单独拉线连接其他几十个 ISP,不如大家都连接到 IXP,然后在 IXP 内部通过交换机实现互联。
- 运营者? 通常由中立的第三方公司创建和运营。
- 规模? 全球有数百个 IXP 存在。
总结来说:
- PoP 是 ISP 网络的接入点。
- Multi-homing 是连接到多个上游 ISP 以获得冗余。
- Peering 是同级 ISP 之间直接、免费地交换流量。
- IXP 是一个物理场所,让多个 ISP 可以方便地进行 Peering。
这些概念共同构成了更接近现实的、复杂的互联网结构。
8 分组延时、丢失和吞吐量
8.1 分组丢失与排队
在路由器的内部,每一条出站链路都对应着一个输出队列(或称为缓冲区)。当一个分组经过路由查询,确定要从某条链路转发出去时,会发生以下情况:
- 如果该链路当前空闲,分组可以直接被发送。
- 如果该链路正在发送其他分组,那么这个新来的分组就必须进入队列中排队等候。
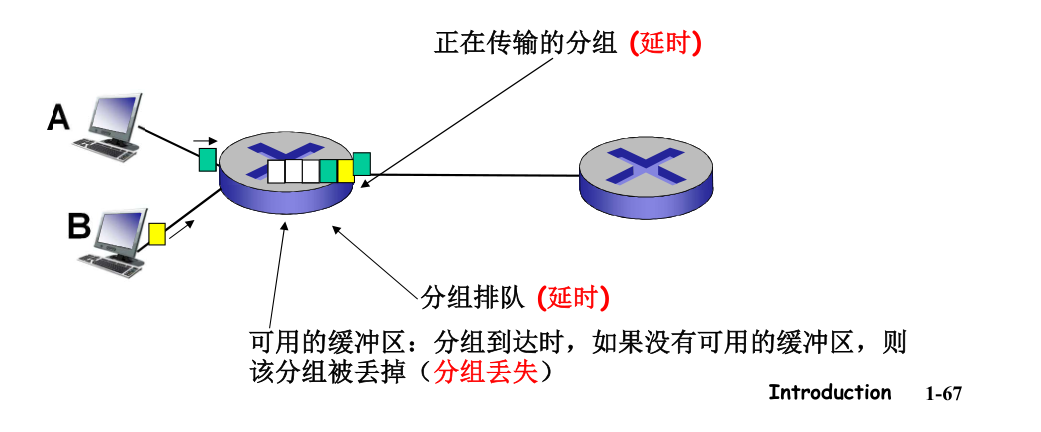 分组丢失就发生在队列环节。因为路由器的内存是有限的,所以队列的长度也是有限的。如果一个分组到达时,对应的输出队列已经满了,路由器无法容纳它,就会直接将其丢弃。这就是分组丢失最根本的原因。
有人可能会问,为什么不把队列设置得非常大,比如几个T或几个P,这样分组就不会丢失了?原因在于,过长的队列会导致极大的排队延时。如果一个分组在队列里排队几天才被发送出去,那么即使它最终成功到达了目的地,对于上层应用来说也早已失去了意义,因为应用通常都有一个可容忍的最大延迟上限。
8.2 四种主要的分组延时
一个分组从一个节点(例如一台主机或路由器)出发,通过一条链路到达下一个节点的总延时,可以分解为四个组成部分。
-
= 处理延时
- 通常是微秒数量级或更少
-
= 排队延时
- 取决于拥塞程度
-
= 传输延时
- = , 对低速率的链路而言很大(如拨号),通常为微秒级到毫秒级
-
= 传播延时
- 几微秒到几百毫秒
英语解释
- : nodal processing “处理延时”
- check bit errors
- determine output link
- typically < microsecs
- : queueing delay “排队延时”
- time waiting at output link for transmission
- depends on congestion level of router
- : transmission delay: “传输延时”
- : packet length (bits)
- : link transmission rate (bps)
- : propagation delay: “传播延时”
- : length of physical link
- : propagation speed ( m/sec)
and very different
8.2.1 1. 节点处理延时 (Processing Delay)
就是对分组进行检查和处理花费的时间
- 检查 bit级差错
- 检查分组首部和决定将分组导向何处
- … 就是处理延迟 processing,处理延迟一般是确定的,因为怎么处理分组的过程是确定的
8.2.2 2. 排队延时 (Queuing Delay)
- 在输出链路上等待传输的时间
- 依赖于路由器的拥塞程度
- 排队延时一般是不确定的
8.2.2.1 排队延时与流量强度 Packet queueing delay (revisited)
排队延时是四种延时中唯一不确定的,它与一个叫做流量强度(Traffic Intensity) 的关键指标密切相关。
流量强度的定义为:
- :分组的平均长度(bits)
- :分组到达队列的平均速率(个/秒)
- :链路带宽(bps)
代表了比特到达队列的平均速率。因此,流量强度就是比特到达速率与链路服务速率的比值。
- 当流量强度接近0时,网络非常空闲,排队延时极小。
- 当流量强度逐渐增大并趋近于1时,排持队延时会急剧增长,趋向于无穷大。
- 如果流量强度大于1,意味着比特到达的速率持续超过了链路的处理能力,队列将无限增长,导致巨大的延时和大量的分组丢失。
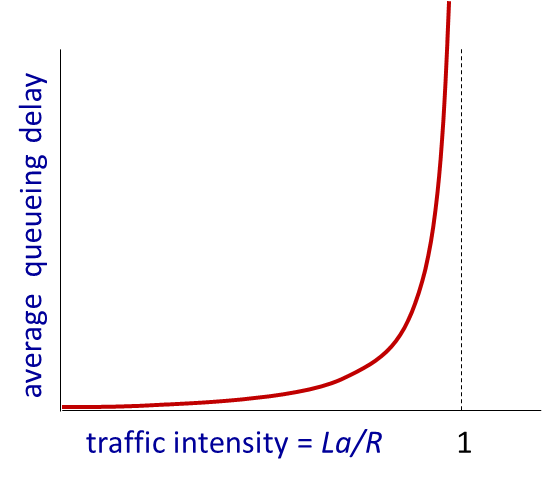
因此,在设计网络系统时,必须保证其平均流量强度远小于1,才能提供可靠的服务。【这也是之前课提到的计算为啥一定是上标是9的缘故了5.4.1 举例分析】
来自张渊PPT
- : average packet arrival rate
- : packet length (bits)
- : link bandwidth (bit transmission rate)
: “traffic intensity”
- : avg. queueing delay small
- : avg. queueing delay large
- : more “work” arriving is more than can be serviced - average delay infinite!
8.2.2.2 “Real” Internet delays and routes
- what do “real” Internet delay & loss look like?
- traceroute program: provides delay measurement from source to router along end-end Internet path towards destination. For all :
- sends three packets that will reach router on path towards destination (with time-to-live field value of )
- router will return packets to sender
- sender measures time interval between transmission and reply
8.2.3 3. 传输延时 (Transmission Delay)
当分组排到队首,轮到它被发送时,路由器需要将构成这个分组的所有比特一个一个地“推”到链路上。这个过程所花费的时间就是传输延时。它取决于分组的长度和链路的带宽。
计算公式为: 其中, 是分组的长度(单位:比特), 是链路的带宽(单位:比特/秒,bps)。例如,一个1兆比特( bits)的分组在1兆比特/秒(1 Mbps)的链路上,其传输延时就是1秒。
8.2.4 4. 传播延时 (Propagation Delay)
一旦一个比特被推到链路上,它并不会瞬间到达链路的另一端,而是需要时间在物理介质(如光纤、铜缆)中传播。一个比特从链路的一端传播到另一端所花费的时间,就是传播延时。
计算公式为: 其中, 是物理链路的长度(单位:米), 是电磁波在该介质中的传播速率(通常约为 米/秒,略低于真空中的光速)。
传播延时的大小与距离直接相关。在距离很近的局域网中,传播延时可能可以忽略不计。但在跨越大陆或海洋的广域网中,甚至在卫星通信中(如地球同步卫星单程约270毫秒),传播延时会成为延迟的主要部分,不可忽略。
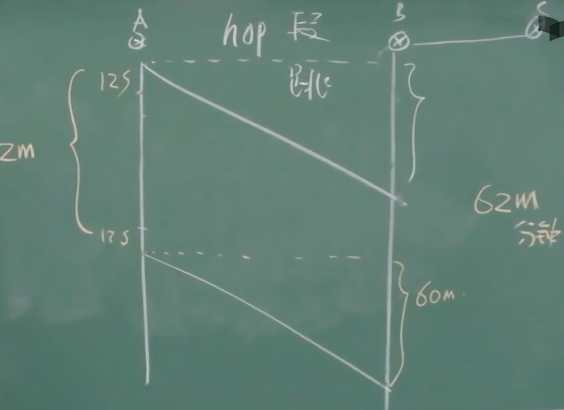
如下图
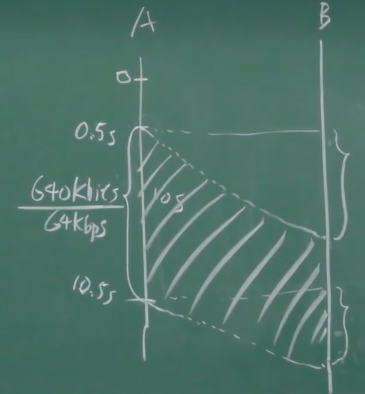
- 虚线的高度是传输延迟
- 三角形的高是传播延迟,传播延迟考虑物理空间
- 如果两个节点非常近的话,那么传播延迟基本可以忽略不计
8.3 通过类比理解延时
为了更直观地理解传输延时和传播延时的区别与关系,我们使用一个车队的比喻。
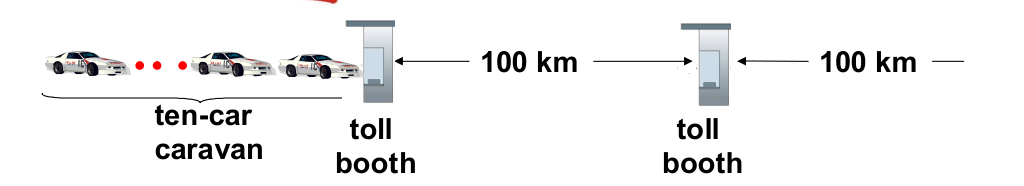 场景一:广域网(WAN)情况
一个由10辆车组成的车队(相当于一个分组),要通过一个收费站(相当于路由器),然后行驶100公里的高速公路。
- 传输延时:收费站服务每辆车需要12秒。服务整个车队就需要 秒(2分钟)。
- 传播延时:车速为100公里/小时。行驶100公里需要1小时(60分钟)。
在这种情况下,整个车队需要2分钟才能全部离开第一个收费站,而第一辆车离开后,还需要60分钟才能到达第二个收费站。总延迟主要由传播延时决定。这类似于广域网,距离长,传播延时显著。
场景二:局域网(LAN)情况 现在,车速提高到1000公里/小时,但收费站效率变低,服务每辆车需要1分钟。
- 传输延时:服务整个车队需要 分钟。
- 传播延时:行驶100公里需要 小时(6分钟)。
在这个场景下,一个有趣的现象发生了:第一辆车在第6分钟时就已经到达了第二个收费站,而此时第一个收费站还有4辆车没有服务完(总共需要10分钟)。这说明,分组的第一个比特已经到达了下一个节点,而源节点还没完成整个分组的发送。这种情况类似于局域网,传输速率相对较低而距离近,传输延时可能大于传播延时。
8.4 使用Traceroute工具探测网络延时
我们可以使用一个名为 Traceroute(在Windows中为 tracert)的命令行工具,来实际测量从本机到目标主机路径上每一“跳”(即每个路由器)的往返延时。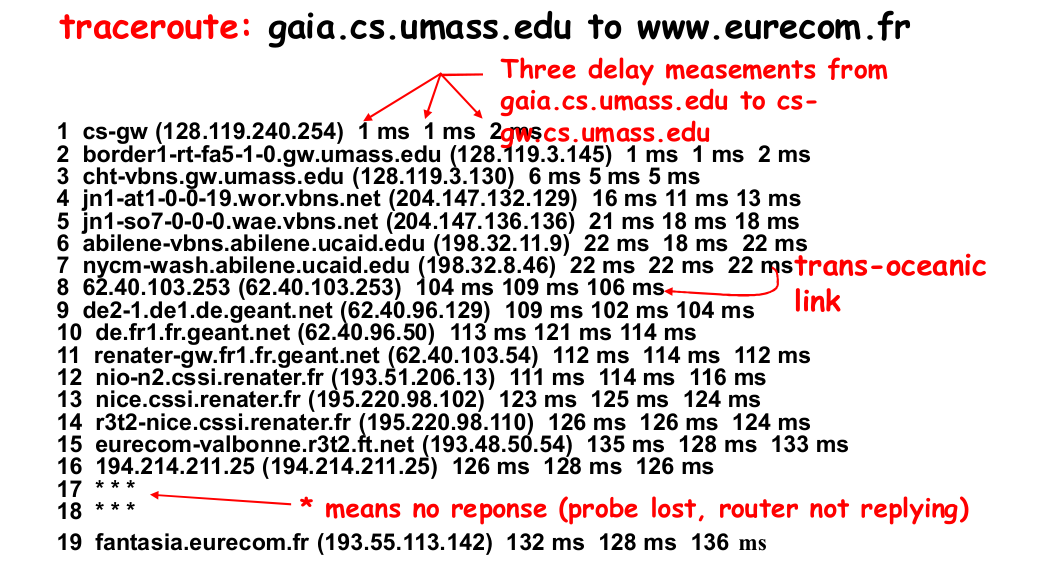
使用帮助
- 在Windows系统下
- Tracert hostname
- 如 Tracert www.gucas.ac.cn
- 更完整的例子
- tract
- 请见帮助: http://www.linkwan.com/gb/broadmeter/article/trace -help.htm
- 测试网址
8.4.1 Traceroute的工作原理
Traceroute 的巧妙之处在于它利用了IP协议中的 TTL(Time-To-Live,生存时间) 字段和 ICMP(Internet Control Message Protocol,互联网控制报文协议)。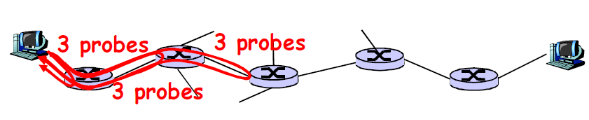
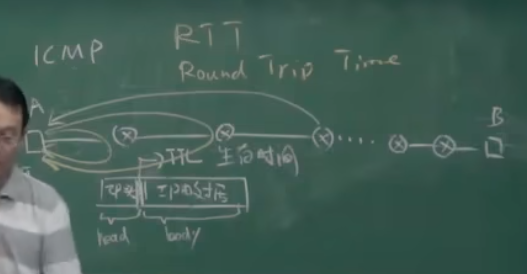
- IP分组头部的TTL是一个整数。每当分组经过一个路由器,该路由器会将TTL的值减1。
- 如果一个路由器收到一个分组,减1后TTL变为0,它会丢弃这个分组,并向源主机发送一个ICMP“超时”错误消息,该消息中包含了它自己的IP地址。
Traceroute 正是利用了这一点来逐跳探测:
- 探测第一跳:发送一个TTL=1的分组。第一个路由器收到后将TTL减为0,丢弃分组并返回一个ICMP超时消息。程序记录下往返时间。
- 探测第二跳:发送一个TTL=2的分组。该分组会成功通过第一个路由器(TTL变为1),但在第二个路由器处超时,并收到第二个路由器的ICMP回复。
- 以此类推,通过不断增加TTL的值,就可以依次获得路径上每个路由器的IP地址和往返延时。
8.4.2 如何判断探测结束?
当TTL足够大,分组最终能够到达目的主机时,Traceroute会发送一个指向目的主机上一个大概率未被使用的端口的分组。目的主机收到后,发现没有应用程序在该端口监听,于是会返回一个不同类型的ICMP消息——“目标端口不可达”。当Traceroute程序收到这个消息时,就知道探测已经完成。
通过分析tracert的输出,我们可以直观地看到网络路径和延时情况。例如,当延时在某两跳之间突然从几十毫秒剧增到上百毫秒时,通常意味着数据包跨越了长距离的物理链路,比如飞跃了大洋。
8.5 分组丢失 Packet loss
我们首先回顾一下分组丢失的原因:路由器的输出队列(即缓冲区)容量是有限的。当一个分组到达时,如果其对应的输出队列已满,路由器将无法缓存这个分组,只能将其丢弃。这个被丢弃的分组,就如同进入了网络核心,却再也没能出来。
8.5.1 丢失分组的结局
一个分组在网络中丢失后,它的“命运”主要有三种,具体取决于该路径上所使用的网络协议。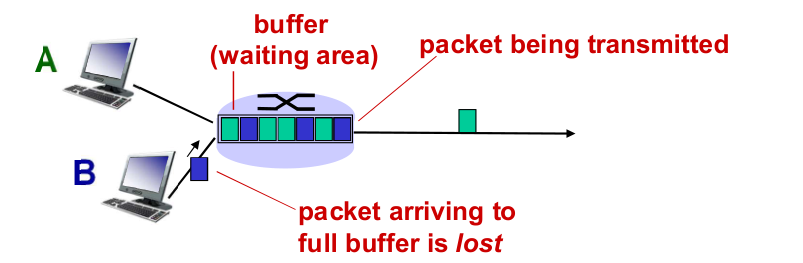
-
由前一个节点重传 如果分组丢失发生在一个可靠的数据链路层上(例如Wi-Fi),那么负责重传的是发送这个分组的前一个节点。这类链路层协议自身包含确认和重传机制,它会坚持不懈地发送,直到收到对方的确认(“OK”)为止。
-
由源端系统重传 如果链路层是不可靠的(例如以太网),它不会负责重传,丢失的责任就交给了上层。如果源端主机使用的是可靠的传输层协议(如TCP),那么TCP协议会检测到这次丢失,并由源端主机重新发送这个分组。
-
根本不重传 如果链路层不可靠,同时源端主机使用的传输层协议也是不可靠的(如UDP),那么这个分组丢失了就真的丢失了。因为应用程序选择使用UDP,就表明它本身对数据的可靠性要求不高,可以容忍一定程度的丢包。
8.5.2 拓展:协议设计中的可靠性权衡
这里我们补充一个重要的协议设计理念:为什么有的链路层可靠,有的却不可靠?
这其实是一种权衡。如果物理介质本身就不可靠,比如充满干扰的无线环境,那么数据链路层协议(如Wi-Fi)就有必要实现可靠传输机制,来“亡羊补牢”,尽早修正错误,向上层提供一个相对可靠的服务。
反之,如果物理介质本身就非常可靠,比如现代的光纤以太网,那么在链路层再增加复杂的确认和重传机制就显得多余,如同“响鼓不用重锤”。这样做只会增加不必要的开销。因此,以太网协议选择向上层提供不可靠的服务,把极少数情况下的错误恢复工作留给更高层的协议去处理。
8.6 吞吐量
吞吐量(Throughput) 指的是在单位时间内,从源主机成功传输到目标主机的有效比特数量,其单位通常是比特/秒(bps)。我们可以区分两种吞吐量:瞬间吞吐量指某个时间点的速率,而平均吞吐量则是在一个较长时间段内的平均速率。
(end-to-end) throughput: rate (bits/time unit) at which bits from the sender are received by the receiver.
- instantaneous: rate at given point in time
- average: rate over longer period of time
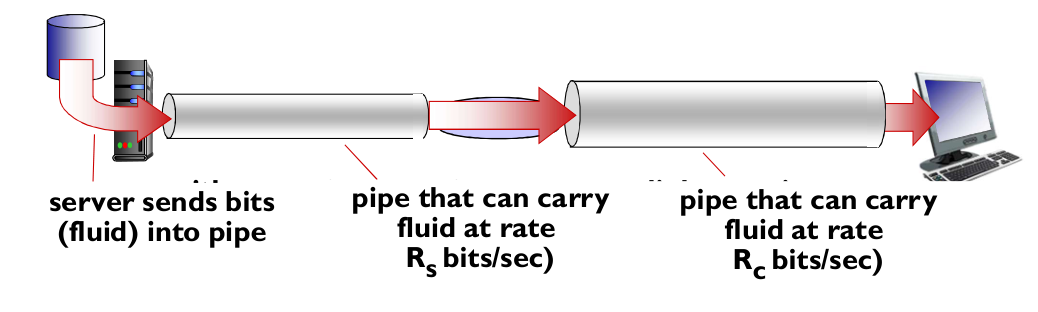
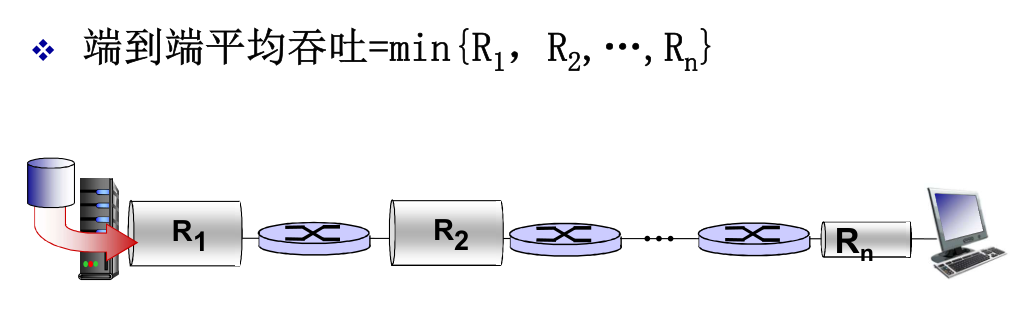
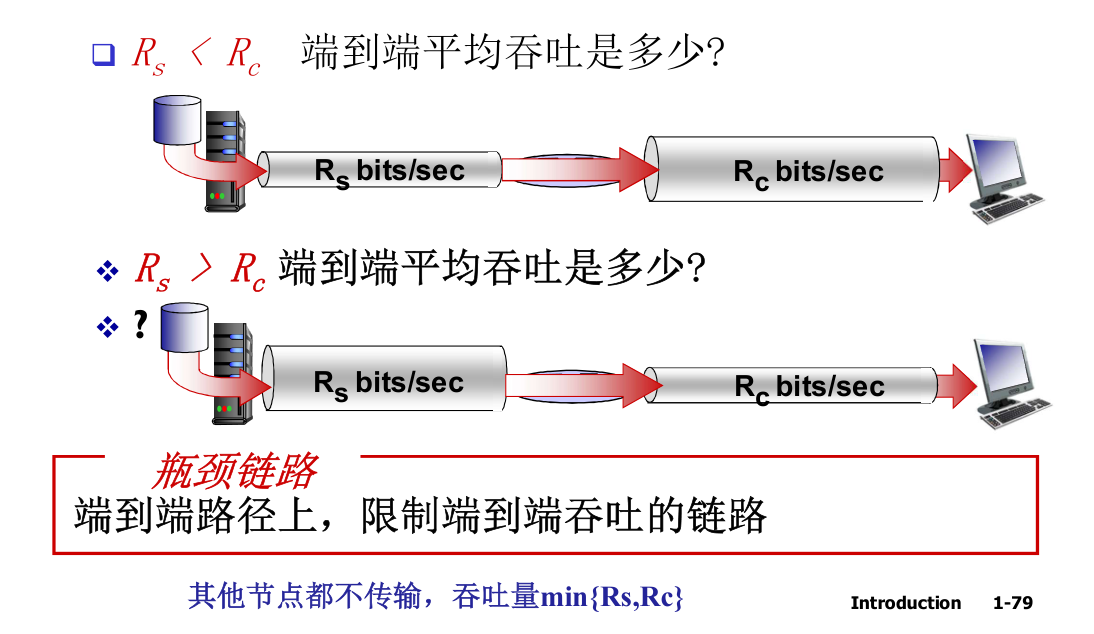
8.6.1 瓶颈链路 (Bottleneck Link)
link on end-end path that constrains end-end throughput
在从源到目标的整个路径上,端到端的吞吐量受到路径上某个或某些链路的限制,这个限制了整体性能的链路,我们称之为瓶颈链路。
简单场景分析
- 假设一条网络路径由两个串联的管道构成,一个细一个粗。那么,整体的水流量(吞吐量)必然是由那个更细的管道决定的。同理,如果一条通信路径由多个带宽不同的链路组成,并且这条路径是独占的,那么它的端到端吞吐量就等于其中带宽最小的那个链路的带宽。
互联网真实场景分析
-
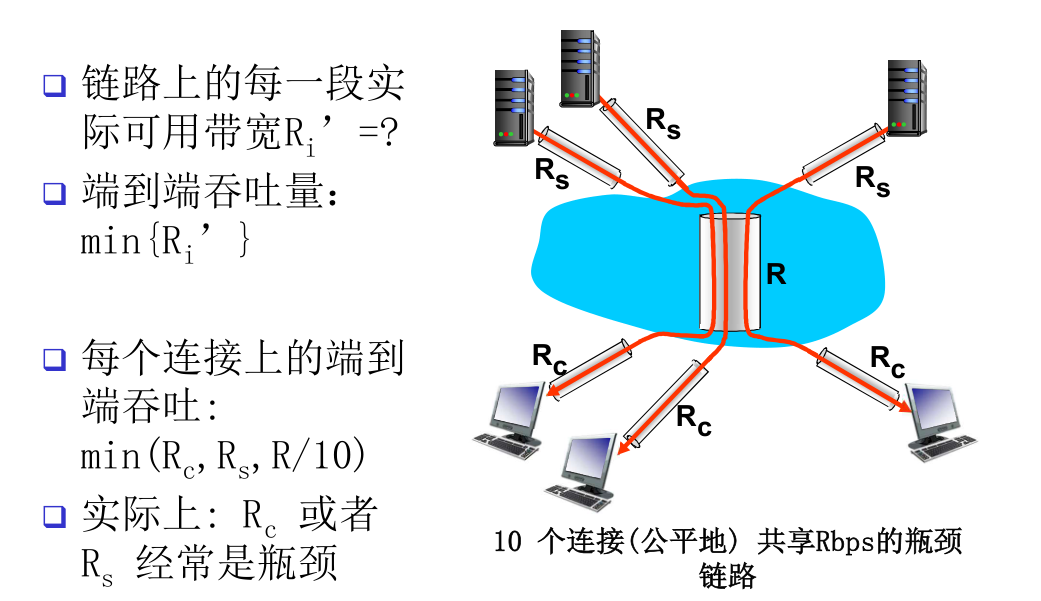
在真实的互联网中,情况要复杂得多,因为链路几乎总是共享的,而不是独占的。
-
假设从主机A到主机B的路径中间经过了某一段链路。这条链路除了为A和B的通信服务外,很可能同时还在为其他N-1对主机的通信服务。如果这条链路的总带宽是 ,并且有 个通信流在公平地共享它(TCP协议的公平性机制保证了这一点),那么A到B的通信在这条链路上实际能获得的带宽仅仅是 。
-
因此,要确定真实的端到端吞吐量,我们必须计算出路径上每一条链路为我们提供的有效带宽(即该链路总带宽除以共享它的连接数),然后找出其中的最小值。这个最小值才是最终的端到端吞吐量,而提供这个最小有效带宽的链路,就是真正的瓶颈链路。
9 网络安全 Network security
- Internet not originally designed with (much) security in mind
- original vision: “a group of mutually trusting users attached to a transparent network” ☺
- Internet protocol designers playing “catch-up”
- security considerations in all layers!
- We now need to think about:
- how bad guys can attack computer networks
- how we can defend networks against attacks
- how to design architectures that are immune to attacks
9.1 Bad guys: packet interception
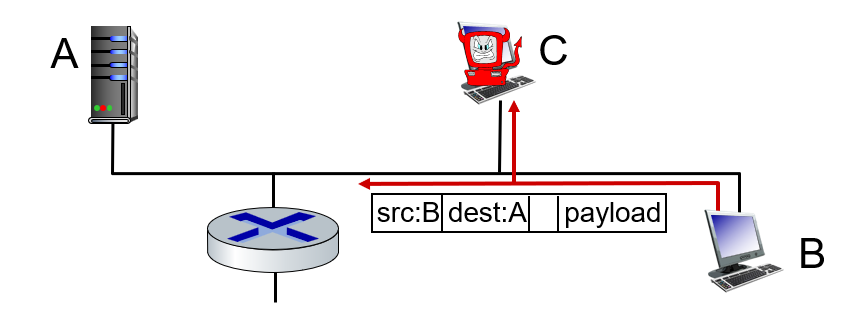
9.1.1 packet “sniffing”:
- broadcast media (shared Ethernet, wireless)
- promiscuous network interface reads/records all packets (e.g., including passwords!) passing by
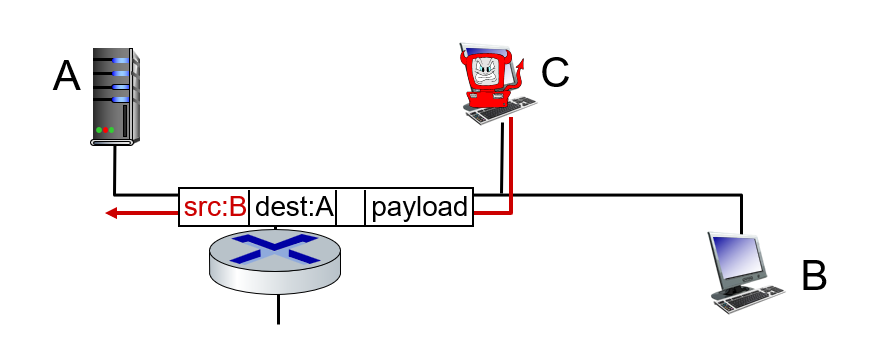
9.1.2 IP spoofing:
- injection of packet with false source address
9.1.3 Denial of Service (DoS):
- attackers make resources (server, bandwidth) unavailable to legitimate traffic by overwhelming resource with bogus traffic
- select target
- break into hosts around the network (see botnet)
- send packets to target from compromised hosts
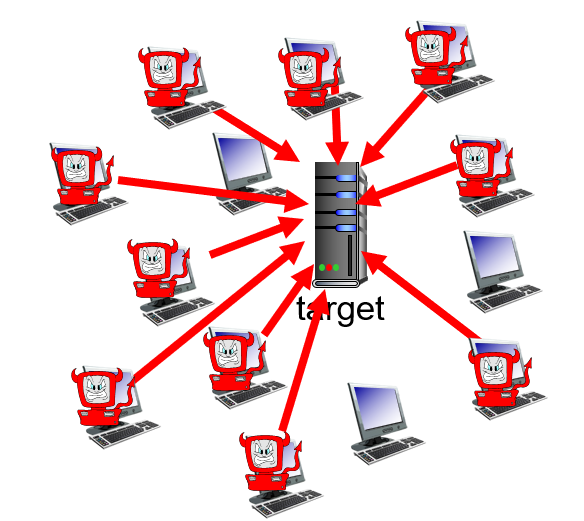
9.2 Lines of defense:
- authentication: proving you are who you say you are
- cellular networks provides hardware identity via SIM card; no such hardware assist in traditional Internet
- confidentiality: via encryption
- integrity checks: digital signatures prevent/detect tampering
- access restrictions: password-protected VPNs
- firewalls: specialized “middleboxes” in access and core networks:
- off-by-default: filter incoming packets to restrict senders, receivers, applications
- detecting/reacting to DOS attacks
… lots more on security (throughout, Chapter 8)
10 协议层次及服务模型
10.1 为什么需要分层?—— 网络是一个复杂的系统
教师首先指出,计算机网络是一个异常复杂的大系统。其复杂性体现在:
- 功能繁杂:网络需要实现多种功能,从底层的物理信号传输,到点到点通信、路由选择、可靠数据传输,再到区分不同进程的应用层功能等。
- 构成多样:网络由数以百亿计的设备(主机、路由器)、形态各异的链路、成千上万的应用和协议构成,涉及大量的硬件和软件。
面对如此复杂的系统,工程师和科学家需要一种有效的方法来设计、实现和组织网络功能。
10.1.1 解决复杂问题的思路:模块化与分层
解决复杂问题的思路主要有两种:模块化和分层。
- 模块化分解:将复杂功能拆解成一个个独立的模块,模块之间可以相互调用。
- 分层:这是一种特殊的模块化方式。它同样将功能分解,但模块(层次)之间的调用关系受到严格限制,即只允许相邻的层次之间进行调用,不推荐或不允许跨层调用。
计算机网络的设计与实现,正是采用了这种分层的方式。
现实生活中的例子:异地哲学家交流
为了帮助理解,教师用一个生动的例子进行说明:两位身处异地、使用不同语言的哲学家需要进行思想交流。这个问题可以通过分层来解决:
- 第三层(哲学家层):负责交流哲学思想。这对应网络中的应用层,两个应用进程在这里交换应用报文,实现具体功能。
- 第二层(翻译层):负责语言转换。将哲学家的母语翻译成双方约定好的“共用语言”。这对应网络中的表示转换功能。
- 第一层(秘书层):负责信件的实际传输,解决异步和异地通信的问题。秘书可以通过邮局、马车或互联网等方式发送信件。这对应网络中的底层通信功能。
这个例子清晰地展示了分层的好处:
- 简化问题:将一个复杂的大问题分解为三个相对独立且功能单一的子问题。
- 便于技术更新:任何一层的实现技术都可以独立更新。例如,秘书层可以将通信方式从马车升级为电报,而哲学家层和翻译层完全不受影响。
当然,分层也存在一个潜在缺点,即与一体化的实现方式相比,效率可能会稍低。
10.2 服务、协议与接口的正式描述
在理解了分层的基本思想后,教师对几个核心概念进行了更正式的描述。
10.2.1 各层次如何协同工作?
- 本层协议实现:每一层为了实现自身的功能(例如提供可靠传输),本层的两个对等实体(Peer Entity)需要进行交互。它们交互时所遵循的规则、动作的集合,就是协议(Protocol)。协议是一种水平关系。
- 借助下层服务:本层协议实体在进行交互时,无法直接通信。它必须通过层间接口,使用其紧邻的下一层所提供的服务,来交换协议数据单元(PDU)。
- 向上层提供服务:本层协议通过交互和内部处理,实现了更复杂、更高级的功能。这些新功能会通过层间接口,向上层提供更好的服务。这是一个垂直关系。
通过这种“一层摞一层”的方式,从最底层的物理层(负责发送电磁波或光信号)开始,逐层构建,最终实现了计算机网络极其复杂的功能。
10.2.2 每一层提供的“新服务”是什么?
教师特别强调,某一层(例如团长层)向上层提供的服务,不仅仅是其下所有层次(连长、士兵等)服务的简单总和。它还必须包含由本层协议实体(团长与团长)之间交互所带来的新功能。如果一个层次没有增加任何新的服务特性,那么这个层次的存在就没有必要。
10.3 核心术语详解
10.3.1 1. 服务 (Service)
服务是低层实体向上层实体提供的通信能力,是一种垂直关系。上层实体通过层间接口来访问下层提供的服务。
- 服务用户 (Service User) 与 服务提供者 (Service Provider):在一个场景中,角色是相对的。例如,TCP 实体可以同时为 FTP、Web 等多个应用提供服务。此时,这些应用就是“服务用户”,而 TCP 实体就是“服务提供者”。
- socket API 就是一个典型的例子,它是传输层向应用层提供的服务接口。
比如应用层有 A1,A2,A3这些服务
- A1 A2 A3就是服务用户
- TCP就是服务提供者
- 通过层接界面服务访问点来区分用户
10.3.2 2. 服务访问点 (SAP - Service Access Point)
SAP 是上层使用下层服务时,位于层间接口上的一个“地点”或“地址”。它的主要作用是区分不同的上层用户。
因为一个服务提供者(如 TCP 实体或顺丰快递)通常需要同时为多个用户服务,所以必须有一个机制来区分数据或包裹是给谁的。在传输层,端口(Port) 就是一种 SAP。我们常说的套接字(Socket),就可以理解为一个服务访问点。
10.3.3 3. 原语 (Primitive)
原语是上层使用下层服务的具体形式,可以理解为一组预先定义好的命令或函数。服务提供者能提供多种多样的服务(如寄快件、代收货款),服务用户需要通过不同的原语来明确告知它到底想使用哪一种服务。
在 socket 编程中,像 create_socket, send, close 等一系列API函数,就是原语的具体体现。
10.4 服务的类型
根据通信前是否需要建立连接,服务可以分为两大类。
10.4.1 1. 面向连接的服务 (Connection-oriented Service)
在这种服务模式下,两个通信实体在进行实质性的数据交换之前,必须先进行“握手”,即建立一个连接。这个过程会为后续的通信分配和准备资源。通信结束后,还需要拆除连接。
- 过程:建立连接 → 通信 → 拆除连接。
- 特点:通常能保证数据传输的顺序(保序)。
- 适用范围:适合传输较大的数据块。
- 例子:TCP 协议提供的就是面向连接的服务。网络层的虚电路(Virtual Circuit)也是一个例子。
10.4.2 2. 无连接的服务 (Connectionless Service)
这种服务模式下,通信实体之间无需预先建立连接,可以直接发送数据。它不预留资源,也不要求通信双方都处于活跃状态,就像寄信一样。
- 特点:通常是不可靠的,可能出现数据丢失、重复或失序的情况。
- 适用范围:适合传输零星、少量的数据。
- 例子:UDP 协议提供的就是无连接的服务。IP 分组本身也是无连接的。
10.5 服务与协议的最终总结
最后,教师再次总结了服务与协议的区别与联系,这是理解网络体系结构的关键。
-
区别
- 服务 (Service):是垂直的,存在于相邻的两个层次之间,通过原语在 SAP 上进行操作。
- 协议 (Protocol):是水平的,存在于不同机器上的对等层实体之间,是它们通信时必须遵守的规则集合。
-
联系
- 本层协议的实现,必须依赖和使用下层提供的服务。
- 实现本层协议的目的,是为了向上层提供更高级、更好的服务。
通过这个精巧的循环关系,计算机网络将复杂的功能层层构建起来,最终得以高效地运行。
好的,这是根据您提供的课堂录音、幻灯片和已有笔记,为您整理的一份更完善、更详细的课堂笔记。
10.6 数据单元(DU)的深入理解
10.6.1 核心概念:SDU 与 PDU
教师首先强调了两个最重要的概念:服务数据单元(SDU)和协议数据单元(PDU)。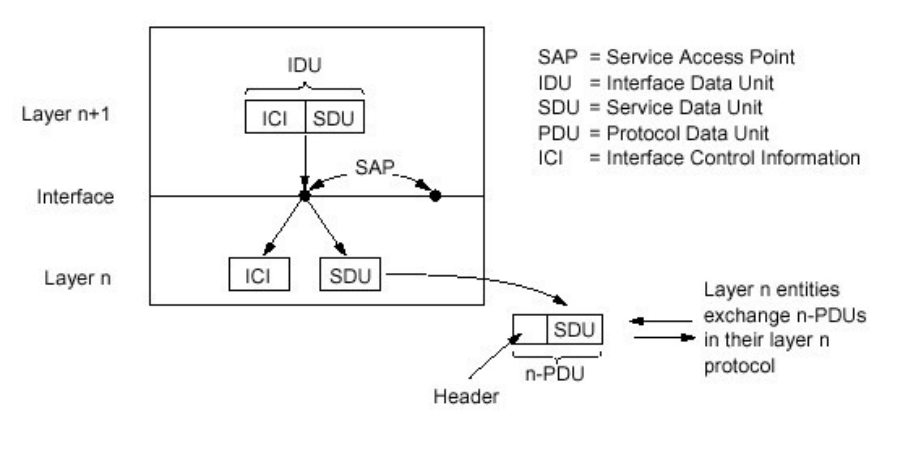
-
服务数据单元 (SDU - Service Data Unit):指上层要委托本层传输的数据。可以将其形象地理解为上级(如师长)交给下级(如团长)的一个需要传递的任务包。
-
协议数据单元 (PDU - Protocol Data Unit):指本层的协议实体之间实际交换的数据单元。它的构成是:从上层接收到的 SDU,加上本层为了实现协议功能而附加的控制信息(通常称为头部 Header)。
最核心的关系:上层传下来的数据(SDU),在本层被加上一个头部(控制信息),就形成了本层的 PDU。这个 PDU 传递到下一层时,又会成为下一层的 SDU。
10.6.2 SDU 与 PDU 之间的三种关系
在实际网络传输中,一个上层的 SDU 并非总是刚好封装成一个本层的 PDU。它们之间主要存在三种关系:
- 一对一:最理想的情况,一个 SDU 被封装成一个 PDU 的数据部分。
- 一对多(分割):当上层传来的 SDU 过大,超过了本层 PDU 的最大尺寸限制时,本层会先将这个大的 SDU 分割成多个小块,然后为每个小块分别加上头部,形成多个 PDU。
- 多对一(合并):当上层传来的 SDU 非常小时,为了提高传输效率,本层可能会将多个小的 SDU 合并在一起,然后只加上一个共同的头部,形成一个 PDU。
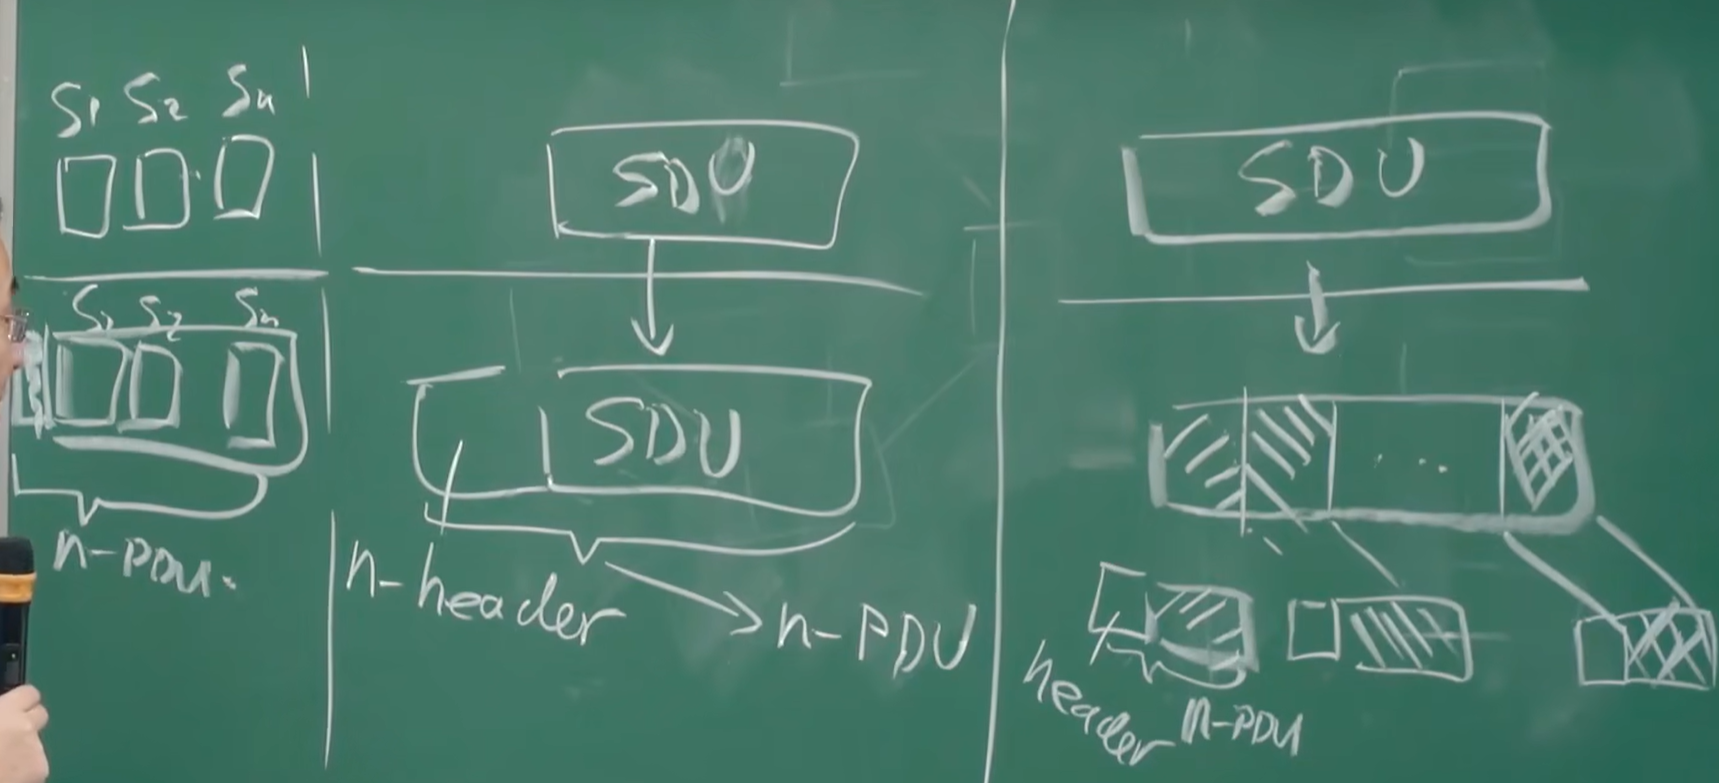
10.6.3 各层次 PDU 的专用名称
在 Internet 协议栈中,每一层的 PDU 都有一个约定俗成的名称,我们需要熟记: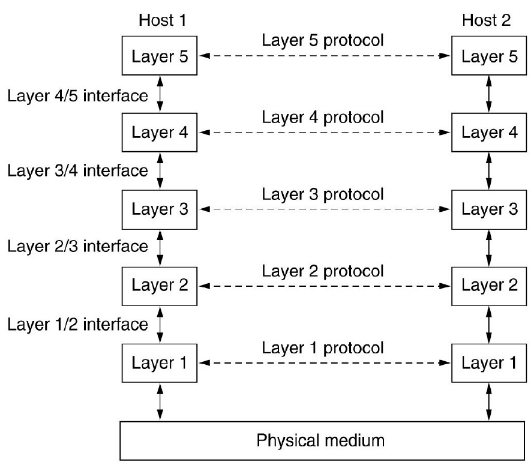
- 应用层:报文 (Message)
- 传输层:报文段 (Segment)。教师补充道,其全称是 Message Segment,意指一个长报文被分成的“一段”。
- 网络层:分组 (Packet)。在像 IP 这样的无连接网络中,分组也常被称为数据报 (Datagram)。
- 数据链路层:帧 (Frame)
- 物理层:位 (Bit)。教师指出这个称呼相对含糊,不如上面几层明确。
10.7 分层处理的优势与劣势
在深入学习具体的网络模型前,我们再次总结一下采用分层方法来设计复杂网络系统的好处与坏处。
10.7.1 分层的好处
- 概念化 (分而治之):结构清晰,将一个庞大复杂的问题分解为若干个规模更小、功能独立的子问题。这使得每一层的功能都更容易被设计和实现。
- 结构化 (易于维护和升级):模块化的设计使得任何一层的实现技术都可以独立更新,而不会影响到其他层。只要层间接口保持不变,底层的技术革新对上层是透明的。
- 例子:就像之前提到的哲学家模型,秘书层可以将通信方式从马车升级到电报,而翻译层和哲学家层的工作完全不受影响。
- 便于交流和标准化:清晰的层次划分和术语定义,为全球的工程师和研究人员提供了讨论和制定标准的共同语言。
10.7.2 分层的劣势
分层的主要缺点是效率可能相对较低。因为数据每经过一层,都需要进行封装或解封装等处理,这些操作会带来一定的开销。相比之下,一个“一股脑”实现的整体系统可能会运行得更快。
结论:尽管存在效率问题,但分层带来的巨大好处远超其弊端。因此,分层是现代计算机网络设计的基本原则。
10.8 Internet 协议栈 (TCP/IP 五层模型)
| 层次 | 服务 | 传输单位 | 协议 |
|---|---|---|---|
| 应用层 | 网络应用(实现网络应用) 为人类用户或者其他应用进程提供网络应用服务 | 报文(message) | FTP,SMTP,HTTP,DNS |
| 传输层 | 主机之间的数据传输(区分进程,把不可靠变为可靠) 在网络层提供的端到端通信基础上,细分为进程到进程,将不可靠的通信变成可靠地通信 | 报文段(segment):TCP段,UDP数据报 | TCP,IP |
| 网络层 | 为数据报从源到目的选择路由( 转发、路由 ) 主机主机之间的通信,端到端通信,不可靠 | 分组packet(如果无连接方式:数据报datagram) | IP,路由协议 |
| 链路层 | 相邻网络节点间的数据传输(相邻两点间,以帧位单位的传输) 2个相邻2点的通信,点到点通信,可靠或不可靠 | 帧(frame) | 点对对协议PPP,802.11(wifi),Ethernet |
| 物理层 | 在线路上传送bit(相邻两点间电磁波的承载,以bit的传输) | bit |
互联网的功能被划分为五个层次,自下而上分别是:
物理层
- 功能:在物理媒介(如铜线、光纤)上传输原始的比特流(0和1)。它负责将数字比特转换为物理信号(如电信号、光信号)进行发送,并在接收端反向执行该过程。
- 范围:相邻节点间的比特传输。
链路层
- 功能:在物理层提供的比特流服务之上,将数据组织成帧 (Frame),并实现在相邻两个节点之间的可靠或不可靠的数据传输。它解决了如何从比特流中识别出一个个独立数据单元的问题。
- 范围:点对点(相邻节点间)的通信。
网络层
- 功能:将链路层提供的“相邻节点间”的传输能力,扩展为“源主机到目标主机”的端到端传输。它负责在复杂的网络中为分组(Packet)选择最佳路径。
- 核心任务:路由 (Routing) - 规划全局路径;转发 (Forwarding) - 在路由器上根据指令将分组从一个端口移到另一个端口。
传输层
- 功能:在网络层提供的“主机到主机”的服务基础上,提供“进程到进程”的通信服务。
- 核心任务:
- 进程区分:通过端口号等机制,确保数据能够准确送达目标主机上的特定应用程序。
- 服务增强:可以将网络层不可靠的传输服务,转变为对上层应用可靠的传输服务(如 TCP 协议所做的)。
应用层
- 功能:直接面向用户,利用传输层提供的服务,通过交换报文 (Message) 来实现各种各样的网络应用,例如网页浏览(HTTP)、文件传输(FTP)、电子邮件(SMTP)等。
10.9 ISO/OSI 参考模型 (七层模型)
除了互联网实际采用的五层模型,还有一个理论上更完备的七层参考模型,由国际标准化组织(ISO)提出。它在传输层和应用层之间增加了两个额外的层次:
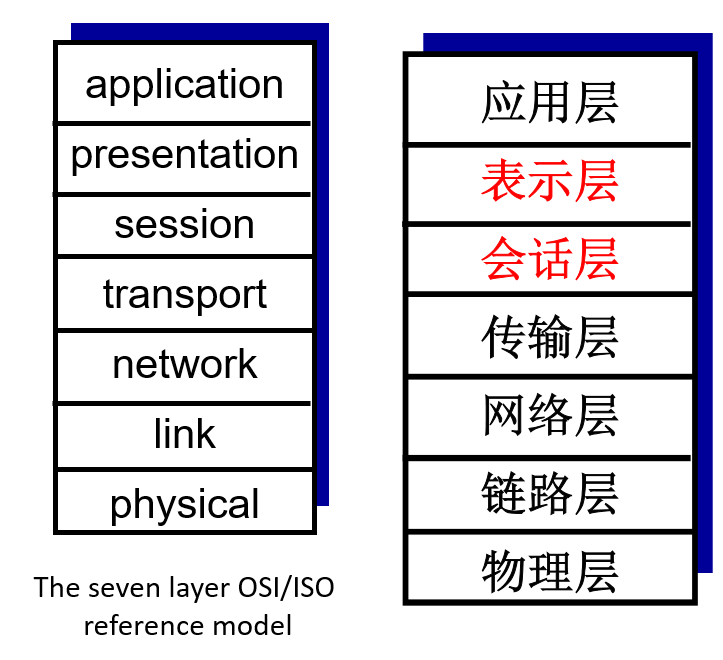
Two layers not found in Internet protocol stack!
-
presentation: allow applications to interpret meaning of data, e.g., encryption, compression, machine-specific conventions
-
session: synchronization, checkpointing, recovery of data exchange
-
Internet stack “missing” these layers!
- these services, if needed, must be implemented in application
- needed?
-
会话层:负责建立、管理和终止应用程序之间的会话(或称对话),例如数据交换的同步、设置检查点和恢复等。
-
表示层:负责数据的表示、转换和格式化,确保一个系统的应用层所发送的信息可以被另一个系统的应用层理解。例如,数据加密、压缩、编码转换等。
与 Internet 模型的关系:在 Internet 协议栈中,并没有独立的会话层和表示层。如果应用程序需要这两层的功能,必须由应用层自己来实现。
10.10 数据的封装与解封装过程(Services, Layering and Encapsulation)
数据在网络中的传输过程,在逻辑上看是应用层与应用层直接通信,但物理上,数据必须经历一个自顶向下封装和自底向上解封装的复杂过程。 Application exchanges messages to implement some application service using services of transport layer
Transport-layer protocol transfers (e.g., reliably) from one process to another, using services of network layer
- transport-layer protocol encapsulates application-layer message, , with transport layer-layer header to create a transport-layer segment
- used by transport layer protocol to implement its service
Network-layer protocol transfers transport-layer segment from one host to another, using link layer services
-
network-layer protocol encapsulates transport-layer segment with network layer-layer header to create a network-layer datagram
- used by network layer protocol to implement its service
-
Link-layer protocol transfers datagram from host to neighboring host, using network-layer services
-
link-layer protocol encapsulates network datagram , with link-layer header to create a link-layer frame
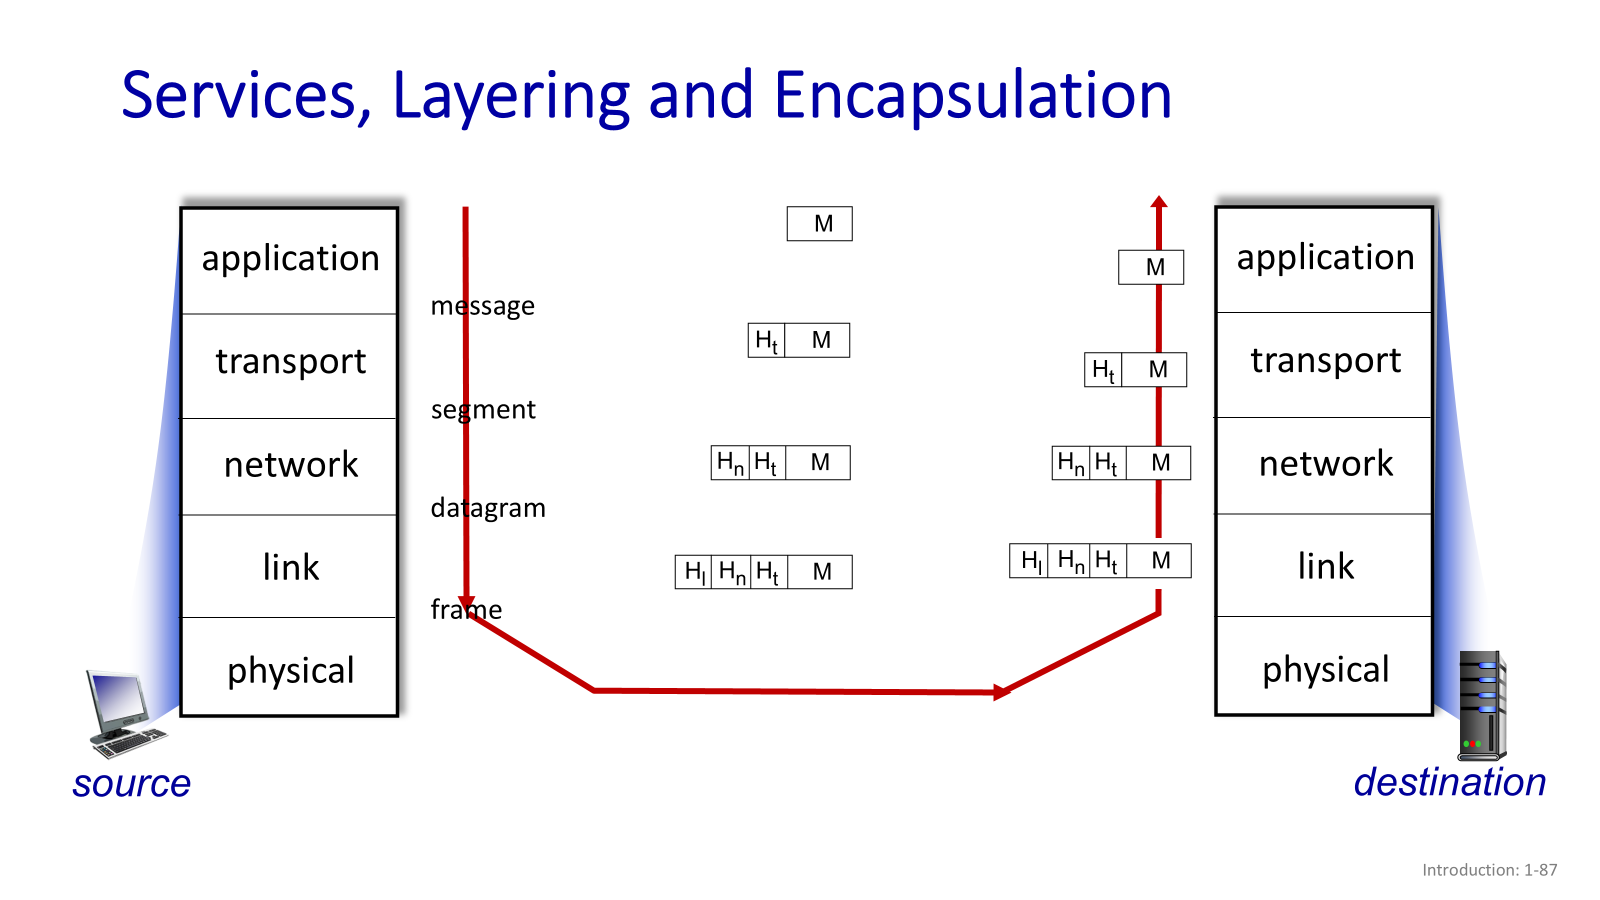
中文描述
10.10.1 1. 源端的封装 (Encapsulation)
当应用程序发送数据时,数据会从应用层开始,逐层向下传递:
- 应用层的报文(M)被交给传输层。
- 传输层为报文添加一个头部(),形成报文段(Segment),然后交给网络层。
- 网络层为报文段添加一个头部(),形成分组(Packet),然后交给链路层。
- 链路层为分组添加头部()和尾部(),形成帧(Frame),然后交给物理层。
- 物理层将帧转换为比特流,通过物理介质发送出去。
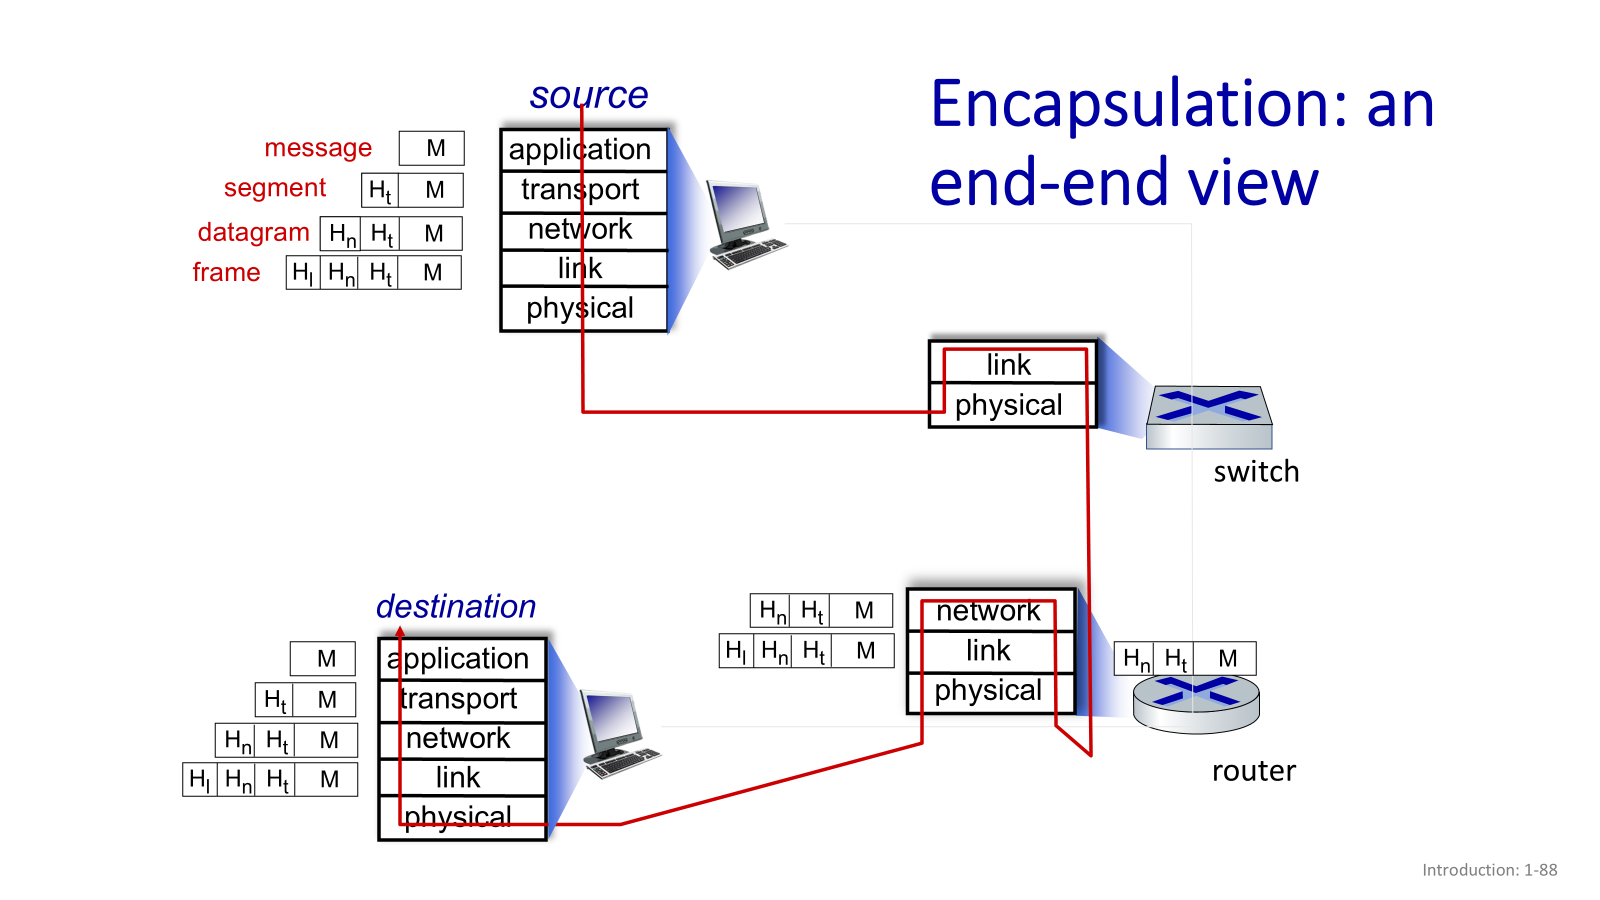
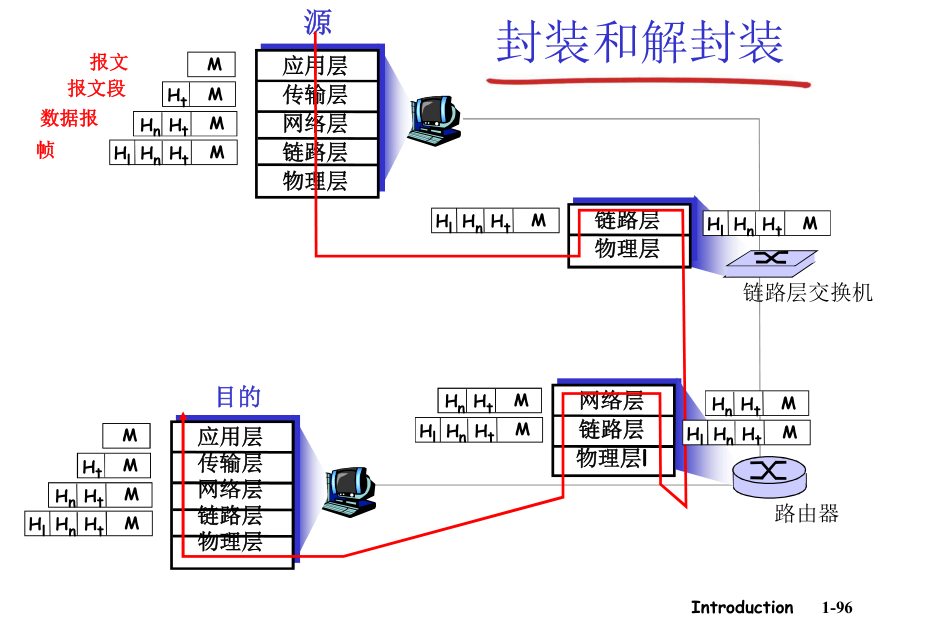
10.10.2 2. 中间设备的处理
数据在到达最终目的地之前,通常会经过交换机和路由器等中间设备。
- 链路层交换机 (Switch):进行两层的解封装和再封装。它接收物理信号并重组为帧,检查帧头部的 MAC 地址以决定从哪个端口转发,然后重新封装成帧发送出去。
- 路由器 (Router):进行三层的解封装和再封装。它接收帧并提取出其中的 IP 分组,检查分组头部的 IP 地址,通过查询路由表来决定下一跳路径,然后将分组重新封装成适合下一段链路的帧进行发送。
10.10.3 3. 目的端的解封装 (Decapsulation)
数据到达目标主机后,会经历一个与封装相反的、自底向上的解封装过程:
- 物理层接收比特流,重组成帧,交给链路层。
- 链路层检查并剥离帧的头部和尾部,将里面的分组交给网络层。
- 网络层剥离分组头部,将里面的报文段交给传输层。
- 传输层剥离报文段头部,将原始的应用报文或其一部分交给应用层。
- 应用层最终收到发送方发出的原始报文,完成通信。
这个“封装 → 转发 → 解封装”的过程,确保了数据能够跨越复杂的网络,准确无误地从源进程抵达目标进程。
11 计算机网络发展史
这节课我们将完成第一章的最后一节内容,即计算机网络,特别是互联网的发展历史。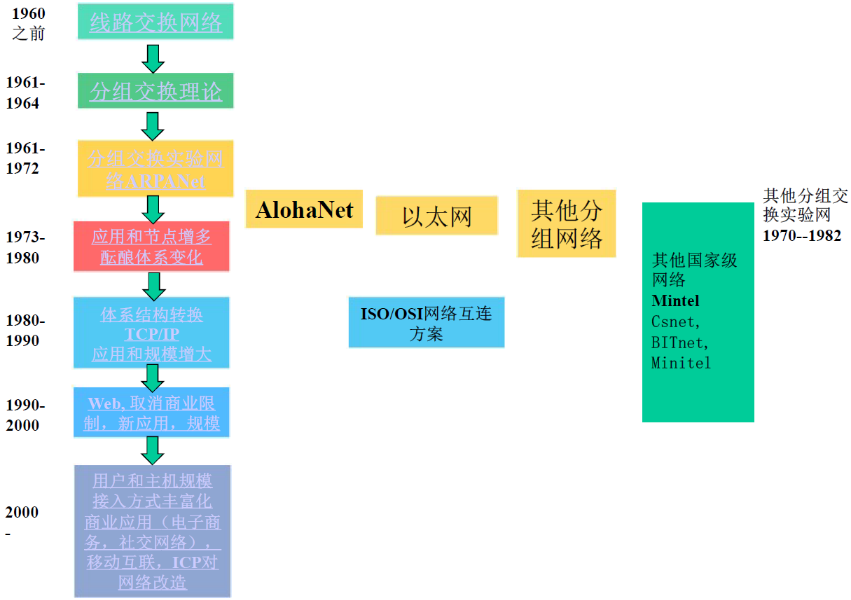
互联网发展那么快的原因:
- 架构具有很强的包容性
- 应用部署很容易,都能在部署到应用层
11.1 1. 理论奠基期 (1960s): 从线路交换到分组交换
在1960年之前,计算机之间的通信网络普遍采用线路交换(Circuit Switching)。然而,这种技术对于计算机通信存在诸多弊端:
- 建立时间长:相对于计算机通信的瞬时性,建立一条专用线路的耗时过长,代价巨大。
- 资源利用率低:一旦建立连接,线路资源便被独占,这不适合具有很强突发性的计算机数据通信。
- 可靠性不高:核心交换节点的损坏会影响大量通信线路,导致网络大面积瘫痪。
由于这些缺陷,研究人员开始探索一种新的交换方式。当时,由于信息交流不畅,有三个独立的研究小组分别在理论上提出了分组交换(Packet Switching),并证明了它更适合具有突发性的计算机通信。
11.2 2. 实验与诞生 (1962-1972): ARPANET的构建
11.2.1 ARPANET的起源
理论的突破需要实践的验证。在麻省理工学院(MIT),研究人员向美国国防部高级计划研究局(ARPA,当时称DOD)申请资助,希望建造一个实验性的分组交换网络,以验证其在资源共享和可靠性方面的优势。
他们在项目申请书中强调的核心论点是:对于军方通信网络,如果采用分组交换,即使核心交换节点被摧毁,也只会影响正在该节点处理的分组,其余数据可以绕道而行,从而极大地提升了网络的可靠性。这个论点成功说服了美国国防部。
11.2.2 第一个节点与早期网络
- 1969年,第一个ARPANET节点在加州大学洛杉矶分校(UCLA)建立,其核心设备被称为接口报文处理机(IMP)。
- 到1969年底,一个由四个节点组成的ARPANET初步建成,这便是互联网的前身。
当时的节点设计与现在不同。每个节点既是主机(数据的源和目的地),又是网络交换设备(负责存储转发)。这意味着一台设备不仅自己产生和接收数据,还能为其他设备中转数据。
11.2.3 NCP协议与早期应用
1972年,ARPANET进行了一次公开展示,尝试远程登录(Telnet)到UCLA的一台主机,但展示以宕机失败告终。当时网络运行的协议是NCP(Network Control Protocol),它相当于今天TCP和IP协议功能的综合体,既负责数据转发,也为应用程序提供通信服务。
同年,第一个Email应用程序诞生,到1972年底,ARPANET的节点数量增长到了15个。
11.3 3. 网络的“战国时代”与互联难题 (1972-1980s)
11.3.1 “雨后春笋”般的网络
ARPANET的成功证明了分组交换的可行性,各种基于存储转发思想的网络如雨后春笋般涌现,例如:
- 夏威夷的AlohaNET(微博网络)
- 以太网(Ethernet)
- ATM网络
- 法国等国家的专用网络
这导致了一个非常混乱的局面:标准不一。教师举例说,仅IBM公司自己在数据链路层就有四十多种不同的标准,连自家不同部门的产品都难以互联,更不用说与其他公司的设备连接了。
11.3.2 解决方案一:私有体系架构
为了解决内部产品的互联问题,各大公司开始制定自己的私有网络体系架构,例如DEC公司的DECNET和IBM公司的SNA。
教师拓展:施乐公司(Xerox) 教师提到,当时还有一家比IBM更强大的公司——施乐。它在信息技术领域走在时代前沿,最早的图形用户界面(GUI)、鼠标等创新都出自其研究中心。然而,这家曾经伟大的公司如今已没落,主要销售复印机等办公设备。
11.3.3 解决方案二:OSI的“大一统”理想
为了实现全球范围内的网络互联,国际标准化组织(ISO)提出了OSI(开放系统互联)参考模型,即我们熟知的“七层模型”。
然而,OSI方案存在致命缺陷:
- 思路问题:它要求彻底抛弃所有现有网络设备,重新购买符合OSI标准的新设备。这种“砸掉旧世界,建立新世界”的革命性方案,因成本过高而无法被市场接受。
- 技术问题:OSI标准由具有电信背景的技术官僚制定,显得过于臃肿和低效。如果在每一层都完整实现其复杂的协议,系统的整体效率会非常低下。
11.4 4. 互联网的诞生:TCP/IP的胜利
11.4.1 Cerf与Kahn的网络互联原则
面对互联难题,ARPANET的技术人员Vint Cerf和Robert Kahn(被誉为“互联网之父”)提出了一套截然不同的网络互联原则,它采用了**覆盖(Overlay)**的方法,指导了互联网未来几十年的发展。
11.4.2 IP over Everything: 包容性的架构
TCP/IP方案的核心思想是包容性,而非取代。
- IP作为通用层:在各种各样的物理网络(如以太网、ATM网)之上,增加一个统一的IP层。IP分组可以被封装在任何物理网络的帧中传输。
- 尽力而为的服务:IP层只提供“尽力而为”(Best-Effort)的不可靠传输服务。
- 端到端可靠性:可靠数据传输的问题被推到网络的边缘,由**端系统(主机)**上的TCP协议来解决。
- 无状态路由器:网络核心的路由器不维护通信状态,每个分组都包含完整的地址信息,被独立转发。
这种架构极具包容性,因为它对底层物理网络的要求极低(“你只要好意思叫网络,就可以接到IP网上”),从而保护了用户已有的投资,只需进行软件层面的改动即可接入。
11.4.3 1983年“标记日”(Flag Day)
为了实现这一新的架构,ARPANET进行了一次重大的“革命性”升级。
- 1983年1月1日,这个被定为“标记日”的一天,整个ARPANET所有节点停机,进行软件升级,协议栈从NCP切换到TCP/IP。
- 这次升级将原先NCP的功能分解为IP层(网络互联)和TCP/UDP层(传输服务),并明确区分了**主机(包含所有层次)和路由器(只到网络层)**两种设备。
教师指出,这种“一刀切”式的革命性升级在当时节点尚少的情况下是可行的,但对于今天拥有数百亿个节点的互联网来说,已经完全不可能,任何升级都只能是渐进式的。
11.5 5. 商业化前夜:NSFNET与关键应用的出现
TCP/IP架构的包容性体现在两个方面:
- IP over everything:可以连接过去和未来的任何物理网络。
- Everything over IP:在端系统上部署新应用非常容易,无需改动网络核心。
这种应用部署的便捷性极大地促进了互联网经济的发展,形成了“应用吸引用户 → 用户促进ISP扩容 → 更好的网络吸引更多应用”的良性循环。
11.5.1 关键应用:DNS, FTP, Email
- 1982年:基于SMTP协议的Email应用发布。
- 1983年:**域名解析系统(DNS)**诞生。教师特别指出,DNS是一个为其他应用服务的特殊应用,它将人类易于记忆的域名转换为机器工作所需的IP地址。
- 1985年:文件传输协议(FTP)诞生。
11.5.2 NSFNET接管与商业化
起初,ARPANET主要由军方使用。后来,美国国家科学基金会(NSF)资助建立了NSFNET,作为一个连接学术机构的网络,并接入了ARPANET,形成了双骨干网。
一个关键的转折点是,NSFNET放宽了对商业应用的限制,允许盈利性业务在网络上运行。这极大地刺激了互联网的商业化发展,ARPANET逐渐退出历史舞台,NSFNET演变成了我们今天所知的互联网(Internet)。
11.6 6. 万维网(Web)的爆发与浏览器战争 (1990s)
11.6.1 超文本的诞生与Web的发明
- 超文本(Hypertext):由数学家提出的概念,是一种带有链接、可以相互指向的非线性网状文本结构。
- Web的发明:在欧洲核子研究中心(CERN),物理学家**蒂姆·伯纳斯-李(Tim Berners-Lee)**为了更方便地发布和共享实验数据,基于超文本思想,发明了:
- HTML:一种标记语言,用于描述网页结构。
- HTTP:一种协议,用于浏览器和服务器之间的通信。
- 世界上第一个Web服务器和浏览器(当时是字符界面)。
11.6.2 图形浏览器与网景(Netscape)的崛起
- 1994年,**马克·安德森(Marc Andreessen)发布了网景(Netscape)**浏览器,这是第一个大获成功的图形用户界面浏览器。它让普通大众也能轻松访问网页,极大地推动了Web的普及。
11.6.3 微软的反击与“世纪诉讼”
微软公司看到了Web的巨大潜力,迅速开发了自己的Internet Explorer(IE)浏览器,并利用其Windows操作系统的市场垄断地位,将IE免费捆绑在系统中。
尽管早期的IE体验很差,但免费策略对收费的Netscape造成了致命打击。Netscape因此对微软提起了世纪反垄断诉讼,但最终不敌,公司被收购。
11.7 7. 现代互联网:泡沫、移动与未来 (21世纪至今)
11.7.1 杀手级应用与网络泡沫
21世纪初,即时通信、P2P文件共享、社交网络等“杀手级”应用大量涌现,吸引了海量用户。
- 2001年网络泡沫:当时市场极度疯狂,一个简单的网站概念就能上市并获得巨额融资。泡沫破裂后,大批没有实际盈利能力的公司倒下,但也沉淀下了一批真正有实力的公司,如谷歌、思科、雅虎等。
教师拓展:赢者通吃 教师指出,互联网和数字经济具有极强的复制性和网络效应,导致“赢者通吃”的局面。行业第一名通常占据超过一半的市场份额,第二、三名分享剩余部分,后来者几乎没有机会。
11.7.2 移动互联与云计算时代
- 设备:2005年后,智能手机、平板等移动终端数量远超固定终端,移动互联网时代到来。
- 接入:宽带接入(光纤到户)和高速无线接入(4G/5G、Wi-Fi)无处不在。
- 应用:出现了像微信这样的“超级应用”,集成了通信、支付等多种功能。
- 架构:谷歌、微软等内容提供商开始自建全球网络,同时,越来越多的企业和业务迁移到云计算平台。
11.7.3 未来趋势
互联网的下一个发展浪潮被认为是物联网(IoT),同时,互联网的底层体系结构也在酝酿着新的重大变化。
12 第一章内容回顾与总结
在本次课程中,我们将花一些时间,从两个层次对第一章的全部内容做一个回顾和总结。
12.1 高层次回顾
首先,我们从一个较高的层次来梳理本章的核心知识脉络。
- 互联网的定义:我们探讨了“什么是网络、计算机网络以及互联网”,从不同的角度理解了这个庞大系统的构成。
- 协议的重要性:我们定义了什么是协议(Protocol),它是网络通信的基石。
- 网络的基本组成:我们将网络划分为三个主要部分进行分析:网络边缘(端系统)、网络核心(交换设备和链路)以及接入网。
- 核心交换技术:在网络核心部分,我们重点比较了分组交换和线路交换的工作原理与特性。
- 互联网的结构:我们了解到,互联网是一个“网络的网络”,其结构是一个松散的、分层次的体系。尽管ICP等内容提供商自建网络的行为使其结构日益复杂,但分层结构依然是其基本特征。
- 网络性能:由于互联网核心采用分组交换,我们分析了其必然会带来的**丢失(Loss)和延迟(Delay)**问题,并详细讲解了延迟的四种组成部分。此外,**吞吐量(Throughput)**也是衡量网络性能的一个关键指标。
- 层次与服务模型:为了解决设计与实现的复杂性,计算机网络采用了分层设计。每一层都利用下层提供的服务,来实现本层协议的功能,并向其上层提供更高级的服务。通过这种“一层摞一层”的方式,最终构建出功能复杂的网络。
- 互联网发展史:我们简要回顾了互联网的发展历史,帮助大家对它为何能取得如此巨大的成功建立一些感性的认识。
关于网络安全:本章原本包含网络安全内容,但为了更系统地讲解,我们会将其作为一个独立的章节在后续课程中详细介绍。
12.2 细节回顾与重要术语
接下来,我们对一些关键知识点进行更细致的回顾,并强调需要掌握的核心术语。
-
多角度看互联网
- 从组成角度看:互联网由端系统、网络交换设备、通信链路和协议构成。
- 从服务角度看:互联网是为应用程序提供通信服务的基础设施,服务类型包括面向连接和无连接。
- 应用交互模式:主要有客户端/服务器(C/S)模式和对等(P2P)模式。
-
核心网与接入网技术
- 交换方式:需掌握分组交换与线路交换的区别。
- 分组交换的两种方式:虚电路(Virtual Circuit)和数据报(Datagram)。
- 接入技术:包括家庭接入(如ADSL、Cable Modem)、机构接入(如以太网)以及有线和无线等多种方式。
-
分层体系架构的核心术语 教师特别强调,以下这些在分层模型中反复出现的核心术语,希望大家都能切实掌握:
- 服务 (Service)
- 协议 (Protocol)
- 服务访问点 (SAP - Service Access Point)
- 协议数据单元 (PDU - Protocol Data Unit)
- 服务数据单元 (SDU - Service Data Unit)
- 原语 (Primitive)
12.3 实例分析:中国科学技术大学校园网架构
为了让大家对网络结构有更直观的理解,教师以中国科学技术大学(科大)的校园网为例进行了讲解。
12.3.1 内部网络结构
科大校园网内部采用典型的分层结构:
- 接入层:教学楼和办公楼内的用户设备首先连接到楼层交换机。
- 汇聚层:楼层交换机再汇接到大楼的核心交换机。
- 核心层:各个大楼的交换机最终连接到所在校区(如西区)的核心交换机。
各个校区(东、西、南、北区)的核心交换机之间通过冗余的光纤连接在一起,形成一个网状结构(图结构),而非简单的树状结构。
生成树算法 (Spanning Tree Protocol) 尽管物理上存在冗余链路,但在链路层,网络运行了生成树算法。该算法能确保在任意时刻,只有一个无环路的树状拓扑在工作,从而防止数据包在网络中无限循环。其他冗余链路则处于备用状态,一旦主链路故障,它们可以被激活以保证网络的可靠性。
12.3.2 外部连接与服务
- 出口网关:东区网络中心的核心交换机是整个校园网的主要出口,它通过防火墙连接到多个不同的互联网服务提供商(ISP)。
- 服务器部署:许多校内核心服务器,如Web服务器、邮件服务器、办公服务器和FTP服务器等,都直接挂在核心交换机上,以获得最高的访问性能。
- 其他服务:网络中心还提供VPN拨号等接入服务。
12.3.3 作为区域网络中心的角色
科大校园网不仅服务于本校,还扮演着安徽省高校教育网的一个区域网络接口提供商的角色。许多省内高校,如阜阳师范、安徽师大等,都通过科大的网络接入到更广阔的教育网和互联网中。
当然,这些高校自己也会连接到电信、移动等商业ISP。这充分体现了互联网“任意互联”的特性,即一个机构可以通过多个ISP接入互联网,以实现网络的冗余和优化。
13 课后题不错的补充
P2 P31 P25 P27