1 计算机网络 - 第二章习题课
1.1 R17 查看你的Received信息
Print out the header of an e-mail message you have recently received. How many Received: header lines are there? Analyze each of the header lines in the message.
1.1.1 示例邮件头 (Example E-mail Header)
这是一个从 alice@example-sender.com 发送给 bob@gmail.com 的虚构邮件头。
Delivered-To: bob@gmail.com
Received: by 2002:a05:620a:1111:b0:44a:1234:5678 with SMTP id a1csp1234567abc;
        Mon, 27 Oct 2025 10:00:05 -0700 (PDT)
Received: by 10.10.10.11 with SMTP id 42so1234567abc.1;
        Mon, 27 Oct 2025 10:00:04 -0700 (PDT)
Received: from mail-server.example-sender.com (mail-server.example-sender.com. [198.51.100.5])
        by mx.google.com with ESMTPS id 6si1234567abc.71.2025.10.27.10.00.03
        for <bob@gmail.com>
        (version=TLS1_3 cipher=TLS_AES_256_GCM_SHA384);
        Mon, 27 Oct 2025 10:00:03 -0700 (PDT)
Received: from [192.168.1.10] (alice-desktop.local)
      by mail-server.example-sender.com (Postfix 3.5.8) with ESMTP id 8B7C123456
      for <bob@gmail.com>;
      Mon, 27 Oct 2025 17:00:01 +0000 (UTC)
Message-ID: <12345-67890@example-sender.com>
Date: Mon, 27 Oct 2025 17:00:00 +0000 (UTC)
Subject: R17 Header Analysis
From: Alice <alice@example-sender.com>
To: Bob <bob@gmail.com>
1.1.2 R17 问题解答
1.1.2.1 1. “How many Received: header lines are there?” (有多少条 Received: 头?)
在上面的示例邮件头中,总共有 4 条 Received: 头。
1.1.2.2 2. “Analyze each of the header lines in the message.” (分析邮件中的每一个头)
分析 Received: 头的关键在于**从下往上(From Bottom to Top)**阅读。这能追溯出邮件从发件人到收件人的完整路径。
1.1.2.3 📬 邮件路径分析 (从下往上)
Received: Header #4 (最底部 - 邮件的起点)
Received: from [192.168.1.10] (alice-desktop.local)
      by mail-server.example-sender.com (Postfix 3.5.8) with ESMTP id 8B7C123456
      for <bob@gmail.com>;
      Mon, 27 Oct 2025 17:00:01 +0000 (UTC)
- 分析: 这是邮件的第一跳。
from [192.168.1.10]: 发件人 (Alice) 的本地计算机(一个内网IP)正在提交邮件。by mail-server.example-sender.com: 邮件被 Alice 公司的外发邮件服务器(example-sender.com)接收。with ESMTP: 使用的是标准 SMTP 协议。Mon, 27 Oct 2025 17:00:01 +0000 (UTC): UTC 时间 17:00:01,邮件离开 Alice 的电脑。
Received: Header #3 (第二跳 - 跨越互联网)
Received: from mail-server.example-sender.com (mail-server.example-sender.com. [198.51.100.5])
        by mx.google.com with ESMTPS id 6si1234567abc.71.2025.10.27.10.00.03
        for <bob@gmail.com>
        (version=TLS1_3 cipher=TLS_AES_256_GCM_SHA384);
        Mon, 27 Oct 2025 10:00:03 -0700 (PDT)
- 分析: Alice 的服务器将邮件发送给 Bob 的邮件服务商(谷歌)。
from mail-server.example-sender.com [198.51.100.5]: Alice 公司的服务器(现在显示其公网IP)正在发送。by mx.google.com: 邮件被谷歌的邮件交换 (MX) 服务器接收。with ESMTPS: 使用了安全的、加密的 SMTP (注意那个 “S”)。括号里显示它使用了TLS1_3加密。Mon, 27 Oct 2025 10:00:03 -0700 (PDT): 谷歌在太平洋时间 10:00:03 收到邮件(注意时区变化,17:00 UTC确实等于10:00 PDT)。
Received: Header #2 (第三跳 - 谷歌内部路由)
Received: by 10.10.10.11 with SMTP id 42so1234567abc.1;
        Mon, 27 Oct 2025 10:00:04 -0700 (PDT)
- 分析: 邮件在谷歌的数据中心内部被传递。
by 10.10.10.11: 谷歌的内部服务器(10.10.10.11是一个内部IP)接收了邮件。这可能是用于垃圾邮件扫描或分发。- 这比上一跳晚了 1 秒钟 (
10:00:03→10:00:04)。
Received: Header #1 (最顶部 - 最后一跳)
Received: by 2002:a05:620a:1111:b0:44a:1234:5678 with SMTP id a1csp1234567abc;
        Mon, 27 Oct 2025 10:00:05 -0700 (PDT)
- 分析: 这是邮件被投递到 Bob 收件箱的最后一步。
by 2002:a05:...: 另一台谷歌内部服务器(一个 IPv6 地址)处理了该邮件。Mon, 27 Oct 2025 10:00:05 -0700 (PDT): 邮件在 10:00:05 被最终处理。- 在这之后,邮件被写入
Delivered-To: bob@gmail.com所指定的邮箱文件中,Bob 就可以看到这封新邮件了。
1.2 P7 计算查询时间
假设您在 Web 浏览器中点击一个链接来获取一个网页。该 URL 对应的 IP 地址没有在您的本地主机中缓存,因此需要进行 DNS 查询来获取 IP 地址。假设在您的主机从 DNS 收到 IP 地址之前,总共访问了 个 DNS 服务器;连续访问这些服务器产生的 RTT (往返时间) 分别为 。
此外,假设与该链接关联的网页只包含一个对象,即大量的 HTML 文本。设 为本地主机与包含该对象的服务器之间的 RTT。假设该对象的传输持续时间为 ,那么从客户端点击链接到客户端接收到该对象总共需要多少时间?
总时间是从点击链接开始,到接收完整个对象为止所经过的所有步骤的总和。
-
DNS 查询时间:
- 客户端需要依次访问 个 DNS 服务器。
- 总 DNS 时间 = 。
-
TCP 连接建立时间:
- 获取 IP 地址后,客户端需要与 Web 服务器建立 TCP 连接(三次握手)。
- 这需要 1 个 。
-
HTTP 请求和对象传输时间:
- 建立连接后,客户端发送 HTTP 请求。服务器收到请求后发回对象。
- 请求和接收到对象的第一个字节需要 1 个 。
- 问题中提到,该对象是“大量的 HTML 文本”,其传输持续时间为 。这部分时间是在收到第一个字节后,接收剩余全部内容所需的时间。
- 因此,此步骤总时间为 。
总时间: 将所有步骤的时间相加:
1.3 P8
再次考虑问题 P7,并假设 。此外,假设有一个新的 HTML 文件,该文件小到传输时间可以忽略不计,它引用了同一服务器上的九个同样很小的对象(传输时间也忽略不计)。
在以下情况下,总共需要多少时间?
a) 非持久性 HTTP,没有并行的 TCP 连接? b) 非持久性 HTTP,浏览器配置了 6 个并行连接? c) 持久性 HTTP?
首先,我们根据 P8 的假设简化 RTT:
所有情况的共同步骤:
在浏览器获取任何对象之前,必须先完成两件事:
- DNS 查询:
- 时间 = 。
- 获取基础 HTML 文件:
- 这个 HTML 文件本身也是一个对象(尽管很小)。
- 建立 TCP 连接: 。
- 请求和接收 HTML 文件: 。
- 获取 HTML 时间 = 。
“启动”总时间(获取 HTML 文件)= 。
在 时间后,浏览器解析了 HTML,发现还需要下载 9 个 嵌入的对象。接下来的时间取决于 HTTP 的模式:
a) 非持久性 HTTP,无并行
- 非持久性: 每个对象都需要一个全新的 TCP 连接。
- 无并行: 必须一个接一个地串行下载。
- 下载 1 个小对象的时间 = (建立 TCP) + (请求/接收) = 。
- 下载 9 个对象的时间 = 。
总时间 (a) = 启动时间 + 9 个对象的时间
b) 非持久性 HTTP,6 个并行连接
- 非持久性: 每个对象都需要一个新 TCP 连接。
- 6 个并行: 浏览器可以同时打开 6 个连接。
- 启动时间仍然是 。
- 下载 9 个对象:
- 第 1 轮: 并行下载对象 1-6。这 6 个下载同时开始,每个都需要 。此轮耗时 。
- 第 2 轮: 下载剩余的 3 个对象 (对象 7-9)。此轮耗时 。
- 下载 9 个对象的总时间 = (第一轮) + (第二轮) = 。
总时间 (b) = 启动时间 + 9 个对象的时间
c) 持久性 HTTP
- 持久性: 浏览器重用为获取基础 HTML 而建立的 TCP 连接。
- 启动时间仍然是 。此时,TCP 连接仍然打开。
- 我们分两种标准情况讨论(这也对应您图片中的
c)部分):
c.1) 持久性,无流水线 (Pipelining)
- 浏览器在开放的连接上发送 1 个请求,等待响应完成后,再发送下 1 个请求。
- 下载 1 个小对象的时间 = (请求/接收)。(不再需要 TCP 建立时间)
- 下载 9 个对象的时间 = 。
总时间 (c.1) = 启动时间 + 9 个对象的时间
c.2) 持久性,有流水线 (Pipelining)
- 浏览器在开放的连接上,连续发送所有 9 个请求,而无需等待响应。
- 服务器也连续发回 9 个响应。
- 下载 9 个对象的时间:
- 客户端发送完所有请求(时间忽略不计)。
- 第一个请求的响应在 后到达。
- 由于所有对象都很小(传输时间忽略不计),所有 9 个响应会紧随其后相继到达。
- 接收完所有 9 个对象总共只需要 。
总时间 (c.2) = 启动时间 + 9 个对象的时间
1.3.1 总结
- P7 答案:
- P8 (a) 答案:
- P8 (b) 答案:
- P8 (c) 答案:
- 无流水线:
- 有流水线:
希望这个详细的解答对您有帮助!您是否需要我为您解释 HTTP/2 中多路复用 (Multiplexing) 会如何进一步优化 P8 (c) 的情况?
1.4 P9: Web 缓存性能分析
1.4.1 问题描述
考虑一个场景:机构网络通过一个路由器连接到互联网,接入链路带宽为 。假设机构内部用户平均每秒请求 个对象,每个对象平均大小为 。从机构路由器到源服务器的平均往返时间 (RTT) 为 3 秒(这包括了传输和处理延迟)。
a. 计算总的平均响应时间(从请求发出到对象接收完毕)。需要计算流量强度 和接入链路上的平均排队和传输延迟 。
b. 现在机构安装了一个 Web 缓存,假设命中率 。计算总的平均响应时间。假设访问缓存的延迟(查找时间等)为 。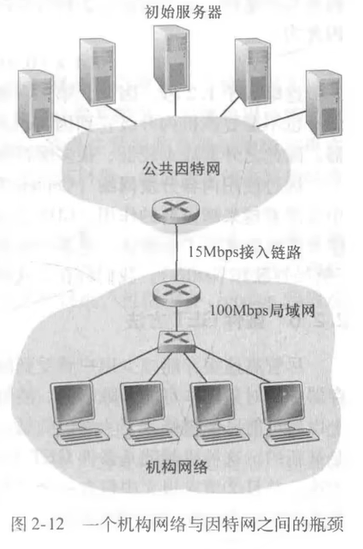
1.4.2 a. 无缓存情况
计算:
- 传输时间 (): (教师计算为 0.05675 s)
- 流量强度 (I):
- 接入延迟 (): (包括排队延迟和传输延迟) (教师计算为 0.575 s)【这是前面推过的公式】
- 总平均响应时间 (t): 假设局域网内部延迟 (教师似乎使用了这个值)。 互联网及服务器延迟 。 (教师计算为 3.575 s)
结果: 无缓存时,平均响应时间约为 3.575 秒。
1.4.3 b. 有缓存情况 (命中率 0.4)
计算:
- 未命中率 (Miss Rate):
- 接入链路上的新流量强度 (): 只有未命中的请求会通过接入链路。
- 接入延迟 (): (只针对未命中的请求)
- 命中时的响应时间 (): (假设教师的 是缓存查找时间) 教师在计算中似乎只用了 10ms,可能代表从局域网用户到缓存的总时间
- 未命中时的响应时间 (): 如果按教师计算方法只计一次 10ms:
- 总平均响应时间 (t): 使用教师的方法: (教师计算结果为 1.874 s)
结果: 加入缓存后,平均响应时间显著降低到约 1.88 秒。
原因:
- 40% 的请求在本地缓存快速响应,避免了通过慢速接入链路和互联网。
- 由于 40% 的流量被缓存拦截,接入链路的流量强度从 0.907 下降到 0.544,大大减少了排队延迟 ( 从 0.575s 降到 0.124s)。
1.5 P10: HTTP 传输时间计算
1.5.1 问题描述
考虑一条带宽 的链路,远端服务器通过该链路发送数据。分组(包括数据分组和控制分组如握手、请求)的双向往返时间(RTT)假定为固定值(虽然题目未给出具体值,但在计算中会考虑)。
假设每个 HTTP GET 请求都获得一个 HTML 文件(基础对象),大小为 。该基础对象包含 10 个指向其他对象的引用(例如图片),每个被引用的对象大小也是 。
控制分组(如 TCP 连接建立、HTTP 请求)的大小为 。
假设有 N 个并行连接时,每个连接获得 的链路带宽。
问题:
a. 使用非持续 HTTP 和 10 个并行 TCP 连接下载所有对象(基础对象 + 10 个引用对象)需要多长时间? b. 使用持续 HTTP(无流水线)下载所有对象需要多长时间? c. 比较这两种情况下的并行 HTTP 的并发开销是否有意义?现在考虑持续 HTTP,你认为它的性能有很大增益吗?评价并解释你的答案。
1.5.2 a. 非持续 HTTP,10 个并行连接
分析:
-
下载基础对象:
- 需要建立一个 TCP 连接(1 RTT,传输 SYN (L’),SYN-ACK (L’),ACK (L’))。
- 发送 HTTP 请求(1 RTT,传输 GET (L’))。
- 服务器传输 HTML 文件(传输 L)。
- 如果忽略 RTT 中的传输时间,每次对象获取需要 2 RTT 的往返延迟,加上控制分组和数据分组的传输时间。
- 教师简化计算(似乎侧重传输时间或使用了特定模型):认为获取一个对象需要 3 次控制分组传输 () 和 1 次数据分组传输 ()。总时间 。此外还需加上往返传播延迟。
- 初始基础对象下载时间 秒。(注意:这里 k=1000)
- 秒。
-
下载 10 个引用对象 (并行):
- 基础对象下载完成后,浏览器同时发起 10 个 TCP 连接请求。
- 每个连接过程与下载基础对象类似,但带宽被 10 个连接共享 ()。
- 获取一个引用对象的时间(并行时单个连接花费的时间) 。
- 秒。
- 秒。
- 由于 10 个连接并行进行,这部分的总时间取决于最慢的那个连接完成的时间,即 。
-
总时间:
- 秒。
- 教师计算结果为 7377 秒。
- 如果考虑传播延迟 (RTT),每次对象获取(建连+请求)需要 2 RTT。总共需要 1 次初始对象获取 + 1 次并行对象获取(10个对象同时进行)。总 RTT 延迟 = 2 RTT (initial) + 2 RTT (parallel) = 4 RTT。
- 教师板书最后加入了 ( 代表单向传播延迟,所以 RTT = ?还是 代表 RTT?通常 指传播延迟,RTT = 。按 2 RTT/对象,总共 4 RTT = 。但教师写 ,可能他将 定义为 RTT)。假设 代表 RTT,则总时间 秒。
计算:
1.5.3 b. 持续 HTTP (无流水线)
分析:
- 建立 TCP 连接: 1 RTT (传输 SYN, SYN-ACK, ACK)。教师简化为 的传输时间。
- 下载基础对象: 发送请求 (1 RTT, 传输 GET L’),接收对象 (传输 L)。教师简化为 的传输时间。
- 下载 10 个引用对象 (顺序): 对于每个对象:发送请求 (1 RTT, 传输 GET L’),接收对象 (传输 L)。教师简化为每次 的传输时间。总共 10 次。
- 总时间:
- 使用教师的简化模型:
- 秒。【这里别忘了就是我请求那10个对象还有一个请求的RTT】
- 秒。
- 教师计算结果为 7351 秒。
- 如果考虑 RTT: 1 RTT (setup) + 1 RTT (req 1) + … + 1 RTT (req 11)。总共 1 + 11 = 12 RTT。
- 教师板书最后加入了 (假设 是 RTT,1 个用于建连,1 个用于第一个请求)。则 秒。
计算:
1.5.4 c. 比较与评价
- 计算结果比较: 在这个特定的低带宽场景下,持续 HTTP (7351s) 略快于非持续并行 HTTP (7377s)。
- 并发开销: 非持续并行 HTTP 需要建立 11 个 TCP 连接,而持续 HTTP 只需要建立 1 个。在高延迟网络中,建立连接的开销 (RTT 延迟) 会很显著。虽然这里计算上差别不大(7377 vs 7351),主要是因为极低的带宽使得传输时间占主导地位。
- 持续 HTTP 增益: 持续 HTTP 避免了多次 TCP 连接建立和慢启动的过程,在高延迟或普通带宽下通常性能增益明显。在这个极端低带宽例子中,传输时间远大于 RTT 开销,所以节省的连接建立时间带来的增益相对不显著。
- 结论: 在这个低带宽场景下,持续 HTTP 性能略好。并行非持续的并发开销(主要是连接建立)相对于巨大的传输时间来说不明显。但在带宽更高、RTT 影响更大的实际网络中,持续 HTTP (尤其是带流水线的) 通常比非持续并行有显著优势。
1.6 P13和P14 HTTP2优先传输的问题
1.6.1 题目翻译
问题 13 (P13)
考虑通过 HTTP/2 发送一个网页,该网页包含一个视频文件和三个图像。假设该视频剪辑被传输时分为 5000 个帧 (frame),每个图像被捕获为 4 个帧。
a. 如果所有的视频帧都首先被发送(没有交错),那么需要多少“帧时间”才能将所有图像发送完毕?
b. 如果帧是交错 (interleaved) 发送的,那么需要多少“帧时间”才能将所有三个图像发送完毕?
问题 14 (P14)
考虑问题 13 中的网页。现在采用了 HTTP/2 优先级 (prioritization) 策略。假设所有图像的优先级都高于视频剪辑,并且第一个图像的优先级高于第二个图像,第二个图像的优先级高于第三个图像,依此类推。
那么需要多少“帧时间”才能将第二个图像发送完毕?
1.6.2 问题解答
1.6.2.1 🎓 问题 13 (P13) 解答
首先,我们明确对象和它们的大小:
- 1 个视频:5000 帧
- 3 个图像:每个 4 帧
- 总图像帧数: 帧
- 总帧数: 帧
- “帧时间” (frame time) 是发送一个帧所需的时间单位。
a) 无交错(串行发送)
- 发送视频: 题目要求首先发送所有视频帧。
- 发送 5000 个视频帧需要 5000 帧时间。
- 发送图像: 视频发送完毕后,开始发送 3 个图像的所有帧。
- 总共有 12 个图像帧。
- 这些帧将在 到 的时间内发送。
- 完成时间: 问题问的是“直到所有图像发送完毕”。最后一个图像帧在第 5012 帧时间被发送。
答案 (a): 需要 5012 帧时间。
b) 有交错(并行 multiplexing)
- 理解交错: HTTP/2 可以在一个 TCP 连接上交错发送来自不同流 (stream) 的帧。我们这里有 4 个流:1 个视频流和 3 个图像流。
- 公平交错: 在没有优先级(P14 的情况)时,最公平的交错方式是“轮询”(round-robin)。发送端会依次从每个流中取一个帧来发送。
- 发送顺序: 4 个流的发送顺序会是:
- : 视频 (第 1 帧)
- : 图像 1 (第 1 帧)
- : 图像 2 (第 1 帧)
- : 图像 3 (第 1 帧)
- : 视频 (第 2 帧)
- : 图像 1 (第 2 帧)
- … 以此类推
- 计算图像完成时间: 每个图像都需要 4 帧。
- 图像 1 的帧将在 被发送。 (在 完成)
- 图像 2 的帧将在 被发送。 (在 完成)
- 图像 3 的帧将在 被发送。 (在 完成)
- 完成时间: 问题问的是“直到所有三个图像发送完毕”。这取决于最晚完成的那个图像(图像 3)。
答案 (b): 需要 16 帧时间。
1.6.2.2 🎓 问题 14 (P14) 解答
- 理解优先级: HTTP/2 允许设置优先级。根据题目,优先级顺序为:
- 图像 1 (最高)
- 图像 2
- 图像 3
- 视频 (最低)
- 发送顺序: 发送端会严格按照优先级顺序发送。它会先发送完图像 1 的所有 4 帧,然后再发送图像 2 的所有 4 帧,依此类推。
- 计算过程:
- 到 : 发送图像 1(最高优先级)。图像 1 有 4 帧。在 时,图像 1 发送完毕。
- 到 : 发送图像 2(第二优先级)。图像 2 有 4 帧。在 时,图像 2 发送完毕。
- (此后, 到 会发送图像 3, 之后才开始发送视频)。
- 完成时间: 问题问的是“直到第二个图像发送完毕”。
答案: 需要 8 帧时间。
您是否需要我解释一下 HTTP/2 的“流”(Stream) 和“帧”(Frame) 是什么关系?
1.7 P22: C/S 与 P2P 文件分发时间
1.7.1 问题描述
考虑向 N 个对等方分发一个大小为 F = 15 Gbits 的文件。服务器具有上传速率 。每个对等方(客户端)具有下载速率 和上传速率 。考虑三种情况的 : 300 kbps, 700 kbps, 2 Mbps。
计算 N = 10, 100, 1000 时,对于每种 组合,客户端-服务器 (C/S) 模式和对等网络 (P2P) 模式下的最小分发时间。用表格形式给出结果。
(假设 )
1.7.2 客户端-服务器 (C/S) 模式
分析: 在 C/S 模式下,文件分发时间由两个因素决定:
- 服务器将 N 份文件副本全部上传完毕所需的时间。
- 下载速度最慢的客户端下载完一份文件副本所需的时间。 最小分发时间是这两者中的较大值。客户端的上传速率 在此模式下不起作用。
公式:
计算: 使用 (或近似计算,教师使用了 1024 进位制)
- N = 10:
- N = 100:
- N = 1000:
表格 (C/S):
| N | (s) | (s) | (s) | |
|---|---|---|---|---|
| 10 | (任意) | 5120 | 7680 | 7680 |
| 100 | (任意) | 51200 | 7680 | 51200 |
| 1000 | (任意) | 512000 | 7680 | 512000 |
(教师板书的值与此计算一致)
1.7.3 对等网络 (P2P) 模式
分析: 在 P2P 模式下,文件分发时间由三个因素决定:
- 服务器至少要上传一份完整的文件副本所需的时间。
- 下载速度最慢的客户端下载完一份文件副本所需的时间。
- 所有 N 份文件副本的总比特量需要被整个网络的总上传能力(服务器上传 + 所有对等方上传)所支持,由此决定的时间。 最小分发时间是这三者中的最大值。
公式:
计算: 需要计算 (假设所有 相同)。注意单位转换: 需要转换为 Mbps。
- N = 10:
- : . . . .
- : . . . .
- : . . . .
- N = 100:
- : . . . (教师板书 25600).
- : . . . (教师板书 15300).
- : . . . .
- N = 1000:
- : . . . (教师板书 46454).
- : . . . (教师板书 21041.4).
- : . . . .
(教师板书中的数值略有差异,可能是由于使用 1000 进位或 1024 进位以及取整方式不同导致,但趋势和数量级一致)
表格 (P2P):
| N | (Mbps approx) | (s) | (s) | (s approx) | (s approx) |
|---|---|---|---|---|---|
| 10 | 0.293 | 5120 | 7680 | 4664 | 7680 |
| 10 | 0.684 | 5120 | 7680 | 4170 | 7680 |
| 10 | 2 | 5120 | 7680 | 3072 | 7680 |
| 100 | 0.293 | 5120 | 7680 | 25902 | 25902 |
| 100 | 0.684 | 5120 | 7680 | 15610 | 15610 |
| 100 | 2 | 5120 | 7680 | 6678 | 7680 |
| 1000 | 0.293 | 5120 | 7680 | 47554 | 47554 |
| 1000 | 0.684 | 5120 | 7680 | 21513 | 21513 |
| 1000 | 2 | 5120 | 7680 | 7567 | 7680 |
1.7.4 结论比较
- 可伸缩性 (Scalability): P2P 模式比 C/S 模式具有更好的可伸缩性。当 N 增大时,C/S 模式下的分发时间(当 成为瓶颈时)与 N 成正比增长。而在 P2P 模式下,由于所有对等方都贡献上传带宽,总上传能力 () 随 N 增长,使得 这一项的增长远慢于线性增长(甚至可能趋于平稳或缓慢增长,取决于 的大小)。
- 瓶颈: 在 C/S 模式下,当 N 较大时,服务器上传带宽 成为瓶颈。在 P2P 模式下,瓶颈可能是服务器上传第一个副本 (),最慢客户端下载 (),或者是总上传能力 ()。当 N 很大且客户端上传能力 较高时,瓶颈往往是最慢客户端的下载速度 。
- 效果: P2P 利用了对等方的上传能力,大大减轻了服务器的负担,尤其在分发大文件给大量用户时,效率远高于 C/S 模式。
1.8 P23: C/S 文件分发方案设计
1.8.1 问题描述
考虑使用客户端-服务器(C/S)体系结构向 N 个用户分发 F 比特的文件。假定服务器上传速率为 ,每个用户的下载速率为 , 是所有用户中的最小下载速率。服务器不能同时向多个用户流式传输,组合速率不能超过 。
a. 假设 。定义一个分发方案。 b. 假设 。定义一个分发方案。 c. 得出最小分发时间通常是 所决定的结论。
1.8.2 分析与方案
基本模型:
- 服务器 S,上传速率 。
- N 个客户端 。
- 客户端 的下载速率为 。
- 。
- 文件大小 F。
- 目标:将文件 F 分发给所有 N 个客户端。
- 最小分发时间 (这是已知的 C/S 模式下的理论最小时间)。
a. (服务器相对较慢或客户端很多)
- 条件解读: 这个条件意味着,如果服务器平均地将它的上传带宽分配给所有 N 个客户端,那么每个客户端得到的带宽 不超过(小于等于)最慢客户端的下载能力 。换句话说,。服务器的总上传能力不足以同时满足所有客户端以 的速度下载。服务器的上传是瓶颈。
- 分发方案: 服务器以其最大能力 进行上传。它可以将这 的带宽同时分配给 N 个客户端,每个客户端获得 的速率。由于 (对所有 i),每个客户端的下载速率被服务器的分配所限制,实际下载速率为 。
- 时间分析:
- 服务器需要上传的总数据量是 。它以 的总速率上传,所需时间为 。
- 每个客户端需要下载 F 比特的数据。它以 的速率下载,所需时间为 。
- 由于 , 。因此 。
- 此方案下,所有客户端同时开始下载,并同时在 时间后完成。这符合最小分发时间 。
- 方案总结: 服务器同时向所有 N 个客户端传输文件,每个连接分配 的带宽。
b. (服务器相对较快或客户端较少)
- 条件解读: 这个条件意味着,如果服务器平均分配带宽,每个客户端得到的 将超过最慢客户端的下载能力 。换句话说,。服务器有足够的能力同时以 的速度服务所有客户端,甚至可能更快。此时,最慢客户端的下载能力 可能是瓶颈。
- 分发方案: 服务器仍然可以尝试同时服务所有 N 个客户端。对于客户端 ,服务器可以提供的最大速率是 (如果平均分配),但客户端 只能以 的速率接收。因此,客户端 的实际下载速率是 。
- 由于 ,对于最慢的客户端,其实际下载速率是 。
- 对于其他客户端 ,其实际下载速率是 ,这个值 。
- 时间分析:
- 服务器需要上传的总数据量为 。它实际使用的总上传带宽是多少?是 。这个值 。服务器上传完所有数据所需的时间是 。
- 最慢的客户端下载需要的时间是 。
- 其他客户端下载需要的时间是 。
- 因此,整个分发完成的时间取决于最慢的客户端完成下载,或者服务器完成所有上传。
- 由于 , 。因此 。
- 在此方案下,最慢的客户端在 时刻完成。服务器是否在此之前完成了所有上传?服务器需要的总时间 。因为 ,所以 。因此 。所以服务器总能在最慢客户端完成之前或同时完成上传。
- 此方案下,总时间由最慢客户端决定,为 。这符合最小分发时间 。
- 方案总结: 服务器同时向所有 N 个客户端传输文件。每个客户端 以 的速率下载。
c. 结论
无论在哪种情况下 ( 或 ),通过上述的分发方案,达到的分发时间分别是 和 。
结合两种情况:
- 当 时, ,此时最小时间为 。
- 当 时, ,此时最小时间为 。
因此,在客户端-服务器模式下,无论服务器和客户端的具体速率关系如何,能够达到的最小分发时间总是由服务器总上传瓶颈 () 和最慢客户端下载瓶颈 () 中的较大者决定,即:
1.9 P2P 文件分发系统时间分析 (P24)
本节课主要分析 P24 题目,探讨 P2P (Peer-to-Peer) 文件分发系统所需的最短时间,并与 P23 的 C/S (Client-Server) 模型进行对比。
1.9.1 P2P 分发时间下限公式
在 P2P 文件分发系统中,假设有一个服务器和 N 个客户端(Peer),需要将一个大小为 F 的文件分发给所有 N 个客户端。
最小分发时间 满足以下不等式:
首先,老师在 01:03 处回顾了 P2P 分发时间的三个下限(瓶颈):
- 服务器上传瓶颈: (服务器至少要传出一个完整文件)
- 最慢下载瓶颈: (下载最慢的客户端也需要下载完)
- 系统总上传瓶颈: (N个客户端总共需要 的数据量,系统总上传能力为 )
本题P24假设 非常大,所以我们忽略第2个瓶颈。因此,最小分发时间 。
📚 a 问的策略
这种情况可以等价地写为 ,即 或 。这意味着服务器的上载带宽 相对于平均每个客户端能提供的上载带宽 来说较小。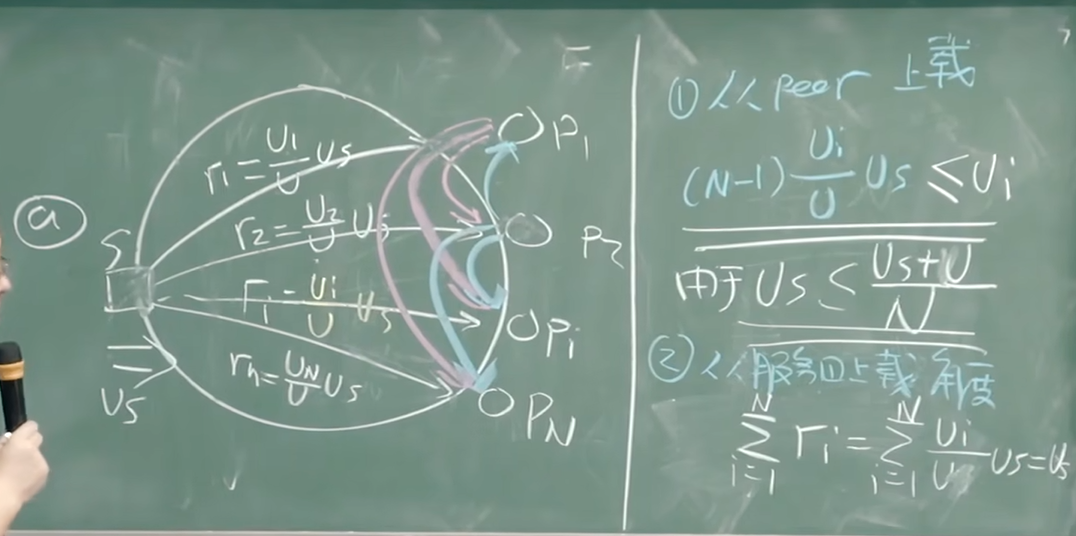
条件:
- 这个条件可以转换为 ,即 。
- 老师在 18:40 左右的讲解中指出,这个条件意味着 。
- 结论: 在此条件下,服务器的上传速率 是系统的瓶颈。
目标: 设计一个分发方案,使其时间恰好为 。
策略(基于老师 06:50 - 13:20 的讲解): 该策略的核心是让服务器始终保持 的满速率上传,并且利用对等方(Peers)的高上传能力(由 保证)来相互分发。
- 服务器(S):在 的全部时间内,以 的速率持续上传文件内容。服务器将其带宽 分配给 个对等方,例如按比例 分配给 ,使得 。
- 对等方(Peers):
- 每个对等方 一旦从服务器或其他对等方收到了文件的任何部分,就立即以其最大上传速率 将这些部分上传给其他 个对等方。
- 由于 远大于 和 ,对等方的下载带宽不是瓶颈。
- 结果: 由于对等方的总上传能力 足够大( ),它们有能力在 时间内,将从服务器收到的数据(总共 )以及它们彼此之间的数据(总共 )进行充分交换,确保所有 个节点都能下载完 。系统的瓶颈在于服务器将第一份完整文件 注入系统的速度。
简而言之: 服务器以 全速上传,所有对等方以 全速“接力”上传。因为对等方“接力”的能力足够强(满足条件a),所以总时间取决于服务器这个“源头”的速度。
📚 b 问的策略
条件:
- 这个条件可以转换为 。
- 老师在 21:20 左右的讲解中指出,这个条件意味着 。
- 结论: 在此条件下,服务器相对“快”,而系统的总上传能力 是瓶颈。
目标: 设计一个分发方案,使其时间恰好为 。
策略(基于老师 21:20 - 27:50 的精巧设计): 该策略的核心是让服务器和所有 个对等方在整个分发期间 内,同时以各自的最大上传速率( 和 )满负荷工作。
- 文件划分(流体模型): 老师在 21:30 处将文件 划分为 个逻辑流(streams)。
- 服务器(S)的上传策略(总速率 ):
- 对于 ,服务器以 的速率向对等方 发送“流 ”。
- 服务器使用其剩余的带宽 ,向所有 个对等方广播“流 ”(即每个对等方收到 的速率)。
- (检查: ,这个条件在b中成立,所以 )。
- 对等方(Peers)的上传策略:
- 每个对等方 在收到服务器发来的“流 ”后,立即以其最大速率 将“流 ”转发给所有其他 个对等方(即向每个其他对等方以 的速率发送)。
- 结果(验证):
- 服务器满载: 总上传速率为 。
- 对等方 满载: 总上传速率为 。
- 对等方 的总下载速率 :
- 来自服务器的“流 ”:
- 来自服务器的“流 ”:
- 来自其他 个对等方的“流 ” ():
- 将三者相加(如老师在 27:10 处的推导),。
- 由于每个对等方都以这个速率接收,下载完 的时间 。该策略恰好达到了瓶颈时间。
📚 c 问的策略
这是一个结论性问题,策略是基于a和b的分析进行总结。
- P2P分发的最小时间 必须大于等于所有瓶颈中的最大值。在忽略 的情况下,。
- 在情况a中( 是瓶颈),我们找到了一个策略,使得 。
- 在情况b中( 是瓶颈),我们也找到了一个策略,使得 。
- 结论: 由于在任一情况下( 是瓶颈或 是瓶颈),我们都能设计出一个方案来达到该瓶颈对应的下限时间。因此,在一般情况下,最小分发时间就是这两个瓶颈中的较大值。
- 所以, 。
希望这个总结对你有帮助!你是否想了解一下如果 不是无限大时,这个策略会如何变化?
1.10 P25 Overly Network的相关问题
考虑一个覆盖网络 (overlay network),该网络有 个活动的对等方 (peer),每对对等方之间都有一个活动的 TCP 连接。此外,假设这些 TCP 连接总共通过了 个路由器。
在相应的覆盖网络中,有多少个节点 (node) 和边 (edge)?
这道题的关键在于理解“覆盖网络”(Overlay Network) 的定义。
- 覆盖网络是一个构建在另一个网络(称为底层网络,underlay network)之上的逻辑网络。
- 在覆盖网络中,节点 (Nodes) 是指网络中的端系统或对等方 (peers)。
- 在覆盖网络中,边 (Edges) 是指节点之间建立的逻辑连接(例如 TCP 连接),无论它们在底层物理网络中走了多远或经过了多少路由器。
1.10.1 1. 节点 (Nodes) 的数量
- 根据定义,覆盖网络的节点就是它的 个活动的对等方 (peers)。
- 因此,节点的数量 = 。
- 题目中提到的 个路由器是底层物理网络的组件,不是覆盖网络的节点。
1.10.2 2. 边 (Edges) 的数量
- 题目说明“每对对等方之间都有一个活动的 TCP 连接”。
- 这描述了一个全连接(fully connected)的图,其中 个节点中的每一个都与其他所有节点相连。
- 我们可以使用组合数学来计算:从 个节点中任意选取 2 个节点组成一条边,总共有多少种组合?
- 边的数量 =
举例验证:
- 如果 (节点 A, B, C),边有 3 条 (A-B, A-C, B-C)。公式: 。
- 如果 (节点 A, B, C, D),边有 6 条 (A-B, A-C, A-D, B-C, B-D, C-D)。公式: 。
1.10.3 答案
- 节点数量:
- 边的数量:
(注: 个路由器的信息是用来迷惑的,它们属于底层网络,与覆盖网络的拓扑结构无关。)