1 第2章:应用层(概览)
1.1 本章学习内容概述
我们结束了对网络概述的学习,现在开始采用一种“自顶向下”(top down)的方式,从最高层——应用层——开始深入学习。
这一章的内容可以分为三个主要部分:原理、实例和编程。这与其它章节有所不同,因为我们特别加入了编程的部分。
首先,我们会介绍应用层的基本原理。然后,我们会探讨互联网上非常流行的各种应用及其背后的支持协议。这包括:
- Web 应用及其 HTTP 协议
- FTP 应用(文件传输应用本身及其同名的FTP协议)
- 电子邮件 (Email)
- 域名解析 (DNS)
- P2P 应用
- 内容分发网络 (CDN)
最后,我们会学习如何进行 TCP Socket 编程和 UDP Socket 编程。通过分析互联网中主流的协议实例,我们可以更好地理解和呼应本章讲述的原理。 好的,这是根据您第二次提供的课堂录音文字稿整理的课堂笔记。
2 应用层协议原理
2.1 互联网架构与创新
在开始学习具体原理之前,老师首先提出了一个问题:在互联网的各个层次中,哪个层次的协议最多?答案是应用层。
这是因为互联网的架构本身就支持和鼓励创新。你只要有创造力和想法,就可以自己编写程序,定义新的应用层协议,并快速部署各种网络应用。这使得互联网应用的部署门槛非常低。
正是这种开放的架构,催生了从早期的 Email、FTP、Web 应用,到后来的 P2P 文件分享、多媒体、电子支付和网络游戏等无数创新。一个新应用只要能吸引足够的用户,并建立起可持续的生态,就能迅速发展。这也是互联网发展至今,拥有如此庞大用户和设备规模的关键原因。
2.2 如何部署一个网络应用
部署一个新的网络应用流程非常直接:编写程序,然后购买或租用一台主机(服务器)并让程序运行起来。如果应用需要客户端软件,可以将其发布在分享平台上供用户下载。
以 Web 应用为例,只需租用一台服务器,配置好环境,然后启动 Web 服务器软件,用户就可以通过浏览器访问了。
write programs that:
- run on (different) end systems
- communicate over network
- e.g., web server software communicates with browser software
no need to write software for network-core devices
- network-core devices do not run user applications
- “applications on end systems” allows for rapid app development, propagation
2.2.1 部署速度快的原因
网络应用的部署之所以如此迅速,关键在于它完全发生在端系统(End System)上,而无需改动网络核心(Network Core)。网络核心的最高层次是网络层,它不参与任何应用层的具体事务。因此,应用的开发和部署都可以在用户侧和服务器侧独立、快速地完成。
2.3 网络应用的体系结构
根据应用进程之间沟通方式的不同,我们可以将网络应用的体系结构分为三种主要类型:
- 客户-服务器模式 (C/S: Client/Server)
- 对等模式 (P2P: Peer-to-Peer)
- 混合体 (Hybrid)
2.3.1 客户-服务器 (C/S) 模式
在这种模式下,有一个始终运行的服务器。它会“守候”在一个约定好的、众所周知的端口上(如Web服务的80端口),等待客户端的请求。服务器必须拥有一个固定的IP地址,这样客户端才能准确地找到它。
客户端则根据需要启动,并主动向服务器发起通信请求。客户端的IP地址通常是动态的(例如,通过Wi-Fi连接时由DHCP协议分配),并且客户端之间不直接通信。
server:
- always-on host
- permanent IP address
- often in data centers, for scaling
clients:
- contact, communicate with server
- may be intermittently connected
- may have dynamic IP addresses
- do not communicate directly with each other
examples: HTTP, IMAP, FTP。
HTTP(Hypertext Transfer Protocol)IMAP(Internet Message Access Protocol)FTP(File Transfer Protocol) intermittent: 断断续续的
2.3.1.1 C/S 模式的缺点
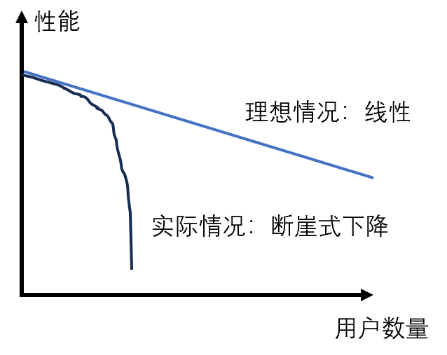
- 可扩展性差:当用户数量激增时,所有请求都涌向唯一的服务器。尽管可以升级服务器硬件,但最终会遇到网络或处理能力的瓶颈。性能一旦达到某个阈值,就会出现“断崖式”的急剧下降,而不是平滑下降。
- 可靠性差:整个服务都依赖于这台服务器。一旦服务器宕机,所有客户端都将无法使用该服务。
2.3.2 对等体 (P2P) 模式
P2P 架构的出现就是为了解决 C/S 模式的诸多问题。
在 P2P 网络中,每个节点(Peer)的地位都是平等的。它既是服务的请求方(客户端),又是服务的提供方(服务器)。在一个会话中它可能是客户端,在另一个会话中它就可能是服务器。
- no always-on server
- end systems directly communicate
- peers(对等方)request service from other peers, provide service in return to other peers
- “self scalability” – new peers bring new service capacity, as well as new service demands
- peers are intermittently connected and change IP addresses
- complex management
- example: BitTorrent
2.3.2.1 P2P 模式的优缺点
-
优点:自扩展性 (Self-scalability) 随着新节点的加入,虽然网络中的服务请求增多了,但提供服务的能力也同时增强了。这使得 P2P 网络的性能不会随着用户规模的增加而急剧下降,而是能维持在一定水平,可以平滑地扩展到百万甚至千万级的用户规模。
-
缺点:难以管理 由于每个节点都是间歇性连接的(随时可能上线或下线),追踪和管理整个网络的状态变得非常复杂,远比管理少数几台中心服务器要困难得多。
2.3.3 C/S 和 P2P 的混合体
混合模式结合了 C/S 和 P2P 两者的优点,是一种非常常见的架构。
2.3.3.1 实例1:Napster 文件共享
Napster 是一个早期非常著名的MP3音乐分享系统。它就是一种典型的混合架构。
- 文件搜索(集中式,C/S):当一个用户上线时,会向一个中心服务器注册自己的IP地址和所拥有的音乐文件列表。当需要下载音乐时,用户向该中心服务器查询,服务器会告知哪个用户拥有该资源。
- 文件传输(分布式,P2P):一旦知道了资源位置,文件的下载就直接在两个用户节点之间进行,不再经过中心服务器。
Napster 因为其P2P的分享模式,用户越多,资源就越多,下载速度也越快,因此极受欢迎。但这也侵犯了唱片公司的版权,最终其中心服务器被关闭,导致整个应用被扼杀。尽管如此,它所开创的技术模式影响深远。
2.3.3.2 实例2:即时通信 (Instant Messaging)
早期的即时通信软件(如QQ、ICQ)也采用了混合架构。
- 在线状态检测(集中式,C/S):用户登录时,会向中心服务器注册自己的IP地址和在线状态。服务器维护着所有在线用户的列表,这样你才能看到哪些好友在线。
- 用户间聊天(分布式,P2P):一旦建立联系,两个用户之间的聊天消息可以直接在彼此之间传输。
虽然现在的微信和QQ等应用的后台架构要复杂得多,但其基本思想仍然可以看作是这种集中式与 P2P 方式相结合的混合体。
3 进程通信与传输层服务(为应用层协议原理的子章节)
网络应用最本质的需求,就是实现运行在不同主机上的“远程应用进程”之间的通信。只有当这些进程能够相互收发报文(Message)时,各种网络应用才能得以实现。
- 同一主机内的进程通信:如果两个进程运行在同一台计算机上,它们之间的通信不需要网络协议,可以直接利用操作系统提供的进程间通信机制,如管道、消息队列或共享缓冲区。
- 不同主机间的进程通信:当进程分布在不同主机上时,它们必须遵守相应的网络规范,借助操作系统提供的网络通信协议栈来收发报文。
3.1 Processes communicating(进程通讯)
Process: program running within a host
- within same host, two processes communicate using inter-process communication (defined by OS) Not our focus!
- processes in different hosts communicate by exchanging messages across the network.
在通信中,我们通常将进程分为两类:
-
client process: process that initiates communication
-
server process: process that waits to be contacted
-
note: applications with P2P architectures have client processes & server processes
-
客户端进程 (Client Process):主动发起通信请求的进程。
-
服务器进程 (Server Process):被动等待并响应连接请求的进程(例如Web服务器)。
特别说明: 即使在每个节点地位平等的 P2P 架构中,在某一次具体的通信会话(Session)里,也同样存在客户端和服务器之分。主动发起请求的一方就是客户端,而被动响应的一方就是服务器。
3.2 分布式通信需要解决的三大问题
为了实现远程进程间的通信,我们需要解决三个核心问题:
3.2.1 问题1:进程的标识与寻址
一个进程必须能够唯一地标识自己,这样其它进程才能找到它。老师用了一个生动的比喻:淘宝小二给你寄快递,必须知道你的姓名和唯一的地址,否则快递无法送达。
因此,这个标识必须是唯一的,并且要包含足以让别人找到你的寻址信息。
3.2.2 问题2:如何使用传输层服务
进程不能凭空(老师比喻为“用气功”)将报文发送给对方。它必须通过一个标准的接口,调用下层(传输层)提供的服务来完成。
这涉及到两个方面:
-
位置 (Location):在层间接口的哪个“点”去访问服务。在TCP/IP模型中,这个点被称为SAP(服务访问点),具体实现就是 Socket (套接字)。
-
形式 (Form):以什么样的方式去调用服务。这通过应用程序接口(API)来定义,具体就是 Socket API。
3.2.3 问题3:如何定义应用层协议
当前两个问题解决后——即进程能找到对方,并且有了通信的机制(Socket API)——我们还需要解决最后一个问题:进程之间到底“聊什么”、“怎么聊”?
这就需要定义应用层协议,来规范报文的格式、字段的含义,以及发送和响应报文的动作与时序。开发者通过编程,调用Socket API,遵循应用层协议的规定,最终实现应用的业务逻辑。
3.3 问题一详解:Addressing processes (进程定址)
-
to receive messages, process must have identifier
-
host device has unique 32/128-bit IP address(IP地址)
-
Q: does IP address of host on which process runs suffice for identifying the process?
- A: no, many processes can be running on same host
-
identifier includes both IP address and port numbers (端口号) associated with process on host.
-
example port numbers:
- HTTP server: 80
- mail server: 25
-
to send HTTP message to gaia.cs.umass.edu web server:
- IP address: 128.119.245.12
- port number: 80
-
more shortly…
在TCP/IP协议栈中,为了唯一地标识并定位一个网络应用进程,需要组合使用以下三个信息:
- 主机IP地址:首先确定进程运行在哪一台主机上。
- 传输层协议:指明该进程使用的是TCP还是UDP服务。
- 端口号 (Port Number):这是由传输层引入的一个关键机制。由于一台主机上可以同时运行多个网络应用,端口号就如同房间号,用于区分这台主机上的不同进程。
- HTTP: TCP(Web应用) 80 Mail: TCP 25 ftp: TCP 2
因此,一个网络进程的完整地址由 (IP地址 + 协议类型 + 端口号) 共同构成。本质上,任意两个进程间的通信,都是由这样两个“端节点”(Endpoint)构成的。
3.4 问题二详解:使用传输层服务与Socket
3.4.1 穿越层间接口所需的信息
当应用层进程要通过接口向传输层传递数据时,好比去快递公司寄件,至少需要提供三样东西:
- 要传输的报文 (SDU):这就是“货物”本身。
- 发送方标识:即“发件人”信息(发送方的IP + 端口号)。这很重要,因为接收方需要知道该向谁回复。
- 接收方标识:即“收件人”信息(接收方的IP + 端口号)。
3.4.2 Sockets: the interface btwn process and network
- process sends/receives messages to/from its socket(套接字)
- socket analogous to door of the application/process
- two sockets involved: one on each side
- sending process shoves message out door
- sending process relies on transport infrastructure on other side of its door to deliver message to socket at receiving process
每次发送数据时都重复提供完整的收发双方地址信息,非常繁琐且容易出错。
为了简化管理并提高效率,引入了 Socket (套接字) 的概念。
老师做了一个非常贴切的比喻:Socket就像是你在编程时,操作系统在你打开一个文件后返回的“文件句柄”(一个整数)。之后,你对这个文件的所有操作都通过这个简单的整数句柄进行,而无需再使用完整的文件路径。Socket也是一个整数,它代表了一种已经建立好的通信关系。
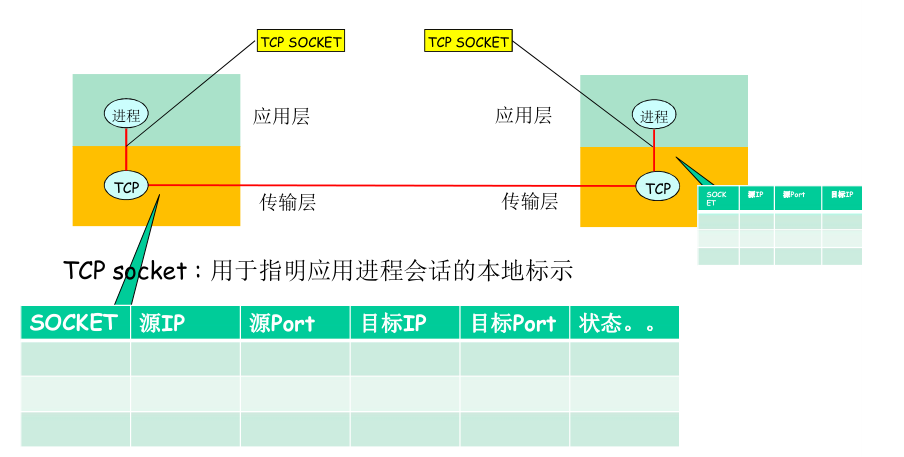
3.4.3 TCP Socket:代表一个完整的“会话”
TCP提供的是面向连接的服务,通信双方会建立一个相对稳定、持续一段时间的连接。因此,TCP Socket被设计用来代表一个完整的通信会话 (Session)。
- 定义:一个TCP Socket在物理上是一个整数,但在逻辑上,它是一个本地标识,唯一地代表了一个由“四元组”
(源IP, 源端口, 目标IP, 目标端口)定义的TCP连接。 - 工作方式:连接建立后,操作系统返回一个Socket整数。之后,应用层发送数据时只需提供这个Socket和数据本身。操作系统维护着一张映射表
(Socket值 -> 四元组),通过查表即可知道如何封装TCP报文段并发往正确的目的地。 - 本地意义:通信双方各自操作系统维护的Socket值是独立的、不同的,仅在本地有效。它本质上是应用层与本地传输层之间的一个约定。
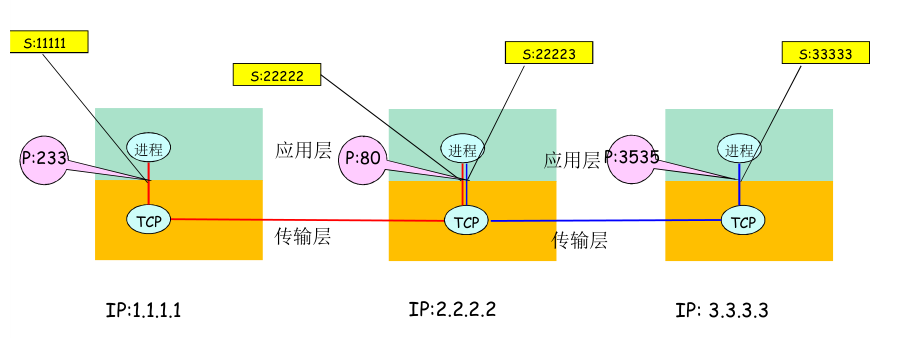
- 关键点:一个服务器进程(如Web服务器运行在80端口)可以同时与多个客户端建立连接。此时,它会拥有多个不同的Socket值,每个Socket代表一个与特定客户端的独立会話。这证明了TCP Socket代表的是会话关系,而不仅仅是一个进程。
3.4.4 UDP Socket:代表一个本地“端点”
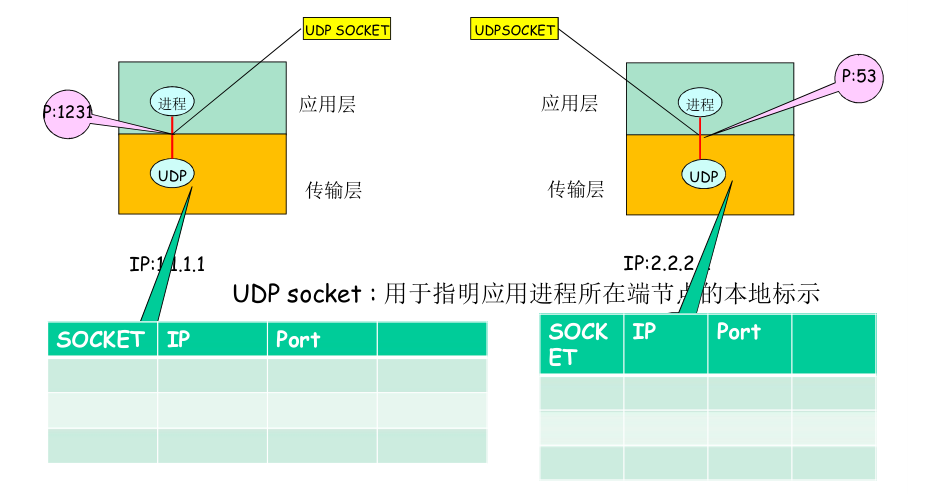
UDP是无连接的,每个数据报都是独立传输的,前后两个报文可能发往完全不同的目的地。因此,UDP Socket无法代表一个完整的会话。
-
定义:一个UDP Socket同样是一个整数,但它只代表一个本地端节点 (Endpoint)。它在逻辑上映射到一个“二元组”
(本地IP, 本地UDP端口)。 -
工作方式:由于Socket本身不包含对方的信息,因此应用层每次通过UDP Socket发送数据时,必须提供三样东西:
- 数据本身(货物)。
- UDP Socket(指明发件人)。
- 目标IP和目标端口(必须每次都明确指定收件人)。
3.4.5 总结 + 比较
套接字(Socket)
- 进程向套接字发送报文或从套接字接收报文
- 套接字←>门户
- 发送进程将报文推出门户,发送进程依赖于传输层设施在另外一侧的门将报文交付给接受进程
- 接收进程从另外一端的门户收到报文(依赖于传输层设施)
- 套接字在物理上就是一个整数
- 逻辑上表示:
- TCP socket:指定了一个会话,表示一个四元组(源IP,源port,目标IP,目标port)
- UDP socket:指定了一个应用所在的一个端节点,表示一个二元组(源IP,源port)
- 优点:
- 便于管理
- 使得穿过层间的信息量最小
到此为止,传输层如何应用socket进行传输这是传输层要做的事情
3.5 问题三详解:定义应用层协议
当进程标识和通信机制都解决后,最后一步就是定义应用层协议。
协议规定了对等的应用进程在通信时需要遵守的规则集合,具体包括:
- 报文类型:如请求报文和应答报文。
- 报文语法:报文中各个字段的结构和格式。
- 字段语义:字段中不同取值的具体含义。
- 时序规则:进程在何时、以何种顺序发送及响应报文。
需要注意的是,应用协议只是应用的一部分。一个完整的应用还包括用户界面、本地I/O操作、内部业务逻辑等与网络通信不直接相关的部分。
应用协议可分为两类:
-
公开协议 (Public Protocol):由RFC文档定义,任何人都可以遵循其规范进行开发,以实现互操作,例如HTTP、SMTP。
-
专用协议 (Proprietary Protocol):协议细节不公开,为特定公司的产品服务,例如早期的Skype。
-
Web应用:
- HTTP协议
- web客户端
- web服务器
- HTML(超文本标记语言,HTML不属于http的部分,所以上传下载文件都不需要html,HTML仅仅是如何解析html文件)
-
公开协议:
- 由RFC文档定义
- 允许互操作
- 如HTTP, SMTP
-
专用(私有)协议:
- 协议不公开
- 如:Skype(通过网络打电话)
3.6 应用对传输服务的需求
传输层提供的服务可以用以下四个维度的指标来衡量:
- 数据丢失率 (可靠性):有些应用(如文件传输、Email)完全不能容忍数据丢失,必须100%可靠。而另一些应用(如实时音视频)可以容忍一定程度的丢包。
- 延迟 (Delay):一些应用对时间非常敏感,延迟过高会严重影响体验,如网络电话、交互式游戏。老师举了航天员与地面通话时因延迟导致对话困难的例子。
- 吞吐量 (Throughput):指单位时间内有效传输的数据量。流媒体等应用需要一个最低的吞吐量保证才能正常播放。而文件传输等“弹性应用”则能充分利用所有可用带宽,快慢都能接受。
- 安全性 (Security):包括数据的机密性、完整性和端点的可认证性。
第八章会讲网络的带宽
| 应用 | 数据丢失率 | 吞吐 | 时间敏感性 |
|---|---|---|---|
| 文件传输 | 不能丢失 | 弹性 | 不 |
| 不能丢失 | 弹性 | 不 | |
| Web文档 | 不能丢失 | 弹性 | 不 |
| 实时音视频 | 容忍丢失(丢失了一块不影响整体的信息) | 音频: 5kbps-1Mbps 视频: 100kbps-5Mbps | 是,100ms |
| 存储音视频(点播) | 容忍丢失 | 同上 | 是,几秒 |
| 交互式游戏 | 容忍丢失 | 几kbps-10kpbs | 是,100ms |
| 即使讯息 | 不能丢失 | 弹性 | 是或不是 |
3.7 Internet提供的传输服务:TCP与UDP
互联网的传输层主要提供两种服务:
3.7.1 TCP 服务
- 提供:可靠传输、流量控制(防止淹没接收方)、拥塞控制(感知网络拥堵并调整速率)。
- 不提供:时间保证、最小吞- 吐量保证、安全性。
- 特点:面向连接,通信前需要“握手”。
3.7.2 UDP 服务
- 提供:不可靠的数据传输。
- 不提供:可靠性、流量控制、拥塞控制等一切附加服务。
- 特点:无连接。
3.7.3 为什么需要 UDP?
既然 UDP 看起来“一无是处”,为什么它依然是必要的?
- 区分进程:它提供了端口号,实现了 IP 协议无法做到的“进程到进程”的通信。
- 无连接延迟:适合请求-响应式的短事务应用。
- 无可靠性开销:对于实时音视频等应用,为实现可靠性而进行的重传所带来的时间代价是不可接受的。
- 无拥塞控制:允许应用按照自己设定的速率发送数据,这对于某些实时应用非常重要。
Internet应用及其应用层协议和传输协议
| 应用 | 应用层协议 | 下层的传输协议 |
|---|---|---|
| SMTP(RFC 2821) | TCP | |
| 远程终端访问 | Telnet(RFC 854) | TCP |
| Web | HTTP(RFC 2616) | TCP |
| 文件传输 | FTP(RFC 959) | TCP |
| 流媒体 | 专用协议(如RealNetworks) | TCP或UDP(大多UDP,但是有些大厂设计防火墙等问题,必须使用TCP,尽管效率低) |
| Internet电话 | 专用协议(如Net2Phone) | TCP或UDP(大多UDP) |
3.8 安全性:SSL/TLS
TCP 和 UDP 本身都不提供任何安全保障,数据(甚至密码)都是以明文传输的。
为了解决这个问题,引入了 SSL (安全套接字层),现在通常称为 TLS。
SSL 运行在 TCP 之上,可以看作是应用层的一个安全库。当一个应用(如Web浏览器)使用 SSL 时,它实际上是在和一个加密的 TCP 连接通信,我们熟知的 HTTPS 就是 HTTP over SSL。SSL 能够提供数据加密(私密性)、数据完整性和端到端的身份认证服务。
Vanilla TCP & UDP sockets:
- no encryption
- cleartext passwords sent into socket traverse Internet in cleartext (!)
Transport Layer Security (TLS)
- provides encrypted TCP connections
- data integrity
- end-point authentication
TLS implemented in application layer
- apps use TLS libraries, that use TCP in turn
- cleartext sent into “socket” traverse Internet encrypted
- more: Chapter 8
4 应用层应用及协议举例
下面介绍应用层的一些 应用 和 支持应用的协议 ,当然,应用层的协议是所有协议栈中最多的,这里只举几个典型的、基础的例子
4.1 网络应用与HTTP协议
本章内容仅仅是基础的内容,实际上Web和HTTP还有很多扩展的知识
网络是一种应用,而HTTP是支持这种应用的协议。我们将从探索网络应用的基本概念开始。
4.1.1 理解网络对象和URL
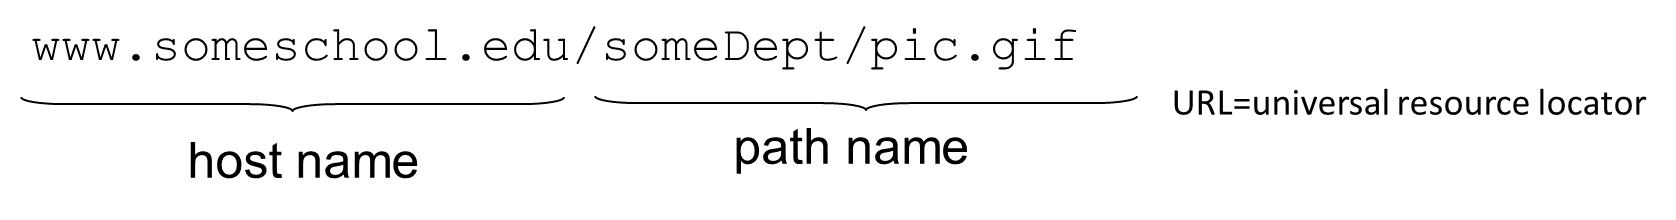
在互联网环境中,“对象”可以是很多东西。一个网页本身就是一个对象。然而,一个网页还包含对其他对象的引用,比如图片。重要的是要理解,网页本身并不包含图片,而是包含指向该图片对象的链接。
互联网上的每一个对象都可以通过URL(统一资源定位符)进行唯一标识和访问。
网页的结构围绕着一个核心的“基础HTML”文件构建。这个基础文件包含指向所有其他构成完整页面的对象(如图片、脚本等)的链接。这就形成了一个复杂的、相互关联的结构。
- A web page (网页) is a file written with the Hyper Text Markup Language (HTML, 超文本标记语言).
- A client uses the HTTP protocol to download the web pages from the web server.
- Besides texts, web page consists of objects, each of which can be stored on different Web servers
- objects can be HTML file, JPEG image, Java applet, audio file,…
- web page consists of base HTML-file which includes several referenced objects, each addressable by a URL, e.g.,
4.1.2 URL的结构
URL的格式使我们能够精确地指定如何以及在哪里找到一个对象。其一般结构如下:
protocol://user:password@hostname/path:port
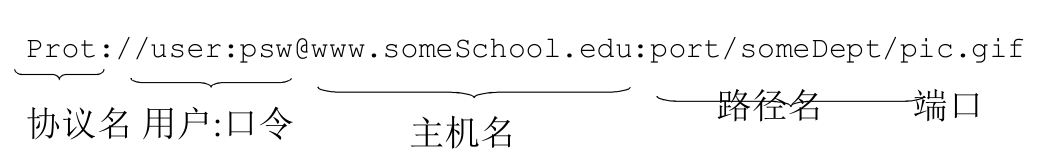
- 协议(Protocol):定义访问方式,例如HTTP、FTP等。
- 用户/密码(User/Password):这些是访问受保护资源的凭据。
- 但是,对于大多数公共网站,如大学的主页或像天猫这样的电子商务网站,你不需要输入用户名和密码。这被称为匿名访问,在这种情况下,URL的这部分会被简单地省略。
- 主机名(Hostname):是对象所在服务器的域名。
- 路径(Path):指定对象在服务器上的目录和文件名。
- 端口(Port):指示服务器上特定的通信端点。不同的协议有默认端口。
- 对于HTTP,默认端口是80;对于FTP,默认端口是21。
- 当你在输入网址时不指定端口,浏览器会自动使用该协议的默认端口。这就是为什么你访问一个网站时不需要在末尾输入“:80”的原因。
- 用户口令可以不提供,即匿名访问
- 端口不填可以是默认的:http-80,ftp-21
4.1.3 无状态协议
HTTP 协议的一个基本特性是它是无状态的。这意味着服务器不保留与客户机过去交互的任何记忆。每个请求都被视为一个完全独立的事务。服务器不知道你之前做了什么,也不知道你接下来可能会做什么。
讲师用一个比喻来描述这一点:“他就像一个没有记忆的人,所以他没有烦恼。” 服务器只是响应当前的请求,然后就把它忘了。
这种设计有一个主要优点:简单性和可扩展性。因为服务器不必为每个客户机维护历史记录,其设计要简单得多。此外,与有状态服务器相比,无状态服务器在相同的资源(如内存)下可以支持更多的用户。
然而,讲师指出,这种无状态性也带来了一些挑战,这将在后面讨论。
4.2 网页是如何显示的
4.2.1 组成结构
- Web页:由一些对象组成 (Web页本身就是一个对象,不过内部嵌入了一些对象,不是嵌入的对象本身,而是对象的链接) (Web页面有一个最基础的 base html,然后html通过链接其他的对象构成了一个 网状结构 )
- 对象可以是HTML文件、JPEG图像、Java小程序、声音剪辑文件等
- Web页含有一个基本的HTML文件,该基本HTML文件又包含若干对象的引用(链接)
- 通过URL对每个对象进行引用,包括访问协议用户名,口令字,端口等; ( 任何对象都可以采用URL来访问,任何对象也可以采用URL来唯一标识 )
Web应用的代理软件:浏览器
4.2.2 渲染过程
当你访问一个网站时,你的浏览器会经过多个步骤来显示页面。
首先,浏览器请求并接收基础HTML文件。这个文件包含页面的结构信息,如文本格式和布局,但不包含实际的图片。
接下来,浏览器读取这个HTML文件。在解析代码时,它会发现指向其他对象(如图片)的链接(URL)。对于每个这些链接,浏览器会向相应的服务器发起一个新的请求来获取该特定对象。
最后,当每个对象被接收后,浏览器会将其放置到已经构建好的结构中。这样,一个包含所有文本和图片的完整网页就被组装并显示在你的屏幕上了。
4.3 HTTP(超文本传输协议)概述
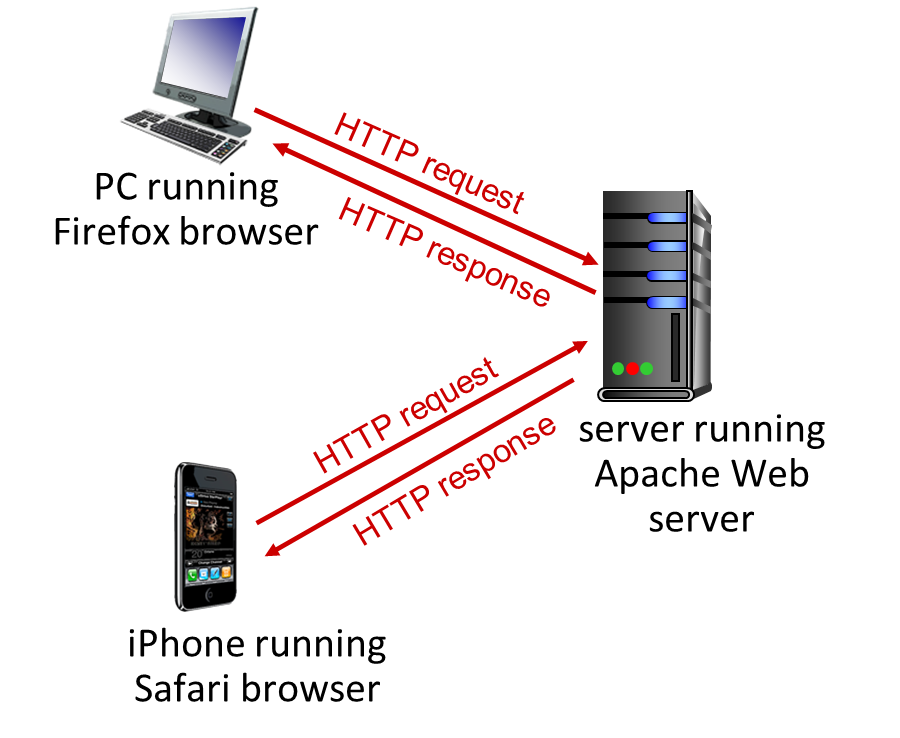
- HTTP: 超文本传输协议
- 网络架构 :客户/服务器模式(C/S)
- 客户: 请求、接收和显示 Web对象的浏览器
- 服务器: 对请求进行响应, 发送对象的Web服务器
- 版本 :
- HTTP 1.0: RFC 1945
- HTTP 1.1: RFC 206
4.3.1 连接过程(使用TCP和套接字)
HTTP协议使用的都是TCP连接方式
- 客户发起一个与服务器的TCP连接(建立套接字),端口号为80(默认是80)
- 服务器接受客户的TCP连接
- 在浏览器(HTTP客户端)与Web服务器(HTTP服务器server)交换HTTP报文(应用层协议报文)
- TCP连接关闭
HTTP依赖TCP协议进行可靠的数据传输。一个网络服务器被设置为在特定端口上“监听”传入的连接,按照惯例,这个端口是TCP 80端口。
讲师用套接字的概念解释了这个过程:
- 服务器在80端口启动一个主要的“等待套接字”【守护端口(TCP socket)】,它除了监听来自客户机的新连接请求外什么也不做。
- 当浏览器发送连接请求时,服务器接受该请求,并创建一个全新的、专用的“连接套接字”专门用于该次对话。
- 如果另一个浏览器连接,服务器会为其创建另一个独特的连接套接字。原来的等待套接字仍然保持打开状态,准备接受更多的请求。
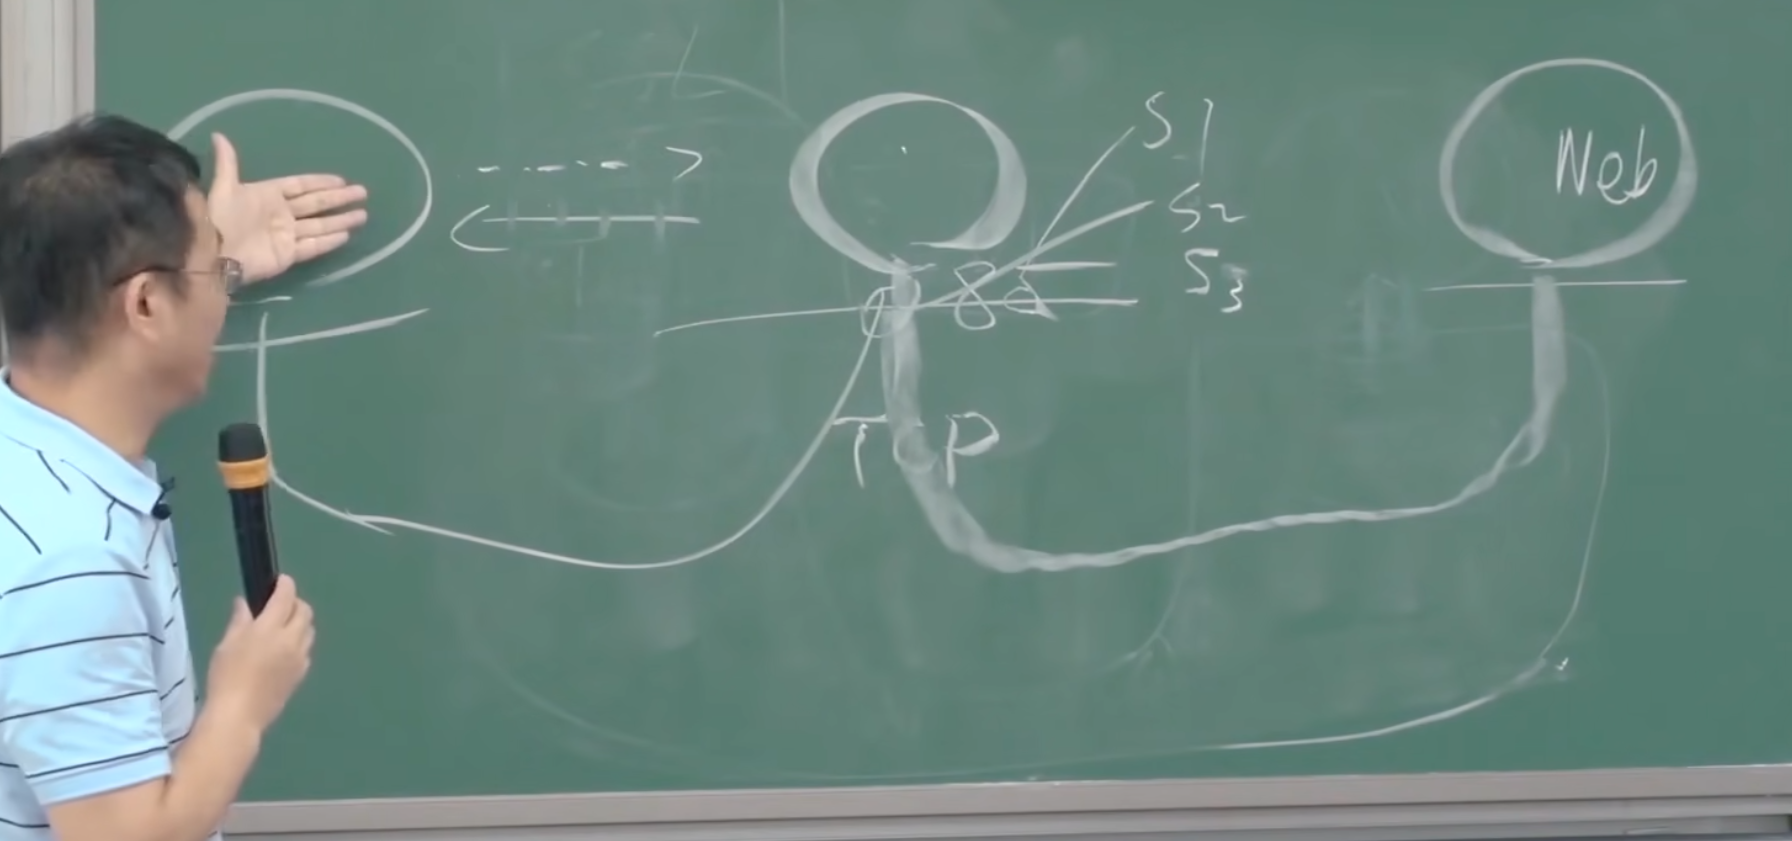
这种模型允许单个网络服务器高效地管理与许多不同客户机的并发连接。
HTTP: hypertext transfer protocol
- Web’s application-layer protocol
- client/server model:
- client: browser that requests, receives, (using HTTP protocol) and “displays” Web objects
- server: Web server sends (using HTTP protocol) objects in response to requests
HTTP uses TCP:
- client initiates TCP connection (creates socket) to server, port 80
- server accepts TCP connection from client
- HTTP messages (application-layer protocol messages) exchanged between browser (HTTP client) and Web server (HTTP server)
- TCP connection closed
HTTP is “stateless”
- server maintains no information about past client requests
aside protocols that maintain “state” are complex!
- past history (state) must be maintained
- if server/client crashes, their views of “state” may be inconsistent, must be reconciled
4.4 HTTP连接:持久连接与非持久连接
HTTP/1.0和HTTP/1.1之间的一个主要区别在于它们处理连接的方式。
要建立连接,客户端(浏览器)必须与其底层的TCP协议层进行通信,通常是通过一系列称为套接字API的命令。这会向服务器发送连接请求,服务器随后必须发回确认。这个过程不是即时的,它需要两台机器之间进行来回交换。
4.4.1 非持久HTTP(HTTP/1.0)
在HTTP/1.0模型中,每个连接仅用于获取一个对象,然后立即关闭。
非持久HTTP
- 最多只有一个 对象 在 TCP连接上发送
- 下载多个对象需要多 个TCP连接
- HTTP/1.0使用非持 久连接
对象指的是请求或响应的文件内容,比如请求一个视频,服务器响应回来的视频就是对象
HTTP1.0 连接是无状态的
- 服务器并不维护关于客户的任何信息
也就是服务器相应了之后就关闭了TCP连接,这种服务器叫做 无状态服务器
4.4.1.1 响应时间计算
使用非持久连接获取单个对象(如图片)时,所需的总时间可分解为:
- 一个往返时间(RTT(round-trip time)):仅用于建立TCP连接。RTT是一个小数据包从客户端传输到服务器再返回所花费的时间。
- 另一个RTT:用于客户端发送HTTP请求和服务器发回响应【请注意,这里涉及到TCP的三次握手,第一个RTT是前两次握手,第三次握手的时候会同时发送HTTP请求报文】。
- 对象传输时间:实际文件在网络上传输所花费的时间。
小请求消息的传输时间通常很短,可以忽略不计。但是,对于像高分辨率图像这样的大型响应对象,这个时间就很可观了。
因此,获取一个对象的总时间大约是2个RTT + 文件传输时间。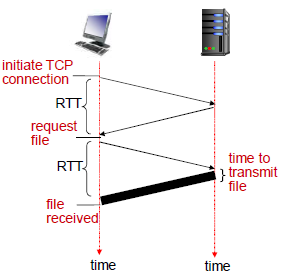
RTT不包含传输时间,响应时间包含,响应时间 = 2RTT+传输时间
4.4.1.2 实际示例
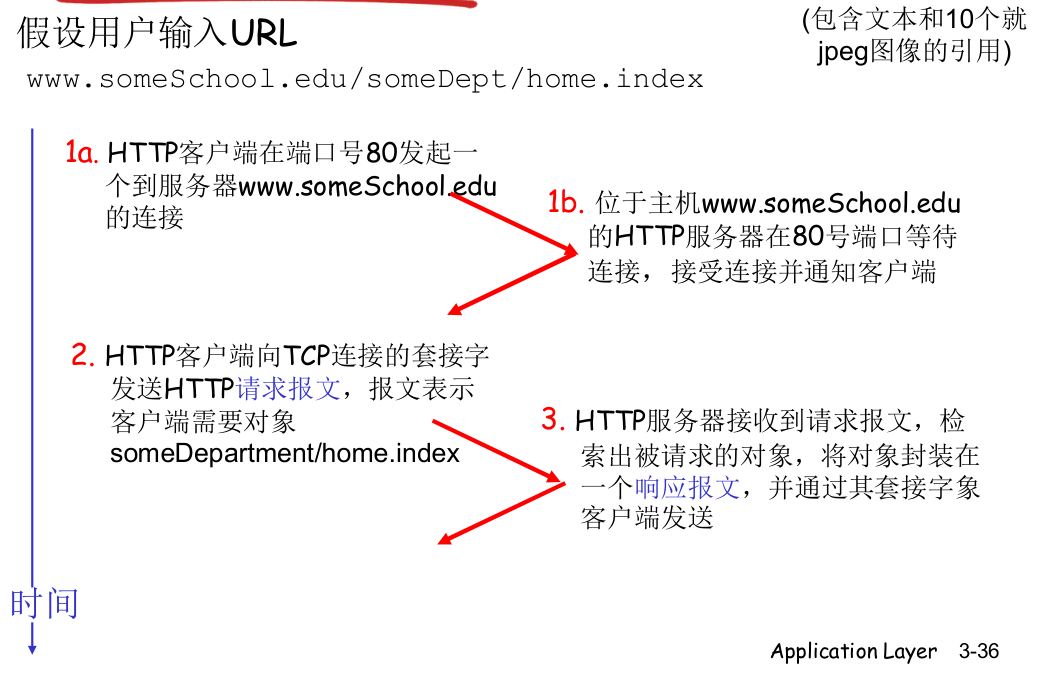
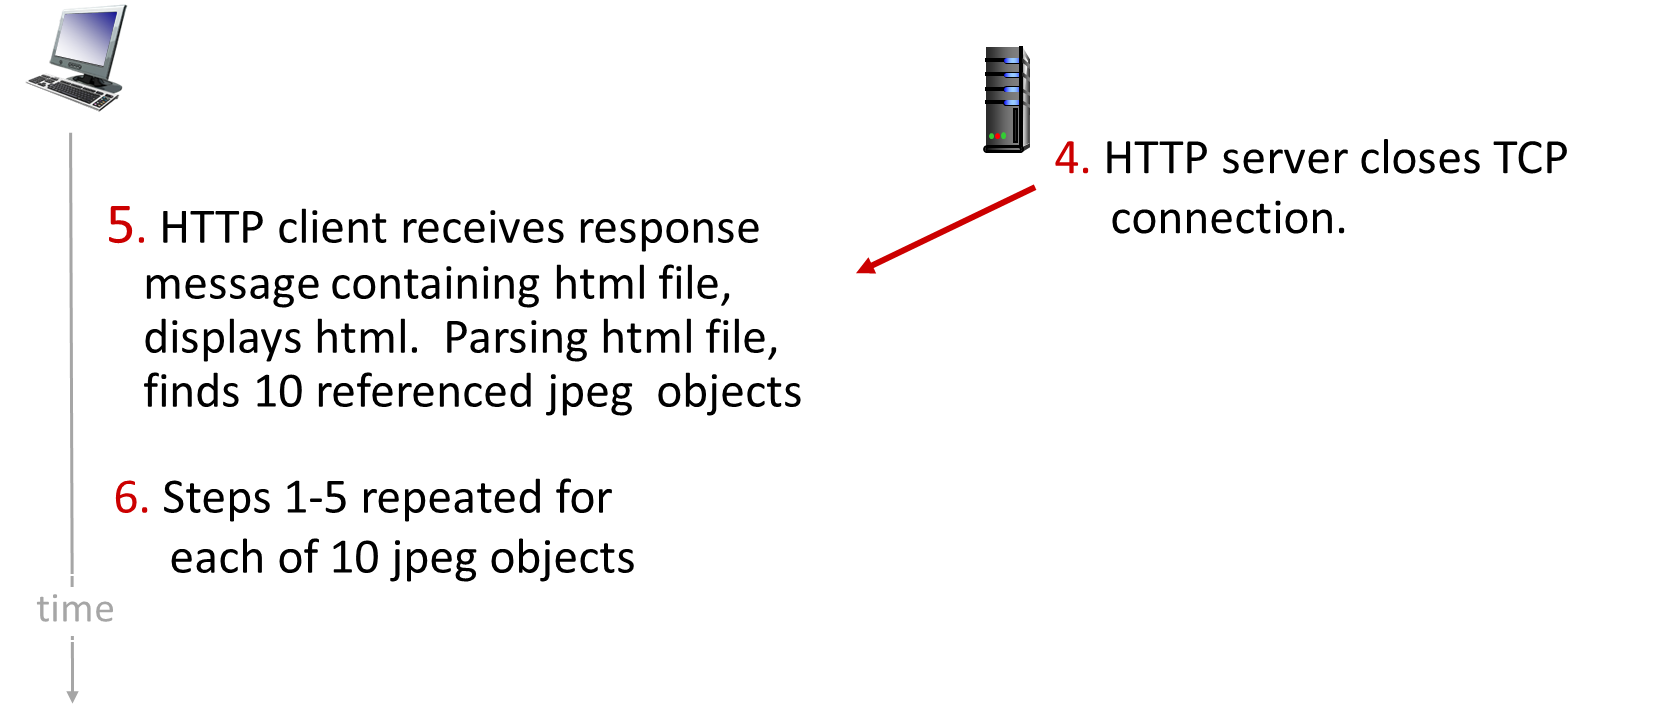
想象加载一个由一个基础HTML文件和10个嵌入图像组成的网页:
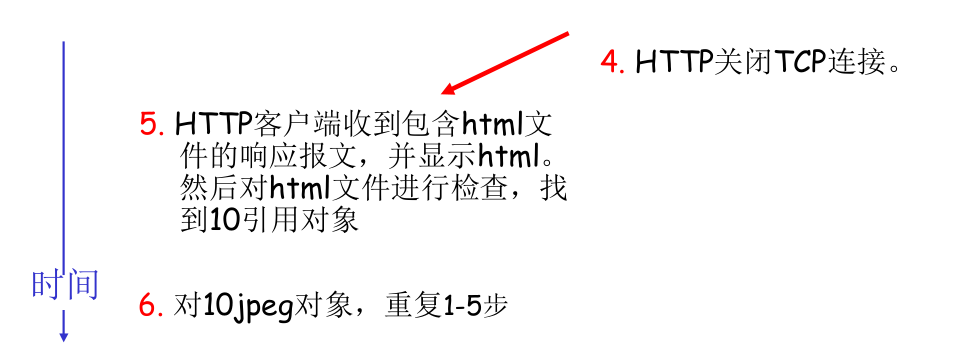
- 浏览器首先建立TCP连接(花费1个RTT)以获取HTML文件。然后它发送请求,获取文件,服务器关闭连接。
- 浏览器解析HTML并发现10个图像的URL。
- 对于这10个图像中的每一个,浏览器都必须重复整个过程:建立一个全新的TCP连接(1个RTT),请求图像(1个RTT),下载图像,然后关闭连接。
这意味着总共需要11个独立的TCP连接,使得这个过程非常低效。每个对象至少花费2个RTT。
4.4.1.3 优缺点
优点:
- 简单
缺点:
- 每个对象要2个 RTT
- 操作系统必须为每个TCP连接分 配资源
- 但浏览器通常打开并行TCP连接 ,以获取引用对象
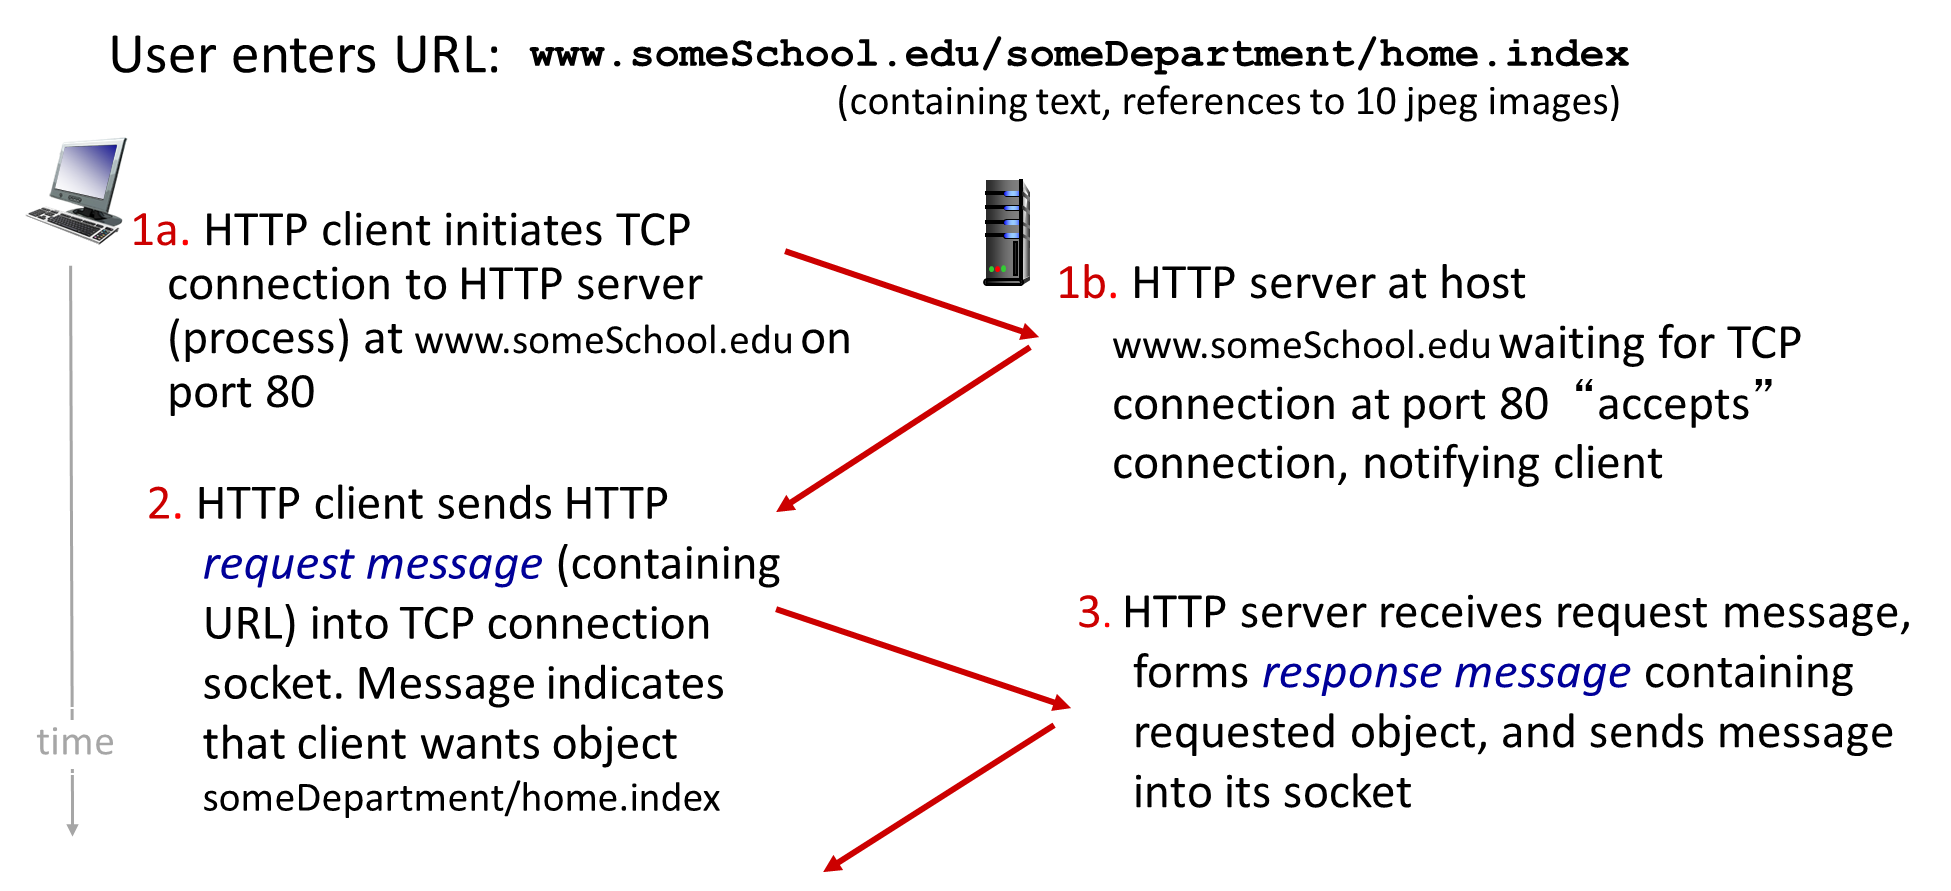
4.4.1.4 Non-persistent HTTP: example【张渊】
User enters URL: www.someSchool.edu/someDepartment/home.index (containing text, references to 10 jpeg images)
4.4.2 持久HTTP(HTTP/1.1)
Non-persistent HTTP issues:
- requires 2 RTTs per object
- OS overhead for each TCP connection
- browsers often open multiple parallel TCP connections to fetch referenced objects in parallel
Persistent HTTP (HTTP1.1):
- server leaves connection open after sending response
- subsequent HTTP messages between same client/server sent over open connection
- client sends requests as soon as it encounters a referenced object
- as little as one RTT for all the referenced objects (cutting response time in half)
HTTP/1.1引入了持久连接作为默认行为,以解决这种低效问题。
初始TCP连接的建立方式与以前相同(花费1个RTT)。但是,服务器发送响应后,会保持TCP连接打开。
如果客户端需要从同一服务器请求更多对象(如我们示例中的10个图像),它可以通过已存在的连接发送这些新请求。这完全消除了为每个对象花费一个RTT建立新连接的需求。
流程如下:
- 服务器在发送响应后,仍保持TCP连接
- 在相同客户端和服务器之间的后续请求和响应报文通过相同的连接进行传送
- 客户端在遇到一个引用对象的时候,就可以尽快发送该对象的请求
4.4.2.1 维护状态的困难
维护状态的协议很复杂!
- 必须维护历史信息(状态)
- 如果服务器/客户端死机,它们的状态信息可能不一致, 二者的信息必须是一致
- 无状态的服务器能够支持更 多的客户端
4.4.2.2 流水线和非流水线
持久连接可以在两种模式下运行:
- 非流水线模式:客户端发送一个对象的请求,等待完全接收响应后,才发送下一个对象的请求。这比非持久连接更高效,但仍然存在等待时间。
- 流水线模式(HTTP/1.1中的默认模式):客户端可以连续发送多个请求,而无需等待响应。例如,它可以一次发送所有10个图像的请求。然后服务器处理这些请求,并按顺序发回响应。
讲师用汽车工厂的类比解释:非流水线模式就像先从头到尾造好一辆车,再开始造下一辆。流水线模式就像现代装配线,多辆车同时处于不同的生产阶段。这种“流水线”方法显著减少了用户必须等待的总时间。
4.5 HTTP报文格式
HTTP消息主要有两种类型:请求消息(从客户端到服务器)和响应消息(从服务器到客户端)。
这些消息的一个关键特点是它们以纯ASCII文本编写,因此人类可以阅读。讲师解释说,这是早期协议中常见的设计选择,目的是让程序员可以通过直接读取网络流量来轻松调试。
4.5.1 HTTP请求报文
HTTP请求报文具有清晰、标准化的结构。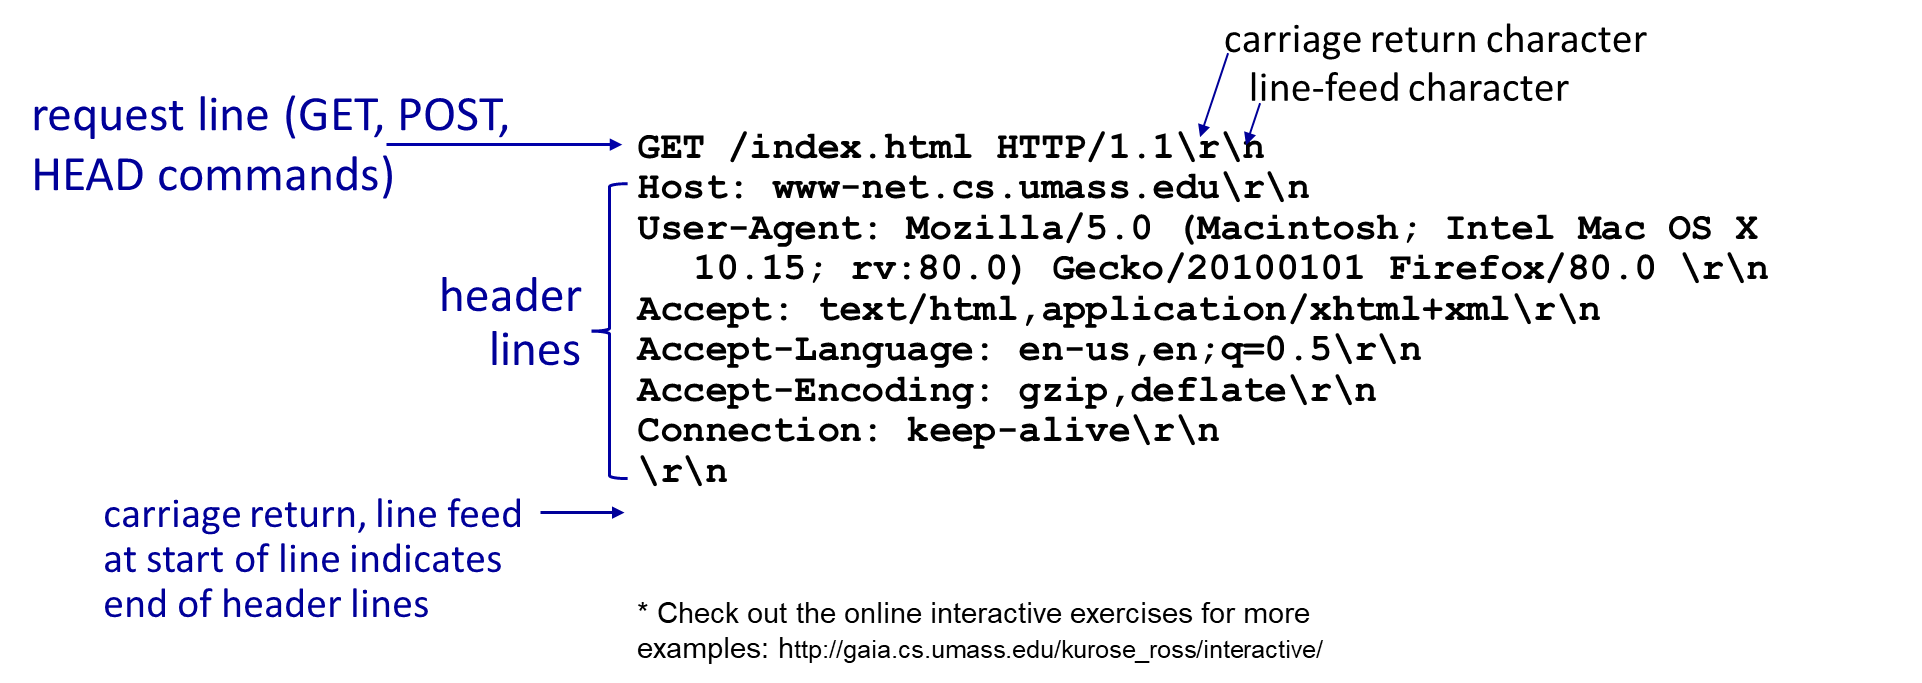
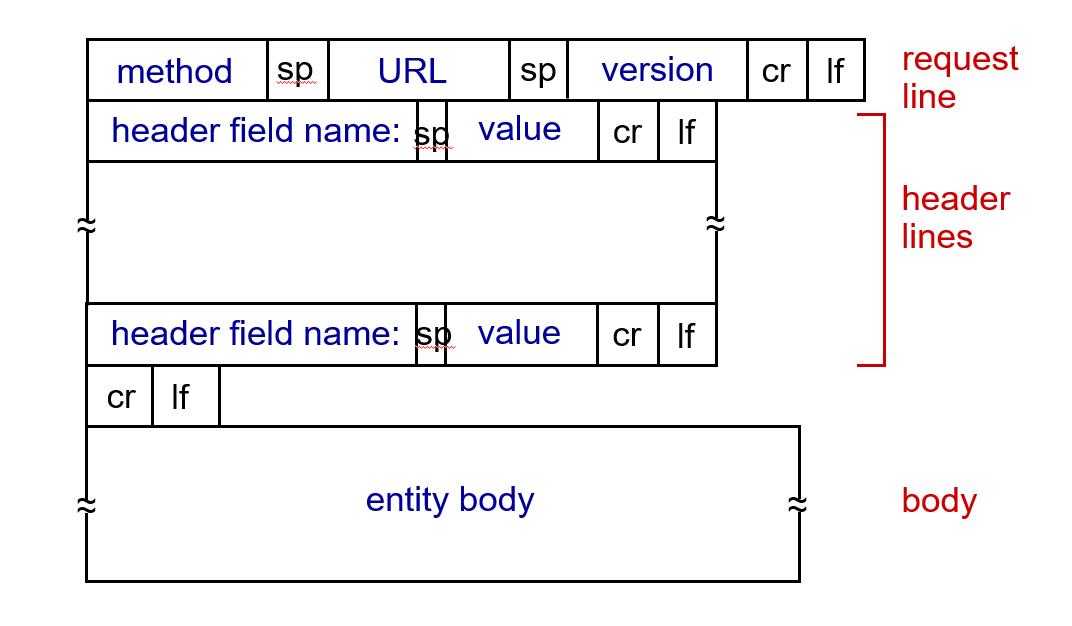
4.5.1.1 通用格式
- 请求行:指定方法、资源的URL和HTTP版本。
- 首部行:提供关于请求的附加信息。每个头部都是一个
名称: 值对。 - 空行:一个回车符和换行符将头部与主体分隔开。
- 实体主体(可选):包含发送到服务器的数据,主要与
POST方法一起使用。
示例:
GET /somedir/page.html HTTP/1.1
Host: www.someschool.edu
User-agent: Mozilla/4.0
Connection: close
Accept-language:fr

# 后面可能是有实体部分,不过这里是get方法就没有了
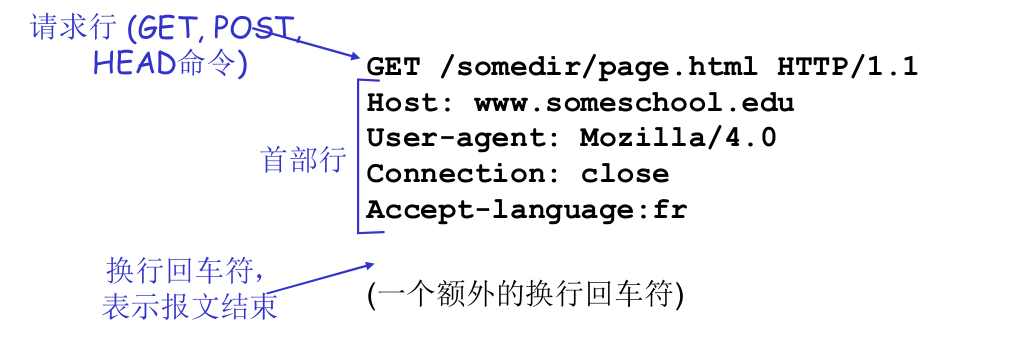 在这个示例中,
Connection: close是一个头部,告诉服务器在此次响应后关闭连接,尽管HTTP/1.1默认使用持久连接。
4.5.1.2 HTTP 请求报文首部行 (HTTP Request Message Headers)
在请求报文示例中(图 2.8 及相关文字),提到了以下首部行:
Host: 指明了所请求对象所在的主机(例如www.someschool.edu)。在 Web 代理缓存和持久连接中,这个首部行是必需的。Connection: 当值为close时(Connection: close),表示浏览器不希望使用持久连接,它告诉服务器在发送完所请求的对象后就关闭该 TCP 连接。User-agent: 指明了发出该请求的浏览器类型(例如Mozilla/5.0,代表 Firefox 浏览器)。服务器可以利用这个信息来为不同类型的浏览器实际发送同一对象的不同版本。Accept-language: 指明用户偏好接收的语言版本(例如fr代表法语)。如果服务器上有该语言版本的对象,就会发送该版本。
4.5.1.3 提交表单输入
客户端向服务器发送信息通常有两种方式:
-
POST方法:数据(如从填写好的网页表单中)包含在请求消息的实体主体中。
-
GET方法:数据作为查询字符串附加在URL的末尾。格式为
?参数1=值1&参数2=值2。例如,百度上的搜索可能看起来像:http://www.baidu.com/s?wd=xx+yy+zzz&cl=3这发送了两个参数:wd的值为xx+yy+zzz,cl的值为3。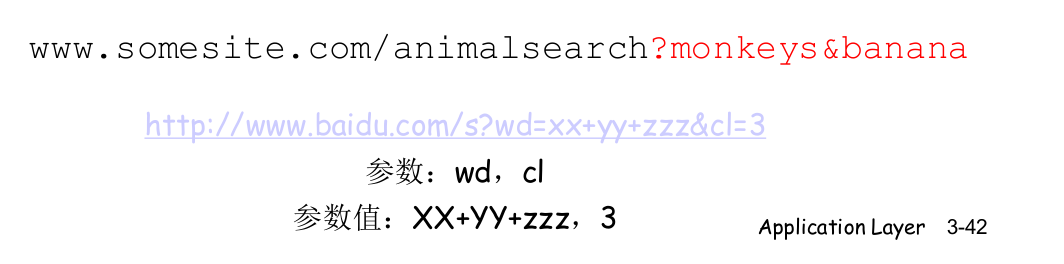
- sp是space空格
- cr是回车
- if是有可能有,有可能没有
4.6 HTTP方法
不同的HTTP版本支持不同的方法:
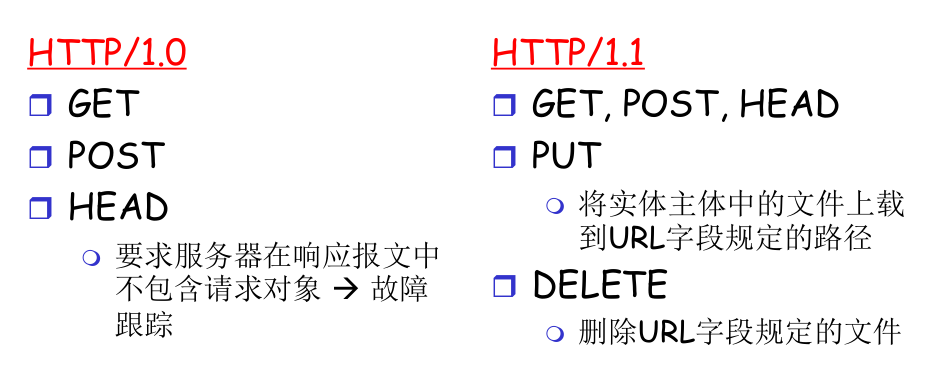 HTTP/1.0方法:
GET:向服务器请求资源。POST:提交数据供服务器处理。HEAD:仅请求资源的头部,而不是实际内容。讲师指出,这对搜索引擎非常有用,搜索引擎可以“爬取”网络来收集元数据并建立索引,而无需下载每个文件。
HTTP/1.1方法: 包括所有HTTP/1.0方法,此外还有:
PUT:将文件或资源上传到服务器上的特定位置。DELETE:删除URL指定的资源。
PUT和DELETE方法通常由网页开发人员和管理员用于网站维护,而不是由普通浏览网页的用户使用。
4.7 The GET request message
4.7.1 GET method:
- Used for retrieving an object (e.g. a html file, a jpg, a sound file, …) from a specified resource
GET /somedir/page.html HTTP/1.1
Host: www.someschool.edu
Connection: close
User-agent: Mozilla/5.0
Accept-language: fr
- Also supports “GET with inputs” by including the inputs in URL field of HTTP GET request message (following a ’?’), e.g., www.somesite.com/animalsearch?monkeys&banana
4.7.2 Other HTTP request messages
POST method:
- web page often includes form input, e.g.
- user input sent from client to server in entity body of HTTP POST request message
HEAD method:
- Similar to GET, but server only returns a light-weight response by omitting the requested object.
- Often used for debugging
PUT method:
- uploads new file (object) to server
- completely replaces file that exists at specified URL with content in entity body of PUT HTTP request message
4.8 HTTP响应报文
HTTP响应报文由服务器发送给客户端,其基本格式包含三个部分:一个状态行、若干首部行,以及一个实体部分(即数据)。
4.8.1 状态行与首部行解析
状态行是响应报文的第一行,它包含了协议版本号、状态码以及对状态码的文字解释。例如,HTTP/1.1 200 OK 表示使用的是HTTP 1.1版本,状态码200代表请求成功。
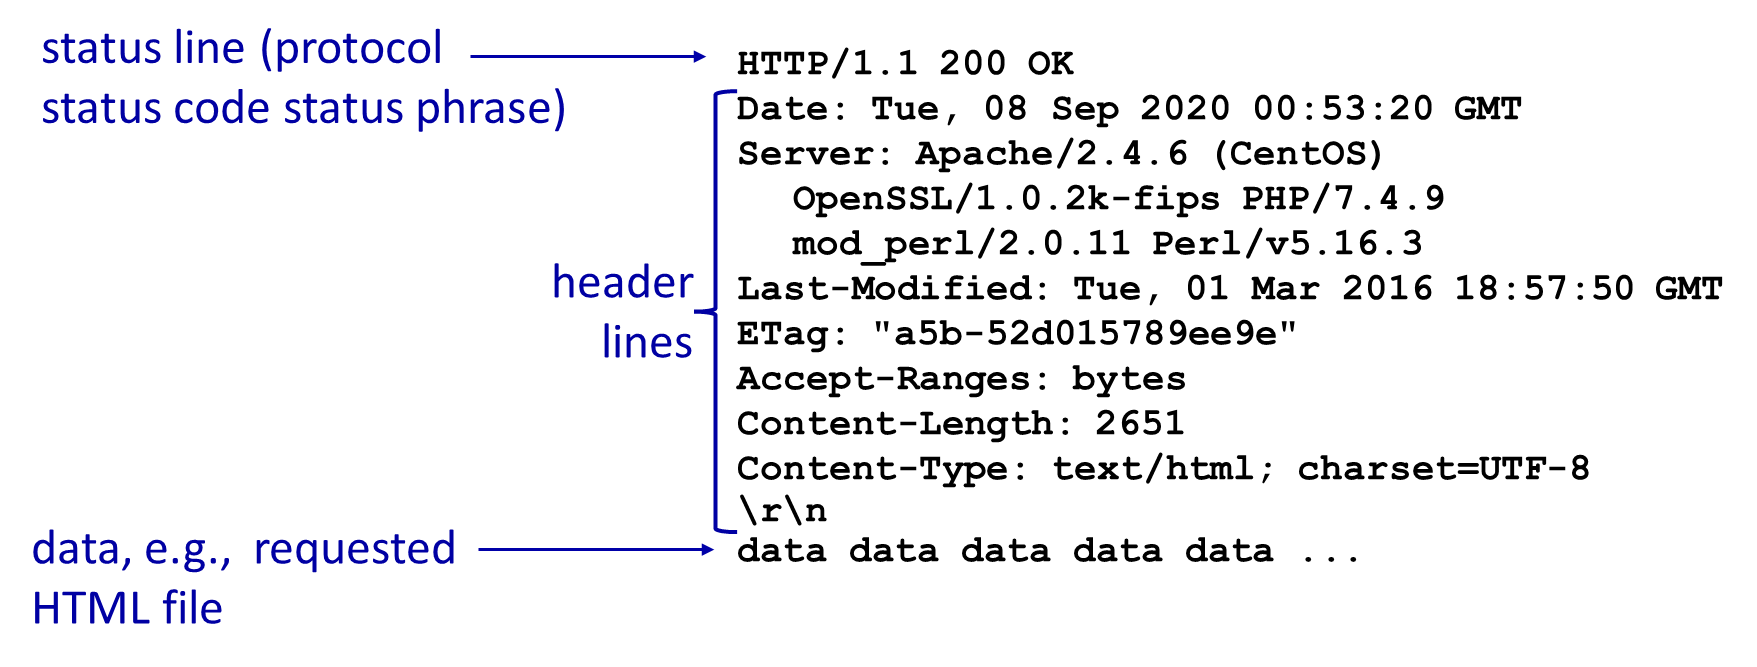
| 部分 | 举例 | 说明 |
|---|---|---|
| 状态行 | HTTP/1.1 200 OK | HTTP/1.1是协议及版本 200是状态码 OK是状态码相应状态信息 |
| 首部行 | Connection close Date: Thu, 06 Aug 1998 12:00:15 GMT Server: Apache/1.3.0 (Unix) Last-Modified: Mon, 22 Jun 1998 …… Content-Length: 6821 Content-Type: text/html | |
| 数据 | data data data data data… |
首部行紧跟在状态行之后,提供了关于服务器和响应数据的附加信息。
- Server: 告知客户端服务器软件的信息,例如
Apache/1.3.0 (Unix)。 - Last-Modified: 指明请求的对象上一次被修改的日期。这个信息非常有用,可以被当作一个版本号来使用。
- Content-Length: 定义了实体主体的字节数,例如
6821。这个字段至关重要。
4.8.1.1 HTTP 响应报文首部行 (HTTP Response Message Headers)
在响应报文示例中(图 2.9 及相关文字),提到了以下首部行:
Connection: 当值为close时(Connection: close),表示服务器告诉客户端,它在发送完报文后将关闭 TCP 连接。Date: 指示该 HTTP 响应报文被服务器创建和发送的日期和时间(例如Tue, 18 Aug 2015 15:44:04 GMT)。Server: 指示生成该响应报文的 Web 服务器软件(例如Apache/2.2.3 (CentOS))。这类似于请求报文中的User-agent首部行。Last-Modified: 指示对象被创建或最后修改的日期和时间(例如Tue, 18 Aug 2015 15:11:03 GMT)。这个首部行对于对象缓存(包括本地客户端缓存和网络缓存服务器)至关重要。Content-Length: 指示实体体 (entity body) 中被发送对象的字节数(例如6821)。Content-Type: 指示实体体中的对象类型(例如text/html)。Location: (课本在讨论301状态码时提到) 当一个对象被永久移动时,该首部行会包含该对象的新 URL。客户端软件会自动(用新的 URL)获取该对象。
NOTE
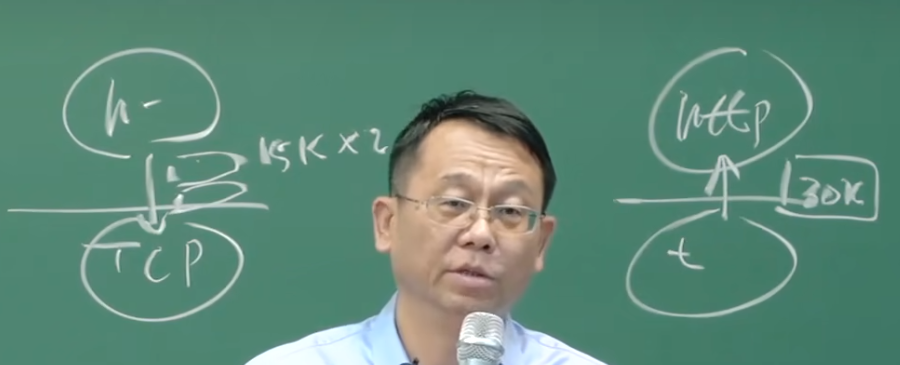
教师特别强调,HTTP运行在TCP之上,而TCP向上层提供的是一种“字节流”(byte stream)服务,它不保证报文的边界。
这意味着,如果应用层向下发送了两个15KB的报文,接收方的TCP层可能会将其合并成一个30KB的数据块向上交付。
因此,应用层协议必须自己来区分报文的开始和结束。HTTP协议正是通过
Content-Length这个首部字段来解决这个问题的,它明确告诉接收方需要读取多少字节才能获得完整的响应内容。
4.9 HTTP响应状态码
早期的应用层协议,包括HTTP,其状态码和命令行通常使用ASCII码字符来表示。这样做的好处是便于网络管理员进行故障排查。
因为报文内容是人类可读的,可以直接打印出来查看,而无需去查阅手册来解码二进制代码。HTTP不仅提供了状态码(如200),还附带了易于理解的文字解释(如OK)。
以下是几个常见的状态码:
- 200 OK: 请求已成功。
- 301 Moved Permanently: 请求的资源已被永久移动到了新的位置。
- 400 Bad Request: 服务器无法理解或解析客户端的请求。
- 404 Not Found: 服务器上没有找到请求的资源,这是大家非常熟悉的一个状态码。
- 505 HTTP Version Not Supported: 服务器不支持请求中所使用的HTTP协议版本。
4.10 动手实践:模拟HTTP请求
使用linux来发送http请求
telnet cis.poly.edu 80opens TCP connection to port 80 (default HTTP server port) at cis.poly.edu. anything typed in sent to port 80 at cis.poly.edu
就是建立了TCP连接
GET /~ross/ HTTP/1.1 Host: cis.poly.eduby typing this in (hit carriage return twice), you send this minimal (but complete) GET request to HTTP server
4.11 维持状态:Cookie机制
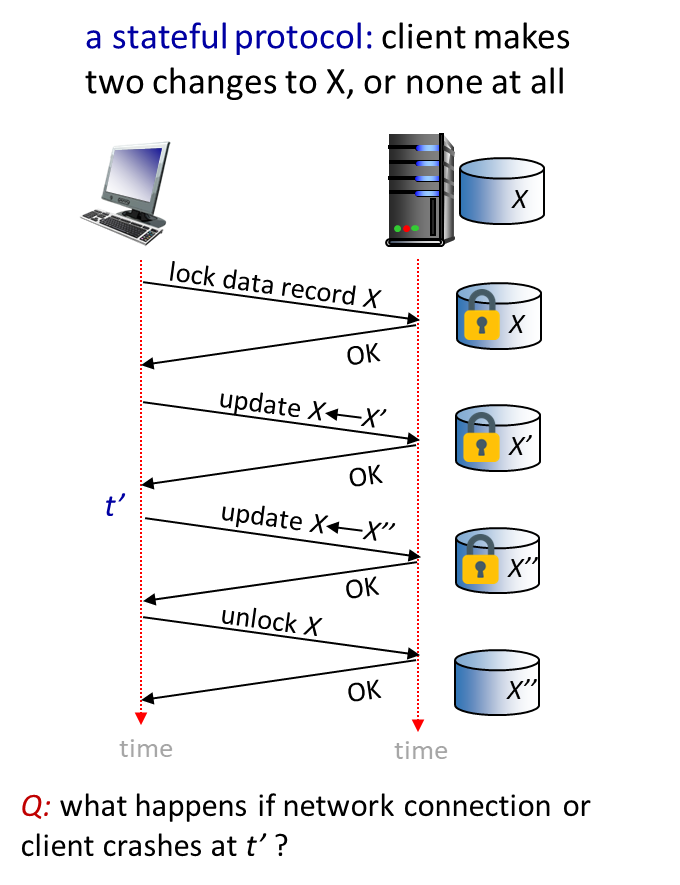
HTTP协议本质上是一个无状态协议。这意味着服务器不会保存任何关于客户端过去请求的信息。服务器只是简单地接收请求、解析、找到资源、然后发送响应。
这种无状态的设计有其优点,比如结构简单,能用同样的资源支持更多的客户端。然而,对于电子商务或文件共享等需要记录用户状态的应用,无状态协议就显得力不从心了。例如,网站需要记住用户的登录状态、购物车里的商品等。
为了解决这个问题,引入了Cookie机制。
Recall: HTTP GET/response interaction is stateless
- no notion of multi-step exchanges of HTTP messages to complete a Web “transaction”
- no need for client/server to track “state” of multi-step exchange
- all HTTP requests are independent of each other
- no need for client/server to “recover” from a partially-completed-but-never-completely-completed transaction
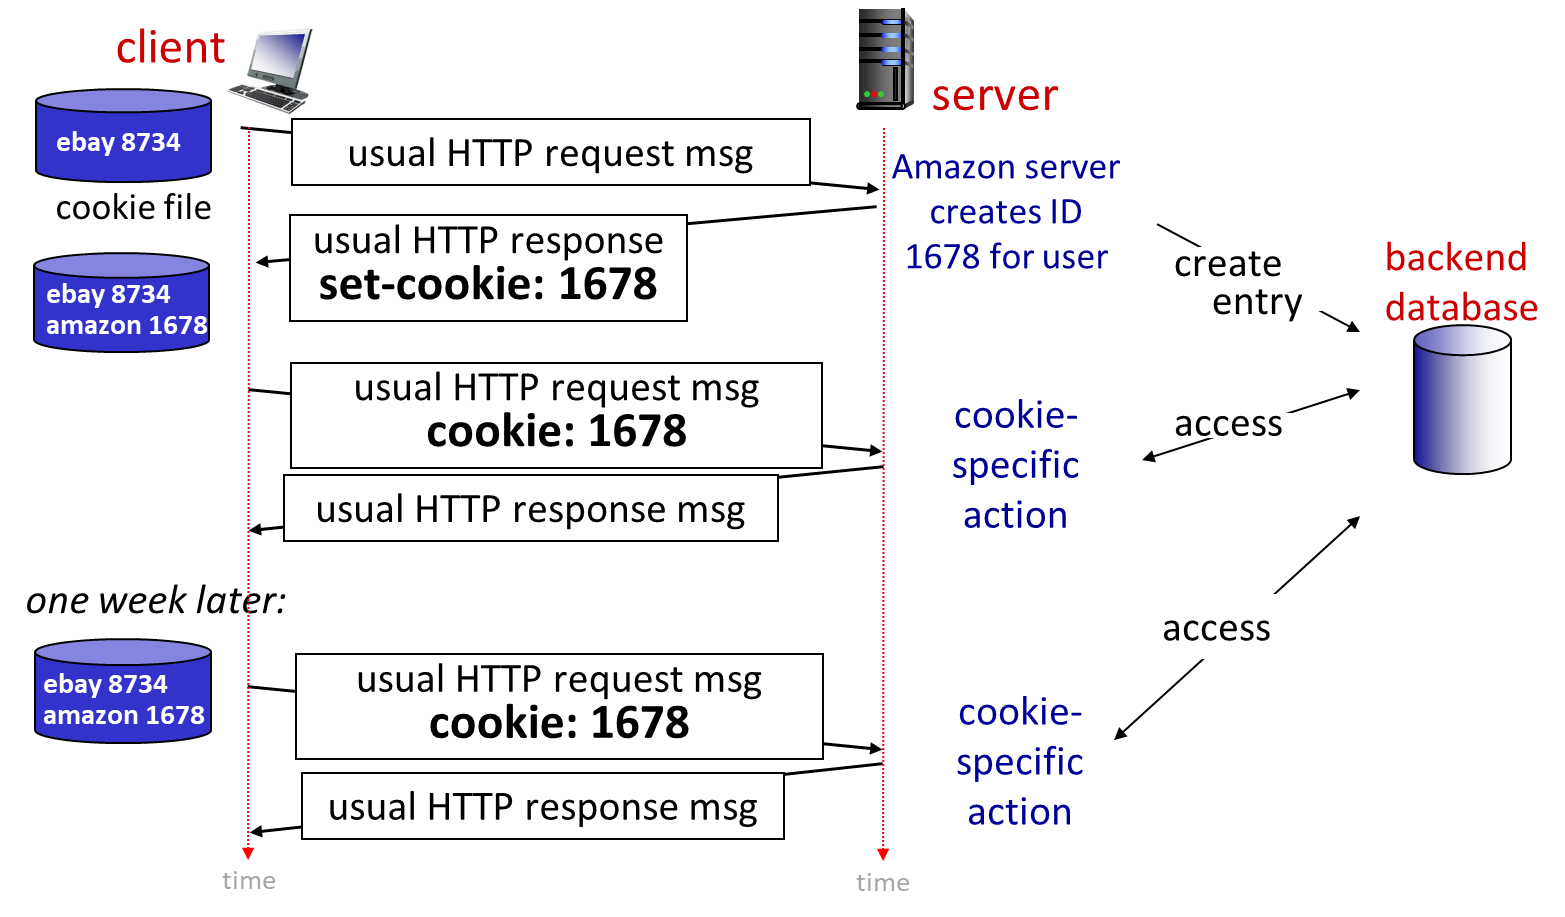
Web sites and client browser use cookies to maintain some state between transactions
four components:
- cookie header line of HTTP response message
- cookie header line in next HTTP request message
- cookie file kept on user’s host, managed by user’s browser
- back-end database at Web site
Here’s how it works:
- When a user visits a site for the first time, the server creates a unique ID for them.
- The server sends this ID back to the client in the response headers (
Set-Cookie:). - The client’s browser stores this cookie.
- On all subsequent requests to that site, the browser includes the cookie in the request headers.
- The server uses this ID to look up the user’s past activity (like items in a shopping cart) in its database and provide a continuous experience.
Example:
- Susan uses browser on laptop, visits specific e-commerce site for first time
- when initial HTTP requests arrives at site, site creates:
- unique ID (aka “cookie”)
- entry in backend database for ID
- subsequent HTTP requests from Susan to this site will contain cookie ID value, allowing site to “identify” Susan
4.11.1 Cookie的工作原理与组成
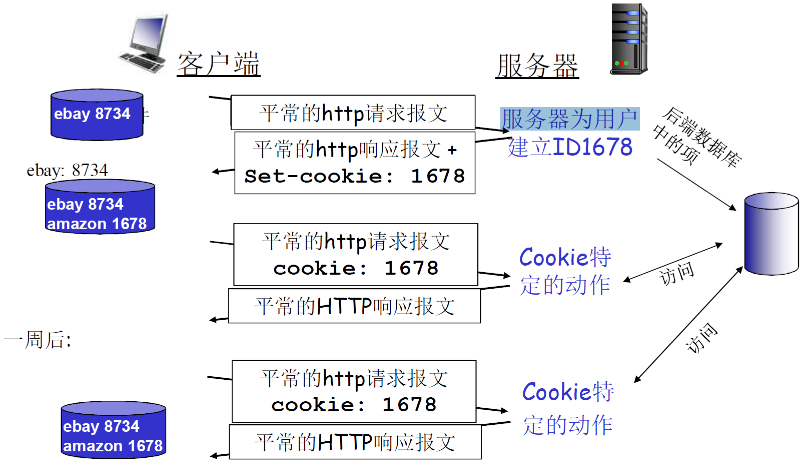
Cookie机制通过在服务器和客户端之间传递状态信息,巧妙地将无状态的HTTP协议变得“有状态”。它主要包含以下四个组成部分:
- 在HTTP响应报文中有一个
Set-Cookie首部行。 - 在HTTP请求报文中有一个
Cookie首部行。 - 在客户端的本地文件系统中,由浏览器管理和存储一个Cookie文件。
- 在Web服务器端,有一个用于存储和查询Cookie信息的后端数据库。
整个流程如下:当用户第一次访问一个网站时,请求中没有Cookie。服务器会为该用户生成一个唯一的ID(即Cookie),并在其后端数据库中创建对应条目。
接着,服务器在发回的响应报文中,通过 Set-Cookie 首部行将这个ID发送给客户端。客户端浏览器收到后,会将这个Cookie存储在本地。
从此以后,该浏览器每次向这个网站发送请求时,都会自动在请求报文中加入 Cookie 首部行并带上这个ID。服务器通过这个ID就能识别出是哪个用户,并查询其历史状态,从而提供个性化的服务。
Cookies能带来什么:
- 用户验证
- 购物车
- 推荐
- 用户状态 (Web e-mail)
如何维持状态:
-
协议端节点:在多个事务上 ,发送端和接收端维持状态
-
cookies: http报文携带状 态信息
4.11.2 Cookie的应用场景
通过维持用户的状态,Cookie能够支持许多重要的Web应用功能:
- 用户验证: 用户登录一次后,服务器通过Cookie记住其登录状态,避免了每次操作都要求重新登录的麻烦。
- 购物车: 服务器可以根据Cookie ID来维护不同用户的购物车内容。
- 个性化推荐: 网站可以记录用户的历史购买或浏览记录,并据此进行商品推荐。
- 用户状态维护: 在一些在线社区或Web邮箱中,服务器需要维护用户的当前操作状态,例如正在编辑的帖子内容。
4.11.3 拓展讨论:Cookie与隐私
- Cookies允许站点知道许多关于 用户的信息
- 可能将它知道的东西卖给第三方
- 使用重定向和cookie的搜索引 擎还能知道用户更多的信息
- 如通过某个用户在大量站点 上的行为,了解其个人浏览方式的大致模式
- 广告公司从站点获得信息
有些网站就要求发送cookie,从而收集到用户的信息进行推荐等用处
5 HTTP的发展(HTTP2)张渊
| Version | Year introduced | Current status | Usage in August 2024 | Support in August 2024 |
|---|---|---|---|---|
| HTTP/0.9 | 1991 | Obsolete | 0 | 100% |
| HTTP/1.0 | 1996 | Obsolete | 0 | 100% |
| HTTP/1.1 | 1997 | Standard | 33.8% | 100% |
| HTTP/2 | 2015 | Standard | 35.3% | 66.2% |
| HTTP/3 | 2022 | Standard | 30.9% | 30.9% |
5.1 HTTP/2
Key goal: decreased delay in multi-object HTTP requests
5.1.1 The Problem with HTTP/1.1: Head-of-Line Blocking
HTTP1.1: introduced multiple, pipelined GETs over single TCP connection
- server responds in-order (FCFS: first-come-first-served scheduling) to GET requests
- with FCFS, small object may have to wait for transmission (head-of-line (HOL) blocking.) behind large object(s)
- loss recovery (retransmitting lost TCP segments) stalls object transmission
HTTP 1.1: client requests 1 large object (e.g., video file) and 3 smaller objects.
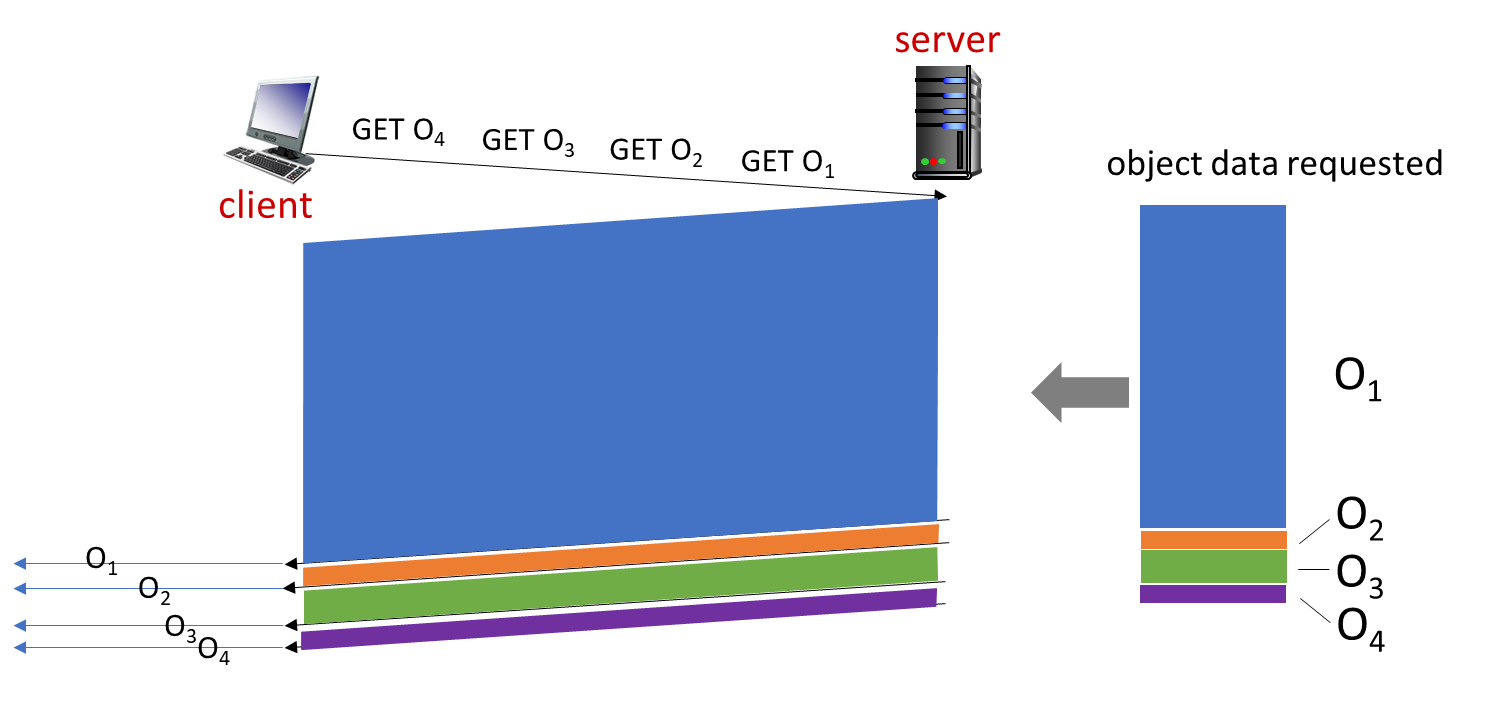
objects delivered in order requested: wait behind
5.1.2 The Solution in HTTP/2: Frames and Interleaving
HTTP/2: [RFC 7540, 2015] increased flexibility at server in sending objects to client:
- methods, status codes, most header fields unchanged from HTTP 1.1
- transmission order of requested objects based on client-specified object priority (not necessarily FCFS)
- push unrequested objects to client
- divide objects into frames, schedule frames to mitigate HOL blocking
The main innovations were:
- Object Framing: Objects are divided into smaller chunks called frames.
- Interleaving: The server can now interleave these frames from multiple objects and send them over the single TCP connection.
- Prioritization: The client can tell the server which objects are more important, so the server is no longer bound by a strict FCFS schedule.
- Server Push: The server can proactively “push” resources to the client that it anticipates will be needed, even before the client requests them.
HTTP/2: objects divided into frames, frame transmission interleaved
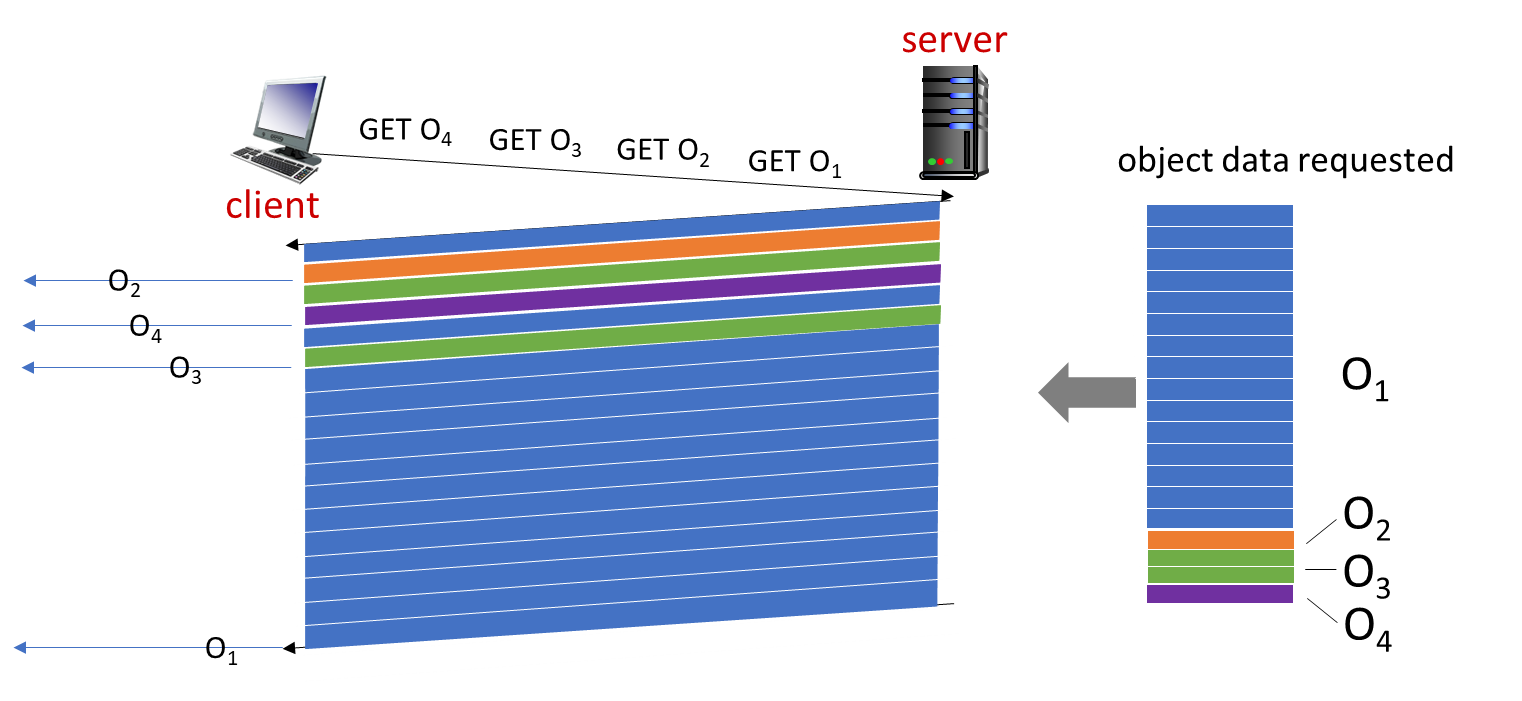
delivered quickly, slightly delayed
5.1.3 The Next Step: HTTP/3 and QUIC
HTTP/2 over single TCP connection means:
- recovery from packet loss still stalls all object transmissions
- as in HTTP 1.1, browsers have incentive to open multiple parallel TCP connections to reduce stalling, increase overall throughput
- no security over vanilla TCP connection
- HTTP/3: adds security, per object error- and congestion-control (more pipelining) over UDP
- more on HTTP/3 in transport layer
While HTTP/2 solved HOL blocking at the application layer, a similar problem still existed at the transport layer. Because HTTP/2 runs over TCP, if a single TCP segment (packet) is lost, TCP’s reliable, in-order delivery mechanism will halt the delivery of all streams until that packet is retransmitted. This stalls all objects again.
HTTP/3 addresses this by fundamentally changing the underlying transport protocol.
- HTTP/3 runs over UDP, not TCP. UDP is a simpler protocol that does not provide reliability or in-order delivery guarantees.
- It uses a new protocol called QUIC built on top of UDP. QUIC re-implements the necessary features like reliability, congestion control, and security, but it does so on a per-stream basis.
- This means that if a packet from one object’s stream is lost, it only stalls that specific stream. The other object streams can continue to be delivered without interruption, completely eliminating the transport-layer HOL blocking problem.
6 Web缓存
6.1 Web缓存(代理服务器)的基本概念
访问Web内容主要有两种方式:一是直接从源头服务器(Origin Server)获取,二是通过Web缓存(通常也称为代理服务器)来访问。
代理服务器的工作流程如下:
用户的浏览器被设置为将所有HTTP请求首先发送给一个Web缓存服务器。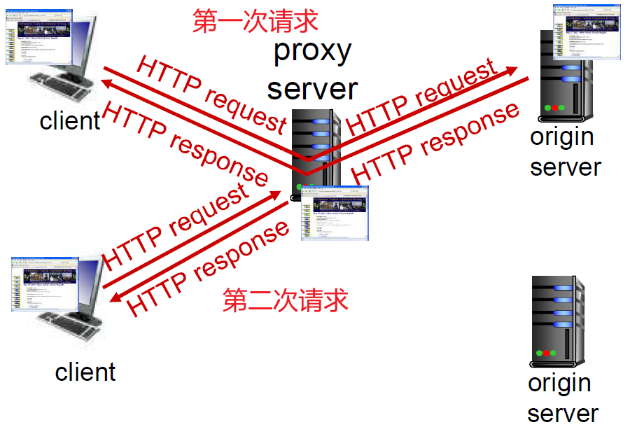
- 如果缓存服务器的本地存储中有所请求的对象,这就构成了一次“命中”(Hit)。缓存会直接将该对象封装成响应报文返回给用户。
- 如果缓存中没有该对象,即“未命中”,缓存服务器会代表用户向原始服务器发起请求,获取该对象。在将对象返回给用户的同时,它也会在本地存储一份副本,以备后续请求使用。
Goal: satisfy client requests without involving origin server
-
user configures browser to point to a (local) Web cache
-
browser sends all HTTP requests to cache
- if object in cache: cache returns object to client
- else cache requests object from origin server, caches received object, then returns object to client
-
server tells cache about object’s allowable caching in response header:
Cache-Control: max-age=<seconds>Cache-Control: no-cache
Here’s how it works:
- A user’s browser is configured to send all HTTP requests to the local web cache first.
- The cache checks if it has a copy of the requested object.
- Cache Hit: If the object is in the cache, it’s returned directly to the user, which is very fast. This avoids involving the original server.
- Cache Miss: If the object isn’t in the cache, the cache requests it from the original server, returns it to the user, and stores a copy for future requests.
6.2 使用Web缓存的优势
教师强调,分析缓存带来的好处需要从多个视角来看:
- 对于客户端用户:最直接的好处是显著降低了请求的响应时间,访问速度变得更快。
- 对于原始服务器:由于大量请求被缓存服务器“拦截”并满足,原始服务器的负载大大减轻。
- 对于网络本身:机构内部网络与互联网之间的接入链路上的流量也大幅减少,减轻了网络负担。
这种高效性背后有一个重要原理,即“二八分布”(或称齐夫分布)。这个规律指出,大约80%的用户访问都集中在20%的热点内容上。
Why Web caching?
-
reduce response time for client request
- cache is closer to client
-
reduce traffic on an institution’s access link
-
Internet is dense with caches provided by CDN companies
- enables “poor” content providers to more effectively deliver content
-
Web cache acts as both client and server
- server for original requesting client
- client to origin server
从角色上看,缓存服务器既是客户端(相对于原始服务器而言),又是服务器(相对于用户而言)。
6.3 缓存性能分析:一个计算示例
接下来,我们通过一个具体的例子来量化分析Web缓存的作用。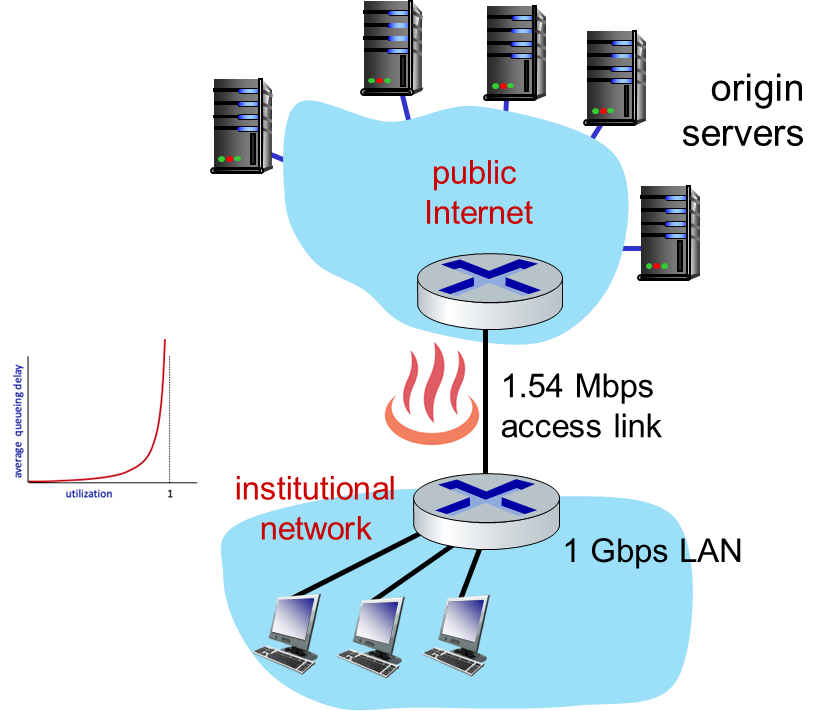
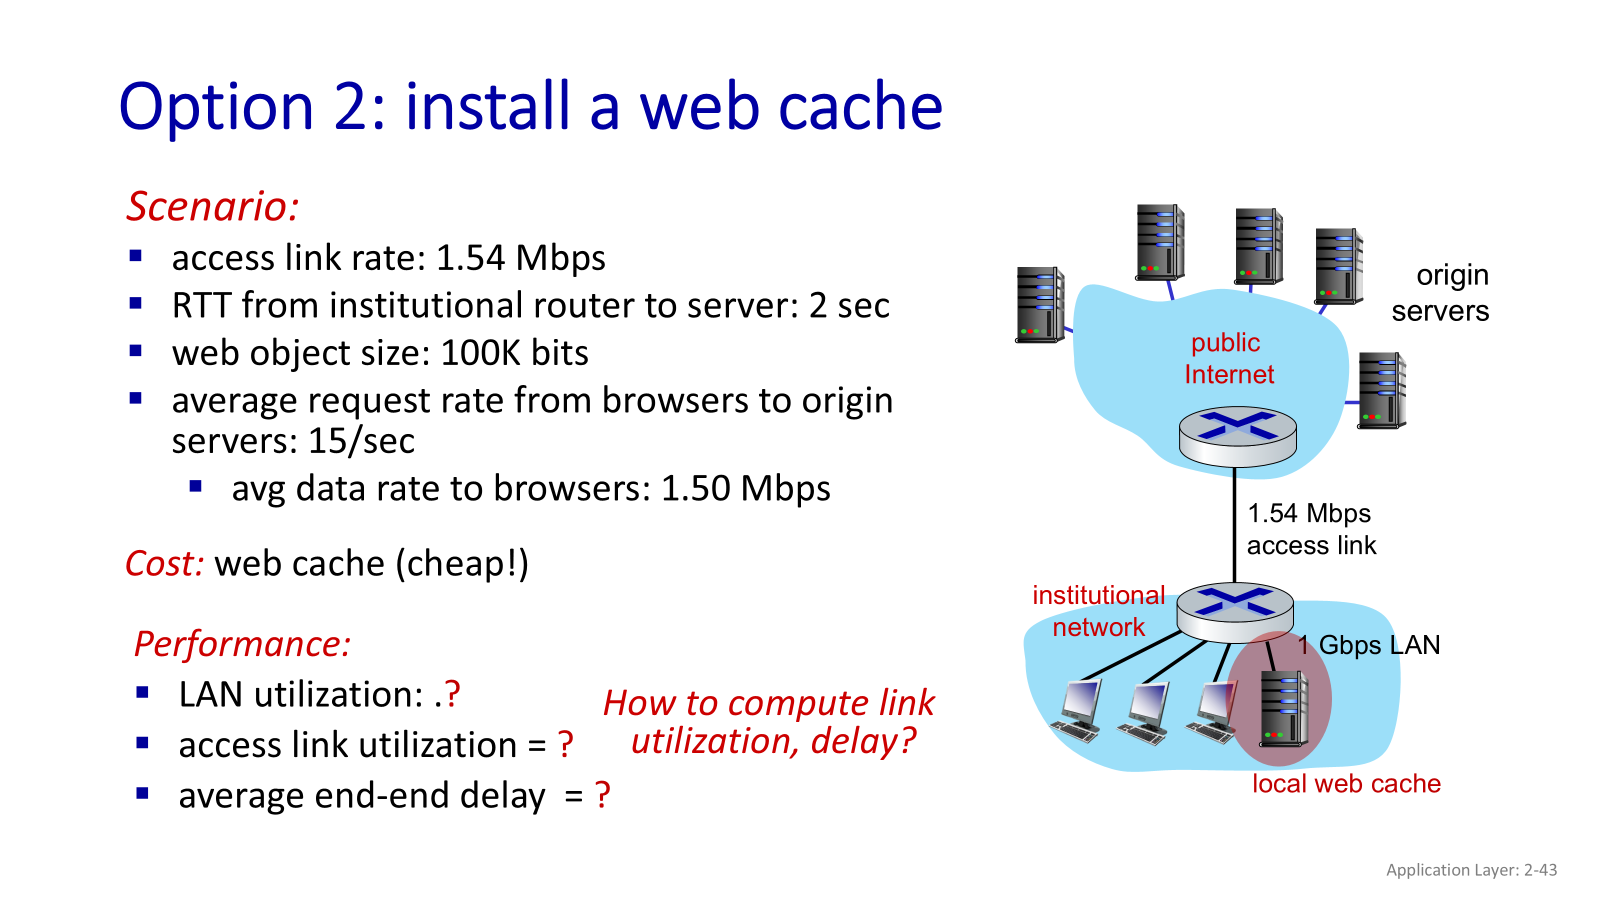
6.3.1 场景设定与问题分析
假设在一个机构网络中,存在以下条件:
- 平均请求的对象大小为 100 kbits。
- 网络内用户每秒向外部服务器发起 15次 请求。
- 由此产生的平均流量速率为:。
- 该机构的互联网接入链路带宽为 1.54 Mbps。
- 从机构的出口路由器到原始服务器再返回的互联网延时(RTT)为 2秒。
- 内部局域网(LAN)的延时非常小,假设为 10毫秒。
在这种情况下,总的响应时间由三部分构成:局域网延时、接入链路延时和互联网延时。
问题的症结在于接入链路。我们可以计算它的流量强度(Traffic Intensity, ):
流量强度接近于1,意味着链路几乎完全饱和。根据排队理论,当流量强度 时,排队延迟会急剧增大,趋近于无穷大。这里补充一个简化的排队延迟计算公式,它可以帮助我们理解这一现象: 其中 是流量强度, 是分组的长度, 是链路带宽,因此 是一个分组的传输时间。从公式中可以看出,当 趋近于1时,分母 趋近于0,导致 变得非常巨大。
此时,排队延迟成为总延迟中的主导(Dominating)部分。假设此时的排队延迟高达2分钟。那么用户的总响应时间大约是:10毫秒 + 2分钟 + 2秒。用户点击一个链接后,需要等待两分多钟才能看到页面。
教师分享了一个有趣的说法,早期的万维网(WWW, World Wide Web)被戏称为“World Wide Wait”(全球等待),生动地描述了这种糟糕的用户体验。
张渊课程
Scenario:
- access link rate: 1.54 Mbps
- RTT from institutional router to server: 2 sec
- web object size: 100K bits
- average request rate from browsers to origin servers: 15/sec
- avg data rate to browsers: 1.50 Mbps
Performance:
- access link utilization = .97
- LAN utilization: .0015
- end-end delay = Internet delay + access link delay + LAN delay = 2 sec + minutes + usecs
problem: large queueing delays at high utilization!
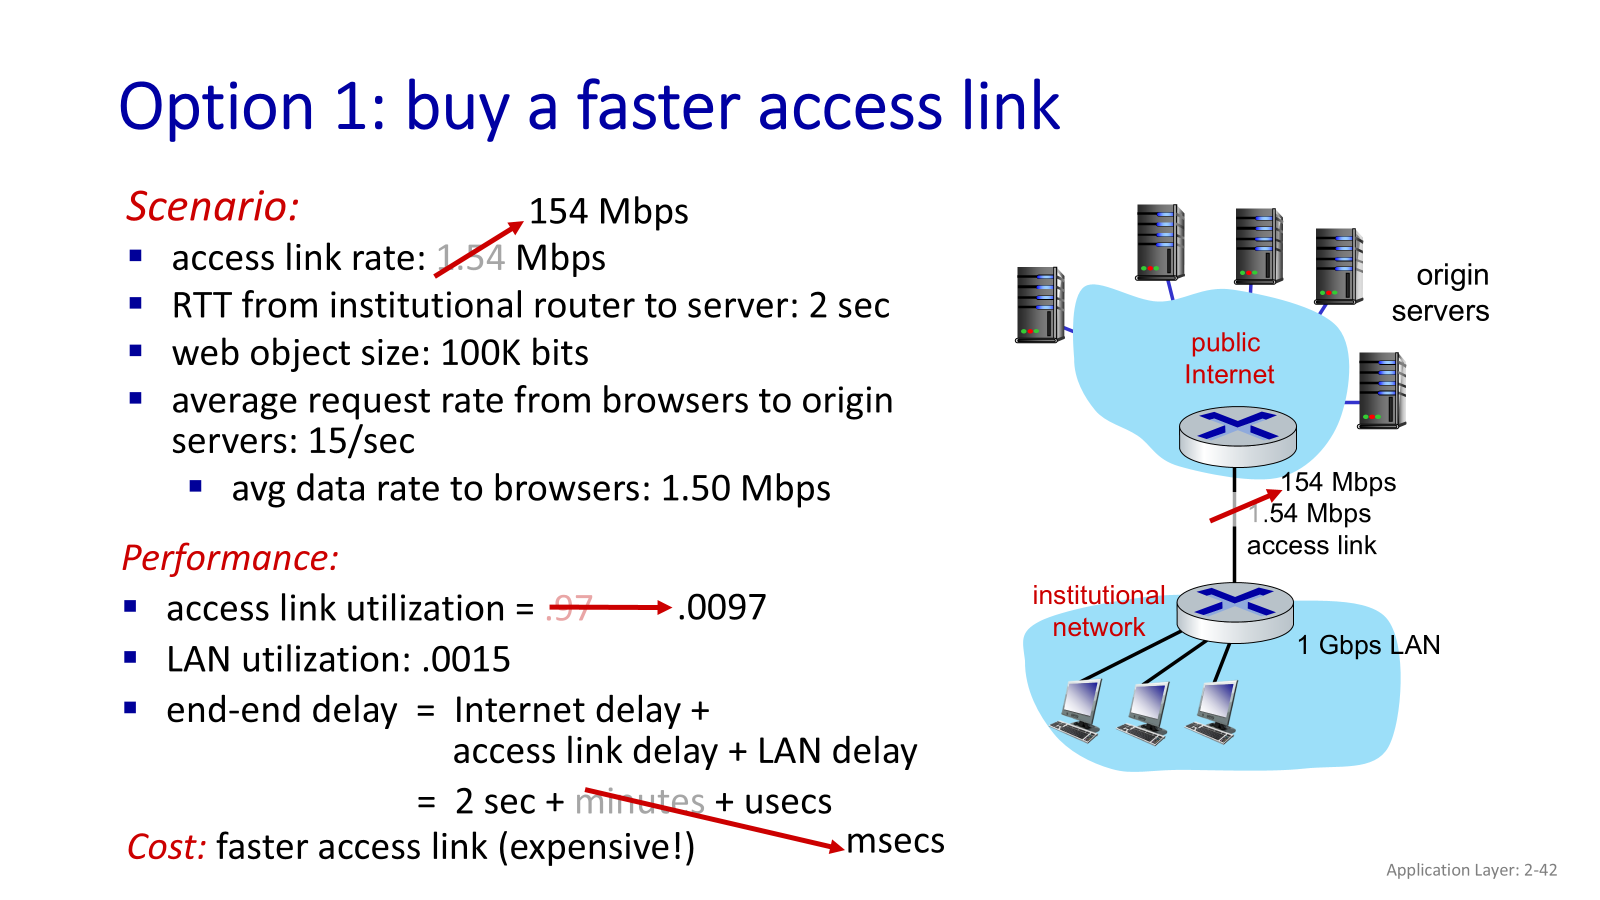
6.3.2 解决方案一:升级接入链路(“土豪”方案)
最直接的办法是解决瓶颈问题。我们可以将接入链路的带宽从1.54 Mbps升级100倍,达到154 Mbps。
在这种“土豪”方案下,新的流量强度变为:
流量强度骤降,排队延迟几乎可以忽略不计。此时总的响应时间约为:10毫秒 + 2秒 ≈ 2秒。
这个方案虽然有效,但代价极其高昂。带宽是需要按月支付的持续性开销,成本可能是原来的90到100倍。这让网络的所有者难以接受,于是网络主管需要寻找一个一次性投入、成本更低的解决方案。
Slides From 张渊
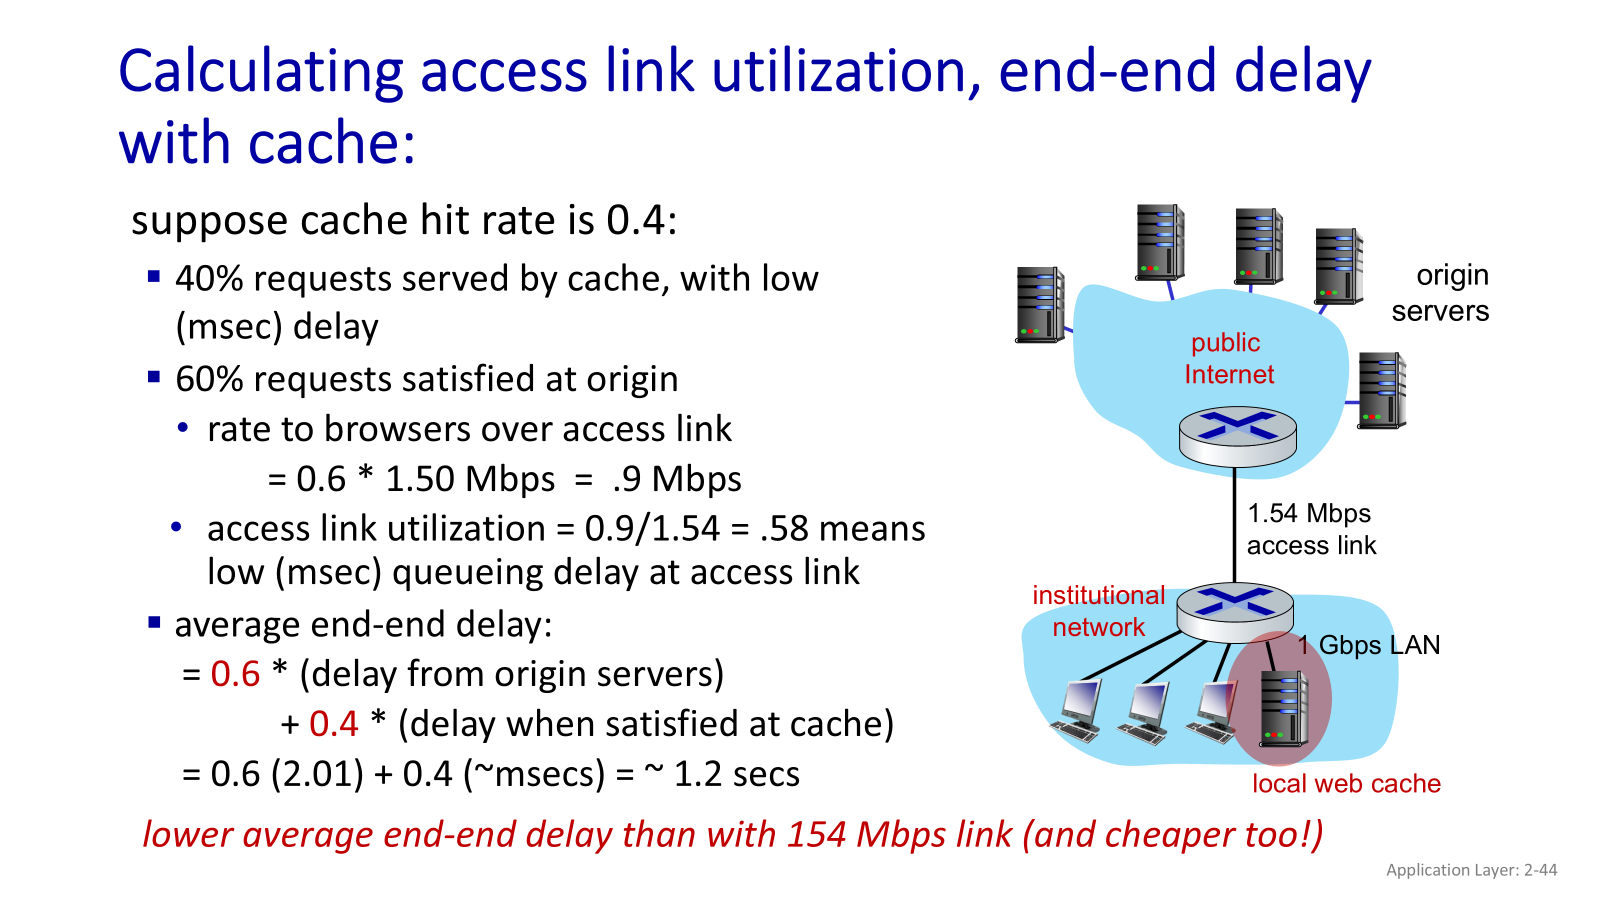
6.3.3 解决方案二:安装本地Web缓存
一个更聪明的办法是在局域网内部署一台Web缓存服务器。
假设该缓存能实现 40%的命中率。这意味着:
- 40%的请求在本地被满足(Hit)。
- 其余60%的请求需要通过接入链路从原始服务器获取(Miss)。
现在我们来计算平均响应时间,它由两部分加权平均得到:
- (命中延时): 仅为局域网内部的延时,约 10毫秒,非常小。
- (未命中延时): 需要经过局域网、接入链路和互联网。
关键在于,现在通过接入链路的流量减少了。新的流量速率仅为原来的60%:
此时接入链路的流量强度为:
流量强度为0.58时,排队延迟处于一个很低的水平。在未命中的情况下,占主导的延迟变回了2秒的互联网延时。
因此,平均响应时间为:
这个方案不仅将响应时间从2分多钟缩短到了1.2秒,甚至比花费巨资升级带宽的方案(2秒)效果更好。这是一个一次性投入、成本低廉且高效的解决方案,让用户、老板和网络管理员都感到满意,只有ISP(运营商)的扩容计划落空了。
Slides From 张渊
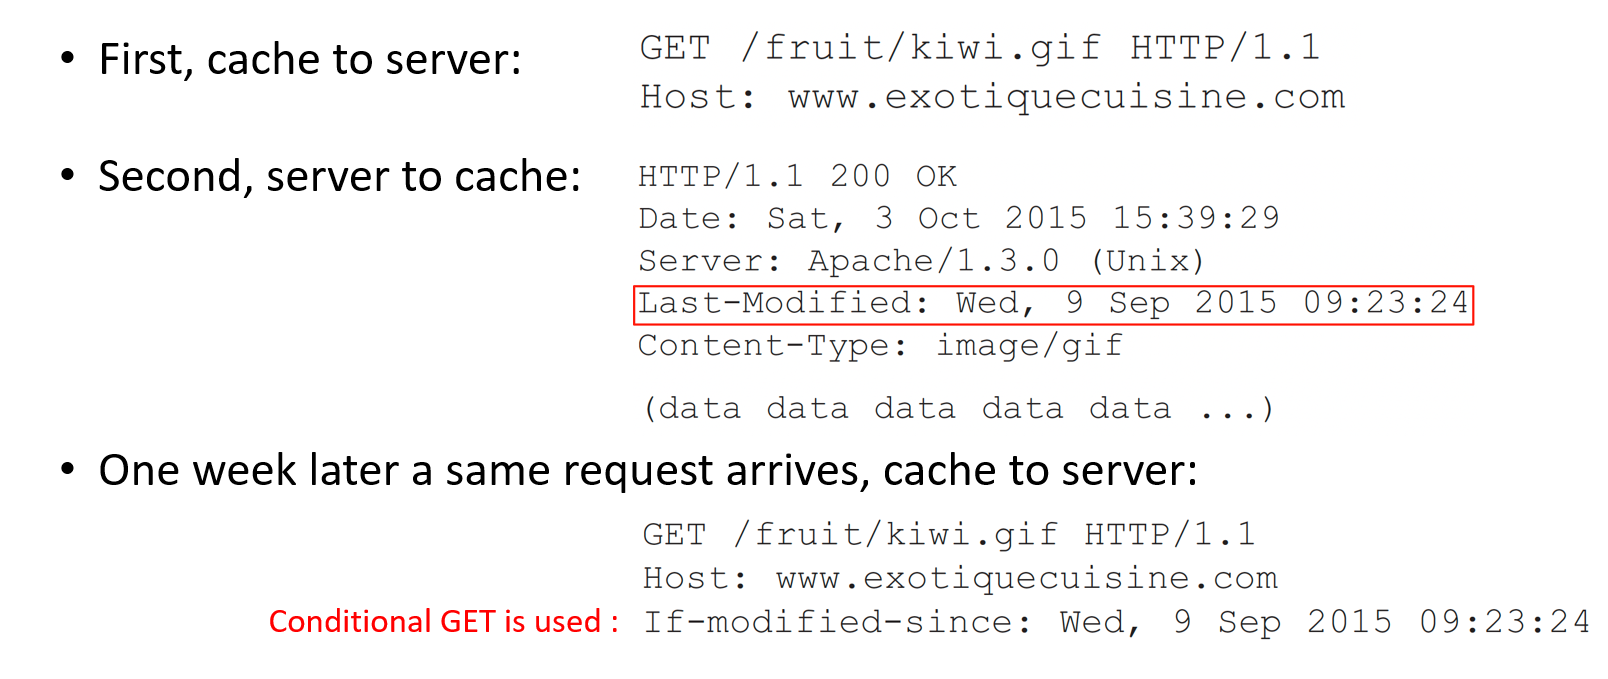
6.4 保持缓存同步:条件GET方法 Conditional GET
使用缓存会引入一个新的问题:版本一致性。如果原始服务器上的对象更新了,而缓存中的副本还是旧的,用户就会获取到过期的内容。
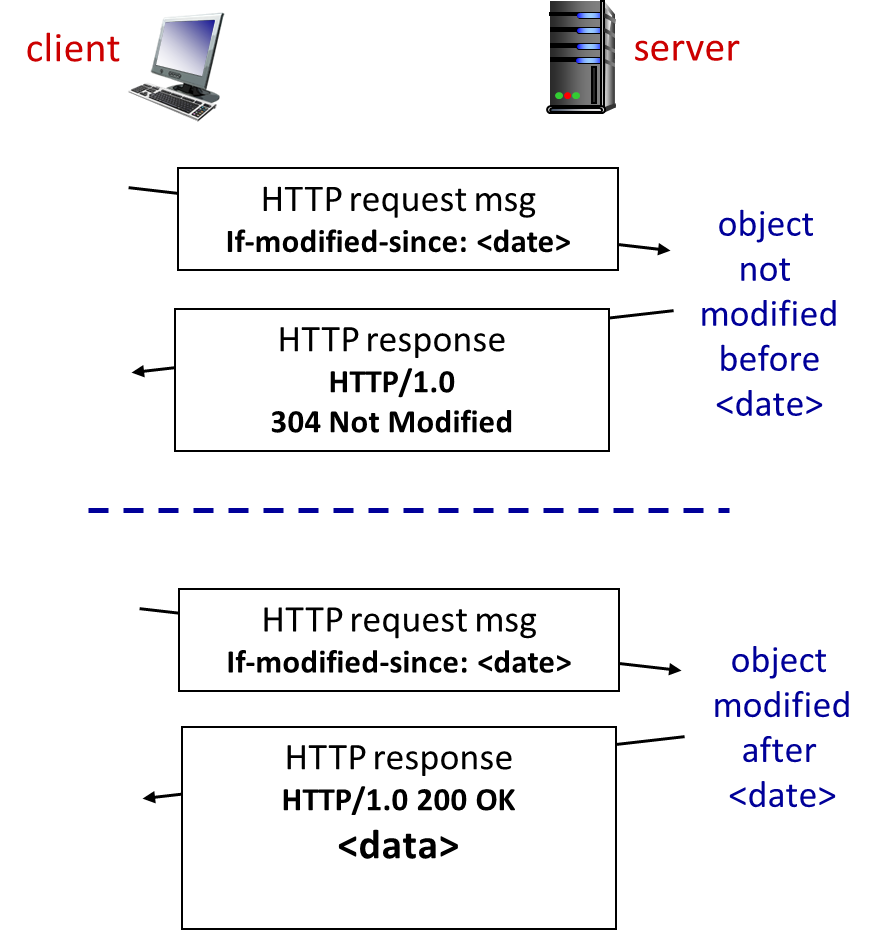
HTTP协议通过一种叫做“条件GET”(Conditional GET)的机制来解决这个问题。
工作流程如下:
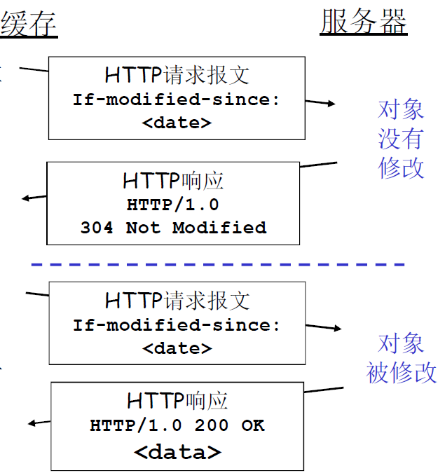
- 缓存服务器在第一次获取某个对象时,会一并存储服务器响应头中的
Last-Modified时间戳。 - 当再有用户请求该对象时,缓存服务器会向原始服务器发送一个特殊的GET请求,其中包含一个首部行:
If-Modified-Since: <date>。这里的<date>就是上次存储的时间戳。 - 原始服务器收到请求后会进行比较:
- 如果发现对象在该时间戳之后没有被修改,服务器就不会发送完整的对象数据,而是返回一个状态码为
304 Not Modified的轻量级响应。缓存得知其副本仍然有效,便直接返回给用户。 - 如果对象已经被修改,服务器则会返回一个标准的
200 OK响应,并在报文主体中附上最新的对象内容。缓存接收后,会用新版本更新本地副本,并将其返回给用户。
- 如果发现对象在该时间戳之后没有被修改,服务器就不会发送完整的对象数据,而是返回一个状态码为
Goal: don’t send object if cache has up-to-date cached version
- no object transmission delay (or use of network resources)
- client: specify date of cached copy in HTTP request【这里存储的就是之前
Last-Modified首部行的内容】 If-modified-since:<date> - server: response contains no object if cached copy is up-to-date: HTTP/1.0 304 Not Modified
6.4.1 To verify if cached contents are up-to-date
7 FTP协议
7.1 FTP的基本工作原理
FTP协议的核心功能是在本地主机和远程主机之间传输文件。这包括将本地文件上传(upload)到服务器,或从服务器下载(download)文件到本地。
7.1.1 客户端/服务器模式
FTP采用的是经典的客户/服务器(Client/Server)模式。
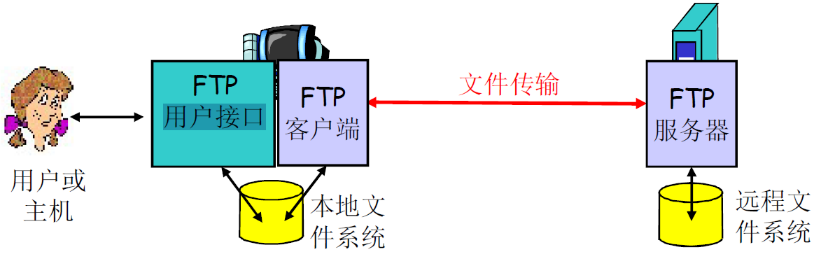
- 客户端 (Client): 是发起文件传输请求的一方。它包括用户界面和与本地文件系统交互的功能。
- 服务器 (Server): 是远程主机,负责接收客户端的请求,并提供文件存取服务。
根据RFC 959标准定义,FTP服务器通常运行在一个守护进程中,监听着著名的TCP端口号21,等待客户端前来建立连接。
| 项目 | 说明 |
|---|---|
| 用处 | 向远程主机上传输文件或从远程主机接收文件 |
| 网络架构 | 客户/服务器模式 客户端:发起传输的一方;服务器:远程主机 |
| 协议 | ftp: RFC 959 |
| 端口号 | ftp服务器:端口号为21 |
7.2 FTP独特的双连接机制
FTP协议最显著的特点是它将控制连接和数据连接分开处理。
7.2.1 1. 控制连接 (Control Connection)
首先,FTP客户端会主动向FTP服务器的TCP 21号端口发起连接请求。一旦服务器接受,两者之间就会建立一个TCP连接,这个连接被称为控制连接。
这个控制连接贯穿整个会话期间,主要负责传输控制信息,其核心功能包括:
- 身份认证: 连接建立后,客户端需要通过此连接发送用户名(
USER)和口令(PASS)进行身份验证。老师特别提到,在像FTP这样的早期协议中,用户名和口令通常是明文传输的,这意味着使用抓包工具可以轻易截获这些信息,安全性较低。 - 发送命令: 认证通过后,客户端可以通过控制连接向服务器发送各种命令,例如
LIST(列出当前目录的文件列表)、RETR(下载文件)、STOR(上传文件)等。
7.2.1.1 关于TCP连接建立的补充说明
老师在此处穿插了一个关于TCP连接如何建立的说明。他解释说,从应用层的视角来看,我们暂时不必深究底层细节。可以将其理解为:两个应用进程按照预定的规则和次序,调用了一系列Socket API(套接字应用程序接口),之后一个TCP连接就“神秘地”建立起来了。
传输层为上层应用提供了这些API原语,应用开发者只需按规则调用即可。至于连接建立的具体过程(如三次握手、状态维护等),这是TCP协议自身的工作,将在后续讲解传输层时进行详细剖析。这符合课程“自顶向下”的讲解顺序。
7.2.2 2. 数据连接 (Data Connection)
当服务器收到一个需要传输文件的命令时(例如客户端请求下载一个文件),它会执行一个非常特别的动作。
服务器会主动地向客户端发起一个新的TCP连接,这个连接专门用于传输文件数据,因此被称为数据连接。通常,服务器会连接到客户端的20号端口来建立这个数据连接。
文件内容会通过这个新建立的数据连接进行传输。一旦文件传输完成,服务器就会关闭这个数据连接。但此时,原有的控制连接并不会关闭,它仍然保持活动状态,以便客户端可以继续发送新的命令(例如,下载另一个文件)。
7.3 FTP协议的核心特性
7.3.1 带外(Out-of-Band)控制
由于FTP的控制命令和实际的文件数据是在两个独立的TCP连接上传输的,我们称其控制信息是带外(Out-of-Band) 传送的。“带内”通常指数据传输的通道,而“带外”则指用于传输控制信令的独立通道。
这一点与我们之前学习的HTTP协议形成了鲜明对比。HTTP的请求、响应头(控制信息)和响应体(数据)都在同一个TCP连接中传输,因此HTTP是**带内(In-Band)**控制。
7.3.2 有状态协议(Stateful Protocol)
FTP是一个有状态的协议。服务器需要为每一个连接的客户端维护状态信息。这意味着服务器必须记住:
- 当前登录的用户是谁。
- 用户当前所在的远程目录是哪一个。
服务器需要将用户的账户信息、当前路径与对应的控制连接关联起来。
这同样也是与HTTP的一个显著区别。HTTP协议在初始设计时是无状态的,服务器不会记录任何客户端的信息。后来为了实现类似购物车等功能,才通过引入Cookie等技术“打补丁”,使其能够维护状态。而FTP天然就是一个有状态的协议。
7.4 FTP命令与响应示例
在控制连接上传输的命令和服务器返回的响应都是基于ASCII文本的,这使得协议相对直观易懂。
7.4.1 命令样例 (Commands)
USER username: 提供用户名。PASS password: 提供口令。LIST: 请求服务器返回当前目录下的文件和文件夹列表。RETR filename: 从服务器检索(下载)一个文件(gets)。STOR filename: 向服务器存储(上传)一个文件(puts)。
关于上传/下载的定义: 老师强调,“上传”和”下载”这两个术语通常是以客户端的视角来定义的。客户端向服务器发送文件称为上传,客户端从服务器接收文件称为下载。
7.4.2 返回码示例 (Response Codes)
服务器的响应也遵循“状态码 + 状态信息”的格式,这与HTTP类似。
331 Username OK, password required: 用户名正确,需要输入密码。125 data connection already open; transfer starting: 数据连接已打开,即将开始传输。425 Can't open data connection: 无法打开数据连接。452 Error writing file: 写入文件时发生错误。
7.4.3 2.3.4 FTP协议 vs HTTP协议
- FTP协议是有状态的
- FTP协议的控制命令和数据传输分别在两个TCP上进行(HTTP在一个TCP上进行)
8 电子邮件 (Email) 应用
8.1 电子邮件系统的三大组成部分
一个完整的电子邮件系统主要由三个核心部分构成:
- 用户代理 (User Agent)
- 邮件服务器 (Mail Server)
- 相关协议 (如 SMTP, POP3, IMAP 等)
There are three major components:
- User Agents: The software you use to read, compose, and manage emails (e.g., Microsoft Outlook, Gmail app).
- Mail Servers: These servers store incoming and outgoing emails. Each user has a mailbox on a mail server. They also have a queue for outgoing messages.
- Simple Mail Transfer Protocol (SMTP): The protocol used for sending emails from one mail server to another. It’s also used to send an email from a user agent to its mail server.
8.1.1 1. 用户代理 (User Agent)
用户代理就是我们通常所说的电子邮件客户端软件,它也被称为“邮件阅读器”。它的主要功能是帮助用户撰写、编辑、发送和阅读邮件。常见的用户代理软件有 Microsoft Outlook、Foxmail 等。
老师在这里做了一个类比,以帮助我们更好地理解“代理”这个概念:
- Web应用的用户代理是: 浏览器 (Browser)。
- FTP应用的用户代理是: FTP客户端软件。
- Email应用的用户代理是: 邮件客户端软件 (如 Outlook)。
这些软件是我们与相应网络应用(Web、FTP、Email)进行交互的媒介,它们代表用户去执行底层的协议动作。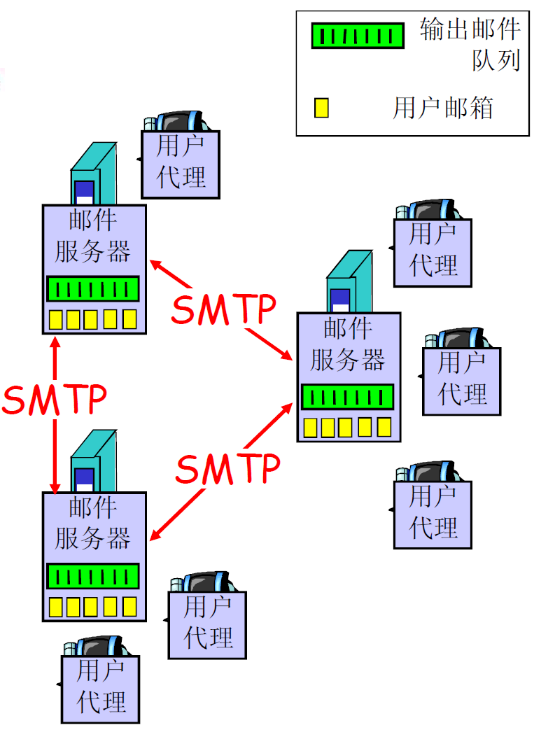
- a.k.a. “mail reader”
- composing, editing, reading mail messages
- e.g., Outlook, iPhone mail client
8.1.2 2. 邮件服务器 (Mail Server)
mail servers:
- outgoing, incoming messages stored on server
- mailbox contains incoming messages for user
- message queue of outgoing (to be sent) mail messages
邮件服务器是在网络上持续运行的、专门处理邮件的计算机程序。它扮演着两个关键角色:
- 发送邮件: 当用户通过用户代理发送邮件时,邮件首先被发送到用户的邮件服务器。服务器会将这封邮件放入一个“输出报文队列”(Outgoing Message Queue)中进行排队。然后,服务器会处理这个队列,将邮件一封封地发送给对应的目标邮件服务器。
- 接收邮件: 当邮件服务器收到一封发送给其用户的邮件时,它会将这封邮件存放到该用户的专属“邮箱”(Mailbox)中。邮箱本质上是服务器上为每个用户划分的存储区域。
8.1.3 3. 相关协议
SMTP protocol between mail servers to send email messages
- client: sending mail server
- “server”: receiving mail server
电子邮件系统依赖于一套协议协同工作,主要分为“推”协议和“拉”协议。
- 发送(推)协议 - SMTP: 简单邮件传输协议(Simple Mail Transfer Protocol, SMTP)是核心的发送协议。它负责将邮件从用户代理“推送”到邮件服务器,以及从一个邮件服务器“推送”到另一个邮件服务器。
- 读取(拉)协议 - POP3, IMAP, HTTP: 当邮件到达接收方的邮件服务器并存入邮箱后,接收者需要通过他的用户代理将邮件从服务器上取回。这个过程是一个“拉取”的动作,所使用的协议包括 POP3 (邮局协议第3版)、IMAP (互联网消息访问协议),甚至 HTTP 也可以用于拉取邮件。
8.2 邮件的完整传输流程:“两推一拉”
整个邮件的生命周期可以概括为两个“推”的阶段和一个“拉”的阶段。
- 第一段(推): 发送方的用户代理使用 SMTP 协议,将写好的邮件推送到自己的邮件服务器。
- 第二段(推): 发送方的邮件服务器使用 SMTP 协议,将邮件推送到接收方的邮件服务器。
- 第三段(拉): 接收方的用户代理使用 POP3 或 IMAP 等协议,从其邮件服务器的邮箱中将邮件拉取到本地进行阅读。
8.3 深入了解 SMTP 协议 [RFC 2821]
SMTP 是电子邮件系统的基石,用于在服务器之间直接传输邮件。
8.3.1 SMTP 的基本特性
| 项目 | 内容 |
|---|---|
| 使用协议 | TCP |
| 网络架构 | C/S |
| 端口号 | 25 |
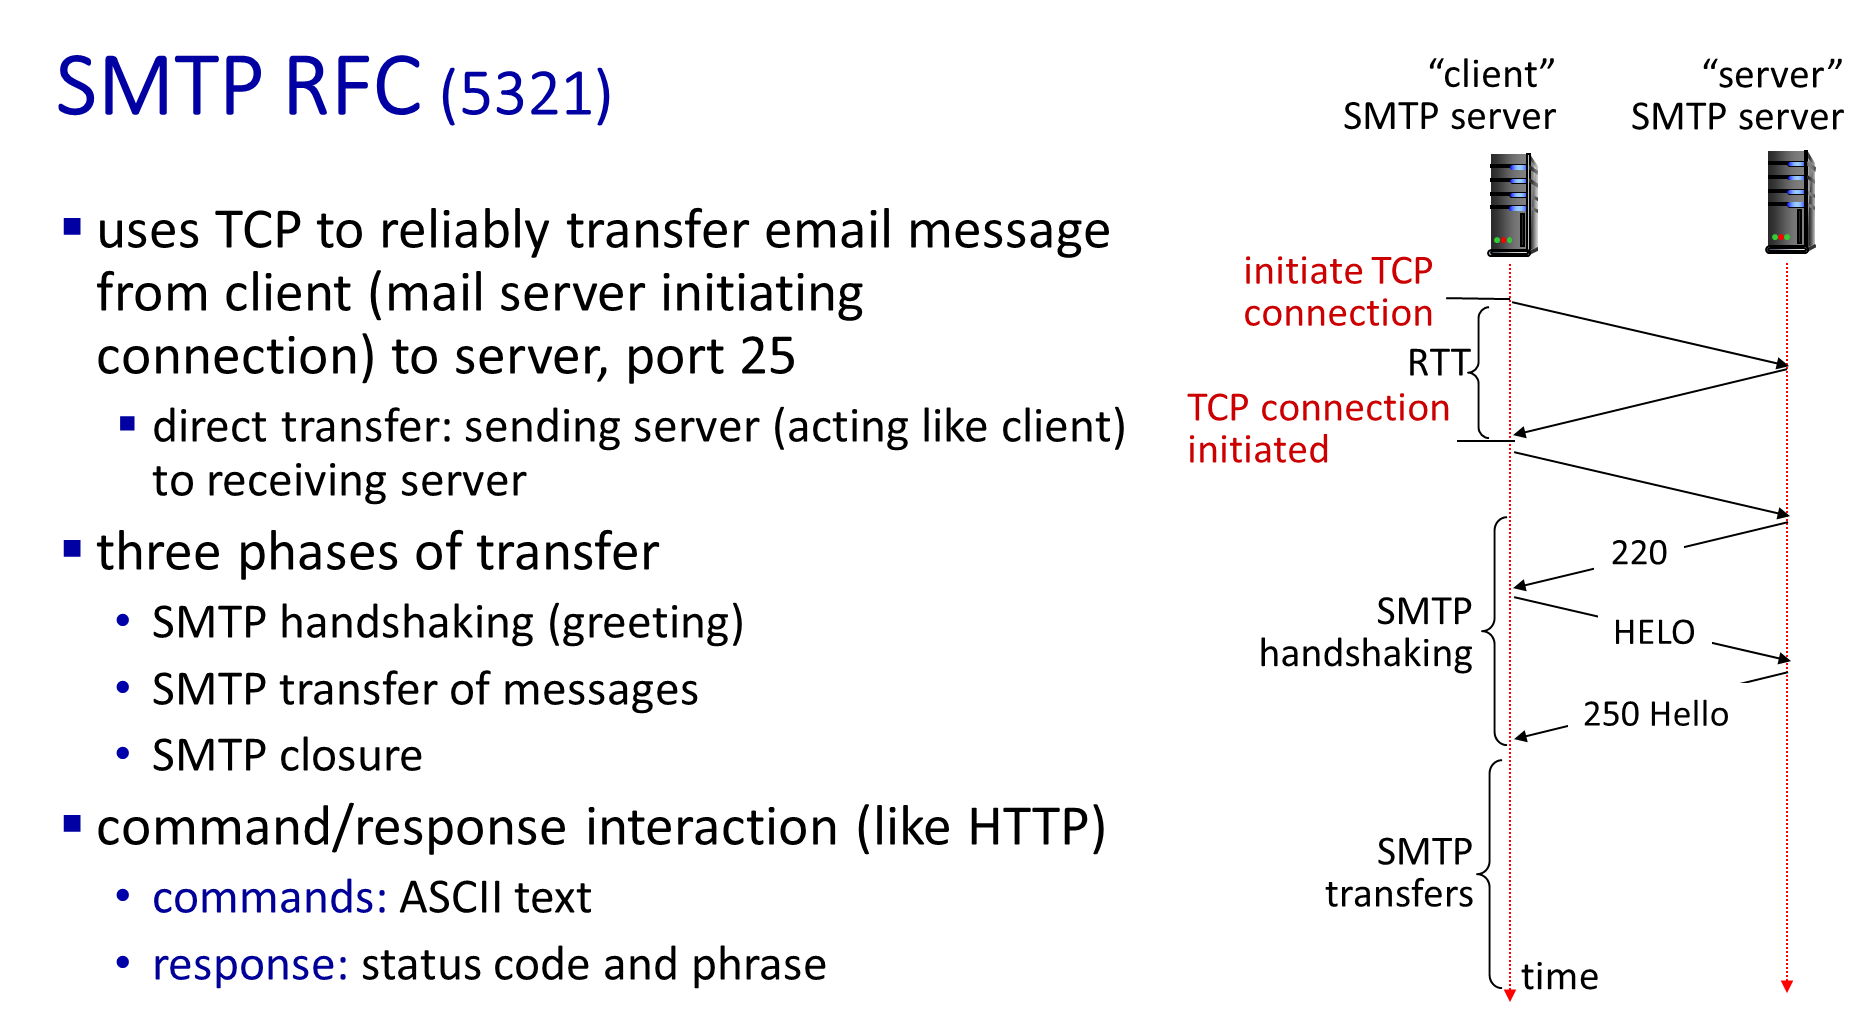
- 传输层协议: SMTP 使用 TCP 来确保邮件报文传输的可靠性。
- 端口号: SMTP 服务器默认监听在 25 号端口。
- 传输阶段: 一次完整的 SMTP 传输过程包含三个阶段:握手(建立连接)、传输报文(发送邮件内容)、关闭(释放连接)。【注意SMTP一般不用中间邮件服务器发送邮件,即使是在地球两段两个邮件服务器也是直接相连。如果目标邮件服务器没有开机,则可能在本地暂存后再尝试发送】
- 命令与响应: SMTP 是一个基于文本的协议。客户端发送 ASCII 文本命令,服务器返回包含状态码和状态信息的 ASCII 文本响应。老师指出,这种文本形式的好处是协议交互非常直观,通过抓包工具可以直接读懂通信内容。
- 命令:ASCII文本
- 响应:状态码和状态信息
PPT原本
- uses TCP to reliably transfer email message from client (mail server initiating connection) to server, port 25
- direct transfer: sending server (acting like client) to receiving server
- three phases of transfer
- SMTP handshaking (greeting)
- SMTP transfer of messages
- SMTP closure
- command/response interaction (like HTTP)
- commands: ASCII text
- response: status code and phrase
AI总结:
- SMTP uses TCP on port 25 to ensure reliable data transfer.
- The transfer process has three phases:
- TCP Connection: A standard TCP connection is established.
- Handshaking: The client and server introduce themselves with SMTP commands (like
HELO). - Transfer of Messages: The email message is sent. The connection is then closed.
- Like HTTP, SMTP commands are text-based and human-readable, and it uses status codes to indicate success or failure.
8.3.2 7位 ASCII 码限制
SMTP 协议有一个源自其早期设计的严格规定:邮件报文(包括头部和正文)必须是 7 位 ASCII 码。一个字节有8个比特,7位 ASCII 码意味着最高位必须为0。
这个限制意味着原始的 SMTP 协议只能传输英文这类可打印字符,无法直接传输中文内容或二进制文件(如图片、可执行文件等)。老师提到,为了解决这个问题,后来通过“打补丁”的方式引入了新的标准(如 MIME),我们稍后会了解到。
8.3.3 示例:Alice 给 Bob 发送邮件
下面我们通过一个实例来完整地看一下邮件的传输流程: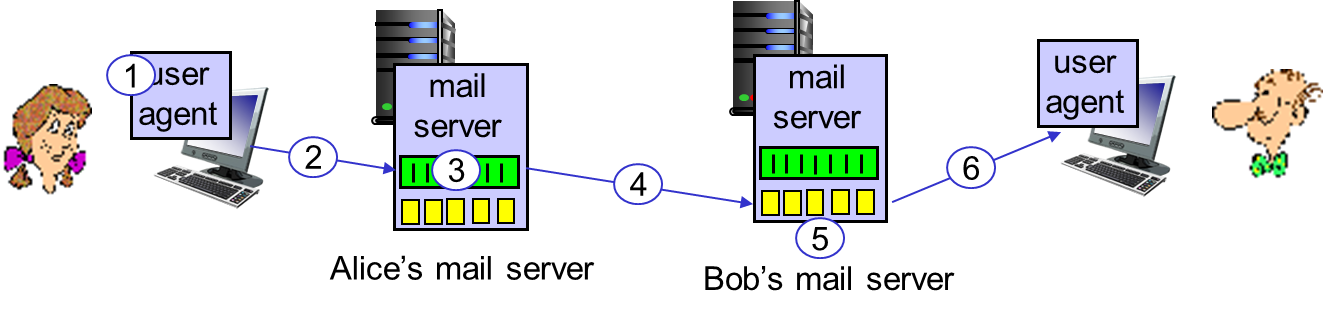
- Alice 使用她的用户代理(如 Outlook)撰写一封邮件给
bob@someschool.edu。 - Alice 的用户代理通过 SMTP 将邮件发送到她自己的邮件服务器(例如
alice@crepes.fr的服务器)。邮件被放入服务器的输出队列中。 - Alice 的邮件服务器作为 SMTP 客户端,向 Bob 的邮件服务器 (
someschool.edu) 的25号端口发起一个 TCP 连接。 - 连接建立后,Alice 的服务器通过这个 TCP 连接,使用 SMTP 命令将邮件内容发送过去。
- Bob 的邮件服务器收到邮件后,将其存放到 Bob 的邮箱中。
- 一段时间后,Bob 打开他的用户代理,用户代理通过 POP3 或 IMAP 协议连接到他的邮件服务器,并将新邮件从邮箱中拉取下来供他阅读。
- Alice uses UA to compose e-mail message “to” bob@someschool.edu
- Alice’s UA sends message to her mail server using SMTP; message placed in message queue
- client side of SMTP at mail server opens TCP connection with Bob’s mail server
- SMTP client sends Alice’s message over the TCP connection
- Bob’s mail server places the message in Bob’s mailbox
- Bob invokes his user agent to read message
为什么邮件服务器需要一个输出队列?
老师解释了两个原因:
- 流量平滑: 服务器可能为成千上万的用户服务,瞬间收到的待发邮件可能很多,超出了其即时发送能力。队列可以起到缓冲作用,让服务器按照自己的节奏处理邮件。
- 效率优化: 服务器可以设置为周期性地(如每隔几分钟)集中处理一次队列中的邮件,而不是来一封就立刻发送一封。这可以避免服务器时刻处于待命状态,节省系统资源,尤其是在邮件量不大的情况下。
8.3.4 简单的 SMTP 交互过程
下面是两个邮件服务器之间一次典型的 SMTP 对话。其中 C: 代表客户端(发送方服务器),S: 代表服务器(接收方服务器)。
S: 220 hamburger.edu
C: HELO crepes.fr
S: 250 Hello crepes.fr, pleased to meet you
C: MAIL FROM: <alice@crepes.fr>
S: 250 alice@crepes.fr... Sender ok
C: RCPT TO: <bob@hamburger.edu>
S: 250 bob@hamburger.edu ... Recipient ok
C: DATA
S: 354 Enter mail, end with "." on a line by itself
C: Do you like ketchup?
C: How about pickles?
C: .
S: 250 Message accepted for delivery
C: QUIT
S: 221 hamburger.edu closing connection
老师特别指出,由于 MAIL FROM 的内容完全由客户端指定,且协议本身没有强制验证,因此伪造发件人地址在技术上是十分容易的。
8.4 SMTP 协议总结与 HTTP 比较
8.4.1 SMTP 核心特点总结
- 使用持久连接: 一个 SMTP 客户端(如科大的邮件服务器)与服务端(如谷歌的邮件服务器)建立连接后,可以连续发送多封邮件(例如,多个科大用户发给多个谷歌用户的邮件),直到所有邮件发送完毕再关闭连接,提高了效率。
- 7位 ASCII 编码要求: 如前所述,整个邮件报文,包括首部和主体,都必须符合 7 位 ASCII 编码标准。
- 报文结束标记: SMTP 使用
CRLF.CRLF(即一个单独的英文句点.在一行)来标识邮件正文的结束。
8.4.2 SMTP vs. HTTP
comparison with HTTP:
- both have ASCII command/response interaction, status codes
- both HTTP 1.1+ and SMTP use persistent connections
| 特性 | HTTP | SMTP |
|---|---|---|
| 工作模式 | 拉 (Pull) | 推 (Push) |
| 协议形式 | 都是基于 ASCII 文本的命令/响应模式 | 都是基于 ASCII 文本的命令/响应模式 |
| 对象封装 | 每个响应报文最多只封装一个对象(如一个HTML文件或一张图片)。 | 一个报文(一封邮件)中可以包含多个对象(如文字正文和多个图片附件)。 |
| each object encapsulated in its own response message | SMTP: multiple objects sent in multipart message | |
| 结束的标志方法 | HTTP uses content-length header | SMTP server uses CRLF.CRLF to determine end of message |
| 特殊格式要求 | SMTP requires message (header & body) to be in 7-bit ASCII |
相同点:
- 应用层协议: 两者都是 TCP/IP 协议栈中的应用层协议。
- 传输层: 两者都使用 TCP 作为底层的传输协议,以实现可靠的数据传输。
- 命令格式: 两者都在控制连接中(非数据部分)使用文本命令(人类可读的 ASCII 文本)。
- 工作模式: 两者都采用客户端-服务器 (Client-Server) 的工作模式。
不同点:
| 特性 | HTTP (超文本传输协议) | SMTP (简单邮件传输协议) |
|---|---|---|
| 主要用途 | 用于从 Web 服务器**“拉取”(Pull)** 信息(如网页、图片)。 | 用于将邮件**“推送”(Push)** 到邮件服务器,或在邮件服务器之间推送邮件。 |
| 协议方向 | Pull 协议:绝大多数情况下,是客户端主动发起请求拉取数据。 | Push 协议:客户端(或发送方服务器)主动发起连接,将数据推送到服务器。 |
| 数据格式 | 可以传输多种格式的数据(HTML, JPEG 等)。 | 原始协议只支持 7-bit ASCII 文本。非 ASCII 数据(如图片、附件)必须通过 MIME 编码后才能发送。 |
| 中间环节 | 是一种端到端的协议(从客户端浏览器到服务器)。(缓存是优化手段,不是协议的必须环节) | 是一种存储-转发 (Store-and-Forward) 协议。邮件通常会经过多个邮件服务器的存储和转发。 |
| 连接持久性 | HTTP/1.1 默认使用持久连接,一个 TCP 连接可以传输多个对象。 | 一个 TCP 连接通常用于发送一封或多封邮件到_同一个_目标服务器,然后关闭。 |
8.5 自己尝试
可以尝试以下方式发送SMTP协议
telnet servername 25

see 220 reply from server

enter HELO, MAIL FROM, RCPT TO, DATA, QUIT

commands
8.6 邮件报文格式 (RFC 822)
SMTP: protocol for exchanging e-mail messages, defined in RFC 5321 (like RFC 7231 defines HTTP)
RFC 2822 defines syntax for e-mail message itself (like HTML defines syntax for web documents)
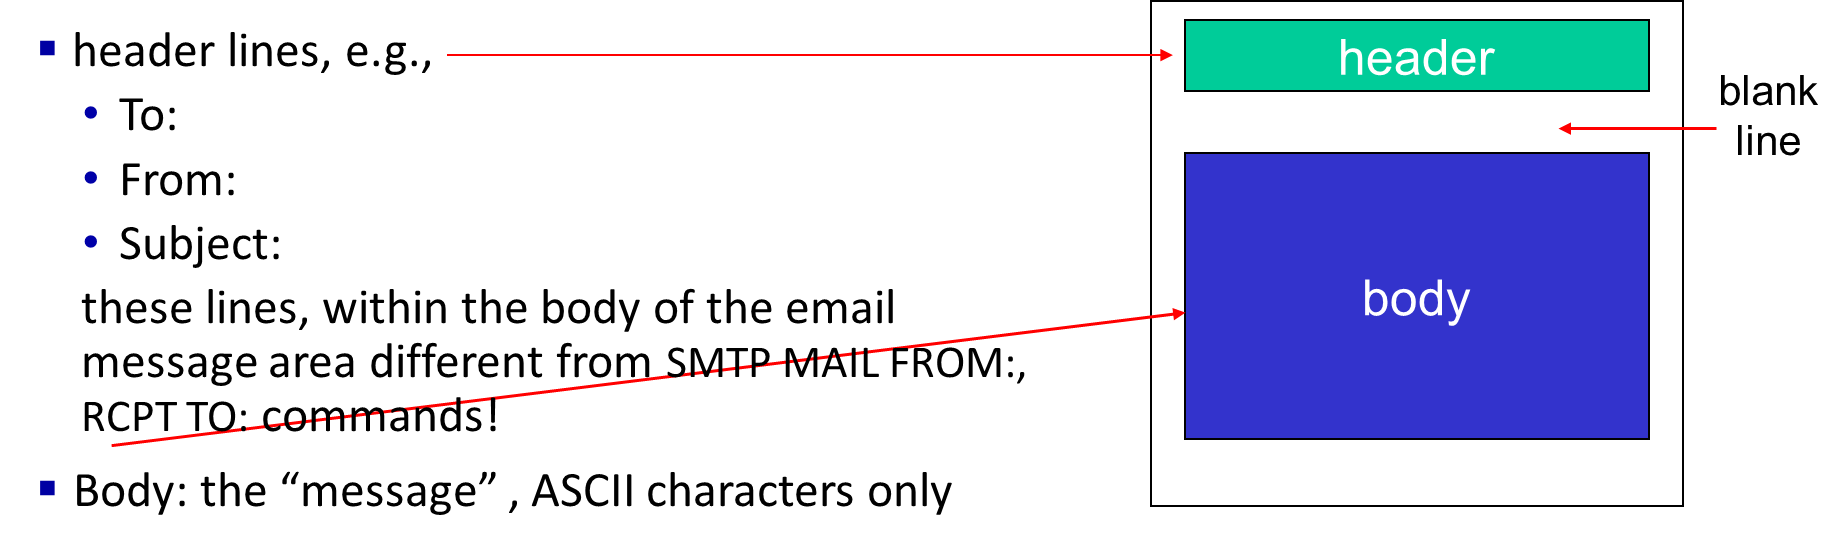
一封邮件本身也具有标准的格式,它与 SMTP 的协议命令是不同的概念。邮件格式主要由两部分组成,中间由一个空行隔开。
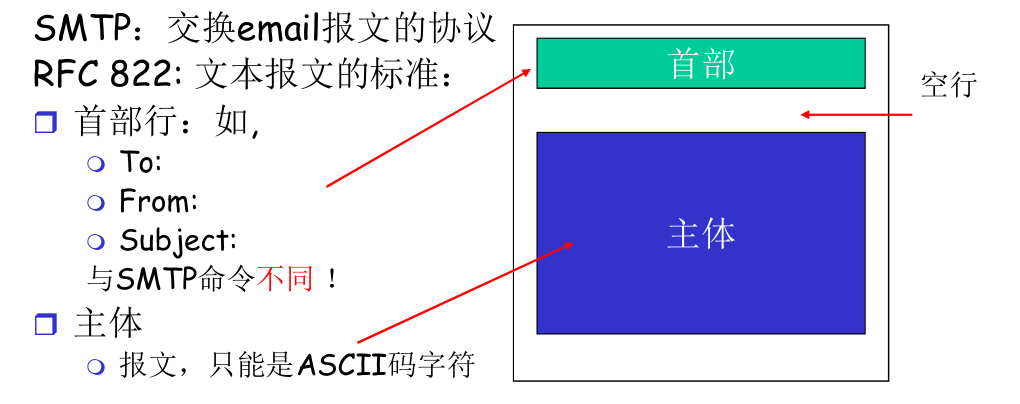
- 首部 (Header): 包含邮件的元数据,由一系列“头部字段”组成。这里的要区分前面
SMTP的握手协议。To:: 收件人地址。From:: 发件人地址。Subject:: 邮件主题。CC:(Carbon Copy, 抄送): 将邮件副本发送给其他人,所有收件人都能看到抄送列表。这通常用于告知相关人员。BCC:(Blind Carbon Copy, 暗抄送): 秘密地将邮件副本发送给其他人,其他收件人不知道该邮件也被发送给了这些人。
- 主体 (Body): 邮件的实际内容,在原始标准下只能是 ASCII 码字符。
8.7 报文格式的多媒体扩展 (MIME)
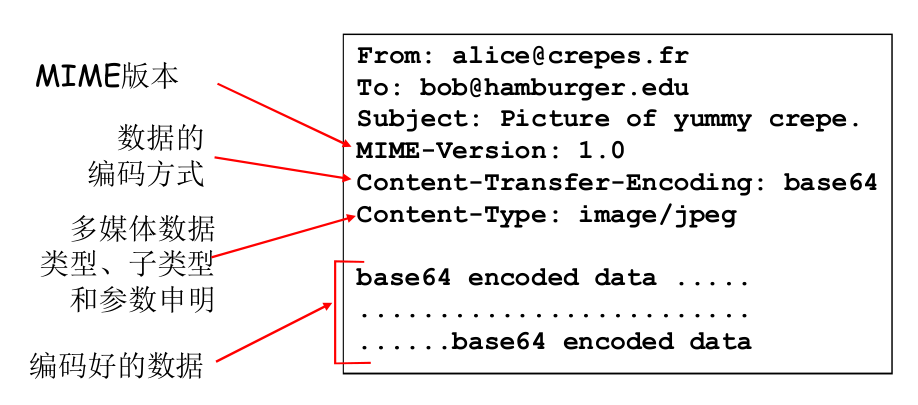
我们在上一节课了解到,原始的SMTP协议有一个核心限制:它只能传输7位ASCII码的文本内容。这引发了一个问题:我们如何发送包含中文字符、图片或可执行文件等非ASCII内容的邮件?
答案是通过一个名为MIME(Multimedia Mail Extension,多媒体邮件扩展) 的“补丁”来实现。MIME是一种标准,它对原始的邮件格式进行了扩展,使其能够支持多种数据类型。
- MIME:多媒体邮件扩展(multimedia mail extension), RFC 2045, 2056
- 在报文首部用额外的行申明MIME内容类型
8.7.1 Base64 编码
MIME的核心思想之一是对非ASCII数据进行编码。其基本逻辑是:将那些不在ASCII码范围内的字节序列(例如一个中文字符占用的两个字节),通过一个约定的映射关系,转换成一个更长的、但完全由标准ASCII字符组成的字符串。
最常用的编码方式是 Base64。
- 工作原理: Base64可以将任意的二进制数据编码成64个可打印的ASCII字符(包括A-Z, a-z, 0-9, + 和 /)。编码后的数据长度会略有增加,但其内容对于原始的SMTP协议来说是完全合法的。
- 传输过程: 发送方的邮件客户端使用MIME标准,将邮件中的非ASCII内容(如图片附件)用Base64进行编码。然后,这个编码后的纯文本字符串通过标准的SMTP协议进行传输。接收方的邮件客户端收到后,再使用Base64进行解码,将文本还原为原始的图片。
通过这种方式,即使底层的SMTP协议没有改变,我们也能传输任意类型的文件了。 常用Base64 对STMP的ASCII码进行拓展 传输更多内容
在邮件的头部,MIME会增加额外的行来声明内容类型,例如:
MIME-Version: 声明MIME的版本。Content-Type: 声明附件的类型,如image/jpeg。Content-Transfer-Encoding: 声明所使用的编码方式,如base64。
8.8 邮件访问协议
邮件访问协议就是用户代理从邮件服务器拉取邮件
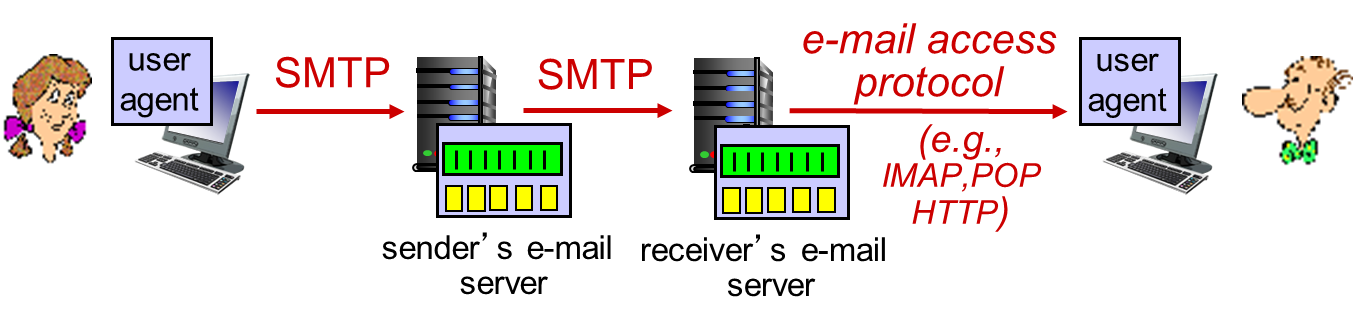
- SMTP: delivery/storage of e-mail messages to receiver’s server
- mail access protocol: retrieval from server
- IMAP: Internet Mail Access Protocol [RFC 3501]: messages stored on server, IMAP provides retrieval, deletion, folders of stored messages on server
- POP: Post Office Protocol: similar to IMAP.
- HTTP: gmail, Hotmail, Yahoo!Mail, etc. provides web-based interface on top of STMP (to send), IMAP (or POP) to retrieve e-mail messages
老师首先回顾了邮件投递的完整流程,即“两推一拉”模型:
- 推 (Push): Alice的用户代理通过SMTP将邮件推送至她的邮件服务器的发送队列。
- 推 (Push): Alice的邮件服务器通过SMTP将邮件推送至Bob的邮件服务器的邮箱中。
- 拉 (Pull): Bob的用户代理通过邮件访问协议,从他的邮箱中将邮件拉取下来。
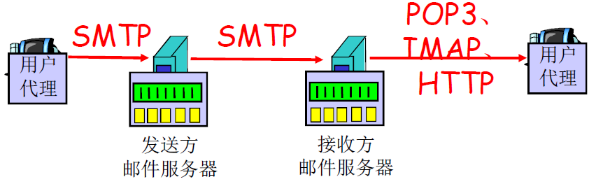
用于最后“拉”取阶段的协议主要有以下三种:
- POP3 (Post Office Protocol version 3): 邮局访问协议,是一个相对简单、用于下载邮件的协议。
- IMAP (Internet Mail Access Protocol): 互联网邮件访问协议,功能比POP3更强大和复杂,支持在服务器上直接管理邮件。
- HTTP (HyperText Transfer Protocol): 我们熟悉的HTTP协议也可以用于收发邮件,这是所有Webmail(网页邮箱,如Hotmail, Yahoo! Mail)的基础。
8.8.1 POP3 协议详解
POP3协议允许用户代理连接到邮件服务器,并将邮箱中的邮件下载到本地。其会话过程主要分为两个阶段。
# 用户确认阶段
S: +OK POP3 server ready
C: user bob
S: +OK
C: pass hungry
S: +OK user successfully logged on
# 事物处理阶段
C: list
S: 1 498
S: 2 912
S: .
C: retr 1
S: <message 1 contents>
S: .
C: dele 1
C: retr 2
S: <message 1 contents>
S: .
C: dele 2
C: quit
S: +OK POP3 server signing off
8.8.1.1 1. 用户确认阶段 (Authorization)
这是用户登录和身份认证的阶段。
- 客户端命令:
user [username]: 提供用户名。pass [password]: 提供口令。
- 服务器响应:
+OK: 命令成功。-ERR: 命令失败。
老师特别强调,原始的POP3协议以明文形式传输用户名和密码,这存在严重的安全隐患。在互联网发展的早期,使用者多为科研人员,对安全性的考虑尚不充分。
现代的解决方案是在传输层增加一个安全层(如SSL/TLS),将整个POP3会话加密,从而保护了应用层传输的明文密码。
8.8.1.2 2. 事务处理阶段 (Transaction)
认证成功后,客户端就可以执行一系列命令来处理邮箱中的邮件了。
list: 列出邮箱中所有邮件的编号和大小。retr [邮件编号]: 检索(Retrieve)并下载指定编号的邮件全文。dele [邮件编号]: 将服务器上的指定邮件标记为“待删除”。quit: 结束会话。当客户端发出quit命令时,服务器会永久删除所有被标记为“待删除”的邮件,然后关闭连接。
8.8.1.3 POP3 的两种工作模式
在邮件客户端软件中,通常可以设置POP3的两种不同工作模式:
-
下载并删除 (Download and Delete): 这是默认模式。邮件被下载到本地设备后,就会从服务器上删除。
- 优点: 不会占满服务器的邮箱空间。
- 缺点: 如果你在电脑上收取了邮件,服务器上的邮件就消失了,之后就无法在手机或平板等其他设备上再次看到这封邮件。
-
下载并保留 (Download and Keep): 客户端下载的是邮件的一个副本,原始邮件仍然保留在服务器上。
- 优点: 可以在多个不同的设备上访问同一封邮件。
- 缺点: 如果不定期清理,服务器上的邮箱可能会被塞满。
8.8.2 IMAP协议
- IMAP服务器将每个报文 与一个文件夹联系起来
- 允许用户用目录来组织 报文
- 允许用户读取报文组件
- IMAP在会话过程中保留 用户状态:
- 目录名、报文ID与目录名 之间映射
8.8.3 POP3 与 IMAP 的对比
IMAP协议是另一种主流的邮件访问协议,它比POP3提供了更多高级功能,两者之间最核心的区别在于邮件的管理方式。
| 特性 | POP3 | IMAP |
|---|---|---|
| 邮件管理 | 在本地管理邮件。将邮件从服务器下载到本地客户端进行组织。 | 在远程服务器上管理邮件。允许用户直接在服务器上创建、删除、重命名文件夹,并将邮件在不同文件夹间移动。 |
| 协议状态 | 无状态 (Stateless)。POP3协议本身不维护用户在远程的操作状态,因为它不支持远程文件夹等复杂操作。 | 有状态 (Stateful)。IMAP服务器必须维护用户的状态,例如用户当前正在查看哪个文件夹,以便正确响应用户的操作。 |
| 复杂度 | 简单 | 复杂,功能更强大 |
总的来说,IMAP提供了一种“云同步”的体验,你在任何设备上对邮件所做的操作(如移动到某个文件夹、标记为已读)都会被同步到服务器上,并在所有其他设备上得到体现。而POP3更像一个传统的邮局,你只需要把信取回家(下载到本地)即可。
9 DNS应用
9.1 DNS的出现和目的
9.1.1 DNS的必要性
网络层的设备,如主机和路由器,是通过IP地址来唯一标识和寻址的。无论是IPv4的32位地址还是IPv6的128位地址,它们本质上都是一长串数字。
尽管我们可以使用点分十进制(如 202.38.64.1)来简化记忆,但数字本身没有直观意义,对于人类来说依然非常不便记忆。
人类更倾向于使用有意义的、易于记忆的字符串来标识互联网上的设备。
- 例如:我们更容易记住邮件服务器地址
ustc.edu.cn,或者Web服务器地址www.ustc.edu.cn。这些字符串的每个部分都有特定含义(www代表万维网,ustc代表中国科学技术大学,edu代表教育机构,cn代表中国),非常直观。
因此,这就产生了一个根本性的需求:必须有一套系统,能够将人类习惯使用的、有意义的“字符串”(即域名)自动转换为机器能够理解和处理的“二进制网络地址”(即IP地址)。DNS系统就是为了满足这一需求而诞生的。
当一个应用(如浏览器)需要访问一个服务器时,它向下层(传输层)提交的必须是IP地址,而不是域名。DNS的核心任务就是完成这个转换。
- distributed database implemented in hierarchy of many name servers
- application-layer protocol: hosts, DNS servers communicate to resolve names (address/name translation)
- note: core Internet function, implemented as application-layer protocol (complexity at network’s “edge”)
- generally used by other app-level protocols e.g. HTTP, SMTP, FTP
9.1.2 DNS的历史
了解DNS的演进历史,可以帮助我们更好地理解其设计思想。
互联网的前身是ARPANET。在早期,ARPANET也需要解决名字解析的问题,它采用了一种非常简单的集中式方案:
- 主机名:所有主机的命名都处于同一个“平面”上,没有层次结构。例如,一个主机可能就叫
alice。 - 集中维护:存在一个中心维护站,负责管理一个名为
Hosts.txt的文件。这个文件记录了所有主机名到IP地址的映射关系。 - 获取方式:网络上的每台主机会定时地从这个中心站下载最新的
Hosts.txt文件,以更新自己的映射表。 随着ARPANET的规模不断扩大,这个方案的弊端也日益凸显: - 命名冲突:在一个平面的命名空间里,重名问题变得非常严重。当节点数增多,可能有很多主机都想叫
alice。如果为了区分而使用alice8898这样的名字,就又退回到了难记的数字,失去了命名的意义。 - 可扩展性差:单一的中心维护站成为了整个网络的性能瓶颈。随着主机数量的增加,解析请求的流量、服务器的负载都急剧增大。
- 维护困难:由于网络节点频繁增删,中心站需要时刻处理更新请求,这不仅维护工作量巨大,而且极易出错。
这个集中式的解决方案最终无法满足网络发展的需求。在互联网开放、共建的精神下,通过RFC(Request for Comments)文档的形式,大家献计献策,最终诞生了我们今天所使用的DNS系统。
9.1.3 DNS需要解决的问题
总的来说,设计一个新的域名系统,需要系统性地解决以下三个核心问题:
- 如何命名 (Naming):
- 如何为网络上的设备命名?关键在于要解决平面命名带来的重名问题。
- 解决方案的核心思路是采用“层次化命名”。
- 如何解析 (Resolution):如何完成从名字到IP地址的转换?
- 鉴于集中式方案的失败,必须采用“分布式”的思路。
- 这意味着需要设计一个由大量节点共同协作的系统,每个节点只负责维护一部分映射关系,共同响应查询。
- 如何维护 (Maintenance):这个系统必须是动态的。
- 当需要增加一个新的域(比如一个新公司成立),或者删除一个旧的域(比如公司倒闭了),应该如何高效、准确地在整个分布式系统中完成这些操作。
9.1.3.1 Challenges in Designing DNS
- Massive Scale: The system needs to store billions of records.
- Heavy Traffic: It must handle trillions of queries per day.
- Organizational Autonomy: Different organizations need to be able to manage their own hostname and IP address records without going through a central authority.
- Reliability and Security: The system must be robust and secure, as its failure could cripple the internet.
9.1.4 DNS的总体思路和功能
9.1.4.1 总体思路
现代DNS系统的主要设计思路如下:
- 分层的、基于域的命名机制:通过树状的层次结构来组织域名,从根本上解决了重名问题。
- 分布式的数据库:由遍布全球的大量域名服务器共同组成一个庞大的分布式数据库。这些服务器也按照树状结构组织,协同工作,完成名字到IP地址的转换。
- 基于UDP的应用服务:DNS主要运行在UDP协议之上,使用53号端口。选择UDP是因为DNS查询通常是“一问一答”的事务性请求,无需像TCP那样先建立连接,从而减少了延迟,提高了效率。
- 在网络边缘实现的核心功能:这是一个非常有趣且重要的特点。DNS无疑是互联网最核心的功能之一,但它并非在网络的“核心”(如骨干路由器)中实现,而是在网络的“边缘”,作为端系统(主机)上的一个应用层协议来实现的。这体现了互联网“将复杂性推向边缘”的设计哲学。
9.1.4.2 主要功能
DNS系统的主要目标和功能可以分为核心功能和其他重要功能。
核心功能:主机名到IP地址的转换
- 这是DNS最基本、最重要的功能,解决了最根本的“字符串”到“数字地址”的翻译问题。
其他功能:
- 主机别名 (Host Aliasing):一个实际的服务器可能会有一个非常复杂、用于内部管理的“规范名字”(Canonical Name),例如
west-coast.rack-5.blade-2.ibm.com。为了方便用户访问,可以为它设置一个简单的“别名”(Alias),例如www.ibm.com。DNS可以提供从别名到规范名字的转换服务。用户查询别名,DNS先返回其规范名字,再由规范名字查询得到最终的IP地址。 - 邮件服务器别名 (Mail Server Aliasing):这与主机别名类似。我们的邮箱地址是
user@ustc.edu.cn,这里的ustc.edu.cn是一个方便记忆的域名。但实际处理邮件的服务器可能有一个规范的管理名称,如mail-server-01.ustc.edu.cn。DNS负责将邮件服务中使用的别名转换成邮件服务器的规范名字。 - 负载均衡 (Load Distribution):对于像
www.ibm.com这样的大型网站,背后支撑服务的是一个由成百上千台服务器组成的集群,分布在世界各地。当DNS系统收到一个对www.ibm.com的解析请求时,它可以根据请求来源的IP地址、服务器当前的负载情况等多种因素,有策略地返回其中一台服务器的IP地址。例如,将亚洲用户的请求导向亚太地区的服务器,将美国用户的请求导向美国东海岸或西海岸的服务器。这样,就巧妙地将访问流量分散到不同的服务器上,起到了负载均衡的作用。
Besides hostname-to-IP translation, DNS provides other useful services:
- Host Aliasing: A host can have multiple names. A complex, canonical (true) name can be given a simpler nickname or alias. This is useful for providing shorter, easier-to-remember names and can offer some privacy.
- Mail Server Aliasing: Similar to host aliasing, but for mail servers.
- Load Distribution: This is a very important service for busy websites.
- A single hostname can be associated with multiple IP addresses, each pointing to a different server. When a user requests the hostname, DNS can return a different IP address based on the user’s location, directing them to a geographically closer server. This distributes the traffic load and reduces latency.
- For example, a user from the US visiting
bilibili.comwill be directed to a US-based server, while a user from Nanjing will be directed to a local server.
9.2 DNS的命名机制:层次化的域名空间(问题一,如何命名)
9.2.1 DNS: a distributed, hierarchical database
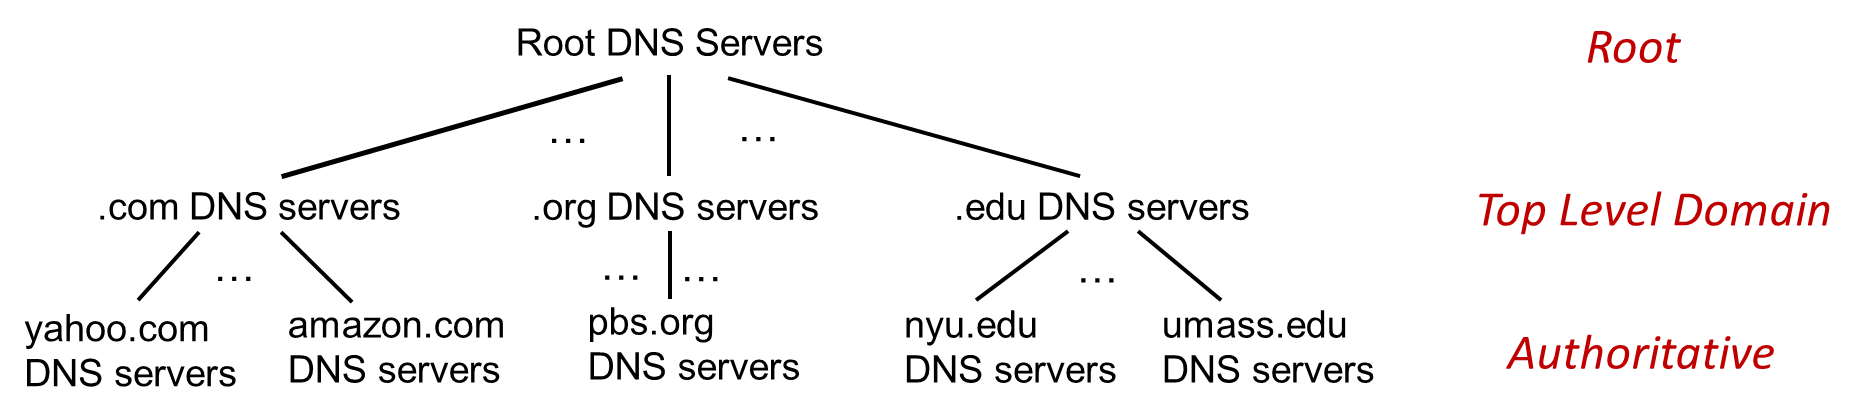
Client wants IP address for www.amazon.com; approximation:
- client queries root server to find .com DNS server
- client queries .com DNS server to get amazon.com DNS server
- client queries amazon.com DNS server to get IP address for www.amazon.com 为了从根本上解决平面命名带来的重名问题,DNS采用了一种层次化的命名方法。整个互联网的域名空间被组织成一棵倒着生长的树。
9.2.2 根与顶级域 (Root and Top-Level Domains, TLDs)
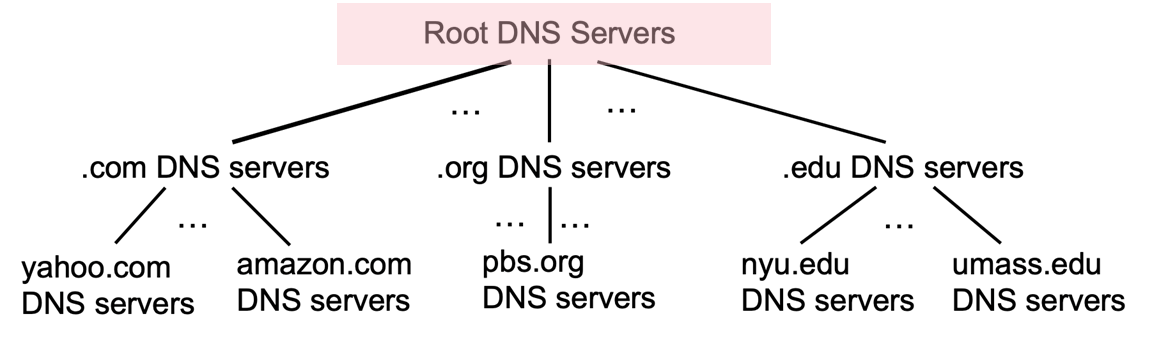
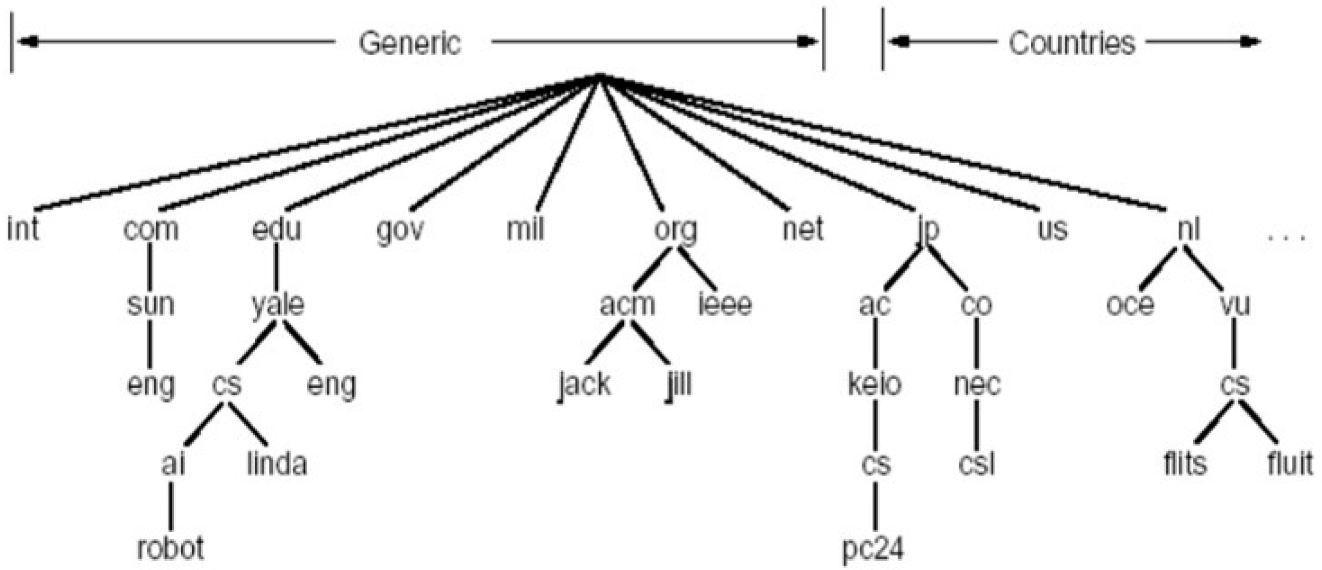
- 整个域名空间的起点是一个抽象的“根”(root),它被分解为数百个顶级域。
- official, contact-of-last-resort by name servers that can not resolve name
- 顶级域主要分为两类【顶级域的图见下一小节】:
- 通用顶级域 (gTLD):如
.com(商业公司),.edu(教育机构),.gov(政府部门),.org(非营利组织)等。.com; .edu ; .gov ; .int ; .mil ; .net ; .org .firm ; .hsop ; .web ; .arts ; .rec ; - 国家代码顶级域 (ccTLD):为每个国家和地区分配的顶级域,如
.cn(中国),.us(美国),.jp(日本),.nl(荷兰)等。
- 通用顶级域 (gTLD):如
9.2.2.1 全球的根服务器
从理论上讲,域名树只有一个逻辑上的“根”。但如果物理上也只有一个根服务器,一旦它发生故障,整个互联网的域名解析服务都将瘫痪。
为了确保系统的可靠性和健壮性,DNS系统在全球范围内共部署了 13 个逻辑根服务器。这些服务器并非13台独立的机器,而是13个由众多物理服务器组成的集群,分布在世界各地(大部分在北美,欧洲和日本也有分布)。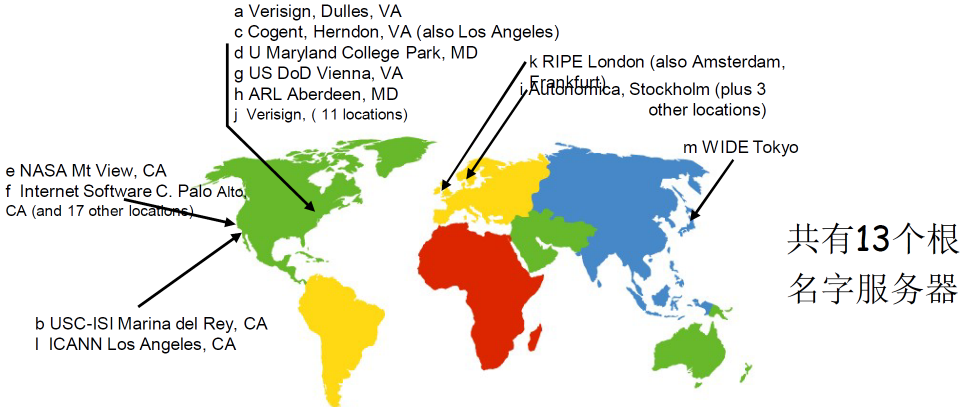
-
树之后一个根,可靠性较低
-
根服务器有多台,提高了可靠性和查询效率
-
全球有13个根服务器,但是中国大陆没有
-
当一个服务器崩了,可以到其他服务器查询
-
根≠顶级域,顶级域是根下面的一级
-
incredibly important Internet function
- Internet couldn’t function without it!
- DNSSEC – provides security (authentication, message integrity)
-
ICANN (Internet Corporation for Assigned Names and Numbers) manages root DNS domain
13 logical root name “servers” worldwide each “server” replicated many times (~200 servers in US)
As of 2024-09-14, the root server system consists of 1867 instances operated by the 12 independent root server operators:
9.2.3 二级域与子域(Top-Level Domain, and authoritative servers)
- 每个顶级域下面,可以再划分为若干个二级域。例如,
.cn顶级域下有.com.cn,.edu.cn,.gov.cn等二级域。 - 同样,二级域下还可以继续划分三级域、四级域,以此类推。例如,
ustc.edu.cn中,ustc就是在.edu.cn这个二级域下的一个三级域。 - 这种划分是灵活的,有些机构(特别是美国的一些早期机构,如MIT)可以直接挂在顶级域下(如
mit.edu),而不需要经过二级域。
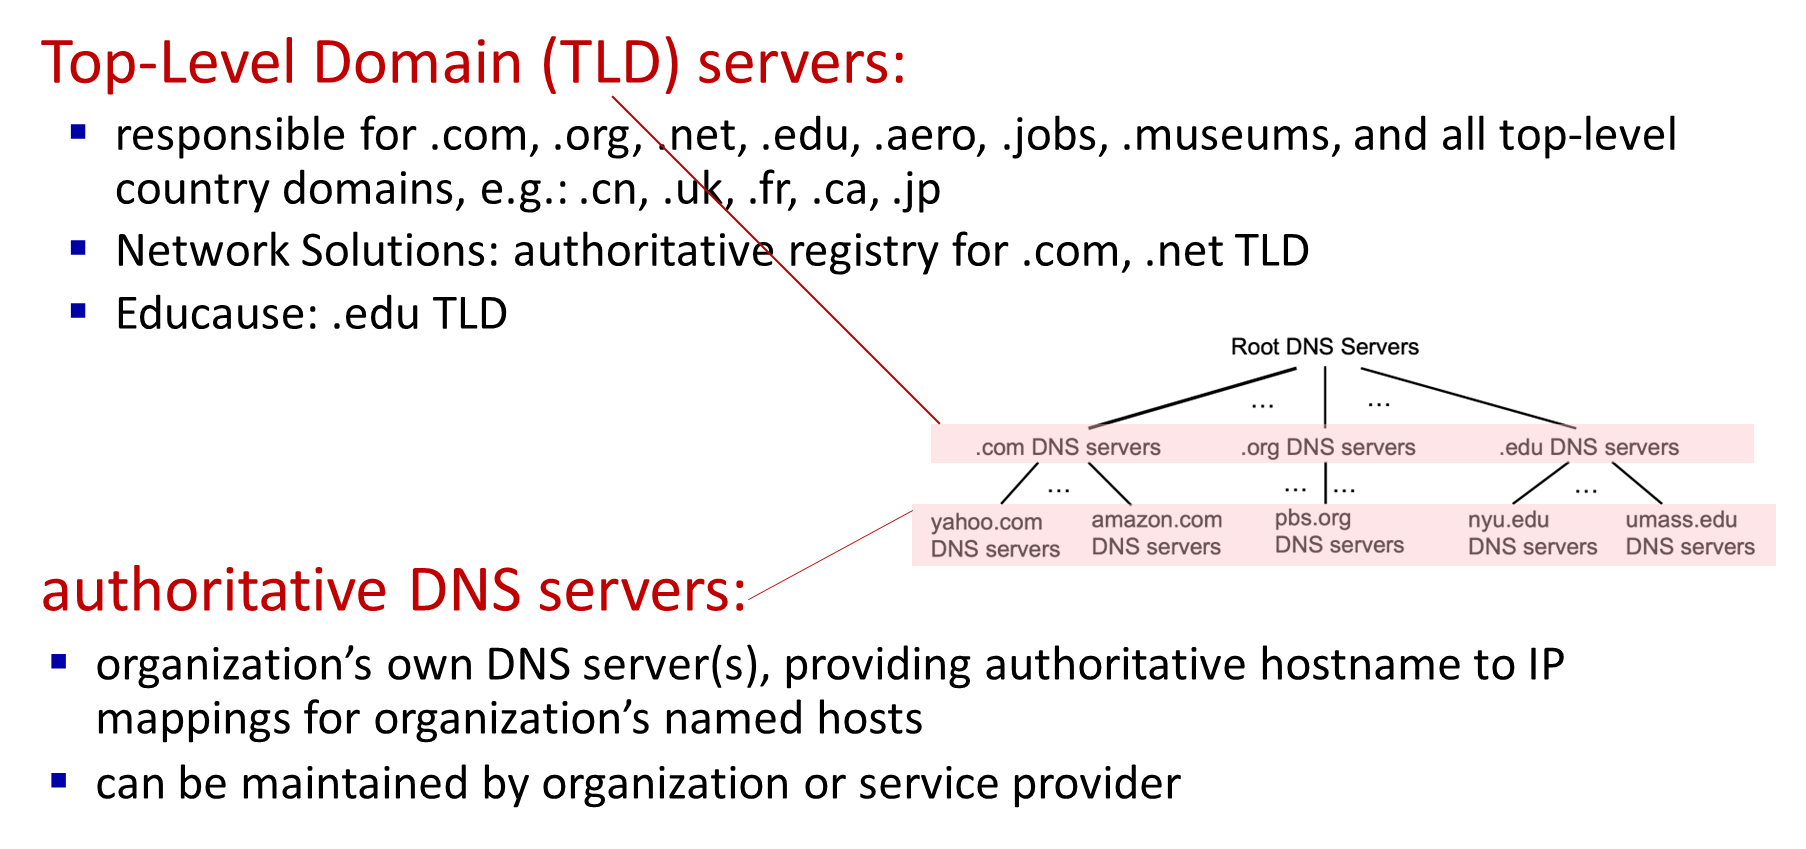
9.2.4 Local DNS name servers
- when host makes DNS query, it is sent to its local DNS server
- Local DNS server returns reply, answering:
- from its local cache of recent name-to-address translation pairs (possibly out of date!)
- forwarding request into DNS hierarchy for resolution
- each ISP has local DNS name server; to find yours:
- MacOS:
% scutil --dns - Windows:
>ipconfig /all
- MacOS:
- Local DNS server returns reply, answering:
- local DNS server doesn’t strictly belong to hierarchy
9.2.5 域的命名规则
- 主机的域名:代表树的“树叶”。它的完整名称是通过从“树叶”开始,向上一直走到“树根”,将经过的每一级域名用点(
.)连接起来构成的。例如,科大的Web服务器主机,其域名为www.ustc.edu.cn。 - 域的域名:代表树的“树枝”。它的名称是从这个“树枝”开始,向上走到“树根”,将经过的各级域名用点连接而成。例如,中国教育网的域名是
edu.cn,中国科学技术大学的域名是ustc.edu.cn。
这种层次化的命名方式,通过为每个主机和域提供一个全局唯一的路径,极大地降低了重名的概率,从而解决了命名问题。
9.2.6 域名的管理与划分
9.2.6.1 域的自治管理
DNS的一个重要特点是分级授权管理。一个域的管理者只负责其下一级子域的划分和命名,而无权干涉其他域。
例如,日本(.jp)的管理者决定将其子域划分为 .co.jp (商业) 和 .ac.jp (学术),而中国(.cn)的管理者则决定使用 .com.cn 和 .edu.cn。每个国家或组织的域管理者都可以根据自身的需求来规划其域名空间,这种方式使得整个DNS系统的管理得以分散化和自治化。
9.2.6.2 域与物理网络的无关性
这是一个非常关键的概念:域的划分是逻辑上的,与物理网络布局完全无关。域的结构主要遵从组织的界限,而不是网络设备所在的地理位置或网络拓扑。
这具体体现在两个方面:
-
同一个域的主机可以分布在不同的物理网络中。 例如,属于
ustc.edu.cn域下的服务器,可能一台在中国科大合肥的校园网内,另一台在北京的数据中心,甚至还有一台部署在美国的云服务器上。它们虽然物理位置不同,但在逻辑上都属于同一个域。 -
同一个物理网络中的主机可以属于不同的域。 例如,在同一个教室的局域网内,一台计算机可能属于中国的某个大学域,而旁边另一台计算机可能属于欧洲某个研究机构的域。只要它们各自的域名和IP地址的对应关系被相应的权威DNS服务器正确维护即可。
9.3 (问题2)DNS的域名解析:如何完成名字到IP的转换
在解决了如何命名的问题后,我们来探讨第二个核心问题:DNS系统是如何完成域名到IP地址的转换的。
9.3.1 集中式服务器的弊端
我们已经分析过,使用单一的、集中式的名字服务器来处理全球的域名解析是不可行的,其主要弊端包括:
- 可靠性问题:单台服务器构成了一个单点故障。一旦这台服务器宕机,整个互联网的域名解析服务都会中断,导致所有依赖域名的应用无法运行。
- 扩展性问题:所有解析请求的流量都会涌向这台服务器,会造成巨大的网络拥堵和服务器负载,其通信容量很快会达到瓶颈。
- 维护问题:全球域名的增加、删除和修改操作都需要在一个远程的集中式数据库上进行,这会使得维护工作变得异常困难和低效。
9.3.1.1 Why DNS is Distributed, Not Centralized
A single, centralized DNS server would be a terrible idea for several reasons:
- Single Point of Failure: If that one server goes down, the entire internet becomes unusable because no one can resolve hostnames.
- Traffic Volume: A single server could not handle the trillions of DNS queries generated worldwide every day.
- Distant Centralized Database: A centralized server would be far away for most users, leading to significant delays.
- Maintenance: Maintaining a single, massive database with billions of records would be a nightmare.
A distributed design solves these problems by spreading the load, increasing reliability, reducing latency, and simplifying maintenance.
9.3.2 分布式解决方案
为了克服以上问题,DNS采用了分布式的解决方案。其核心思想是将整个域名空间树(DNS Name Space)进行切分,划分为一个个可管理的单元。
1. 区域 (Zone) 的划分(区域名字服务器)
- 整个DNS域名树被划分为若干个互不相交的区域 (Zone)。一个区域是树的一部分,可以包含一个域,也可以包含一个域及其下的多个子域。
- 如何划分区域由该区域的管理者自行决定。例如,耶鲁大学(
yale.edu)可以将其工程学院等部门都放在一个大的Zone中统一管理。但如果其计算机系(cs.yale.edu)规模庞大、主机众多,管理者可以决定将其单独划分为一个独立的Zone,并为其配置专门的名字服务器进行管理。 - 每个区域都有一个名字服务器:维护着它所管辖区域的权威信息 (authoritative record) (名字→ip的转换)
- 名字服务器允许被放置在区域之外,以保障可靠性
2. 权威DNS服务器 (Authoritative DNS Server)
- 每个划分好的区域(Zone)都至少有一台权威名字服务器。
- 所谓“权威”,指的是这台服务器所维护的关于其管辖区域内的域名映射信息是官方的、最准确的第一手资料。例如,
ustc.edu.cn域的权威服务器保存着所有科大官方域名的权威记录。 - 为了实现从上至下的查询,DNS的层次结构中隐含了一个重要规则:上层域的权威服务器必须知道其下层子域的权威服务器在哪里。例如,
.edu.cn的权威服务器中,必须有记录(指针)指向ustc.edu.cn的权威服务器。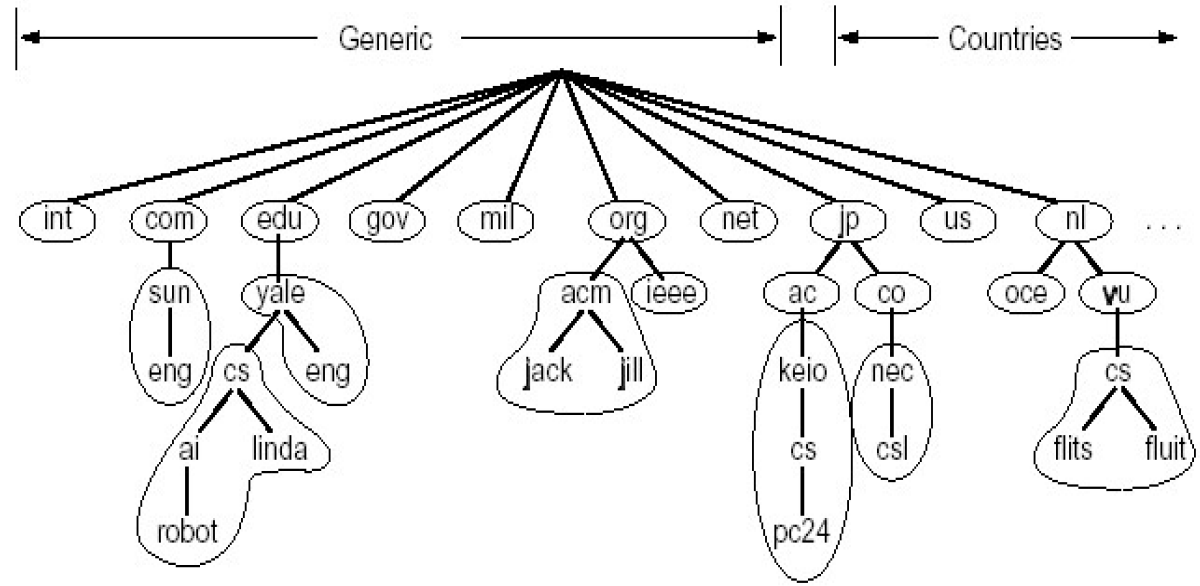
- 如图,耶鲁大学的cs科目单独划分成一个区域管理
3. 顶级域 (TLD) 服务器
- 顶级域服务器是一种特殊的权威服务器,它负责管理顶级域名,如
.com,.org等通用顶级域和.cn,.uk等所有国家顶级域。例如,Network Solutions公司负责维护.com的TLD服务器。 - 有趣的是,某些国家代码顶级域也被用于商业目的。例如,太平洋岛国图瓦卢的国家代码是
.tv,这个域名因其酷炫的含义被卖给了一家传媒机构,这展示了数字资产在互联网世界中的价值。
4.权威DNS服务器
- organization’s own DNS server(s), providing authoritative hostname to IP mappings for organization’s named hosts
- can be maintained by organization or service provider
9.3.3 DNS的核心数据:资源记录 (Resource Records, RR)
每个区域的权威名字服务器都维护着一个数据库,这个数据库由一系列的资源记录 (Resource Records, RR) 组成。这些记录是DNS存储信息的标准格式。
一条完整的资源记录格式为:RR: (Domain_name, TTL, Class, Type, Value)
下面对每个字段进行详细解释:
-
Domain_name (域名) 和 Value (值)
Domain_name是这条记录所关联的域名,而Value是与之对应的值,具体含义由Type字段决定。例如,如果Type是A,那么Value就是Domain_name对应的IP地址。 -
Class (类别) 对于我们所使用的互联网,这个字段的值固定为
IN(Internet)。DNS在设计之初曾考虑支持其他类型的网络,但目前我们只关心互联网应用。 -
TTL (Time To Live, 生存时间) 这是一个至关重要的字段,它决定了这条记录在被其他DNS服务器缓存后,可以在缓存中保留多长时间。
- 权威记录:在权威服务器自身的数据库中,其管理的记录的TTL值可以被视为无限大,因为这些记录是永久性的,除非管理员手动修改。
- 缓存记录:当一个外部DNS服务器(例如,上海交大的DNS服务器)查询并获取到一条科大的域名记录后,它会将这条记录保存在自己的缓存中。这条缓存记录的TTL是一个有限的数值(例如,默认为2天)。下次有用户查询同一个域名时,服务器可以直接从缓存返回结果。
- TTL的作用:缓存是为了提升查询性能和效率,而TTL到期后删除缓存是为了保证数据一致性。如果科大某台服务器更换了IP地址,旧的缓存记录在TTL过期后会被自动清除,从而避免用户访问到错误的地址。
-
Type (类别) 这个字段定义了该条资源记录的类型,对应DNS的不同功能。常见的类型有:
- Type = A: 这是一条地址记录 (Address)。
Name是一个主机名,Value是该主机对应的 IPv4地址。 - Type = CNAME: 这是一条别名记录 (Canonical Name)。
Name是一个别名,Value是该别名对应的规范名字(真实名字)。 - Type = MX: 这是一条邮件交换记录 (Mail Exchanger)。
Name是邮件地址中的域名(别名),Value是负责处理该域邮件的邮件服务器的正规名字。 - Type = NS: 这是一条名字服务器记录 (Name Server)。它用于实现DNS的层级查询。
Name是一个子域的域名(如foo.com),Value是负责解析该子域的权威名字服务器的域名。
- Type = A: 这是一条地址记录 (Address)。
重要补充:为了让上级域能找到下级域的权威服务器,上级域的数据库中通常需要包含两条关于下级域的记录:
- 一条 NS 记录,指明下级域的权威服务器的“名字”是什么
- 以及一条对应的 A 记录
- 指明这个权威服务器名字所对应的“IP地址”是什么。这样才能确保查询链路不会中断。
NOTE
DNS: distributed database storing resource records (RR) RR format: (name, value, type, ttl)
type=A
- name is hostname
- value is IP address
type=NS
- name is domain (e.g., foo.com)
- value is hostname of authoritative name server for this domain
type=CNAME
- name is alias name for some “canonical” (the real) name
- www.ibm.com is really servereast.backup2.ibm.com
- value is canonical name
type=MX
- value is name of SMTP mail server associated with name
9.3.3.1 一个例子
; Authoritative data for cs.vu.nl
cs.vu.nl. 86400 IN SOA star boss (952771,7200,7200,2419200,86400)
cs.vu.nl. 86400 IN TXT "Faculteit Wiskunde en Informatica."
cs.vu.nl. 86400 IN TXT "Vrije Universiteit Amsterdam."
cs.vu.nl. 86400 IN MX 1 zephyr.cs.vu.nl.
cs.vu.nl. 86400 IN MX 2 top.cs.vu.nl.

flits.cs.vu.nl.86400 IN HINFO Sun Unix
flits.cs.vu.nl.86400 IN A 130.37.16.112
flits.cs.vu.nl.86400 IN A 192.31.231.165
flits.cs.vu.nl.86400 IN MX 1 flits.cs.vu.nl.
flits.cs.vu.nl.86400 IN MX 2 flits.cs.vu.nl.
flits.cs.vu.nl.86400 IN MX 3 zephyr.cs.vu.nl.
www.cs.vu.nl.86400 IN CNAME star.cs.vu.nl
ftp.cs.vu.nl. 86400 IN CNAME zephyr.cs.vu.nl

rowboat IN A 130.37.56.201
rowboat IN MX 1 rowboat
rowboat IN MX 2 zephyr
rowboat IN HINFO Sun Unix

little-sister IN A 130.37.62.23
little-sister IN HINFO Mac MacOS

laserjet IN A 192.31.231.216
laserjet IN HINFO "HP Laserjet IIIsi" Proprietary
9.4 DNS的完整工作流程(问题2,续)
9.4.1 客户端侧的流程
一个典型的DNS查询始于用户主机上的应用程序。整个流程可以分解为以下几个步骤: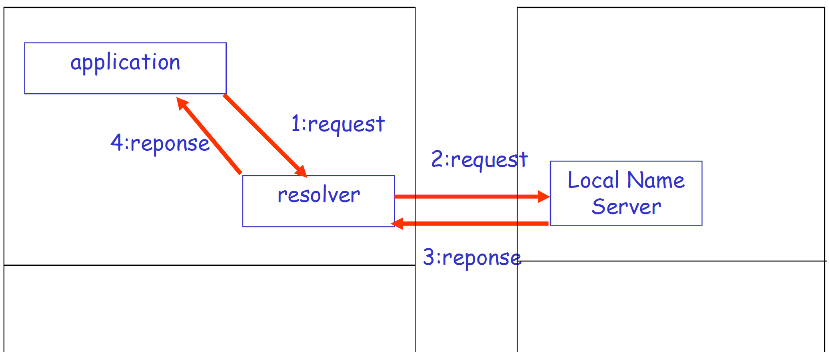
- 应用调用解析器:当用户在浏览器中输入网址时,浏览器(应用程序)会调用操作系统内的解析器 (resolver) 库函数。
- 解析器发送查询:解析器会创建一个DNS查询报文,并将其封装在一个UDP数据段中,发送给本地名字服务器 (Local Name Server)。
- 服务器返回响应:本地名字服务器在获取到查询结果后,会将包含IP地址的响应报文返回给解析器。
- 应用获取结果:解析器将IP地址传递给应用程序,应用程序随后便可使用该IP地址与目标服务器建立连接。
补充:主机上网必备的四项网络配置
为了让上述流程正常工作,一台主机在接入互联网时,必须配置好四项基本信息。这些信息可以通过DHCP协议自动获取,也可以手动配置:
- IP地址:主机在网络中的唯一标识。
- 子网掩码:用于区分IP地址中的网络部分和主机部分。
- 默认网关 (Default Gateway):即路由器的IP地址。当主机需要与不在同一个子网内的设备通信时,会将数据包发送给默认网关,由它负责将数据包转发出去。
- 本地名字服务器的IP地址:主机需要知道该向谁发起DNS查询。
- 一般指定在子网内部的服务器,因为快
9.4.1.1 本地名字服务器的角色 (Local Name Server)
本地名字服务器是用户进入DNS世界的门户,扮演着至关重要的代理角色。
- 它不严格属于DNS的层次结构(即它不是根、顶级域或权威服务器)。
- 每个ISP(互联网服务提供商)、公司或大学通常都会为其网络内的用户提供一个本地DNS服务器,因此它也被称为“默认名字服务器”。
- 用户通常会配置一个在网络上或地理上离自己最近的服务器作为本地服务器,因为这样可以大大减少查询延迟,提升上网体验。
9.4.2 服务器侧的解析过程
当本地名字服务器收到来自客户端的查询请求后,它的处理方式如下:
- 检查缓存:服务器首先会检查自己的缓存。如果要查询的域名-IP映射关系已经存在于缓存中(且TTL未过期),它会立即将结果返回给客户端。
- 发起查询:如果缓存中没有记录,本地名字服务器就会作为客户端的代理,向DNS层次结构发起查询。这个过程主要有两种方式:递归查询和迭代查询。
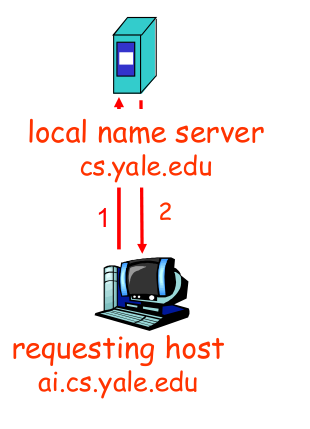 当与本地名字服务器不能解析名字时,联系根名字服务器(全球有13个根服务器),顺着根-TLD 一直找到 权威名字服务器
9.4.2.1 递归查询 (Recursive Query)
在纯粹的递归查询模式下,解析的负担完全交给了被查询的服务器。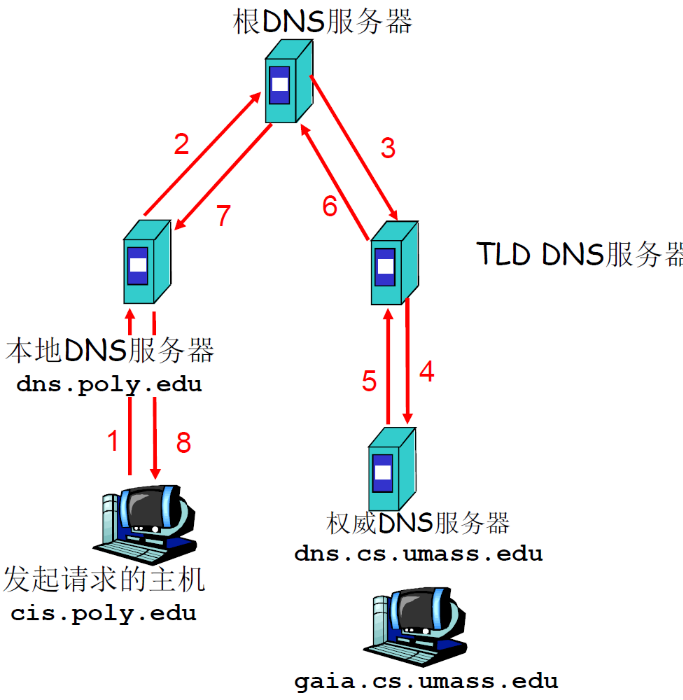
- 过程:本地服务器向根服务器查询,并请求递归服务。根服务器会代替本地服务器,去查询顶级域服务器;顶级域服务器再代替根服务器,去查询权威服务器,直到获得最终答案。然后,结果再沿着原路返回。
- 缺点:这种方式会给根服务器等高级别服务器带来巨大的负担,因为它们需要处理并跟踪每一个查询的全过程。因此,在DNS服务器之间,这种方式很少被使用。
Recursive query (递归查询):
- puts burden of name resolution on contacted name server
- heavy load at upper levels of hierarchy?
9.4.2.2 迭代查询 (Iterative Query)
【注意之类的1和8还是递归查询】
这是DNS服务器之间进行查询的标准方式,它将解析的负担分散开来。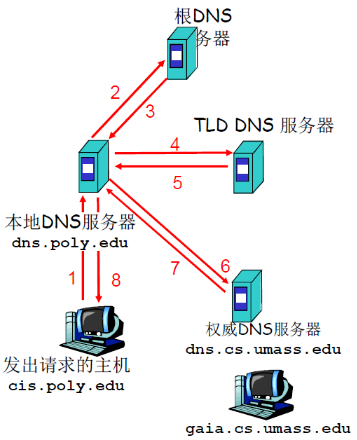
-
过程:以
gaia.cs.umass.edu的查询为例:- 本地服务器向根服务器发起查询。
- 根服务器回复:“我不知道完整答案,但
.edu域归一个TLD服务器管,这是它的地址。” - 本地服务器接着向
.edu的TLD服务器发起查询。 - TLD服务器回复:“我也不知道,但
umass.edu域有一个权威服务器,这是它的地址。” - 本地服务器最后向
umass.edu的权威服务器发起查询。 - 权威服务器知道最终的IP地址,并将这个权威结果返回给本地服务器。
- 本地服务器将结果缓存起来,并返回给最初发起请求的主机。
-
特点:“我不知道,但你可以去问他。” 在这个过程中,每一级服务器都只提供下一级的线索,而不会代为查询。
Iterated query (迭代查询):
- contacted server replies with name of server to contact
- “I don’t know this name, but ask this server”
9.4.2.3 两种查询方式id结合
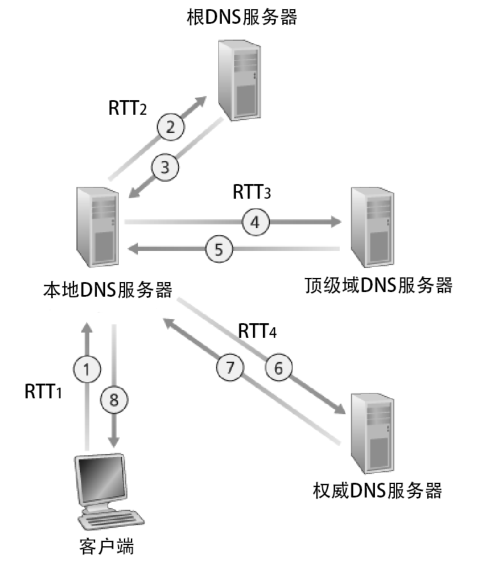
- (1) 客户端 → 本地 DNS 服务器: 递归查询 (Recursive Query)。
- 说明: 客户端(主机)向本地 DNS 服务器请求一个完整的答案,并期望本地服务器代替它完成所有后续工作。
- (2) 本地 DNS → 根 DNS 服务器: 迭代查询 (Iterative Query)。
- (5) 本地 DNS → 顶级域 DNS 服务器: 迭代查询 (Iterative Query)。
- (7) 本地 DNS → 权威 DNS 服务器: 迭代查询 (Iterative Query)。
- 说明: 序号 (2)、(5)、(7) 共同构成了本地 DNS 服务器的迭代查询过程。本地服务器(作为客户端)自己依次“迭代”地去询问根、顶级域和权威服务器,直到它获得最终答案。
9.5 DNS Caching(问题2)
9.5.1 缓存的重要性
缓存是DNS系统高性能运作的基石。
- 目的:提高效率。一旦任何一台名字服务器通过查询学到了一个映射关系,它就会将这个结果缓存起来。这样,当再次收到相同的查询时,就可以直接从缓存中快速响应,而无需重复完整的迭代查询过程。
- 效果:尤其是根服务器和顶级域服务器的地址,通常都会被缓存在本地服务器中,这极大地减少了对这些关键服务器的访问压力。
- 一致性问题:缓存可能导致数据不一致(例如,权威服务器更新了IP,但缓存中仍是旧数据)。
- 解决方案:通过TTL(生存时间) 机制来解决。缓存中的每条记录都有一个有效期,过期后会被自动删除,从而确保缓存数据能定期与权威服务器同步。
老师最后总结道:“缓存是为了性能,删除是为了一致性。” 这句话精辟地概括了DNS缓存机制的核心思想。
To improve performance and reduce traffic, DNS query results are cached at various levels.
- When a local DNS server receives an IP address, it caches the mapping for a certain period (defined by a Time-To-Live or TTL value).
- If another user in the same organization requests the same hostname, the local server can provide the answer instantly from its cache without querying the entire DNS hierarchy again.
- Your own computer also maintains a local DNS cache for frequently visited sites.
9.5.2 Classroom Q&A: Google’s 8.8.8.8
A student asked about services like Google’s 8.8.8.8.
The teacher explained that 8.8.8.8 is a public local DNS server. It performs the same function as the local DNS server provided by your ISP or university. It is not an authoritative server that stores all records itself; rather, it performs queries into the DNS hierarchy on your behalf.
You can configure your computer to use multiple local DNS servers in a preferred order. If you list Google’s server first, your computer will send its DNS queries there.
9.6 DNS协议报文(问题2)
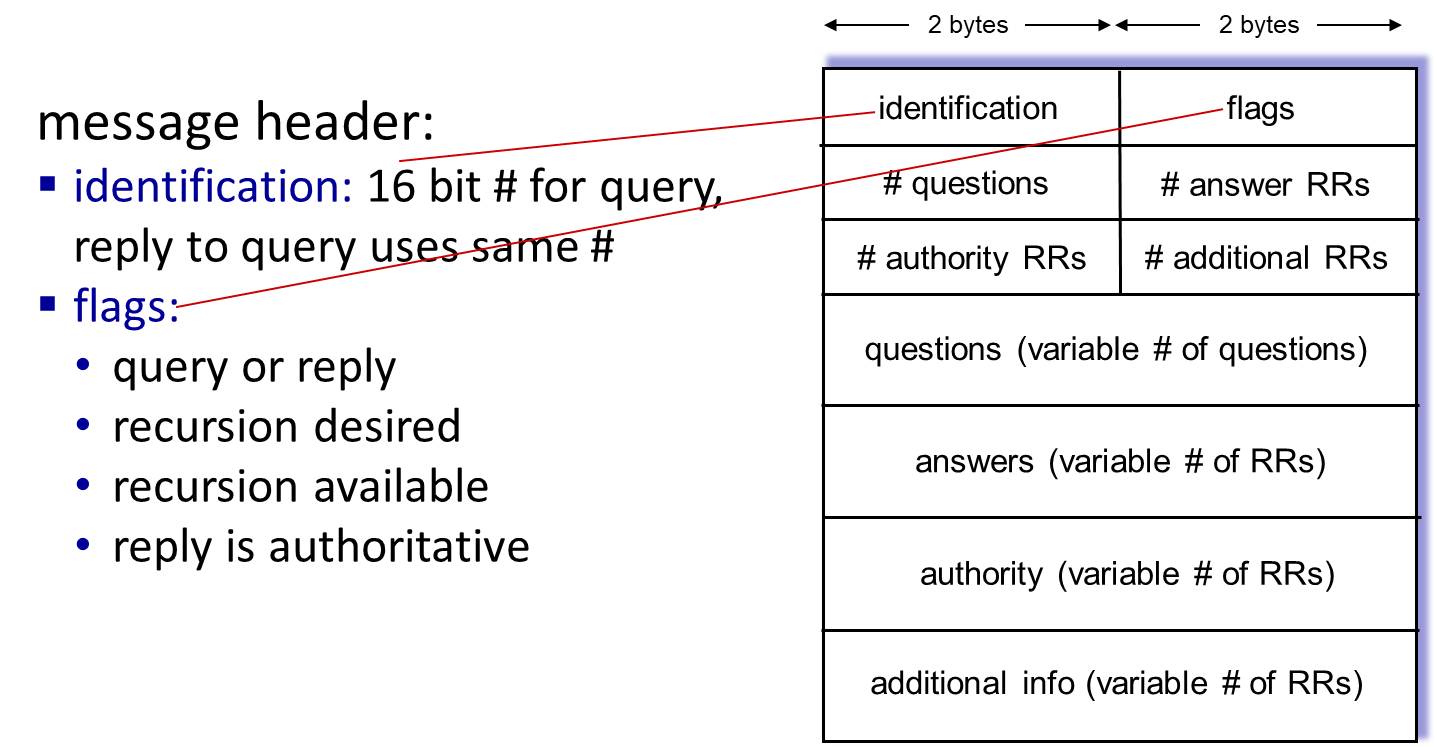
DNS query and reply messages, both have same format:
DNS的查询和响应使用统一的报文格式。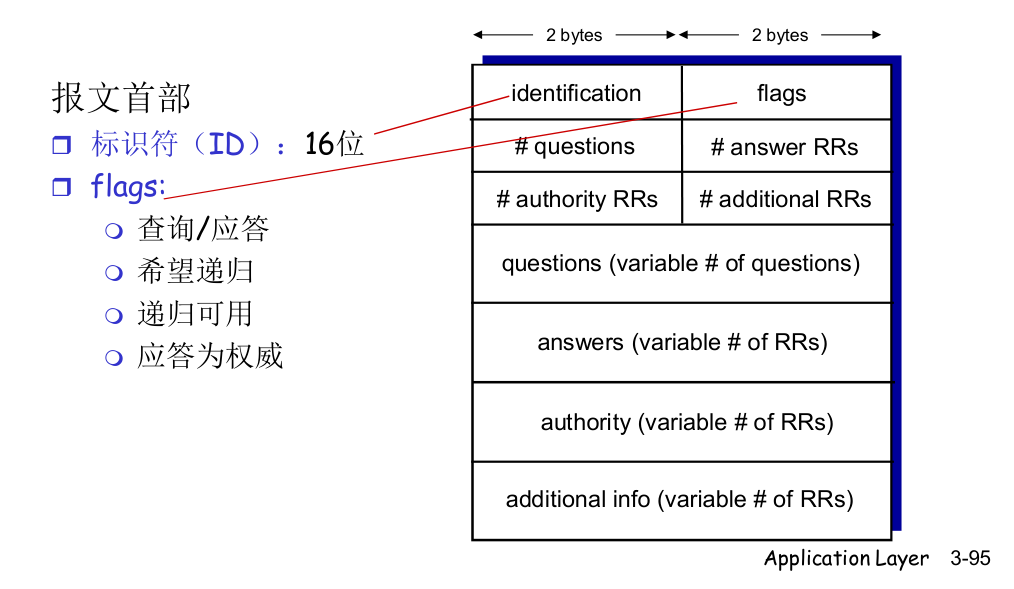
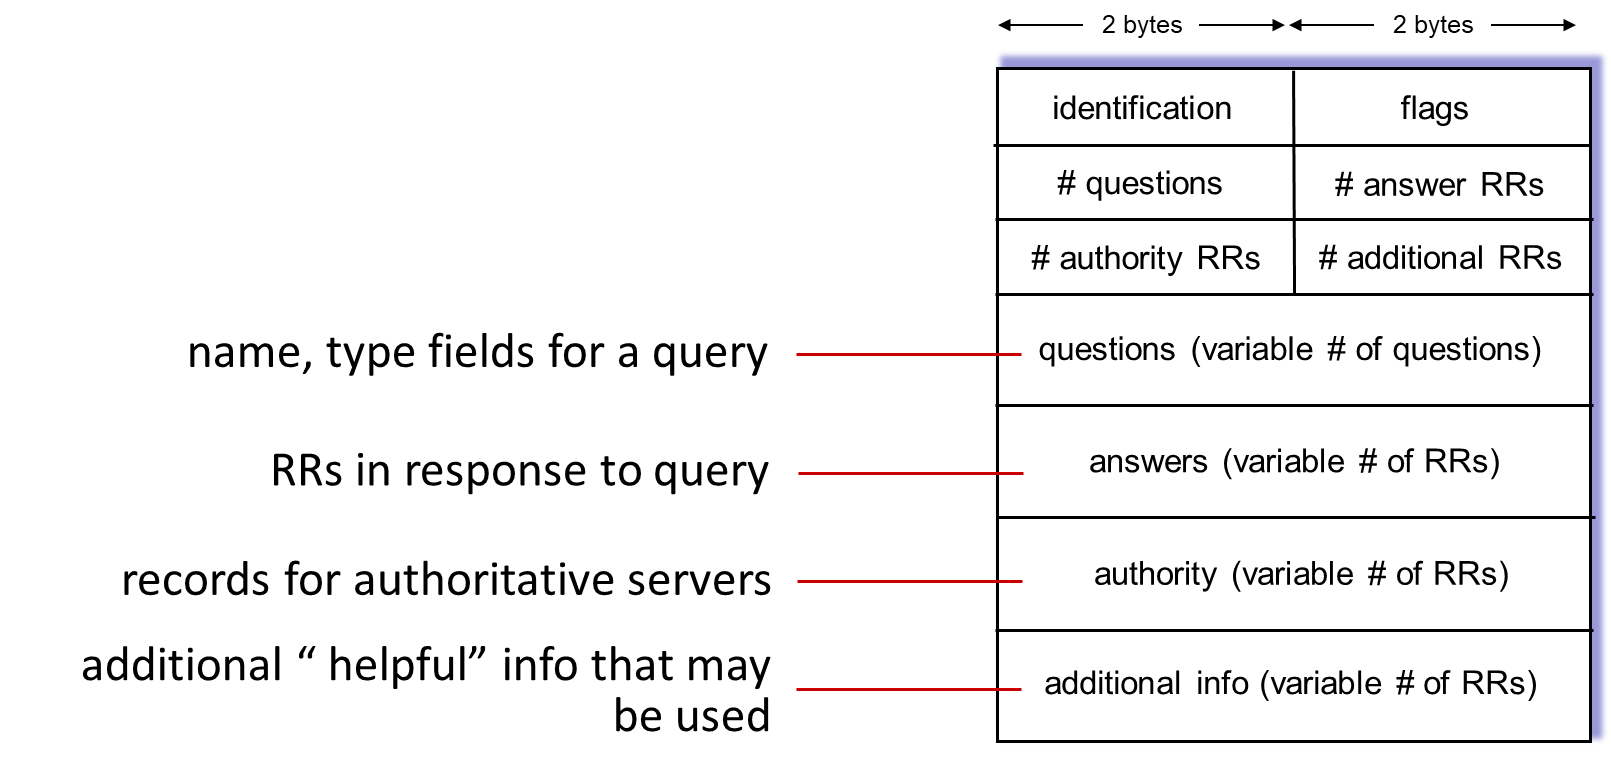
-
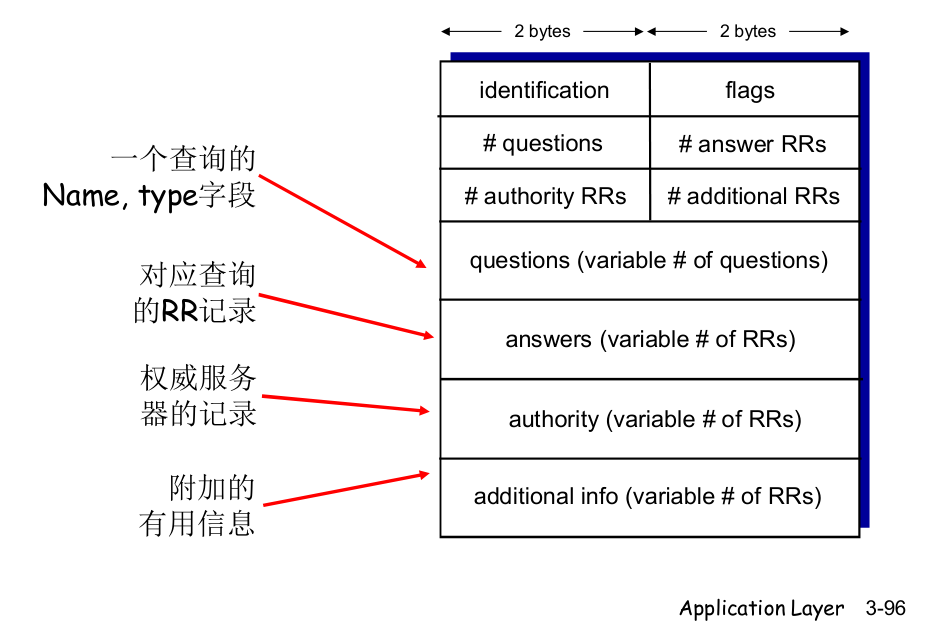
报文结构:报文包含一个报文首部和四个内容区域:问题(Questions)、回答(Answers)、权威(Authority)和附加信息(Additional Info)。
-
Identification (ID) 字段:这是一个16位的标识符,用于匹配查询和响应。这个字段至关重要,它使得DNS服务器可以并行处理多个查询(类似流水线),而不会混淆哪个响应对应哪个请求。
-
Flags 字段:包含多个标志位,用于区分报文是查询还是响应、是期望递归查询还是迭代查询、返回的答案是否为权威信息等。
-
The first 12 bytes is the header section, which has a number of fields. The first field is a 16-bit number that identifies the query. This identifier is copied into the reply message to a query, allowing the client to match received replies with sent queries. There are a number of flags in the flag field. A 1-bit query/reply flag indicates whether the message is a query (0) or a reply (1). A 1-bit authoritative flag is set in a reply message when a DNS server is an authoritative server for a queried name. A 1-bit recursion-desired flag is set when a client (host or DNS server) desires that the DNS server perform recursion when it doesn’t have the record. A 1-bit recursion-available field is set in a reply if the DNS server supports recursion. In the header, there are also four number-of fields. These fields indicate the number of occurrences of the four types of data sections that follow the header.
-
The question section contains information about the query that is being made. This section includes (1) a name field that contains the name that is being queried, and (2) a type field that indicates the type of question being asked about the name—for example, a host address associated with a name (Type A) or the mail server for a name (Type MX).
-
In a reply from a DNS server, the answer section contains the resource records for the name that was originally queried. Recall that in each resource record there is the Type (for example, A, NS, CNAME, and MX), the Value, and the TTL. A reply can return multiple RRs in the answer, since a hostname can have multiple IP addresses (for example, for replicated Web servers, as discussed earlier in this section).
-
The authority section contains records of other authoritative servers.
-
The additional section contains other helpful records. For example, the answer field in a reply to an MX query contains a resource record providing the canonical hostname of a mail server. The additional section contains a Type A record providing the IP address for the canonical hostname of the mail server.
How would you like to send a DNS query message directly from the host you’re working on to some DNS server? This can easily be done with the nslookup program, which is available from most Windows and UNIX platforms. For example, from a Windows host, open the Command Prompt and invoke the nslookup program by simply typing “nslookup.” After invoking nslookup, you can send a DNS query to any DNS server (root, TLD, or authoritative). After receiving the reply message from the DNS server, nslookup will display the records included in the reply (in a human-readable format). As an alternative to running nslookup from your own host, you can visit one of many Web sites that allow you to remotely employ nslookup. (Just type “nslookup” into a search engine and you’ll be brought to one of these sites.) The DNS Wireshark lab at the end of this chapter will allow you to explore the DNS in much more detail.
9.6.1 RFC 1035
RFC 1035: Domain names - implementation and specification
9.7 (问题3)DNS的维护问题(CRUD)
这里以添加为例,删改查是一样的
- 在上级域的名字服务器中增加两条记录,指向这个新增的子域的域名和域名服务器的地址
(Type = NS、 Type = A 相当于指针) - 在新增子域的名字服务器上运行名字服务器,负责本域的名字解析:名字→IP地址
整个过程可以概括为两个主要步骤:首先,需要在上级域中建立指向新子域的“指针”;然后,需要在新子域自己的服务器上配置好本地域名的解析服务。
example: new startup “Network Utopia”
- register name networkuptopia.com at DNS registrar (e.g., Network Solutions)
- provide names, IP addresses of authoritative name server (primary and secondary)
- registrar inserts NS, A RRs into .com TLD server: (networkuptopia.com, dns1.networkuptopia.com, NS) (dns1.networkuptopia.com, 212.212.212.1, A)
- create authoritative server locally with IP address 212.212.212.1
- type A record for www.networkuptopia.com
- type MX record for networkuptopia.com
9.7.1 实例:在 .com 域中建立 “networkutopia.com”
假设一家名为 “Network Utopia” 的新公司,希望在 .com 顶级域下注册并建立自己的域名 networkutopia.com。
9.7.1.1 第一步:注册域名并在上级域(.com)中建立链接
- 向注册机构申请
- 公司首先需要向一个域名注册服务机构(如GoDaddy、阿里云等)提交申请,注册
networkutopia.com这个域名。
- 公司首先需要向一个域名注册服务机构(如GoDaddy、阿里云等)提交申请,注册
- 提供权威服务器信息
- 在注册过程中,公司必须提供自己权威DNS服务器的域名和IP地址。例如,主服务器域名为
dns1.networkutopia.com,其IP地址为212.212.212.1。
- 在注册过程中,公司必须提供自己权威DNS服务器的域名和IP地址。例如,主服务器域名为
- 上级域(.com TLD)服务器更新记录
- 注册机构会将这些信息提交给
.com顶级域的管理者。.com的权威服务器会在其数据库中添加两条关键的资源记录 (RR) 来指向这个新的子域: - 一条 NS (Name Server) 记录:
这条记录的作用是指明
networkutopia.com这个子域由名为dns1.networkutopia.com的服务器来负责权威解析。(networkutopia.com, dns1.networkutopia.com, NS) - 一条 A (Address) 记录:
这条记录(有时也称为“胶水记录”)的作用是提供
dns1.networkutopia.com这台权威服务器自身的IP地址,以便其他DNS服务器能够找到它。(dns1.networkutopia.com, 212.212.212.1, A)
- 注册机构会将这些信息提交给
通过这两条记录,.com TLD服务器就建立了一个从上至下的“指针”,当外界查询任何 *.networkutopia.com 的地址时,.com 服务器就会告诉查询者:“去问 dns1.networkutopia.com,它的地址是 212.212.212.1。”
9.7.1.2 第二步:配置新域自己的权威服务器
- 运行并配置本地DNS服务
“Network Utopia” 公司需要在其IP地址为
212.212.212.1的服务器上,运行DNS服务器软件,并将其配置为networkutopia.com域的权威服务器。 - 添加本地域名记录
在这台新的权威服务器上,公司需要为自己内部的所有主机和服务创建相应的资源记录。例如:
- 为其Web服务器
www.networkutopia.com创建一条 A记录,指向Web服务器的IP地址。 - 为其邮件服务器
mail.networkutopia.com创建一条 MX记录,用于处理发送到@networkutopia.com的邮件。 至此,一个新域的增加工作就完成了。当需要修改或删除一个域时,过程与此类似,都是对相应服务器上的资源记录进行修改或删除操作。老师总结道,这覆盖了数据库管理中常见的“增删改查”操作,从而确保了整个DNS系统的动态可维护性。
- 为其Web服务器
9.8 DNS负载均衡算法设计
这是一个典型的 加权轮询 (Weighted Round Robin, WRR) 算法设计问题。目标是按照 1:2:3 的速率比(分别设为服务器 S1, S2, S3)来分配请求。
一个平滑且高效的加权轮询算法(类似 Nginx 的实现)如下:
算法描述(伪代码):
// 1. 初始化服务器列表,包含它们的静态权重
servers = [
    { ip: "IP_1", static_weight: 1, current_weight: 0 },
    { ip: "IP_2", static_weight: 2, current_weight: 0 },
    { ip: "IP_3", static_weight: 3, current_weight: 0 }
]

// 2. 计算总权重
total_weight = 6 // (1 + 2 + 3)

// 3. 每次有 DNS 查询时,调用此函数
function getNextServer():
    best_server = null
    max_weight = -infinity // 设为一个极小值

    // 步骤 A: 遍历所有服务器,更新它们的当前权重,并找到最大者
    for server in servers:
        // 当前权重 = 当前权重 + 静态权重
        server.current_weight = server.current_weight + server.static_weight

        if server.current_weight > max_weight:
            max_weight = server.current_weight
            best_server = server

    // 步骤 B: 选中服务器的当前权重减去总权重
    best_server.current_weight = best_server.current_weight - total_weight

    // 步骤 C: 返回被选中的服务器 IP
    return best_server.ip
算法工作流程演示:
假设 S1(w=1), S2(w=2), S3(w=3)。current_weight 初始为 [0, 0, 0]。
- 请求 1:
current更新为[0+1, 0+2, 0+3]→[1, 2, 3]max是 S3。best_server(S3) 的current减 6 →[1, 2, -3]- 返回 S3
- 请求 2:
current更新为[1+1, 2+2, -3+3]→[2, 4, 0]max是 S2。best_server(S2) 的current减 6 →[2, -2, 0]- 返回 S2
- 请求 3:
current更新为[2+1, -2+2, 0+3]→[3, 0, 3]max是 S3 (假设S3优先)。best_server(S3) 的current减 6 →[3, 0, -3]- 返回 S3
- 请求 4:
current更新为[3+1, 0+2, -3+3]→[4, 2, 0]max是 S1。best_server(S1) 的current减 6 →[-2, 2, 0]- 返回 S1
- 请求 5:
current更新为[-2+1, 2+2, 0+3]→[-1, 4, 3]max是 S2。best_server(S2) 的current减 6 →[-1, -2, 3]- 返回 S2
- 请求 6:
current更新为[-1+1, -2+2, 3+3]→[0, 0, 6]max是 S3。best_server(S3) 的current减 6 →[0, 0, 0]- 返回 S3
结果: 在一个 6 次请求的周期中,返回序列为 [S3, S2, S3, S1, S2, S3]。
- S1: 1 次
- S2: 2 次
- S3: 3 次 这精确地实现了 1:2:3 的负载均衡,并且将高权重的请求(S3)平滑地分布在周期中。
9.9 对DNS的攻击及其健壮性
尽管存在多种理论上的攻击手段,但在实际运行中,DNS系统被证明是一个非常可靠和健壮的分布式系统。
9.9.1 关于“根服务器不在中国”的安全担忧
老师特别针对一个常见的疑问进行了解释,即中国大陆没有根服务器是否会构成严重的安全风险。
-
常见的担忧:有人担心,如果境外的根服务器被“掐断”,中国的互联网解析服务就会瘫痪。
-
实际情况并非如此:
- 首先要澄清一个误区:用户的数据流量(如浏览网页、看视频)并不会经过DNS根服务器。根服务器只处理域名查询请求。
- 更关键的是,域名查询也并非每次都需要从根服务器开始。由于广泛的缓存机制,国内几乎所有的本地DNS服务器(Local Name Server)都已经缓存了全球顶级域(TLD)服务器甚至大量二级域服务器的IP地址。
- 因此,即便真的无法访问根服务器,绝大多数域名查询请求依然可以通过本地缓存或直接查询已知的TLD服务器来完成解析,服务并不会中断。
-
结论:所以,虽然这种担忧有一定的合理性,但由于DNS的分布式和缓存设计,其带来的实际安全风险远不像一些非专业人士所担心的那么严重。
9.9.2 常见的DNS攻击类型
- 本节讲解攻击DNS的手段,但是总的来说,DNS还是比较健壮的
- 教材对于域名解析系统攻击比较详细的
9.9.2.1 DDoS 攻击 (分布式拒绝服务)
这种攻击的目标是通过海量流量淹没服务器,使其无法响应正常请求。
攻击根服务器:
- 方式:向根服务器发送大量
ping包或查询请求。 - 效果:这类攻击基本没有成功过。
- 原因:
- 根服务器本身部署了强大的流量过滤器和防火墙。
- 正如前述,由于本地DNS服务器大量缓存了TLD服务器的地址,所以很少需要直接查询根服务器,这大大减轻了根服务器的压力。
就是因为服务器是分布式的,轰炸轰不过来,不一定所有的查询都需要走跟服务的,TLD服务器可能都进行了缓存了
攻击TLD服务器:
- 方式:向
.com等顶级域服务器发送大量查询。 - 效果:理论上比攻击根服务器更危险,但效果通常也有限,因为TLD服务器的信息同样被广泛缓存。
9.9.2.2 重定向攻击 (Redirection Attacks)
这类攻击的目标不是搞垮服务器,而是欺骗用户,将其引导至错误的、恶意的网站。
-
中间人攻击:
- 方式:攻击者在用户和DNS服务器之间进行窃听,截获用户的查询请求,然后伪造一个错误的应答并发送给用户。例如,将银行网站的域名解析到一个钓鱼网站的IP地址。
-
DNS中毒 (DNS Poisoning):
- 方式:攻击者主动向一个公共DNS服务器发送大量伪造的DNS应答,企图让服务器将这些错误的、虚假的映射关系存入缓存。一旦“投毒”成功,所有使用该服务器的用户都会被引向错误的地址。
- 实现难度:这种攻击在技术上较困难,因为需要在分布式系统中精准地进行截获和伪造。
9.9.2.3 利用DNS进行DDoS (DNS Amplification Attack)
这种攻击巧妙地利用了DNS协议的特点,将DNS服务器变成了攻击的“帮凶”。
- 方式:攻击者向全球大量的开放DNS服务器发送查询请求,但将请求报文中的源IP地址伪造成攻击目标的IP地址。
- 放大效应:DNS的响应报文通常比查询报文大得多。这样一来,攻击者只用发送很小的流量,就能触发大量的DNS服务器向受害者IP发送庞大的响应流量,从而形成拒绝服务攻击。
- 效果:虽然是一种有效的放大攻击手段,但随着各种防护措施的部署,其效果也受到了限制。
10 P2P 应用详解
- 没有(或极少)一直运行的 服务器
- 任意端系统都可以直接通信
- 利用peer的服务能力
- Peer节点间歇上网,每次IP 地址都有可能变化
10.1 P2P 应用实例
教师强调,P2P 是一种应用架构的类别,而非某个具体的应用。它可以被用于多种场景,例如:
- 文件分发:最著名的例子是 BitTorrent(常被戏称为 BT)。
- 流媒体:例如 看看 (KanKan)。教师特别提到,看看是首次出现在国外顶级教材中的中国技术解决方案。它让用户在观看视频点播时,流量主要来自其他用户节点而非中心服务器,极大地减轻了服务商的带宽和服务器成本。
- VoIP (网络电话):例如 Skype。它将语音通话数据通过互联网而非传统的电信网进行传输。教师补充说,我们现在常用的微信、QQ、钉钉等应用提供了效果更优的解决方案,它们同样也运用了 P2P 的技术思想。
10.2 性能对比分析:C/S vs. P2P
为了量化 P2P 架构的优势,我们通过一个具体场景来进行性能分析:从一台服务器将一个大小为 F 的文件分发给 N 个 Peer 节点,最少需要多少时间?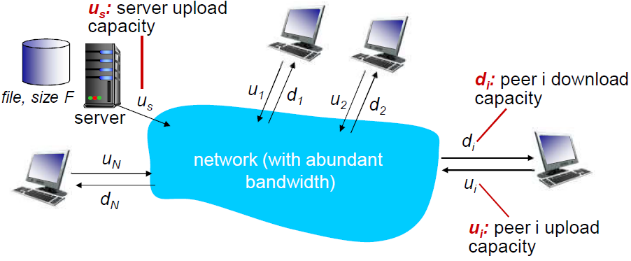
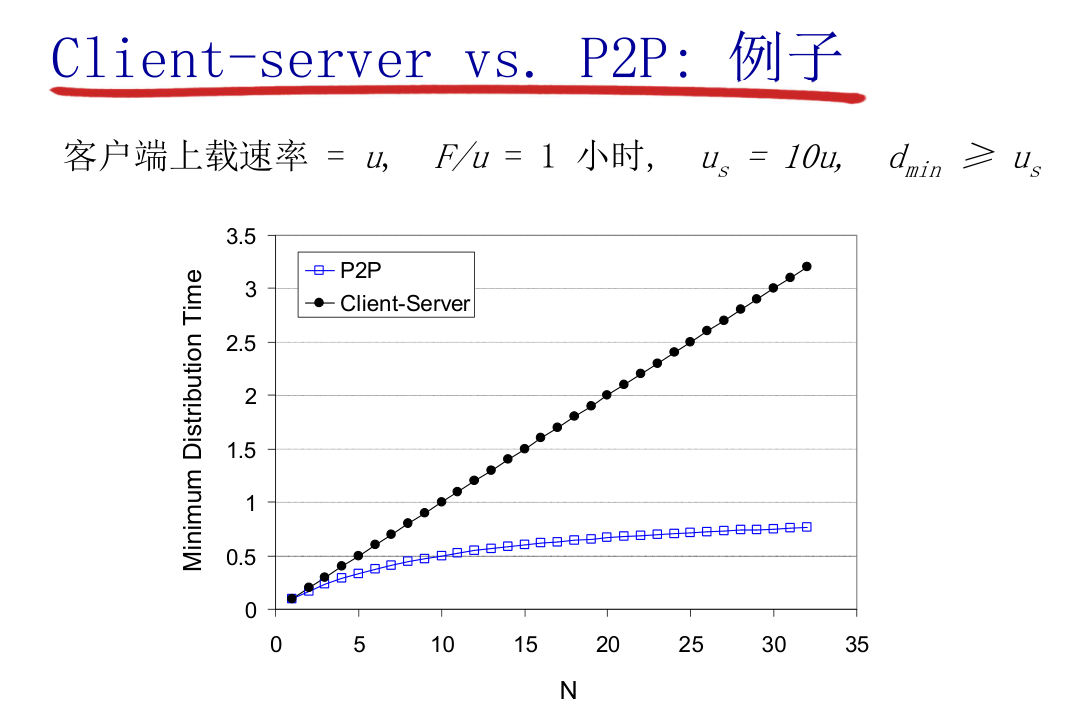
10.2.1 C/S 模式下的文件分发时间
在 C/S 模式下,所有客户端都直接从唯一的中心服务器下载文件。因此,客户端自身的上传能力()是无关紧要的。
我们从两个角度来分析时间的下限:
-
服务器上传的瓶颈:服务器必须向 N 个客户端分别上传一份文件的完整拷贝。因此,服务器总共需要上传的数据量为 。如果服务器的最大上传带宽为 ,那么仅上传这些数据就需要的时间至少为:
-
客户端下载的瓶颈:每个客户端都必须完整地下载一份大小为 F 的文件。所有客户端的下载速度可能不同,整个分发任务的完成时间取决于下载速度最慢的那个客户端。假设所有客户端中,最小的下载带宽为 ,那么最慢的客户端完成下载所需的时间为:
整个分发任务必须同时满足这两个条件,因此总耗时的下限()是这两个时间中的最大值。
对 C/S 模式耗时的解读
教师通过一个生动的比喻来解释这个公式的物理意义:
- 当 N 很小(例如 8 个客户端):服务器的上传能力很强,足以应对少数客户端(“一个打十个没问题”)。此时,瓶颈在于客户端的下载能力,即 这一项决定了总时间。
- 当 N 很大(例如 8 万个客户端):服务器的上传能力成了明显的瓶颈。服务器必须将其有限的上传带宽分配给海量的用户(如同“撒胡椒面”),分到每个用户的带宽就微乎其微了。此时, 这一项成为主导因素。
结论是,随着客户端数量 N 的增加,C/S 模式下的文件分发时间会线性增长,导致其可扩展性极差。
10.2.2 P2P 模式下的文件分发时间
在 P2P 模式下,情况发生了根本性的变化。除了服务器,每个 Peer 节点在下载数据的同时,也可以将自己已拥有的数据块上传给其他需要的 Peer 节点。
我们从三个角度来分析时间的下限:
-
服务器的初始上传:为了启动整个分发过程,服务器至少需要将一份完整的文件拷贝上传到 P2P 网络中。这个过程耗时至少为:
-
客户端下载的瓶颈:与 C/S 模式相同,最慢的客户端仍然需要下载一个完整的文件,其耗时下限依然是:
-
整个系统的总上传能力瓶颈:这是 P2P 模式的关键。所有 N 个客户端总共需要下载的数据总量仍然是 。但在 P2P 网络中,提供这些数据上传服务的不再仅仅是服务器,而是服务器和所有 Peer 节点的总和。整个系统的总上传带宽为服务器上传带宽 加上所有 Peer 节点的上传带宽之和 。因此,基于系统总上传能力的耗时下限为:
P2P 模式下的总耗时下限()是这三个时间中的最大值。
对 P2P 模式耗时的解读
分析这个公式,尤其是第三项,我们可以发现:
- 当客户端数量 N 增加时,分子 (总需求)线性增长。
- 但与此同时,分母 (总服务能力)也在随着 N 的增加而增长。
这意味着,请求资源的用户越多,贡献服务能力的用户也越多。这种“人人为我,我为人人”的精神,使得 P2P 系统的分发时间增长远非线性,而是非常平缓的。如课程图表所示,随着 N 的增加,P2P 模式的性能优势愈发明显,节约的时间也越多。
10.2.3 P2P 架构的挑战
尽管 P2P 在性能和可扩展性上优势巨大,但它也存在一个显著的问题:可管理性差。
P2P 网络具有高度的动态性:
- 节点的上线和下线是随机且频繁的。
- 节点上线后,其 IP 地址可能会变化。
- 不同节点所在的网络位置、拥有的资源、上传和下载带宽都各不相同。
这种高度的动态性和异构性,使得对一个大型 P2P 系统进行有效的管理和维护变得非常复杂和困难。
10.3 P2P 系统架构与管理
10.3.1 结构化与非结构化 P2P
P2P 系统主要可以分为两大类:非结构化 P2P (Unstructured P2P) 和结构化 P2P (Structured P2P)。
结构化 P2P,也常被称为基于分布式散列表(DHT, Distributed Hash Table)的 P2P 系统,其工作原理较为复杂,将在更高级的计算机网络课程中学习。本次课程的重点是非结构化 P2P。
10.3.1.1 概念:覆盖网络 (Overlay Network)
在理解 P2P 类型之前,必须先理解“覆盖网络”的概念。这是一个在应用层面上构建的逻辑网络。
- 节点 (Node):网络中的节点是 Peer,即一个个的应用进程。
- 边 (Edge):如果两个 Peer 之间存在协作关系(例如,为传输文件而建立的 TCP 连接),那么在覆盖网络中,它们之间就存在一条边。
这个网络是逻辑的,因为它与底层的物理网络拓扑不同。在覆盖网络中,两个 Peer 通过一条边直接相连,但在物理世界里,它们之间的数据传输可能需要经过许多路由器和物理链路。
10.3.1.2 定义区分
- 非结构化 P2P:Peer 节点之间建立邻居关系(overlay)(即覆盖网络的边)是任意的、随机的。整个覆盖网络的拓扑结构没有特定的规律。
- 结构化 P2P (DHT):Peer 节点之间的连接遵循着严格的规则,构成一个有序的覆盖网络,例如环状、树状或更复杂的拓扑结构。这种有序结构使得资源定位更加高效。
10.3.2 P2P 文件共享
10.3.2.1 场景描述
例子
- Alice在其笔记本电脑上 运行P2P客户端程序
- 间歇性地连接到 Internet,每次从其 ISP得到新的IP地址
- 请求“双截棍.MP3”
- 应用程序显示其他有“ 双截棍.MP3” 拷贝的对 等方
- Alice选择其中一个对等方, 如Bob.
- 文件从Bob’s PC传送到 Alice的笔记本上:HTTP
- 当Alice下载时,其他用户也 可以从Alice处下载
- Alice的对等方既是一个Web 客户端,也是一个瞬时Web 服务器
所有的对等方都是服务器 = 可扩展性好!
10.3.2.2 两个核心问题
以文件共享为例,任何 P2P 系统都必须解决两个核心问题:
- 如何定位所需资源? 即如何在一个庞大的分布式网络中,找到拥有特定文件的 Peer 节点。这本质上是一个目录服务问题。
- 如何处理节点的加入与离开? P2P 网络是高度动态的,必须有健壮的机制来管理节点的动态变化。
10.3.3 非结构化 P2P 实例分析
10.3.3.1 1. 集中式目录:Napster
Napster 是第一代 P2P 文件共享系统的代表,由一位美国大一本科生创建,初衷是在校园内免费分发 MP3 文件。它的架构特点是目录服务集中,文件传输去中心化。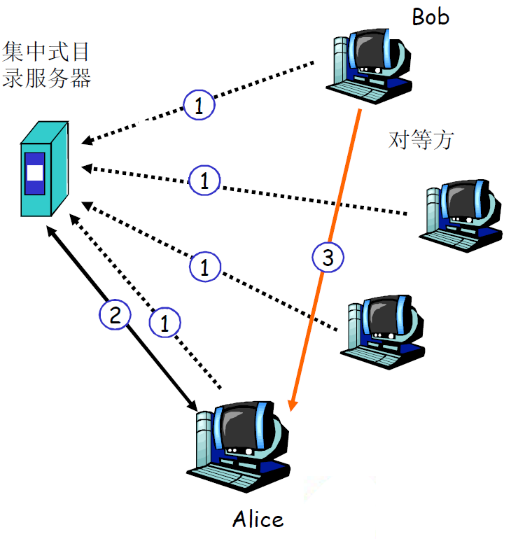
- 节点加入与注册:当一个 Peer(例如 Bob)上线时,它会向一个中心目录服务器进行注册,告知服务器自己的 IP 地址以及所共享的文件列表。服务器因此维护着一张包含所有在线 Peer 及其资源的动态表格。
- 资源查询:另一个用户 Alice 想要下载一首歌,她在 Napster 客户端中输入关键字进行搜索。该查询请求被发送到中心目录服务器。
- 获取 Peer 列表:服务器根据 Alice 的查询,在自己的数据库中进行索引,找到所有拥有该歌曲的在线 Peer,并将这个 Peer 列表(包含 IP 地址)返回给 Alice。
- 直接文件传输:Alice 的客户端从列表中选择一个 Peer(例如 Bob),然后直接与 Bob 的客户端建立一个 P2P 连接(如 HTTP 连接),开始下载文件。这个过程不经过中心服务器。
- 更新目录:当 Alice 下载完成后,她的客户端也会向中心服务器上报,表明自己也拥有了这个资源,从而可以为其他用户提供服务。
Napster 模式的缺点
尽管 Napster 开创了 P2P 的先河,但其集中式目录的设计带来了三个致命问题:
- 单点故障 (Single Point of Failure):如果中心目录服务器宕机,整个 P2P 网络就会瘫痪,用户无法再进行任何搜索。
- 性能瓶颈:随着用户数量的增多,所有节点的注册、查询和状态更新请求都会涌向中心服务器,使其不堪重负,成为整个系统的性能瓶颈。
- 法律风险:中心服务器的存在使其成为了一个明确的法律打击目标。版权所有者可以轻易地起诉运营该服务器的机构,指控其为盗版内容的传播提供了索引服务。最终,Napster 正是因此被法院判决“拔掉插头”。
10.3.3.2 2. 完全分布式:Gnutella 与查询泛洪
为了解决 Napster 的中心化问题,出现了像 Gnutella 这样的完全分布式 P2P 系统。在 Gnutella 中,没有中心服务器,所有 Peer 节点的地位完全平等。
Gnutella 是一个开放协议,因此存在许多遵循该协议的不同客户端实现,就像 HTTP 协议有许多不同的浏览器一样。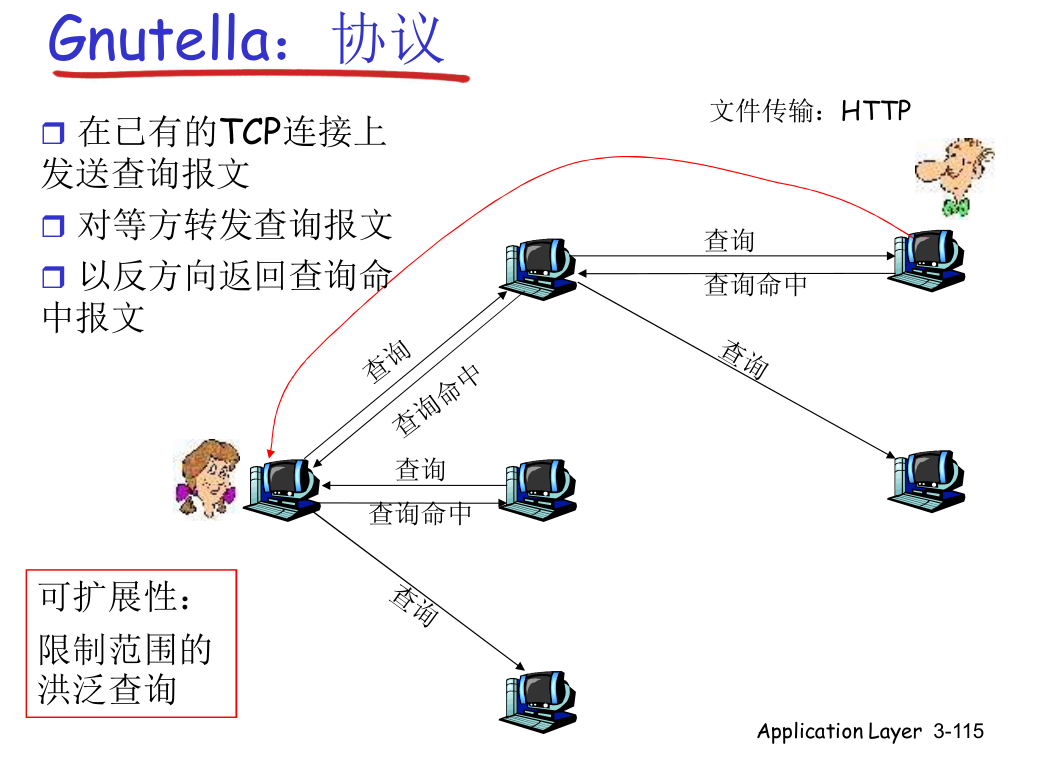
10.3.3.2.1 资源查询:查询泛洪 (Query Flooding)
在 Gnutella 中,资源查询采用一种被称为“泛洪”的广播方式:
- Alice 向她的所有邻居节点发送一个查询报文。
- 她的邻居收到后,会将这个查询报文转发给它们各自的所有邻居(除了发送该报文给它的那个邻居)。
- 这个过程不断重复,查询报文就像洪水一样迅速扩散到网络的广大区域。
- 如果某个节点拥有被查询的资源,它会沿着查询报文传播的反向路径发回一个命中(Hit)响应。
- 最终 Alice 收到响应,得知哪些节点拥有文件,然后与之建立直接连接进行下载。
泛洪的控制:不受控制的泛洪会产生巨大的网络流量,甚至可能因网络中的环路而无限循环。因此需要限制机制:
- TTL (Time-to-Live):为每个查询报文设置一个生存跳数(例如 5 或 7),每经过一个节点转发,TTL 值减 1。当 TTL 减为 0 时,报文不再被转发。
- 查询记录:中间节点会记住近期转发过的查询,如果再次收到相同的查询(可能来自一个环路),则不再转发。
10.3.3.2.2 覆盖网络的建立:节点的加入
Gnutella 的查询泛洪依赖于一个已经存在的覆盖网络。那么,一个新节点是如何加入这个网络的呢?
- 获取种子节点列表:Gnutella 客户端在安装时,会自带一个配置文件,其中包含了一些长期在线、比较稳定的“死党”节点的 IP 地址列表。
- 发送 Ping 报文:新加入的节点 X 会向列表中的这些“死党”节点发送
Ping报文,请求加入网络。 - Ping 的转发与 Pong 的响应:收到
Ping的节点,一方面会向 X 发回一个Pong报文作为响应,另一方面会将这个Ping报文转发给自己的所有邻居。这个过程会级联进行。 - 接收大量 Pong:由于
Ping报文被广泛转发,新节点 X 会从网络中大量不同的 Peer 处收到Pong报文。 - 建立邻居关系:X 从收到的众多
Pong响应中,随机选择若干个(例如 8 到 10 个)Peer,与它们建立 TCP 连接,从而成为它们的新邻居,成功融入覆盖网络。
10.3.3.2.3 覆盖网络的建立:节点的离开
如果对等方X离开呢?
- 节点X向所有邻居发消息要离开
- 所有的邻居都重新找一个节点连接来补充X,以满足图查找所需要的度
10.3.3.2.4 Gnutella 的现状
- 理论上很好,但是技术上难以实现(也有非技术原因)
- 之所以开源就是因为找不到东西,没人用
10.3.3.3 3. 混合型 (Hybrid) P2P 架构:KaZaA
为了兼顾查询效率和去中心化,诞生了以 KaZaA 为代表的混合型架构。这种架构引入了“组长”(Supernode)和“组员”的概念,形成一个两级结构。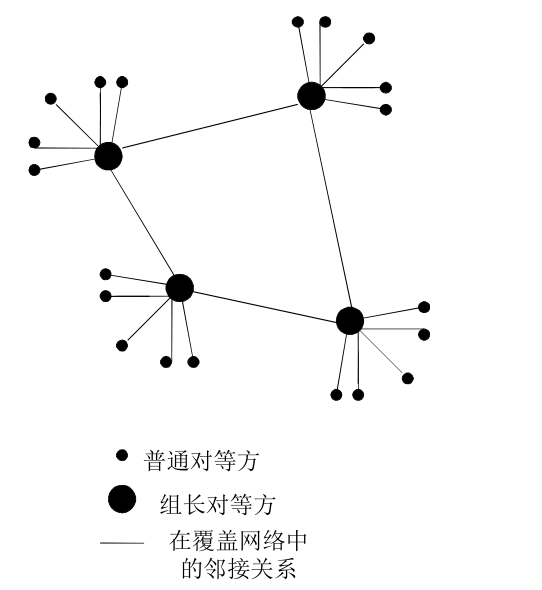
- 架构:一部分能力较强(如带宽大、在线时间长)的 Peer 会成为组长,其他普通 Peer 作为组员。每个组员都隶属于一个组长,并与之保持连接。同时,组长与组长之间也相互连接,形成一个分布式的骨干网络。
- 查询流程:
- 一个组员发出查询时,会先将请求发送给自己的组长。
- 组长首先在自己的组内(包含所有组员)进行查找。如果找到了,就直接将结果返回给查询者。这一步类似于集中式的目录服务。
- 如果组内没有找到,组长会将该查询转发给网络中的其他组长。组长之间的查询过程则类似于完全分布式的泛洪。
- 小组内部查询是集中式查询,组长和组长之间就是完全分布式查询
- 某一个对等体要查询,先向组长查询目录(查询谁有这个内容),如果组长知道,就直接返回;如果不知道,就向其他组长查询
这种混合模式通过在小组内实现高效的集中查询,同时在小组间保持分布式的健壮性,有效地提升了整个网络的查询效率。
10.3.3.3.1 KaZaA:查询
在讨论查询时,一个关键问题是如何精确地标识一个文件。如果仅用文件名,例如“某某歌手的歌”,会产生歧义,因为同一首歌可能有现场版、录音棚版,以及不同码率、不同格式的多个版本。
P2P 系统采用了一种更精确的分布式命名方式:内容哈希 (Content Hashing)。
- 文件描述 (Metadata):这是文件的可读信息,如歌名、歌手、专辑、版本(“真唱”、“现场版”)等。用户在搜索时,输入的就是匹配这些描述的关键字。
- 文件哈希 (Hash):在文件上传或被索引时,系统会通过哈希算法(如 SHA-1)对文件的完整内容进行计算,生成一个唯一的、固定长度的标识码(例如 16 或 20 字节)。这个哈希值是文件的“指纹”。
查询与下载流程:用户通过关键字搜索匹配到文件的描述信息后,客户端实际发起下载请求时,使用的不是文件名,而是该文件唯一的哈希值。这样就能确保无论文件被如何命名,下载到的一定是内容完全一致的那个文件。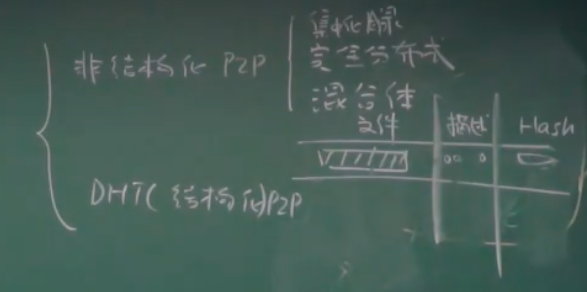
NOTE
- 文件的结构:每个文件有一个散列标识码(唯一Hash,上载时赋予)和一个描述符(描述信息,用户在检索的时候匹配描述)
- 文件本身
- 文件描述符(描述文件内容的,搜索的时候就通过文件描述符匹配)
- 散列标识码(唯一Hash,上载时赋予,用于唯一表示一个文件)
- 客户端向其组长发送关键字查询 ,组长用匹配(描述)进行响应:
- 对每个匹配:元数据、散列标识码和IP地址
- 如果组长将查询转发给其他组长,其他组长也 以匹配进行响应
- 客户端选择要下载的文件
- 向拥有文件的对等方发送一个带散列标识码的 HTTP请求
10.3.3.3.2 Kazaa小技巧
- 请求排队
- 限制并行上载的数量
- 确保每个被传输的文件从上载节点接收一定量的带宽
- 激励优先权
- 鼓励用户上载文件
- 加强系统的扩展性
- 并行下载
- 从多个对等方下载同一个文件的不同部分
- HTTP的字节范围首部
- 更快地检索一个文件
- 从多个对等方下载同一个文件的不同部分
10.3.4 结构化 P2P 简介:分布式散列表 (DHT)
最后,课程简要介绍了结构化 P2P 的核心思想——DHT。
- 统一哈希空间:节点(通过哈希其 IP 地址)和内容(通过哈希其本身)都被映射到同一个 ID 空间中。
- 有序的覆盖网络:所有节点根据其 ID 值,构成一个有序的逻辑拓扑,最典型的例子是环状拓扑。节点按 ID 大小首尾相连。
- 确定性路由:内容被存储在 ID 与其最“接近”的节点上(例如,存储在 ID 大于等于内容 ID 的第一个节点上)。当查询一个内容时,可以根据其哈希 ID,在环状网络上通过高效、确定的路由算法快速定位到存储它的节点,而无需进行全网泛洪。
- 大白话:这就是 DHT 最妙的地方——制定一个规则,明确规定每个“文件 ID”应该由哪个“节点 ID”来负责管理。
- 规则(以 Chord 算法为例):一个内容 (ID),由它在环上顺时针方向的第一个节点(即 ID 大于等于它的第一个节点,称为“后继节点”)来负责。
DHT 方案能够以极少的副本数量实现快速、精准的资源定位,在现代许多分布式系统中应用广泛。
10.4 案例分析:BitTorrent (BT)
BitTorrent(常被戏称为 BT 或“变态”)是目前最成功、最广泛的 P2P 文件分发应用。它在设计上综合了多种思想,非常高效。
10.4.1 核心概念
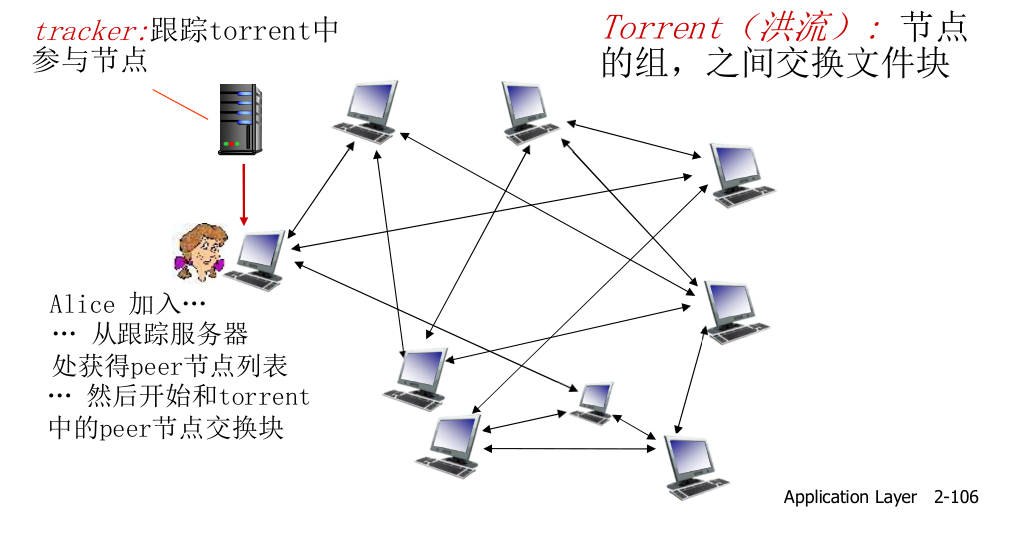
- Torrent (洪流):指所有正在共同下载和上传同一个文件(或文件集) 的 Peer 组成的群体。老师将其生动地比喻为一个“互通有无的学习小组”。
- Tracker:一个协调服务器。它不存储文件本身,只负责跟踪记录当前洪流中有哪些 Peer 节点,并帮助新加入的 Peer 找到其他 Peer。
- 文件块 (Chunks):一个大文件被预先分割成许多个大小相等的、较小的文件块(256KB)。Peer 之间交换的基本单位就是这些块。
- 种子 (Seed) & 吸血鬼 (Leecher):拥有 100% 文件块的 Peer 称为“种子”,它只上传不下载。而正在下载、尚未拥有全部文件块的 Peer 称为“吸血鬼”。
10.4.2 资源定位:BitMap 与信息交换
在洪流内部,Peer 之间需要知道彼此拥有哪些文件块。这是通过 BitMap(位图)机制解决的。
- BitMap:一个二进制串,每一位对应文件的一个块。如果某位是
1,代表该 Peer 拥有对应的块;如果是0,则代表没有。这是一个非常紧凑的目录信息。 - 信息交换:洪流中的 Peer 会周期性地互相交换各自的
BitMap。通过这种方式,每个 Peer 都能实时了解到邻居们拥有文件块的分布情况,从而知道该向谁请求自己需要的块。
BitMap全是0的是吸血鬼,全是1的是种子
10.4.3 下载策略:请求文件块
Requesting chunks:
- at any given time, different peers have different subsets of file chunks
- periodically, Alice asks each peer for list of chunks that they have
- Alice requests missing chunks from peers, rarest first
BT 的下载策略非常精妙,它将集体利益与个人利益巧妙地结合在一起。
-
初始阶段 - 随机请求:一个新加入的 Peer (吸血鬼) 一开始什么都没有,它的
BitMap全是0。此时它会随机地向邻居请求下载最初的几个(例如 4 个)文件块。这个阶段如同“饥不择食”,目标是尽快拥有一些可以与其他 Peer 交换的资本。 -
稳定阶段 - 稀缺优先 (Rarest First):一旦拥有了几个文件块,该 Peer 的下载策略立刻转变为请求最稀缺的块。它会分析所有邻居的
BitMap,找出在整个洪流中副本数量最少的块,并优先请求下载。
“稀缺优先”策略的好处:
- 对集体有利:可以快速补齐稀缺块的副本数,避免因唯一拥有该块的 Peer 下线而导致文件永远无法下载完整,从而提升整个洪流的“健康度”。
- 对个人有利:当你拥有了稀缺块,你对于其他 Peer 的价值就提高了。根据 BT 的上传策略,其他 Peer 会更愿意向你上传数据,从而提升你自己的下载速度。
10.4.4 上传策略:Tit-for-Tat (一报还一报)
BT 的上传策略是其设计的精髓,它激励分享,惩罚自私。
- 有限疏通 (Limited Unchoking):一个 Peer 不会同时为所有请求者提供上传服务(“不是撒向人间都是爱”)。它会设置一个并发上传数量上限(通常是 4 个)。它会主动为这 4 个 Peer 提供上传,这个过程叫“疏通”(Unchoke);而其他所有请求者则被暂时“阻塞”(Choke)。
- 上传配额分配:决定疏通哪 4 个 Peer 的机制如下:
- 回报最高者优先 (每十秒):每隔十秒Peer 会评估所有向它请求的节点,并优先疏通那些在上一个周期中为它提供了最快下载速度的 4 个节点。这就是“你对我好,我就对你好”的“一报还一报”原则。
- 随机试探 (每30s):每30s,Peer 会随机选择一个被阻塞的节点进行“优化疏通”(unchocked)。这么做的目的是为了发现新的、潜在的优质伙伴(“不知道哪块云彩会下雨”)。如果这个被随机选中的“黑马”恰好能提供很高的上传速度,那么在下一个评估周期,它就有可能凭实力进入“回报最高”的前 4 名。
Sending chunks: tit-for-tat
- Alice sends chunks to those four peers currently sending her chunks at highest rate
- other peers are choked by Alice (do not receive chunks from her)
- re-evaluate top 4 every10 secs
- every 30 secs: randomly select another peer, starts sending chunks
- “optimistically unchoke” this peer
- newly chosen peer may join top 4
10.4.5 加入洪流的完整流程
一个用户加入 BT 洪流的过程是“带外解决”(Out-of-band)的,即需要借助 BT 网络之外的系统。
- 用户通过常规的搜索引擎或 BT 网站,找到并下载一个
.torrent种子文件。 - 这个
.torrent文件很小,里面包含了文件的元数据(如文件块的哈希值列表)以及 Tracker 服务器的地址。 - 用户的 BT 客户端打开该文件,连接到 Tracker 服务器,并请求加入洪流。
- Tracker 服务器返回一个当前洪流中的部分 Peer 节点的 IP 地址列表。
- 客户端根据这个列表与其他 Peer 建立连接,正式成为洪流的一员,开始交换
BitMap并遵循上述策略下载和上传文件块。
Sending chunks: tit-for-tat
- Alice sends chunks to those four peers currently sending her chunks at highest rate
- other peers are choked by Alice (do not receive chunks from her)
- re-evaluate top 4 every10 secs
- every 30 secs: randomly select another peer, starts sending chunks
- “optimistically unchoke” this peer
- newly chosen peer may join top 4
(1) Alice “optimistically unchokes” Bob
(2) Alice becomes one of Bob’s top-four providers; Bob reciprocates
(3) Bob becomes one of Alice’s top-four providers
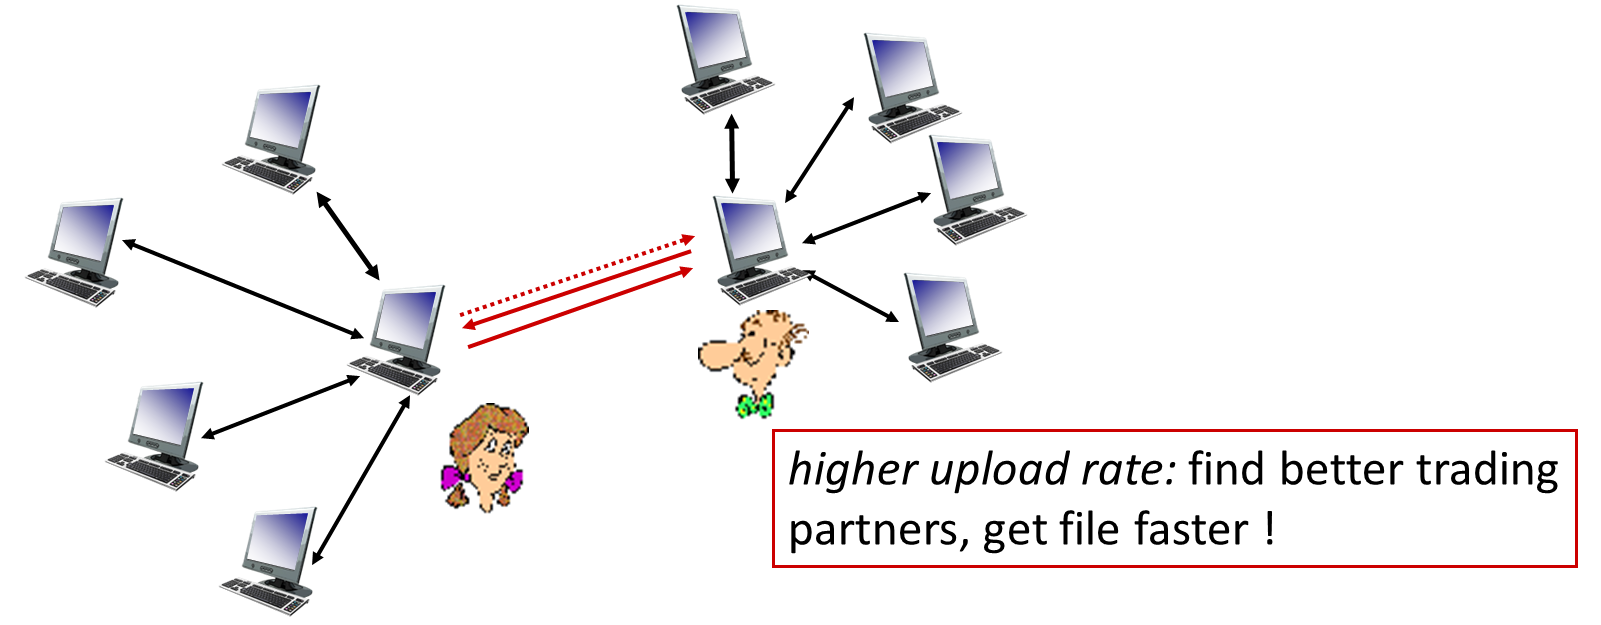
11 CDN
11.1 视频服务面临的核心挑战
随着视频业务的普及,服务提供商面临着前所未有的挑战。过去,为几十或几百个用户提供并发视频播放服务相对简单,但现在需要同时为数百万甚至上亿的用户提供高质量服务。
11.1.1 挑战一:规模性 (Scalability)
核心问题在于,如何为海量用户(例如YouTube的10亿用户)提供稳定、并行的流化视频服务?显然,依赖单台或少数几台“超级服务器”是无法应对如此巨大规模的并发请求的。
11.1.2 挑战二:异构性 (Heterogeneity)
另一个巨大挑战来自用户端的多样性。不同用户的网络环境、设备能力和观看需求千差万别。
老师举例说明:手机用户屏幕尺寸小,观看视频时并不需要极高的分辨率。但如果用户在家中使用100寸的网络电视,一个低分辨率(如800x600)的视频会显得非常模糊,无法满足其观看需求。因此,服务必须能够适应不同用户的带宽条件和设备处理能力。
为了应对这些挑战,业界的解决方案是构建一个分布式的、位于应用层的基础设施,也就是我们接下来要深入学习的CDN(内容分发网络)。
11.2 多媒体基础:理解视频
11.2.1 视频压缩的原理:空间与时间冗余
视频压缩技术之所以有效,是利用了视频数据在空间和时间维度上存在的冗余。
- 空间冗余 (Spatial Redundancy):指在一帧图像内部存在的冗余。例如,一帧画面中的天空部分,可能包含大量颜色相同或相近的像素点。压缩时,无需存储每个像素的颜色值,只需记录“某个颜色值持续了多少个像素”,即可大大减少数据量。
- 时间冗余 (Temporal Redundancy):指在相邻的视频帧之间存在的冗余。例如,在一个镜头中,背景是静止的,只有人物在移动。那么在传输后续帧时,只需编码和传输发生变化的部分(即移动的人物),而无需重复传输整个静止的背景。
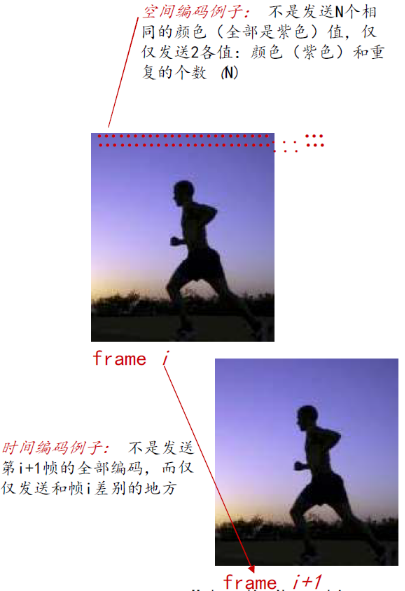
11.2.2 视频编码方案:CBR 与 VBR
利用上述冗余特性,发展出了多种视频编码方案。
- CBR (Constant Bit Rate): 即固定码率编码。无论视频内容是简单还是复杂,都以一个相对固定的码率(如1.5Mbps)进行压缩。
- VBR (Variable Bit Rate): 即可变码率编码。码率会根据视频画面的复杂程度动态变化。当画面是静态风景时,码率会很低;而当画面切换到激烈的打斗场景时,码率会瞬间变得很高。
老师还补充提到了MPEG系列、我们国家主导的AVS等国际编码标准,并特别指出中国科学技术大学在多媒体编码领域的科研实力很强,例如由信息学院李卫平教授提出的可伸缩编码(Scalable Video Coding) 技术。这项技术能根据不同终端(手机、PC、大屏电视)的需求,提供相应解析度的视频流,有效解决了异构性的问题。
11.3 流化服务 (Streaming)
在网络上观看视频,最常用的方式是“流化服务”(Streaming)。它与传统的“先下载后播放”(Download and Play)模式有本质区别。
“先下载后播放”模式要求用户必须等待整个视频文件(可能高达数GB)全部下载完成后才能开始观看,等待时间非常长。
而流化服务则实现了“一边下载,一边观看”。用户设备(如机顶盒)上有一个缓冲区,网络数据流不断地填充这个缓冲区,同时播放器从缓冲区中提取数据进行播放。这种并行处理的方式,极大地缩短了用户的等待时间,实现了“即点即播”的良好体验。老师风趣地描述道:“现在会员甚至没有广告,点完水都没来得及倒,视频就开始播放了。”
11.3.1 Streaming stored video (ideal case)
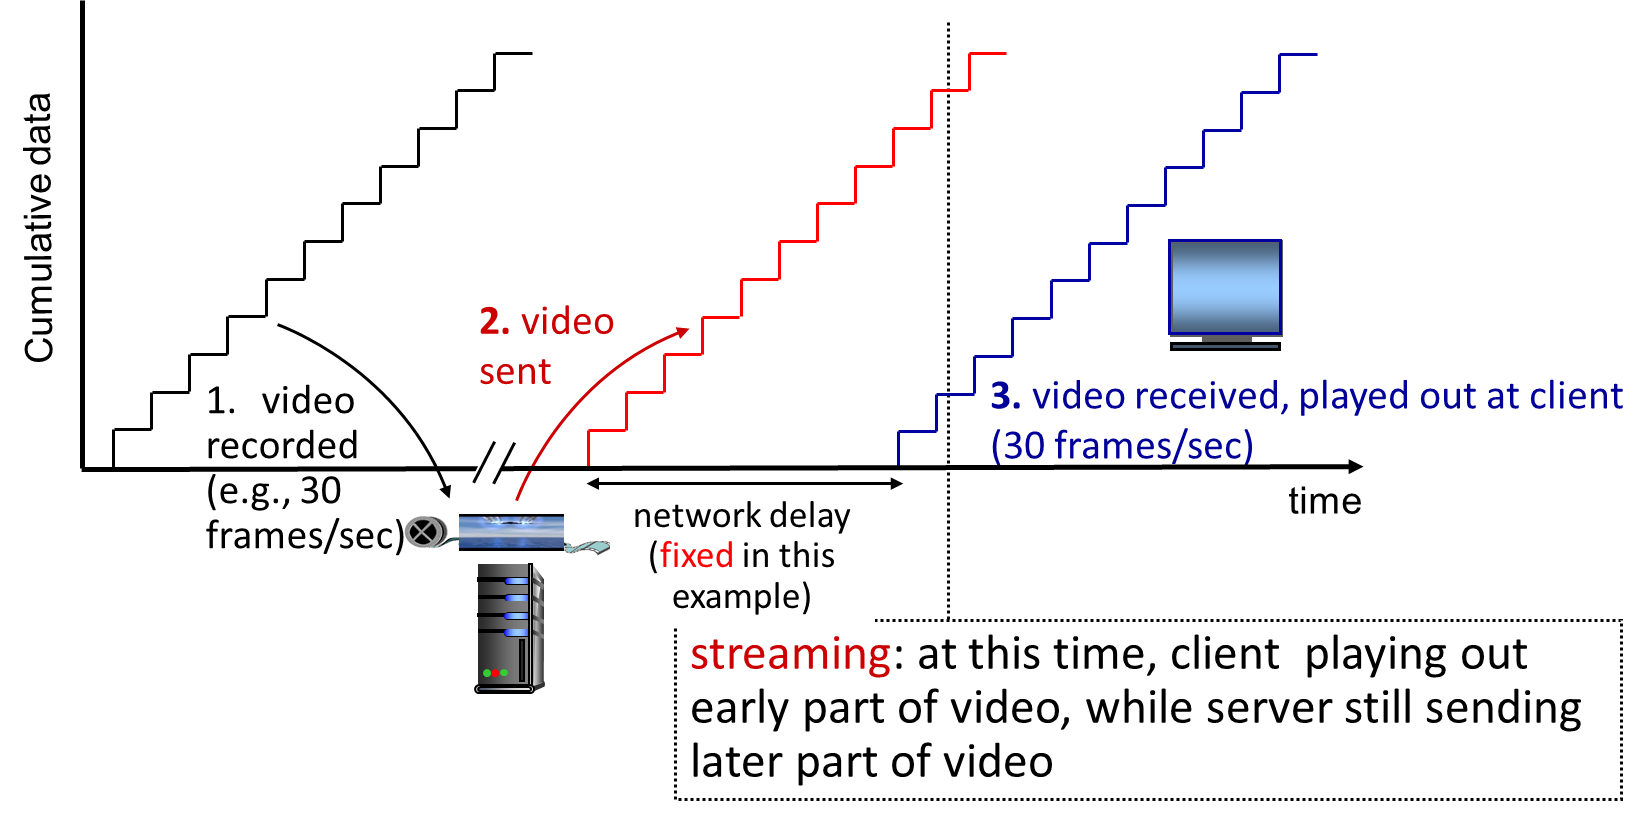
11.3.2 Streaming stored video: challenges
- continuous playout constraint: during client video playout, playout timing must match original timing
- … but network delays are variable (jitter), so will need client-side buffer to match continuous playout constraint
- other challenges:
- client interactivity: pause, fast-forward, rewind, jump through video
- video packets may be lost, retransmitted
11.3.3 Streaming stored video: playout buffering
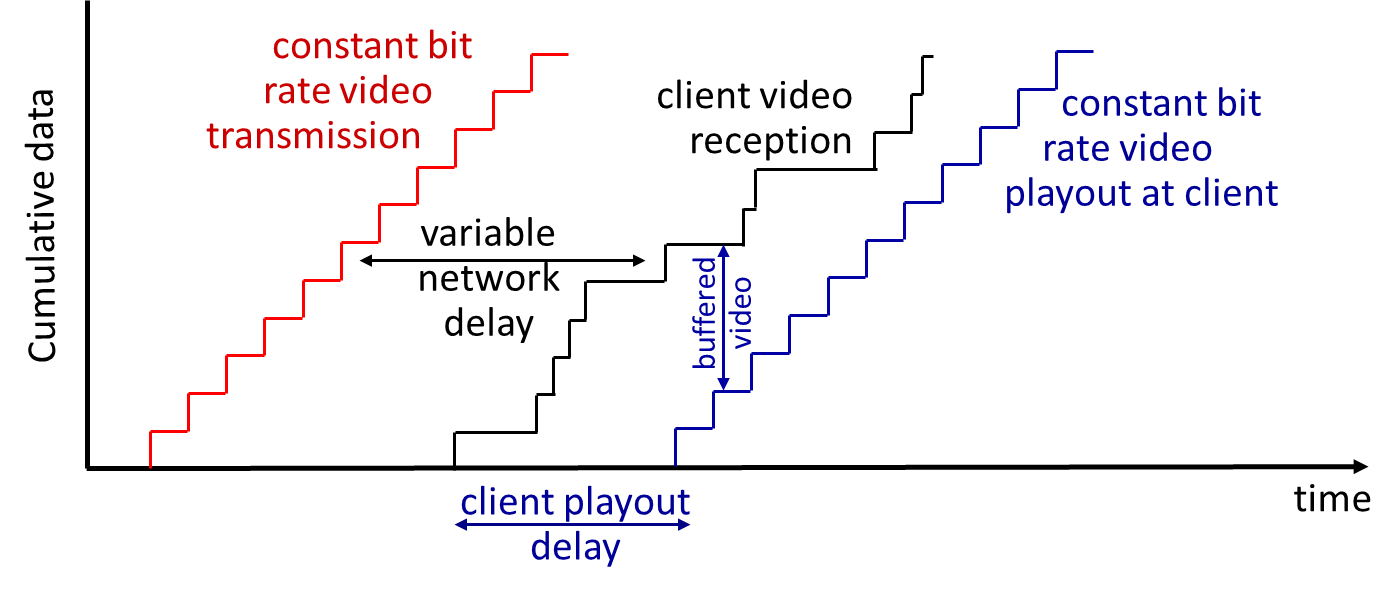
11.4 DASH:动态自适应HTTP流化技术
DASH (Dynamic, Adaptive Streaming over HTTP) 是当前主流的一种流化技术。它构建在通用的HTTP协议之上,这表明HTTP不仅可以用于浏览网页,也可以作为音视频等内容的传输协议。DASH技术的核心目标是解决前面提到的“异构性”问题。
11.4.1 服务器端的准备工作
- 视频分块 (Chunking):服务器首先将一个完整的视频文件,切割成许多个时长较短(例如8-10秒)的独立小块(Chunk)。
- 多码率编码 (Multi-Bitrate Encoding):服务器会对每一个小块,都编码生成多个不同版本,例如超低、低、中、高、超高等多种不同的分辨率和码率。
- 生成告示文件 (Manifest File):服务器会创建一个“告示文件”(Manifest File)。这个文件是DASH的核心,它详细描述了该视频的所有信息:被分成了多少块、每一块有哪些不同的码率版本、以及每个特定版本的视频块存放的URL地址是什么。这些视频块可以被预先部署到不同的服务器上。
11.4.2 客户端的“智能”决策
客户端在播放视频时,会执行一套智能的自适应流程:
-
获取告示文件:播放开始前,客户端首先下载并解析这个Manifest文件,从而了解整个视频的结构和所有可用视频块的位置。
-
动态决策:客户端会根据自身情况,动态地决定接下来要请求哪一个视频块。这个决策过程是持续进行的,主要依据以下几个因素:
- 何时请求:智能地管理自己的缓冲区,确保在当前视频块播放完之前,下一个视频块已经被下载回来,从而避免播放卡顿(即“努力缓冲中…”);同时也要防止请求过快导致缓冲区溢出。
- 请求什么速率:客户端会周期性地测量当前可用的网络带宽。如果带宽充足,且设备性能允许,它会请求最高码率的视频块,为用户提供最佳画质。老师形容这种情况是“心里有底,让用户爽一爽”。反之,如果网络状况不佳,或缓冲区即将耗尽,它就必须请求一个低码率的视频块来保证播放的流畅性。老师形象地说,这时客户端“没有资本和资格”去请求高质量的块。
- 从哪里请求:Manifest文件中可能包含来自不同服务器的URL,客户端可以选择向离自己最近或响应最快的服务器发送请求。
通过这套机制,DASH技术使得客户端能够根据网络状况和设备能力,在播放同一个视频的过程中,无缝地在不同清晰度之间切换,最终目标是在保证流畅播放的前提下,尽可能提供最高的视频质量。
11.5 CDN:应对规模性挑战的解决方案
11.5.1 单一“超级服务器”模式的问题
假设我们尝试用一台或一组集中的“超级服务器”(Mega-Server)来为所有用户服务,会遇到以下几个难以克服的瓶颈:
- 路径长、瓶颈多: 对于地理位置遥远的用户,数据需要经过非常多的网络跳数才能到达。这条长路径中任何一个环节出现带宽瓶颈,都会直接影响用户的观看体验,导致停顿和缓冲。老师强调,服务器自身无论如何优化(例如升级网卡和出口带宽),都无法控制和改善中间复杂的网络链路状况。
- 流量重复与资源浪费: 网络内容的访问遵循“二八定律”,即少数热门内容(如热门剧集《纸牌屋》)会占据绝大多数的流量。在单一服务器模式下,成千上万的用户会同时请求和下载同一份内容,导致同样的数据包在网络骨干道上被重复传输无数次,这是对带宽资源的巨大浪费。
- 单点故障与性能瓶颈: 整个服务都依赖于这个中心服务器集群。一旦它出现故障,所有用户都将无法访问。同时,它本身以及其周边的网络,也很容易成为整个系统的性能瓶颈,引发大面积网络拥塞。
综上所述,这种集中式的服务模式不具备可扩展性。
11.5.2 CDN 的核心思想与工作原理
为了解决以上问题,CDN(Content Distribution Network,内容分发网络)应运而生。它的核心思路非常简单,正如老师所说,就是让内容靠近用户。
CDN通过在全球范围内部署大量的缓存节点(Cache Server),构建起一个应用层的内容分发网络。内容提供商(ICP)将他们的服务内容(如视频、网页、图片)预先存储到这些分布式的缓存节点上。当用户请求内容时,系统会通过智能的调度,让用户从地理位置最近、网络质量最好的缓存节点获取数据,而不是从遥远的源服务器获取。
这种服务模式,我们称之为内容加速服务。
11.5.3 CDN 生态系统中的新角色:CDN运营商
CDN的出现,在互联网中引入了一个新的关键角色——CDN运营商。传统的互联网参与者主要有终端用户、ISP(互联网服务提供商)和ICP(互联网内容提供商)。现在,CDN运营商(如美国的Akamai,中国的蓝汛/ChinaCache)作为独立的商业实体,为ICP提供专业的内容加速服务。
像CCTV、百度、凤凰网等内容提供商,会付费购买CDN运营商的服务,以确保他们的用户无论身在何处,都能获得快速、稳定的访问体验。
- CDN运营商(国内国外都有运营商,比如国外的Akamai,中国蓝汛)在全网部署缓存节点cache server
- ICP购买运营商的服务,将自己的视频缓存到cache节点中
- 客户端在请求的时候,通过DNS,映射到离自己最近的,速度最快的cache
11.5.4 CDN 缓存节点的两种部署策略
CDN运营商需要在全球部署缓存节点,具体“撒点”的位置主要有两种主流策略:
- Enter Deep(深入群众)
这种策略主张将缓存服务器尽可能深地部署到各个地区的本地接入ISP网络内部。这样做的好处是服务器离终端用户非常近,网络跳数极少,拥塞情况可控,因此能提供质量最高的加速服务。然而,缺点是需要部署和维护的节点数量极其庞大(老师提到Akamai有数千个节点),管理复杂且成本高昂。
- enter deep: push CDN servers deep into many access networks
- close to users
- Akamai: 240,000 servers deployed in > 120 countries (2015)
- enter deep: push CDN servers deep into many access networks
- Bring Home(卡住关键少数) 与深入群众不同,这种策略选择在少数(例如十几个)关键网络枢纽位置部署大规模的服务器集群。这些位置通常是大型数据中心或高层级ISP的POP点(Point of Presence)附近。虽然服务器到用户的跳数相对多一些,但通过占据这些关键位置并使用高速线路连接,依然能提供非常好的服务。它的优势在于节点少,更易于管理和维护,成本也更低。
- bring home: smaller number (10’s) of larger clusters in POPs near access nets
- used by Limelight
11.5.5 CDN 的完整工作流程
 以用户通过CDN观看Netflix视频为例,整个过程大致如下:
- 内容预部署: Netflix(作为ICP)首先购买了Akamai(作为CDN运营商)的服务,并提前将热门视频内容(例如某部电影)的多个码率版本,分发并缓存到Akamai遍布全球的CDN节点上。
- 获取告示文件: 用户点击播放。如上节课所述,客户端首先会从Netflix的源服务器获取该视频的Manifest File(告示文件)。
- 智能调度与重定向: Manifest文件中包含了视频所有分块的URL。此时,通过DNS重定向等技术,用户的请求会被智能地导向到离他最近或当前访问质量最佳的一个CDN缓存节点。客户端会拿到指向这个CDN节点的URL。
- 就近获取内容: 客户端直接向这个被指定的、近在咫尺的CDN缓存节点请求视频数据块,开始流化播放。由于路径短、网络好,播放体验非常流畅。
老师用央视春晚直播的例子进一步说明了CDN的价值。如果没有CDN,数以亿计的并发请求会瞬间压垮央视的源服务器。而通过购买蓝汛的CDN服务,直播流被实时分发到全国各地的缓存节点,用户从本地节点获取视频流,从而保证了这一网络盛事的顺利进行。
11.5.6 CDN 的特点:Over the Top (OTT)
老师特别指出了CDN的一个重要特点:它是一种“Over the Top”(OTT)服务。
Internet host-host communication as a service
在互联网“Everything over IP”的架构理念下,网络核心层(路由器)只负责最基础的数据包转发工作。所有复杂、智能的应用逻辑都在网络的“顶层”——即应用层——通过主机与主机之间的通信来实现。CDN正是这种理念的体现,它没有改造网络核心,而是在网络边缘部署应用层服务器(缓存节点),通过软件和服务来完成内容加速这一高级功能。
11.5.7 CDN 运营面临的挑战
OTT challenges: coping with a congested Internet from the “edge”
- what content to place in which CDN node?
- from which CDN node to retrieve content? At which rate? 最后,老师提到运营一个庞大的CDN网络是一个非常复杂的系统工程,面临诸多挑战,这些通常是研究生阶段才会深入研究的课题:
- 从哪个节点获取内容? 当多个CDN节点都缓存了用户所需的内容时,系统如何为用户做出最优的选择?
- 网络拥塞时怎么办? 如果用户到当前节点的网络路径突然发生拥塞,系统应如何平滑地将用户切换到另一个更好的节点?
- 在哪些节点存储什么内容? 对于CDN运营商而言,这是一个核心的部署策略问题。哪些内容应该全网分发?哪些内容只部署在部分区域?这需要综合考虑成本、用户分布、内容热度等多种因素,背后是复杂的运筹学和优化算法。
11.6 CDN工作流程案例分析
为了具体理解CDN是如何运作的,老师通过一个简化模型和一个真实世界的案例(Netflix)进行了详细讲解。
11.6.1 场景一:简化的内容访问模型
我们首先来看一个简化的“玩具版本”场景,以便清晰地理解其核心机制。
在这个例子中,我们有两个主要角色:
- ICP (内容提供商):
netcinema.com - CDN (内容分发网络运营商):
KingCDN.com
整个流程的核心是域名解析重定向(DNS Redirection),具体步骤如下:
- 用户Bob在浏览器中打开
netcinema.com的网站,并点击了一个视频链接,该链接指向http://netcinema.com/video_xyz。 - Bob的计算机会向其本地DNS服务器发起请求,希望能解析
netcinema.com这个域名以获取其IP地址。 - 本地DNS服务器经过标准的迭代查询,最终会找到
netcinema.com的权威DNS服务器。 - 【关键步骤】
netcinema.com的权威DNS服务器并不直接返回其Web服务器的IP地址。相反,它会返回另一个域名,告诉客户端:“要访问这个视频,请去解析这个新域名:video.KingCDN.com/video_abc”。这就是重定向。 - Bob的本地DNS服务器收到这个新域名后,会再次发起一次新的DNS查询,这次的目标是解析
KingCDN.com。 KingCDN.com的权威DNS服务器接收到请求。它内部维护了一套CDN簇选择策略,会根据Bob的IP地址等信息,判断出离Bob最近、服务质量最好的一个缓存节点(Cache Server)。然后,它将这个最佳缓存节点的IP地址返回给Bob。- 最终,Bob的电脑拿到了这个来自KingCDN的IP地址,并直接向这个IP地址对应的缓存服务器发起HTTP请求,开始进行DASH流化播放。
- The user visits the Web page at NetCinema.
- When the user clicks on the link http://video.netcinema.com/6Y7B23V, the user’s host sends a DNS query for video.netcinema.com.
- The user’s Local DNS Server (LDNS) relays the DNS query to an authoritative DNS server for NetCinema, which observes the string “video” in the hostname video.netcinema.com. To “hand over” the DNS query to KingCDN, instead of returning an IP address, the NetCinema authoritative DNS server returns to the LDNS a hostname in the KingCDN’s domain, for example, a1105.kingcdn.com.
- From this point on, the DNS query enters into KingCDN’s private DNS infrastructure. The user’s LDNS then sends a second query, now for a1105.kingcdn.com, and KingCDN’s DNS system eventually returns the IP addresses of a KingCDN content server to the LDNS. It is thus here, within the KingCDN’s DNS system, that the CDN server from which the client will receive its content is specified.
- The LDNS forwards the IP address of the content-serving CDN node to the user’s host.
- Once the client receives the IP address for a KingCDN content server, it establishes a direct TCP connection with the server at that IP address and issues an HTTP GET request for the video. If DASH is used, the server will first send to the client a manifest file with a list of URLs, one for each version of the video, and the client will dynamically select chunks from the different versions.
通过这个流程,我们可以看到,尽管后台发生了一系列复杂的DNS查询和重定向,但整个过程对用户Bob来说是完全透明的。他只是点击了一个链接,视频就开始播放,他并不知道内容实际上是从一个近在咫尺的CDN缓存服务器而非遥远的netcinema源站获取的。这个过程无需修改用户的客户端或浏览器,实现了无缝对接。
11.6.2 场景二:Netflix的真实世界案例
接下来,老师以全球流媒体巨头Netflix为例,介绍了真实世界中CDN的应用。
11.6.2.1 Netflix的业务模式与技术特点
老师首先补充介绍了Netflix的背景。它不仅仅是一个视频播放平台,同时也是一个强大的内容制作公司,出品了像《纸牌屋》等许多脍炙人口的作品。
Netflix的成功之处在于它彻底改变了人们观看影视剧的方式,从传统的线下租借录像带、DVD,演变成了线上即时点播。更重要的是,它开创了一种数据驱动的内容制作模式:一边拍摄,一边播放,同时收集和分析海量的用户反馈数据,来判断什么样的剧情更能吸引观众,并据此调整后续的拍摄方向。这种快速迭代的制作周期,使其能精准地抓住用户的兴趣点。
11.6.2.2 Netflix的云+多CDN架构
在技术架构上,Netflix采取了一种非常聪明和灵活的策略:
- 自有核心服务:对于用户注册、账户管理、计费认证等核心业务,Netflix使用自己维护的服务器,以确保数据安全和业务稳定。
- 拥抱云计算:Netflix将其网站、视频制作和处理等大量计算任务都放在了亚马逊的云(AWS)上。这样做极大地降低了其一次性的硬件投入成本,获得了极高的弹性。
- 采用多CDN分发:在内容分发环节,Netflix并不依赖于单一的CDN提供商,而是同时与Akamai, Limelight, Level-3等多家顶级CDN运营商合作。
11.6.2.3 Netflix的完整用户访问流程
结合其架构,一个用户在Netflix上观看视频的完整流程如下:
- 内容上传与分发:Netflix在亚马逊云上完成视频的制作和编码(生成不同码率的版本)后,会将这些视频文件上传并部署到Akamai、Limelight等多个CDN合作伙伴遍布全球的缓存节点上。
- 用户认证:用户Bob首先需要通过Netflix自有的认证服务器完成账户登录。
- 浏览与请求:登录后,Bob在Netflix的网站(托管在AWS上)上浏览视频库,并点击一部电影。
- DNS重定向与获取Manifest:与简化模型类似,系统会触发一次DNS重定向,为Bob选择一个最优的CDN提供商及其缓存节点。随后,客户端从Netflix的服务器(可能也在云上)获取该视频的Manifest文件。
- DASH流化播放:Manifest文件中包含了指向CDN缓存服务器上视频分块的URL。Bob的播放器解析该文件后,直接向被选定的CDN缓存节点发起请求,开始进行DASH动态自适应流化播放。
通过这套“自有核心 + 云计算 + 多CDN”的混合架构,Netflix成功地为全球上亿用户提供了稳定、高质量的流媒体服务。
12 TCP 套接字编程
报文,实现应用协议,实现应用
- TCP/IP:应用进程使用Socket API访问传输服务
- 地点:界面上的SAP(Socket)
- 方式:Socket API
- 目标: 学习如何构建能借助sockets进行通信的C/S应用程序
socket: 分布式应用进程之间的门,传输层协议提供的端到端服务接口
2种传输层服务的socket类型:
- TCP: 可靠的、 字节流 的服务
- UDP: 不可靠(数据UDP数据报)服务
套接字:应用进程与端到端传输协议(TCP或UDP)之间 的门户
TCP服务:从一个进程向另一个进程可靠地传输字节流
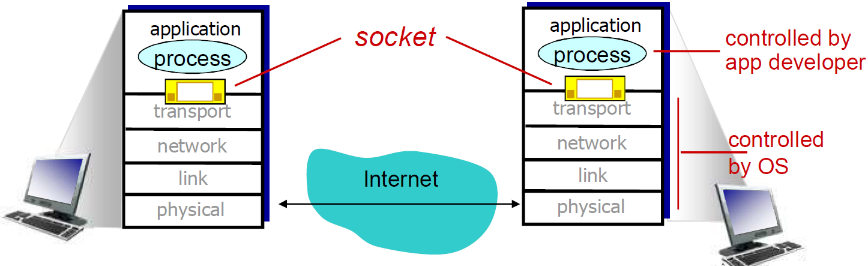
12.1 传输层协议:TCP 与 UDP
TCP/IP 协议栈在传输层提供两种主要协议:
- TCP (Transmission Control Protocol)
- 提供可靠的、面向连接的字节流(Byte Stream)服务。
- “可靠”意味着数据传输不错、不丢、不重、不失序。
- “字节流”意味着 TCP 不保证应用报文的边界。发送方的两次发送可能在接收方被合并为一次接收。因此,应用层协议需要自己维护报文的边界。
- UDP (User Datagram Protocol)
- 提供不可靠的、无连接的服务。
- “无连接”指的是通信前没有“握手”过程,直接发送数据,效率较高。
12.2 TCP Socket 编程详解
12.2.1 Socket 的概念
在编程中,一个 TCP Socket 通常表现为一个整数,类似于文件句柄(File Handle)。这个整数是操作系统内核中一个复杂数据结构的代表,它唯一标识了一个 TCP 连接。
这个整数代表了一个四元组的连接关系:{ 本地 IP, 本地 TCP 端口, 对方 IP, 对方 TCP 端口 }。对这个 Socket 进行写操作,就是向对方的应用进程发送数据;对它进行读操作,就是接收来自对方的数据。
Socket programming with TCP
Client must contact server
- server process must first be running
- server must have created socket (door) that welcomes client’s contact
Client contacts server by:
- Creating TCP socket, specifying IP address, port number of server process
- when client creates socket: client TCP establishes connection to server TCP
- when contacted by client, server TCP creates new socket for server process to communicate with that particular client
- allows server to talk with multiple clients
- source port numbers used to distinguish clients (more in Chap 3)
Application viewpoint
TCP provides reliable, in-order byte-stream transfer (“pipe”) between client and server processes
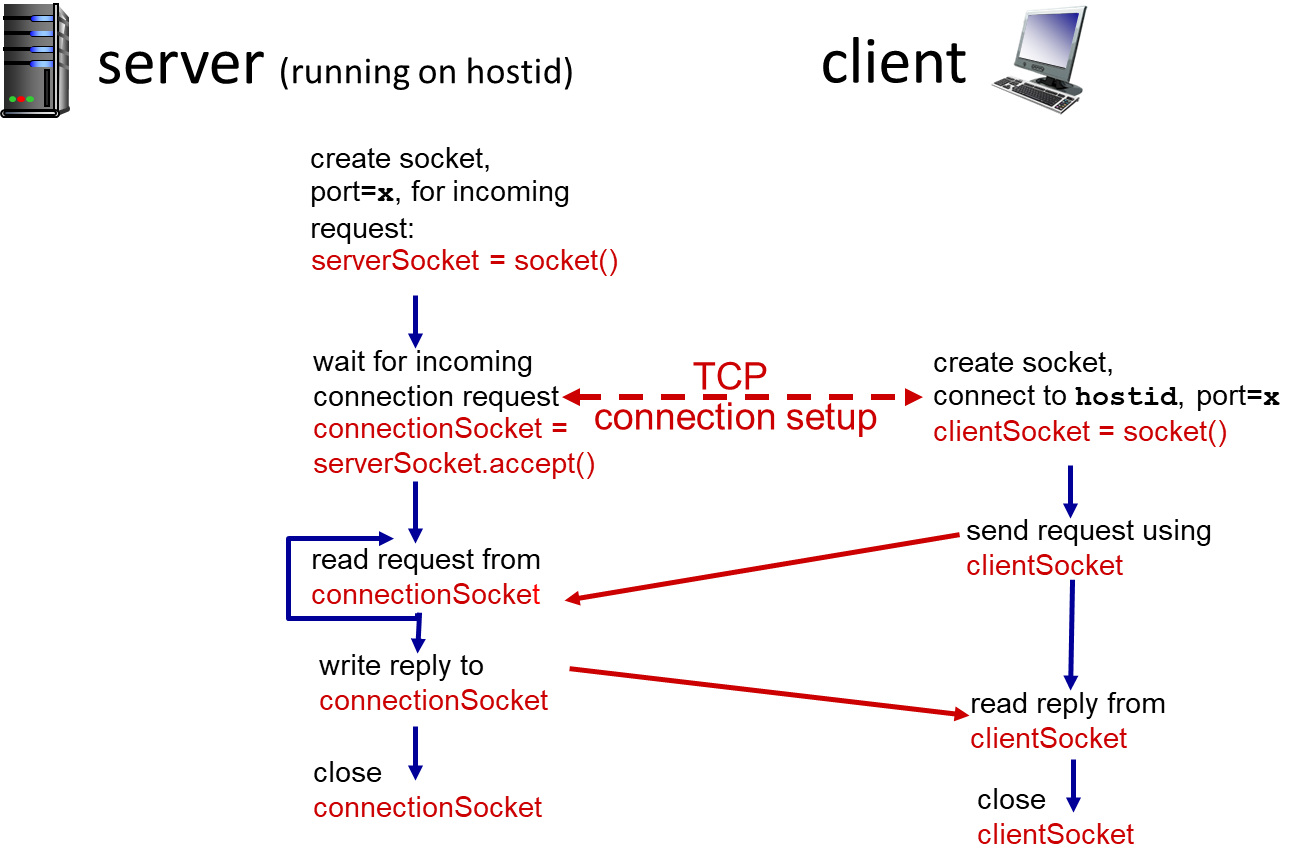
12.2.2 客户端-服务器(C/S)工作流程
在客户端-服务器模型中,服务器必须先运行,因为它需要被动地等待客户端的连接请求。
服务器端流程:
- 创建 Socket:服务器首先创建一个“欢迎 Socket”(Welcome Socket),用于监听连接请求。
- 捆绑(Bind):将这个欢迎 Socket 与服务器的本地 IP 地址和端口号进行捆绑。
- 监听与接收(Accept):服务器调用
accept()函数,在该 Socket 上等待来自客户端的连接请求。这是一个阻塞式调用,意味着如果此时没有连接请求,程序会暂停在这里,直到有请求到来。
客户端流程:
- 创建 Socket:客户端也创建一个 Socket。
- 连接(Connect):客户端调用
connect()函数,并指定服务器的 IP 地址和端口号,主动发起连接请求。此函数也是阻塞式的,直到收到服务器的确认,连接才算建立。
连接建立过程:
- 当客户端的连接请求到达服务器时,服务器上阻塞的
accept()函数会返回。 - 关键点:
accept()函数会返回一个新的 Socket 值,我们称之为“连接 Socket”(Connection Socket)。 - 这个新的连接 Socket 用于与当前这个客户端进行后续的通信。而原来的欢迎 Socket 则继续监听,等待其他客户端的连接请求。
这样,服务器便可以通过一个欢迎 Socket 和多个连接 Socket,同时为多个客户端提供服务。
服务器首先运行,等待连接建立
- 服务器进程必须先处于运行状态
- 创建欢迎
socket - 和本地端口捆绑
- 在欢迎
socket上阻塞式等待接收用户的连接
客户端主动和服务器建立连接:
- 创建客户端本地套接字(隐式捆绑到本地
port)- 指定服务器进程的
IP地址和端口号,与服务器进程连接
- 指定服务器进程的
- 连接
API调用有效时,客户端P与服务器建立了TCP连接 - 当与客户端连接请求到来时
- 服务器接受来自用户端的请求,解除阻塞式等待,返回一个新的
socket(与欢迎socket不一样),与客户端通信- 允许服务器与多个客户端通信
- 使用源
IP和源端口来区分不同的客户端
从应用程序的角度
TCP在客户端和服务器进程之间提供了可靠的、字节流(管道)服务
12.3 应用实例:大小写转换服务
为了更好地理解这个流程,我们来看一个具体的例子:
- 客户端:从键盘读取一行小写英文字符串,通过 Socket 发送给服务器。
- 服务器:接收到字符串后,将其转换为大写,再通过 Socket 发送回客户端。
- 客户端:接收到转换后的字符串,并将其打印在屏幕上。
尽管这个功能在本地很容易实现,但它清晰地展示了客户端与服务器之间通过 Socket 进行请求和响应的完整交互过程。
12.3.1 核心数据结构
在进行 Socket 编程时,通常会用到两个重要的 C 语言结构体:
12.3.1.1 struct sockaddr_in:IP 地址与端口的容器
这个结构体的主要作用是封装一个通信端点的完整地址信息,即它将 IP 地址和端口号捆绑在一起,用于标识网络中的一个具体应用进程。
结构体成员解析:
-
short sin_family: 地址族 (Address Family)- 此字段用于指定使用的协议族。这很重要,因为该结构体的设计具有通用性,不仅限于 TCP/IP。
- 在我们的学习中,当进行 TCP/IP 网络编程时,必须将此字段设置为常量
AF_INET。 - 老师补充说,它也可以用于其他网络协议,例如早期 Novell 网络中的 IPX 协议。
-
u_short sin_port: 端口号 (Port Number)- 用于存放 16 位的端口号。
-
struct in_addr sin_addr: IP 地址- 这是一个内嵌的结构体,其中包含一个
unsigned long类型的成员,用于存放 32 位的 IPv4 地址。
- 这是一个内嵌的结构体,其中包含一个
-
char sin_zero[8]: 填充与对齐 (Padding & Alignment)- 这个数组的主要作用是为了对齐,使得
sockaddr_in的总大小与其他协议的地址结构体(如通用的sockaddr)兼容。 - 老师解释说,某些其他网络协议(如 IPX 或 AppleTalk)的地址长度比 IPv4 地址更长,这个
sin_zero字段就是为了填充字节,确保结构体大小的一致性。
- 这个数组的主要作用是为了对齐,使得
完成以上步骤后,sockaddr_in 变量就包含了连接目标服务器所需的全部信息,可以作为参数传递给 connect() 函数来建立连接。
struct sockaddr_in {
  short sin_family;  //AF_INET
  u_short sin_port;  // port
  struct in_addr sin_addr ;
       // IP address, unsigned long
  char sin_zero[8]; // align
};
sin_family的一些参数
关于指定的常量:您记得完全正确。老师强调,在使用
struct sockaddr_in这个结构体时,必须为其sin_family字段指定一个常量,用来明确告知操作系统你打算使用哪一种网络协议。
对于我们课程中学习的 TCP/IP 协议,这个常量就是
AF_INET。
AF是 “Address Family”(地址族)的缩写。
INET代表 “Internet”,特指我们通常所说的互联网协议族。总结一下:
struct sockaddr_in这个结构体被设计为可以支持多种不同的通信协议。通过给sin_family成员赋值不同的常量,我们来“选择”具体使用哪一种。
- 当我们写
sad.sin_family = AF_INET;时,就等于告诉操作系统:“接下来在这个 Socket 上的所有操作,请使用 IPv4 互联网协议来处理。”- 如果(在过去)要进行 IPX 通信,就会使用另一个不同的常量(例如
AF_IPX)。 因此,AF_INET这个常量是建立 TCP/IP 连接时必不可少的第一步设置。
12.3.1.2 struct hostent:域名解析的结果
作为调用域名解析函数时的参数,返回后,将IP地址拷贝到 sockaddr_in的IP地址部分
当程序只知道主机的域名而不知道其 IP 地址时,就需要进行域名解析。struct hostent 就是用来存放域名解析结果的容器。
- 通过调用如
gethostbyname()这样的函数,输入一个域名(如 “www.google.com”),函数会返回一个指向该结构体的指针。
struct hostent {

    char *h_name;    //域名
    char **h_aliases;    //别名
    int h_addrtype;
    int h_length; //地址长度
    char **h_addr_list;    //IP地址
    #define h_addr h_addr_list[0];

}
结构体成员解析:
char *h_name: 官方域名 (Official Host Name)- 存放主机的正式域名。
char **h_aliases: 别名列表 (Alias List)- 一个字符串数组,存放该主机可能拥有的所有别名。
int h_length: 地址长度- IP 地址的字节长度,对于 IPv4,这个值是 4。
char **h_addr_list: IP 地址列表 (IP Address List)- 这是最重要的字段。由于一个域名可能对应多个 IP 地址(用于负载均衡等目的),这里是一个列表。
- 在编程时,我们通常取用列表中的第一个地址,即
h_addr_list[0]。
12.3.1.3 协同工作流程
在客户端程序中,这两个结构体通常按以下流程协同工作:
- 输入域名:程序从用户或配置中获取服务器的域名。
- 调用解析函数:调用
gethostbyname()等函数,传入域名,函数返回一个指向hostent结构体的指针。 - 提取 IP 地址:从返回的
hostent结构体中,获取h_addr_list[0],这就是服务器的 IP 地址。 - 填充
sockaddr_in:- 将提取到的 IP 地址拷贝到
sockaddr_in变量的sin_addr字段。 - 将服务器的端口号赋值给
sin_port字段。 - 将
sin_family设置为AF_INET。
- 将提取到的 IP 地址拷贝到
12.3.2 API 调用流程图解
服务器端(以 IP 1.1.1.1,端口 80 为例):
welcome_socket = socket():创建一个 Socket,操作系统返回一个整数(例如 8888)。此时它只代表一个潜在的通信端点。bind(welcome_socket, ...):将 8888 这个整数与本地 IP (1.1.1.1) 和端口 (80) 绑定。connection_socket = accept(welcome_socket, ...):在 8888 上等待连接。程序在此阻塞。
客户端(以 IP 2.2.2.2,端口 7777 为例):
client_socket = socket():创建一个 Socket,操作系统返回一个整数(例如 2222)。connect(client_socket, ...):客户端使用 2222 这个 Socket,向服务器的 IP (1.1.1.1) 和端口 (80) 发起连接。- 在客户端,
bind()通常是隐式进行的。操作系统会自动为客户端分配一个未被使用的端口(例如 7777)。 - 此调用会触发 TCP 的三次握手过程。
- 在客户端,
连接建立与数据交互:
- 服务器的
accept()函数接收到连接请求后,解除阻塞,并返回一个新的 Socket 整数(例如 8899)。welcome_socket(8888) 继续监听 80 端口。connection_socket(8899) 代表了与客户端 2.2.2.2:7777 的特定连接。
- 客户端的
connect()函数成功返回,TCP 连接正式建立。 - 客户端调用
write()或send()通过client_socket(2222) 发送数据。 - 服务器调用
read()通过connection_socket(8899) 接收数据,进行处理(大小写转换),然后调用write()将结果发回。 - 客户端调用
read()接收处理后的数据并显示。 close(connection_socket):服务器完成服务后,关闭与该客户端的连接。- 服务器的
while循环返回到accept(),继续等待下一个客户端的连接。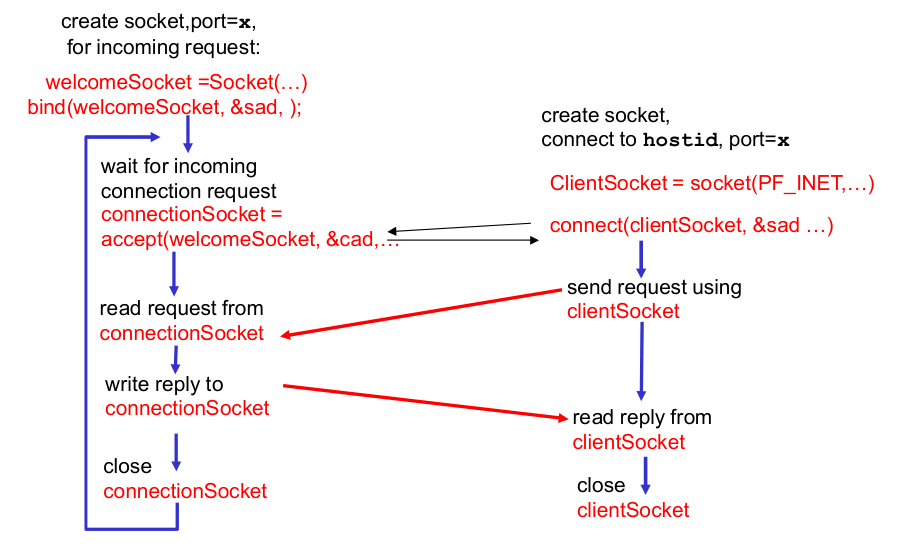
12.4 服务器的并发处理
如果服务器需要同时为多个客户端服务,单进程的循环模型无法满足需求。一个常见的解决方案是多进程模型。
- 主进程(父进程)始终在
welcome_socket上调用accept()。 - 每当
accept()成功返回一个新的connection_socket时,父进程就fork()一个新的子进程。 - 子进程:负责使用这个
connection_socket与客户端进行完整的通信(读、处理、写、关闭)。 - 父进程:不参与具体通信,
fork()之后立刻返回循环,继续调用accept()等待下一个客户端。
补充说明:多进程为何能共用同一端口? 一个 TCP 连接是由一个**四元组(源 IP,源端口,目的 IP,目的端口)**唯一确定的。
welcome_socket只关心**{服务器IP, 服务器端口}**。- 每个
connection_socket则对应一个完整的四元组,例如**{服务器IP, 80, 客户端A_IP, 客户端A_端口}** 和 {服务器IP, 80, 客户端B_IP, 客户端B_端口}。 - 由于每个客户端的 IP 或端口都不同,因此这些四元组也各不相同,操作系统可以准确地将数据包分发给正确的子进程。
12.5 代码示例解析
12.5.1 客户端代码要点 (client.c)
// client.c

void main(int argc, char *argv[]) {
    // sad表示 server addr
    struct sockaddr_in sad; /* structure to hold an IP address of server */
    int clientSocket; /* socket descriptor */
    struct hostent *ptrh; /* pointer to a host table entry */
    char Sentence[128];
    char modifiedSentence[128];
    //    argv[0]是程序的名字
    host = argv[1]; // argv[1] 表示服务器的域名
    port = atoi(argv[2]); // argv[2]表示服务端的端口
    clientSocket = socket(PF_INET, SOCK_STREAM, 0);
    // 这里底层自动使用了bind
    // sad先清0
    memset((char *)&sad,0,sizeof(sad)); /* clear sockaddr structure */
    sad.sin_family = AF_INET; /* set family to Internet */
    // port先转换成短整形,然后设置成网络次序【考虑到不同机器的大小端不同】
    sad.sin_port = htons((u_short)port);
    ptrh = gethostbyname(host);
    /* Convert host name to IP address */
    //将IP地址拷贝到sad.sin_addr
    memcpy(&sad.sin_addr, ptrh->h_addr, ptrh->h_length);
    connect(clientSocket, (struct sockaddr *)&sad, sizeof(sad));
    gets(Sentence); // get input stream from client
    n=write(clientSocket, Sentence, strlen(Sentence)+1); // send line to server
    n=read(clientSocket, modifiedSentence, sizeof(modifiedSentence)); // read line from server
    printf("FROM SERVER: %s\n",modifiedSentence);
    close(clientSocket);  // close the connection
}- 获取参数:程序启动时,需要从命令行参数
argv中获取服务器的域名 (argv[1]) 和端口号 (argv[2])。 - 创建 Socket:
clientSocket = socket(PF_INET, SOCK_STREAM, 0); - 准备服务器地址:
- 使用
gethostbyname(host)将服务器域名解析为 IP 地址。 - 将 IP 地址和端口号填充到一个
sockaddr_in结构体变量sad中。 htons()函数:将端口号从主机字节序(Host byte order)转换成网络字节序(Network byte order),以确保跨平台兼容性。
- 使用
- 建立连接:
connect(clientSocket, &sad, ...); - 数据交互:
gets(Sentence): 从键盘读取输入。write(clientSocket, ...): 将数据发送到服务器。read(clientSocket, ...): 从服务器读取响应。printf(...): 显示结果。
- 关闭连接:
close(clientSocket);
12.5.2 服务器端代码要点 (server.c)
// server.c

void main(int argc, char *argv[]) {

    // 只有一个参数,就是服务端的端口号
    struct sockaddr_in sad; /* structure to hold an IP address of server*/
    struct sockaddr_in cad; /*client */
    int welcomeSocket, connectionSocket; /* socket descriptor */
    struct hostent *ptrh; /* pointer to a host table entry */
    char clientSentence[128];
    char capitalizedSentence[128];
    // port

    port = atoi(argv[1]);
    welcomeSocket = socket(PF_INET, SOCK_STREAM, 0);
    memset((char *)&sad,0,sizeof(sad)); /* clear sockaddr structure */
    sad.sin_family = AF_INET; /* set family to Internet */
    sad.sin_addr.s_addr = INADDR_ANY; /* set the local IP address */
    sad.sin_port = htons((u_short)port);/* set the port number */

    // 此处赋值,在表中进行赋值
    bind(welcomeSocket, (struct sockaddr *)&sad, sizeof(sad));

    // specify the maximum number of clients that can be queued
    listen(welcomeSocket, 10)
        while(1) {
        connectionSocket=accept(welcomeSocket, (struct sockaddr *)&cad, &alen);

            n=read(connectionSocket, clientSentence, sizeof(clientSentence));
            // capitalize Sentence and store the result in capitalizedSentence
            n=write(connectionSocket, capitalizedSentence, strlen(capitalizedSentence)+1);
            close(connectionSocket);

        }

}- 获取参数:从命令行获取服务器要监听的端口号 (
argv[1])。 - 创建 Socket:
welcomeSocket = socket(PF_INET, SOCK_STREAM, 0); - 准备本地地址:
- 填充
sockaddr_in结构体sad。 - IP 地址设为
INADDR_ANY,表示监听本机所有网络接口上的连接。 - 设置端口号并用
htons()转换。
- 填充
- 捆绑:
bind(welcomeSocket, &sad, ...);将 Socket 与地址和端口绑定。 - 监听:
listen(welcomeSocket, 10);- 使 Socket 进入监听状态。
- 第二个参数
10指定了等待连接队列的长度。当服务器正忙时,新来的连接请求会排队,超出队列长度的请求将被拒绝。
- 主循环:
while(1)connectionSocket = accept(welcomeSocket, ...);:阻塞等待客户端连接,成功后返回新的 Socket。read(...),//处理业务逻辑,write(...):与客户端进行数据交互。close(connectionSocket);:关闭与当前客户端的连接,循环继续,等待下一个。
12.6 新的张渊的课的代码python
12.6.1 TCP Client 代码(左侧为注释)
# 导入 socket 库
from socket import *
# 服务器名称
serverName = 'servername'
# 服务器端口
serverPort = 12000
# 为服务器创建 TCP 套接字,远程端口 12000
clientSocket = socket(AF_INET, SOCK_STREAM)
# 连接到服务器
clientSocket.connect((serverName, serverPort))
# 获取用户输入的小写句子
sentence = raw_input('Input lowercase sentence:')
# 发送编码后的句子到服务器
clientSocket.send(sentence.encode())
# 不需要附加服务器名称和端口,从套接字接收修改后的句子
modifiedSentence = clientSocket.recv(1024)
# 打印从服务器接收到的内容
print ('From Server:', modifiedSentence.decode())
# 关闭客户端套接字
clientSocket.close()
12.6.2 TCP Server 代码(左侧为注释)
# 导入 socket 库
from socket import *
# 服务器端口
serverPort = 12000
# 创建 TCP 欢迎套接字
serverSocket = socket(AF_INET, SOCK_STREAM)
# 将套接字绑定到指定端口
serverSocket.bind(('', serverPort))
# 服务器开始监听传入的 TCP 请求
serverSocket.listen(1)
# 打印服务器已准备好接收的提示信息
print 'The server is ready to receive'
# 永久循环
while True:
    # 服务器等待传入请求,返回时创建新套接字
    connectionSocket, addr = serverSocket.accept()
    # 从套接字读取字节(不像 UDP 那样包含地址)
    sentence = connectionSocket.recv(1024).decode()
    # 将句子转换为大写
    capitalizedSentence = sentence.upper()
    # 发送编码后的大写句子到客户端
    connectionSocket.send(capitalizedSentence.encode())
    # 关闭与该客户端的连接(不关闭欢迎套接字)
    connectionSocket.close()
13 2.9 UDP 套接字编程
13.1 UDP Socket 的核心特性
与 TCP 不同,UDP Socket 编程基于 UDP 协议的无连接特性。这意味着在客户端和服务器之间没有正式的连接建立过程。
- 没有握手:通信双方在交换数据前,不需要进行任何“打招呼”或建立连接的步骤。
- 发送端必须指定目标地址:由于没有预先建立的连接,UDP Socket 本身只与本地的 IP 和端口绑定。因此,每次发送数据时,应用程序必须在报文中明确地指定目标的 IP 地址和端口号。
- 服务器端必须提取源地址:服务器从收到的数据分组(Datagram)中,必须主动提取出发送端的 IP 地址和端口号。这是为了知道应该将响应回复给谁。
- 不可靠传输:UDP 传送的数据可能会乱序,也可能会丢失。它为应用程序提供的是一种不可靠的、数据报式的传输服务。
- 没有欢迎套接字和连接套接字之分
补充说明:数据报 (Datagram)
老师提到,术语“数据报 (Datagram)”在网络协议中可能指代不同的东西。IP 分组和 UDP 分组有时都被称为数据报。因此,需要根据上下文来判断它具体指的是网络层(IP)的协议数据单元,还是传输层(UDP)的协议数据单元。
13.1.1 UDP Socket 与 TCP Socket 的根本区别
老师强调了 UDP Socket 在概念上与 TCP Socket 的一个根本性差异:
- 一个 UDP Socket 整数值,代表的是一个二元组:{ 本地 IP, 本地 UDP 端口 }。它仅仅是本地的一个收发数据的“门户”。
- 一个已建立连接的 TCP Socket 整数值,代表的是一个四元组:{ 本地 IP, 本地 TCP 端口, 对方 IP, 对方 TCP 端口 }。它代表的是一个点对点的、已确认的连接。
- UDP就没Welcome和connection socket之分了
这个差异导致了它们 API 使用上的不同。因为 UDP Socket 不包含对方的地址信息,所以在发送(sendto)时必须额外提供;在接收(recvfrom)时,也必须获取对方的地址信息,以便回复。
13.2 API 调用流程图解
我们以服务器 IP 为 1.1.1.1、UDP 端口 80;客户端 IP 为 2.2.2.2、UDP 端口 7777 为例,梳理整个流程。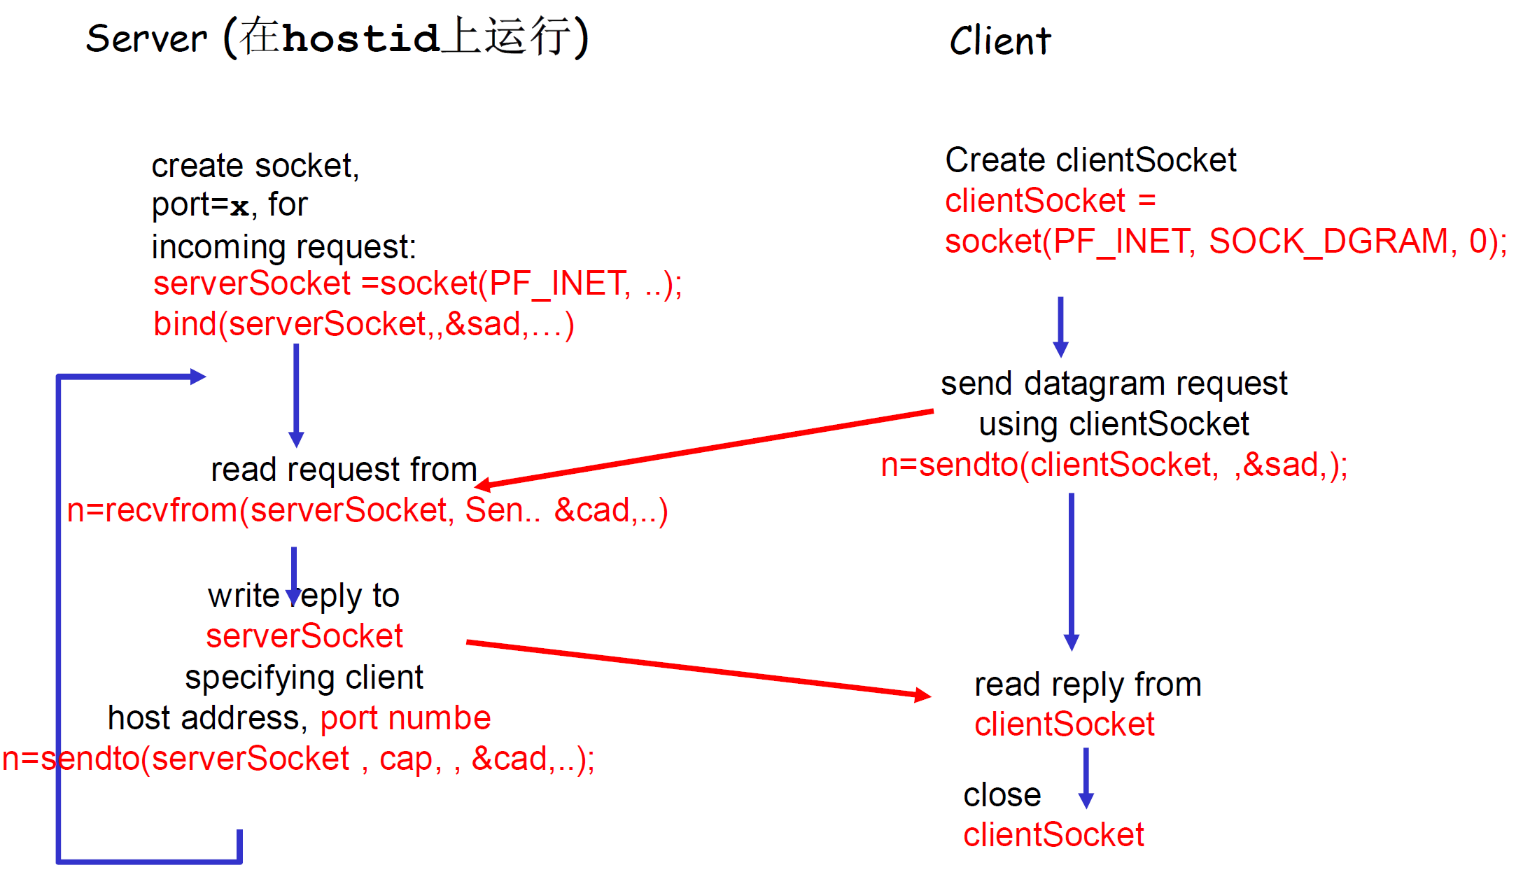
服务器端流程:
- 创建 Socket (
socket):- 调用
socket()函数创建一个 Socket。关键在于,参数中要指明类型为 UDP(SOCK_DGRAM)。操作系统返回一个整数,例如8888。
- 调用
- 捆绑 (
bind):- 调用
bind()函数,将8888这个 Socket 与服务器的本地 IP (1.1.1.1) 和端口 (80) 相捆绑。
- 调用
- 等待接收 (
recvfrom):- 服务器调用
recvfrom()函数,这是一个阻塞式调用。程序会暂停在这里,等待接收来自任意客户端的数据。 recvfrom()不仅会接收数据,还会通过一个“引用型参数”(指针)将发送方的地址信息(IP 和端口)返回给程序。
- 服务器调用
客户端流程:
- 创建 Socket (
socket):- 客户端同样调用
socket()创建一个 UDP Socket,例如2222。 - 客户端通常不需要显式调用
bind(),操作系统会在首次发送数据时,自动为其绑定一个本地 IP 和一个临时的 UDP 端口(例如7777)。
- 客户端同样调用
- 发送数据 (
sendto):- 客户端调用
sendto()函数发送数据。 - 此函数除了需要指明用哪个 Socket 发(
2222)和发什么内容,还必须明确指明要发给谁(即服务器的地址1.1.1.1:80)。
- 客户端调用
交互与响应:
- 服务器上阻塞的
recvfrom()接收到客户端发来的数据后,解除阻塞。此时,服务器不仅得到了数据内容,也通过参数获取到了客户端的地址2.2.2.2:7777。 - 服务器对数据进行处理(例如,大小写转换)。
- 服务器调用
sendto()函数将处理结果发回。此时,它将刚刚从recvfrom()中获取到的客户端地址作为目标地址。 - 客户端调用
recvfrom()接收来自服务器的响应,然后可以关闭 Socket。
关键对比:在服务器端,UDP 编程没有 welcome socket 和 connection socket 之分。自始至终,服务器都使用同一个 Socket 来接收所有不同客户端的请求,并向它们发送响应。
张渊的英语课件的图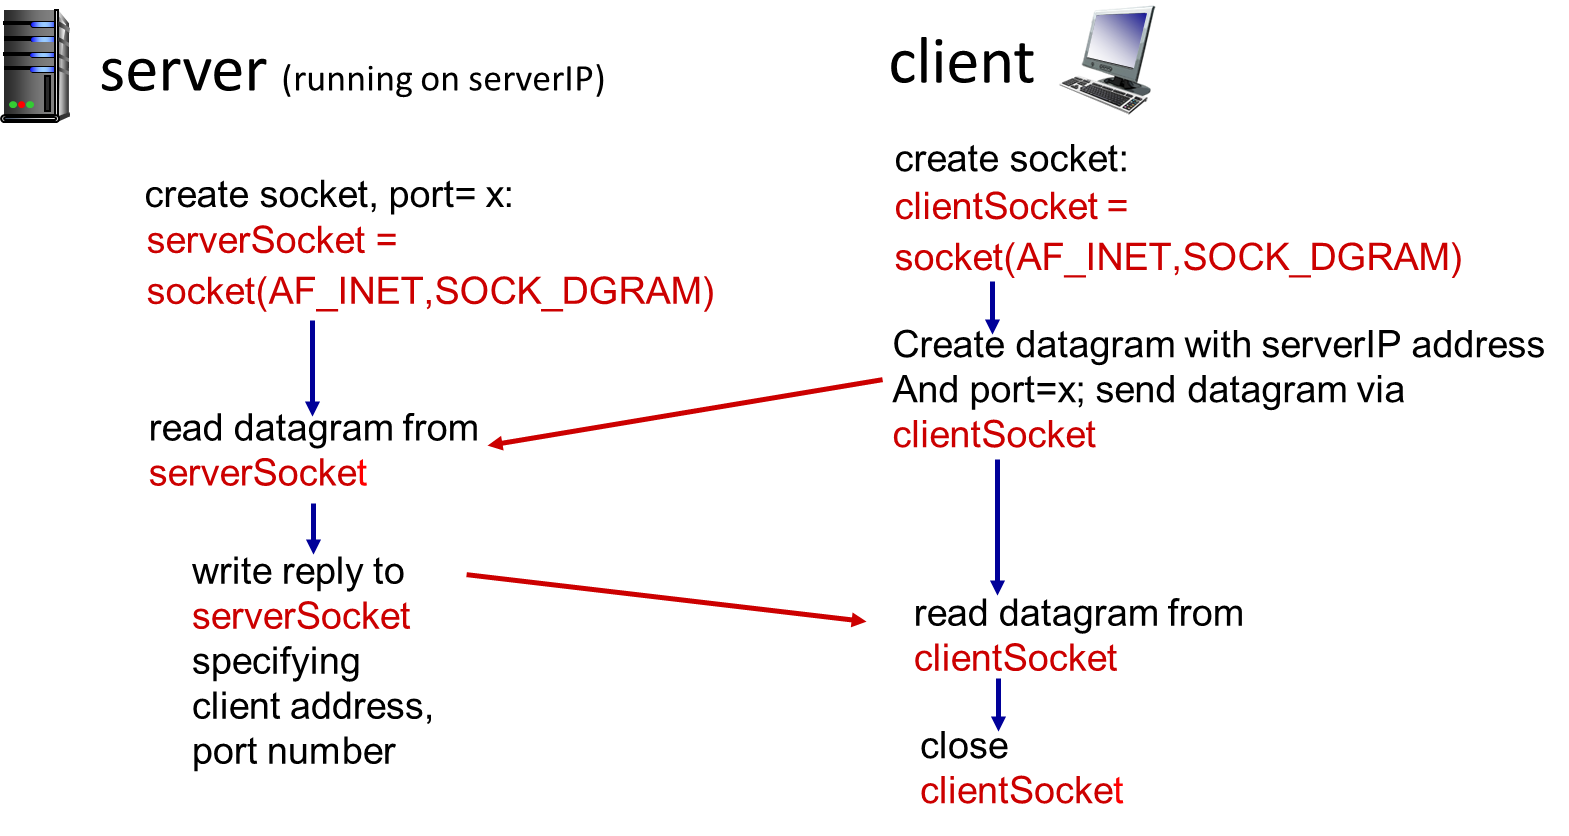
13.3 代码示例解析
13.3.1 客户端代码要点 (client.c - UDP)
/* client.c */

void main(int argc, char *argv[])
{
    struct sockaddr_in sad; /* structure to hold an IP address */
    int clientSocket; /* socket descriptor */
    struct hostent *ptrh; /* pointer to a host table entry */
    char Sentence[128];
    char modifiedSentence[128];
    host = argv[1]; port = atoi(argv[2]);
    clientSocket = socket(PF_INET, SOCK_DGRAM, 0);
    /* determine the server's address */
    memset((char *)&sad,0,sizeof(sad)); /* clear sockaddr structure */
    sad.sin_family = AF_INET; /* set family to Internet */
    sad.sin_port = htons((u_short)port);
    ptrh = gethostbyname(host);

    /* Convert host name to IP address */

    memcpy(&sad.sin_addr, ptrh->h_addr, ptrh->h_length);
    gets(Sentence);
    addr_len =sizeof(struct sockaddr);
    n=sendto(clientSocket, Sentence, strlen(Sentence)+1, (struct sockaddr *) &sad, addr_len);
    n=recvfrom(clientSocket, modifiedSentence, sizeof(modifiedSentence),(struct sockaddr *) &sad, &addr_len);
    printf("FROM SERVER: %s\n",modifiedSentence);
    close(clientSocket);

}- 创建 Socket:
clientSocket = socket(PF_INET, SOCK_DGRAM, 0);- 注意第二个参数是
SOCK_DGRAM,表示创建的是一个 UDP Socket(数据报套接字)。
- 注意第二个参数是
- 准备服务器地址: 这部分与 TCP 客户端类似,通过
gethostbyname()和htons()等函数,将服务器的域名和端口号填充到一个sockaddr_in结构体变量sad中。 - 发送数据:
n = sendto(clientSocket, Sentence, ..., (struct sockaddr *)&sad, ...);- 直接调用
sendto发送数据,最后一个参数&sad就是明确指定了接收方的地址。
- 直接调用
- 接收响应:
n = recvfrom(clientSocket, modifiedSentence, ...);- 调用
recvfrom等待并接收服务器的回复。
- 调用
- 关闭:
close(clientSocket);
与 TCP 客户端的核心区别:没有 connect() 调用。
13.3.2 服务器端代码要点 (server.c - UDP)
/* server.c */
void main(int argc, char *argv[])
{
    struct sockaddr_in sad; /* structure to hold an IP address */

    struct sockaddr_in cad;
    int serverSocket; /* socket descriptor */
    struct hostent *ptrh; /* pointer to a host table entry */
    char clientSentence[128];
    char capitalizedSentence[128];
    port = atoi(argv[1]);
    serverSocket = socket(PF_INET, SOCK_DGRAM, 0);
    memset((char *)&sad,0,sizeof(sad)); /* clear sockaddr structure */
    sad.sin_family = AF_INET; /* set family to Internet */
    sad.sin_addr.s_addr = INADDR_ANY; /* set the local IP address */
    sad.sin_port = htons((u_short)port);/* set the port number */

    bind(serverSocket, (struct sockaddr *)&sad, sizeof(sad));
    while(1) {
        n=recvfrom(serverSocket, clientSentence, sizeof(clientSentence), 0
	   (struct sockaddr *) &cad, &addr_len );
        /* capitalize Sentence and store the result in capitalizedSentence*/
        n=sendto(serverSocket , capitalizedSentence, strlen(capitalizedSentence)+1,
	 (struct sockaddr *) &cad, &addr_len);

    }

}- 创建与绑定:
serverSocket = socket(PF_INET, SOCK_DGRAM, 0);创建 UDP Socket。bind(serverSocket, ...);将 Socket 与本地指定的端口绑定,准备接收数据。
- 无限循环:
while(1) - 接收数据与地址:
n = recvfrom(serverSocket, clientSentence, ..., (struct sockaddr *)&cad, ...);- 这是服务器的核心。它阻塞式地等待数据到来。
- 当数据到达时,数据内容被存入
clientSentence,而发送这个数据的客户端地址则被操作系统自动存入了cad这个sockaddr_in结构体中。
- 处理数据: 对接收到的
clientSentence进行大小写转换。 - 发送响应:
n = sendto(serverSocket, capitalizedSentence, ..., (struct sockaddr *)&cad, ...);- 调用
sendto将处理结果发回。 - 注意,目标地址直接使用了上一步
recvfrom中获取到的客户端地址&cad。
- 调用
与 TCP 服务器的核心区别:没有 listen() 和 accept() 调用。服务器使用一个 Socket 处理所有客户端的交互。
13.4 新版课件的python代码
UDP client
# include Python's socket library
from socket import *
serverName = 'hostname'
serverPort = 12000
# create UDP socket for server
clientSocket = socket(AF_INET, SOCK_DGRAM)
# get user keyboard input
message = raw_input('Input lowercase sentence:')
# attach server name, port to message; send into socket
clientSocket.sendto(message.encode(), (serverName, serverPort))
# read reply characters from socket into string
modifiedMessage, serverAddress = clientSocket.recvfrom(2048)
# print out received string and close socket
print modifiedMessage.decode()
clientSocket.close()
UDP server
# include Python's socket library
from socket import *
serverName = 'hostname'
serverPort = 12000
# create UDP socket for server
clientSocket = socket(AF_INET, SOCK_DGRAM)
# get user keyboard input
message = raw_input('Input lowercase sentence:')
# attach server name, port to message; send into socket
clientSocket.sendto(message.encode(), (serverName, serverPort))
# read reply characters from socket into string
modifiedMessage, serverAddress = clientSocket.recvfrom(2048)
# print out received string and close socket
print modifiedMessage.decode()
clientSocket.close()
14 第 2 章:小结
14.1 核心概念回顾
-
应用程序体系结构
- 本章首先介绍了应用进程间交互的三种主要架构模式:
- 客户-服务器 (Client-Server) 模式
- P2P (Peer-to-Peer) 模式
- 混合 (Hybrid) 模式
- 本章首先介绍了应用进程间交互的三种主要架构模式:
-
应用所需的服务质量 (QoS)
- 应用层需要借助传输层提供的服务。我们可以通过一系列指标来描述传输层服务的质量,以判断其是否满足特定应用的需求。这些指标包括:
- 可靠性 (Reliability)
- 带宽 (Bandwidth)
- 延时 (Delay)
- 安全 (Security)
- 应用层需要借助传输层提供的服务。我们可以通过一系列指标来描述传输层服务的质量,以判断其是否满足特定应用的需求。这些指标包括:
-
Internet 传输层服务模式
- 在 TCP/IP 协议栈中,传输层主要提供两种服务模式:
- TCP:提供一种可靠的、面向连接的字节流服务。
- UDP:提供一种不可靠的、无连接的数据报服务。
- 在 TCP/IP 协议栈中,传输层主要提供两种服务模式:
-
流行的应用层协议
- 我们详细学习了几种主流的应用层协议,包括:
- HTTP (Web)
- FTP (文件传输)
- Email 相关的协议 (SMTP, POP, IMAP)
- DNS (域名系统)
- 老师补充提到了 CDN (内容分发网络)
- 我们详细学习了几种主流的应用层协议,包括:
-
Socket 编程
- 最后,我们通过具体的编程实例,学习了如何使用 Socket API 来构建网络应用,内容覆盖了 TCP Socket 和 UDP Socket 两种编程方式。
14.2 协议相关的深层知识
老师进一步总结了一些贯穿于不同协议设计中的通用概念和权衡。
-
应用报文类型:应用层的报文通常可以分为请求报文(客户端请求信息或服务)和响应报文(服务器以数据或状态码进行回应)。
-
报文格式:一个典型的协议报文通常由两部分组成:首部 (Header),包含关于数据的元信息;和数据 (Data),即被交换的信息本身。
-
控制报文 vs. 数据报文:
- 从用途上看,用于传输用户数据的报文称为数据报文,而用于传输控制信令的报文称为控制报文。
- 这个概念引出了带内 (In-band) 和带外 (Out-of-band) 传输的区别。如果控制信息和数据在同一个 TCP 连接上传输,就是带内;如果使用两个独立的连接分别传输,就是带外(FTP 是一个典型例子)。
-
其他设计思想:
- 集中式 vs. 分散式:例如,在 C/S 模式中,目录的维护可以是集中的或分散的。
- 无状态 vs. 维护状态:服务器可以选择不维护任何客户端的状态(无状态,如 HTTP),也可以选择维护每个客户端的状态(维护状态)。
- 网络边缘处理复杂性:这是互联网的一个核心设计哲学,即把复杂的处理逻辑尽可能地放在网络的边缘(即终端用户的设备上),而保持网络核心的简洁和高效。
14.3 UDP和TCP的对比
- TCP是面向连接的,UDP是无连接的
- TCP是可靠的,UDP是不可靠的
- TCP是面向字节流的,UDP是面向数据报文的
- TCP报文首部20个字节,UDP首部8个字节
- TCP有流量控制拥塞控制机制,UDP没有
- TCP仅支持单播,UDP支持单播,多播,广播
14.3.1 为什么要有 UDP?
TCP 为了保证可靠性,引入了复杂的机制(如握手、确认、重传),这带来了较大的延迟和开销。但在某些场景下,实时性和效率比完全的可靠性更重要:
- 对实时性要求高: 在线游戏、视频会议、实时直播等。这些应用宁可丢失少量数据(例如,画面卡顿一下或跳过一帧),也不能接受因为重传而导致的巨大延迟(例如,画面长时间冻结)。
- 开销敏感的应用: 如 DNS(域名解析)。DNS 查询通常很短,如果使用 TCP,建立和断开连接的开销(三次握手、四次挥手)远大于数据本身的开销,效率极低。
- 广播/多播: UDP 支持一对多的广播和多播,而 TCP 只能支持一对一的通信。
因此,UDP 的存在是为了满足那些对低延迟、高效率、低开销有强烈需求,并且可以容忍一定数据丢失的应用场景。
14.3.2 其他问题
- DNS的作用(4)
- DNS为啥不能集中(4)
- CDN的两种方式