1 传输层 (Transport Layer)概述
目标:
- 理解传输层的工作 原理
- 多路复用/解复用
- 可靠数据传输(网络中的非常核心的内容,将网络层提供的不可靠的服务转变为可靠的服务)
- 流量控制(点到点的问题)
- 拥塞控制 (路径的问题)
- 学习Internet的传输层 协议
- UDP:无连接传输
- TCP:面向连接的可靠传 输
- TCP的拥塞控制
1.1 章节内容概述
我们现在从应用层向下,进入到计算机网络体系结构中的传输层。本章节将首先介绍传输层的一些核心原理,然后以互联网中的TCP和UDP协议为例,深入探讨这些原理的具体实现。
1.1.1 原理部分
多路复用与解复用
- 传输层需要同时支持上层的多个应用进程。在源端,数据需要被正确地整合(复用);在目标端,数据需要被准确地分发给对应的应用进程(解复用)。
可靠数据传输 (Reliable Data Transfer, RDT)
- 这是一个极为核心和经典的网络问题,甚至可以说是网络领域的”Top 3”问题。TCP协议能够在不可靠的IP服务之上,为上层应用提供可靠的通信服务。我们将深入探讨实现这一目标所需的机制,以及如何对抗各种导致数据传输不可靠的因素。
流量控制 (Flow Control)
- 这是一个端到端的问题,用于协调对等的两个TCP实体。流量控制机制确保发送方的发送速率不会超过接收方的处理能力,从而避免数据丢失。
拥塞控制 (Congestion Control)
- 当发送方和接收方的处理能力都很强时,网络路径上的路由器仍然可能发生拥塞。拥塞控制是整个网络的核心机制,用于感知网络拥塞、从中恢复,并在网络状况良好时提升发送速率。没有拥塞控制,整个网络几乎无法使用。
1.1.2 互联网协议实例
本章将以互联网中的两大传输层协议为例进行讲解:
- UDP (User Datagram Protocol):用户数据报协议。
- TCP (Transmission Control Protocol):传输控制协议。我们将详细分析TCP的报文段结构、可靠数据传输机制、流量控制、连接管理以及拥塞控制的具体实现。
1.2 传输层提供的服务
传输层的核心任务是为运行在不同主机上的应用进程之间,提供一种逻辑通信 (Logical Communication) 服务。
这种“逻辑通信”意味着,从应用进程的角度看,数据报文像是直接从一个进程发送到了另一个远程进程。但实际上,数据报文需要通过层层接口,交由传输层进行处理,并依赖网络层等下层服务,最终才能到达对方的传输层,再交付给对应的应用进程。
1.2.1 数据处理流程
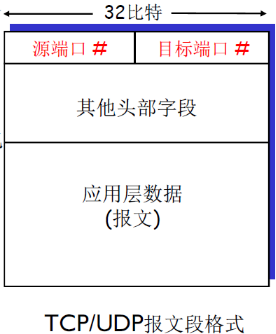
发送方:传输层(如TCP或UDP)从应用层接收到报文(Message)。如果报文过长,会将其分割成更小的单元,称为报文段 (Segment)。每个报-文段都会被添加上一个头部(Header),其中包含了源端口、目标端口等关键信息。
接收方:接收方的传输层实体会接收这些报文段,去掉头部信息,然后根据序号等信息将数据重组成原始的应用报文,最后交付给上层的应用进程。
值得注意的是,TCP向上层提供的是字节流 (Byte Stream) 服务。它保证字节流的顺序和正确性,但不保证应用层报文的边界。因此,应用层需要自己设计协议来识别报文的开始和结束。
1.2.2 互联网中的传输层协议
在TCP/IP协议族中,传输层提供了两种主要协议供上层应用选择:TCP和UDP。无论上层选择哪种协议,它们在向下交付数据时,都依赖于网络层的IP协议。IP协议提供的是一种“尽力而为”(Best Effort) 的分组转发服务,不保证可靠性。
1.3 传输层 vs. 网络层服务
网络层提供的是主机到主机 (Host-to-Host) 的通信服务。而传输层在此基础上,将服务进一步细化,提供了进程到进程 (Process-to-Process) 的通信。
传输层不仅依赖于网络层提供的服务,更重要的是对网络层的服务进行了增强,从而为上层应用提供更优质的服务。例如,网络层可能会丢失数据包或导致其乱序,而传输层(特别是TCP)通过引入相应机制,能够弥补这些不足,向上层提供可靠的通信。
1.4 服务的增强:可强化与不可强化的服务品质
传输层可以对网络层的一些服务品质进行增强,但并非所有品质都可以被改变。
1.4.1 可以被加强的服务品质
- 可靠性 (Reliability):IP服务是不可靠的,但TCP通过确认、重传等机制,可以将其增强为可靠的服务。
- 安全性 (Security):虽然TCP和IP本身不提供加密,但可以在其上增加如SSL/TLS这样的安全层,在端系统内部实现数据的加密、认证和完整性检查,从而提供安全的服务。
1.4.2 不可被加强的服务品质
- 延迟 (Delay):传输层协议(如TCP)无法降低数据在网络中传输的物理延迟。这个延迟由网络路径的物理特性决定。
- 带宽 (Bandwidth):传输层也无法提升网络路径的固有带宽。一条通信路径的吞吐量受到瓶颈链路的限制,传输层协议的努力无法将这个“管道”变得更粗。
1.5 核心功能:多路复用与解复用
这是传输层提供的一项关键功能,它允许一台主机上的多个应用进程同时使用网络。
- 复用 (Multiplexing):在源端,传输层收集来自不同应用进程的数据,并为它们添加头部信息(如端口号),然后将这些报文段传递给网络层。
- 解复用 (Demultiplexing):在目标端,传输层根据报文段头部的端口号等信息,将接收到的数据准确地交付给主机上对应的应用进程。
1.5.1 一个生动的类比:两个大家庭的通信
为了更好地理解这个概念,我们可以想象一个发生在美国东海岸和西海岸的两个家庭(Ann家和Bill家)之间的故事。
- 主机 (Host) = 家庭 (House)
- 应用进程 (Process) = 家中的小孩
- 应用层报文 (Message) = 信封中的信件
- 网络层协议 (e.g., IP) = 邮政服务
- 传输层协议 (e.g., TCP/UDP) = 两家的老大 (Ann家的老大和Bill家的老大)
假设每个家庭都有12个小孩,每个小孩每周都要给对方家庭的12个小孩分别写一封信。这样一来,每周总共有 12 * 12 = 144 封信需要寄送。
邮政服务(网络层)只负责将邮件从一个家庭地址送到另一个家庭地址,它不关心信件具体是写给哪个小孩的。
这时,传输层的角色就体现出来了:
- 复用 (在Ann家):Ann家的老大会收集所有弟妹写的144封信,把它们统一打包成一个大邮包。这个邮包的地址是从“Ann家”到“Bill家”。Ann家的老大在这里就执行了复用操作。
- 解复用 (在Bill家):当这个大邮包被邮政服务送到Bill家后,Bill家的老大会负责拆开邮包,然后根据每封信上的收件人名字,准确地分发给他的11个弟妹。这个过程就是解复用。
通过这个类比,我们可以清晰地看到,传输层是如何在网络层提供的主机到主机服务之上,实现了更精细化的进程到进程通信服务。
1.6 互联网传输层协议简介
1.6.1 TCP (Transmission Control Protocol)
TCP提供的是一种可靠的、保障顺序的传输服务。其主要特性包括:
- 多路复用/解复用:实现进程到进程的通信。
- 可靠数据传输:通过确认和重传机制保证数据不丢失、无差错。
- 拥塞控制和流量控制:调节发送速率以适应网络状况和接收方能力。
- 连接管理:通信前需要先建立连接(三次握手),通信结束后再释放连接。
1.6.2 UDP (User Datagram Protocol)
UDP提供的是一种不可靠的、不保障顺序的传输服务。它是一种非常简洁的协议。
- 多路复用/解复用:这是它在IP服务之上提供的核心增强功能,实现了进程到进程的通信。
- 除此之外,UDP几乎没有增加任何额外的服务。它直接利用IP提供的”Best Effort”服务,不保证可靠性,也不提供流量控制或拥塞控制。
- UDP以数据报 (Datagram) 为单位进行传输,而不是像TCP那样的字节流。
最后需要强调的是,无论是TCP还是UDP,它们都不提供延迟保证和带宽保证。
2 多路复用与解复用
2.1 基本原理
2.1.1 端口号
网络层的IP协议提供了主机到主机的通信服务。为了在主机到主机服务的基础上,实现更为精细化的进程到进程通信,传输层引入了一个关键机制:端口号 (Port Number)。
无论是TCP还是UDP,都使用16比特的端口号,理论上可以提供超过六万个端口。然而,TCP和UDP在使用端口号的方式上存在显著差异,这也导致了它们复用和解复用机制的不同。
2.1.2 概念
- 多路(复用/解复用):一个TCP/UDP实体上有很多应用进程借助其发送
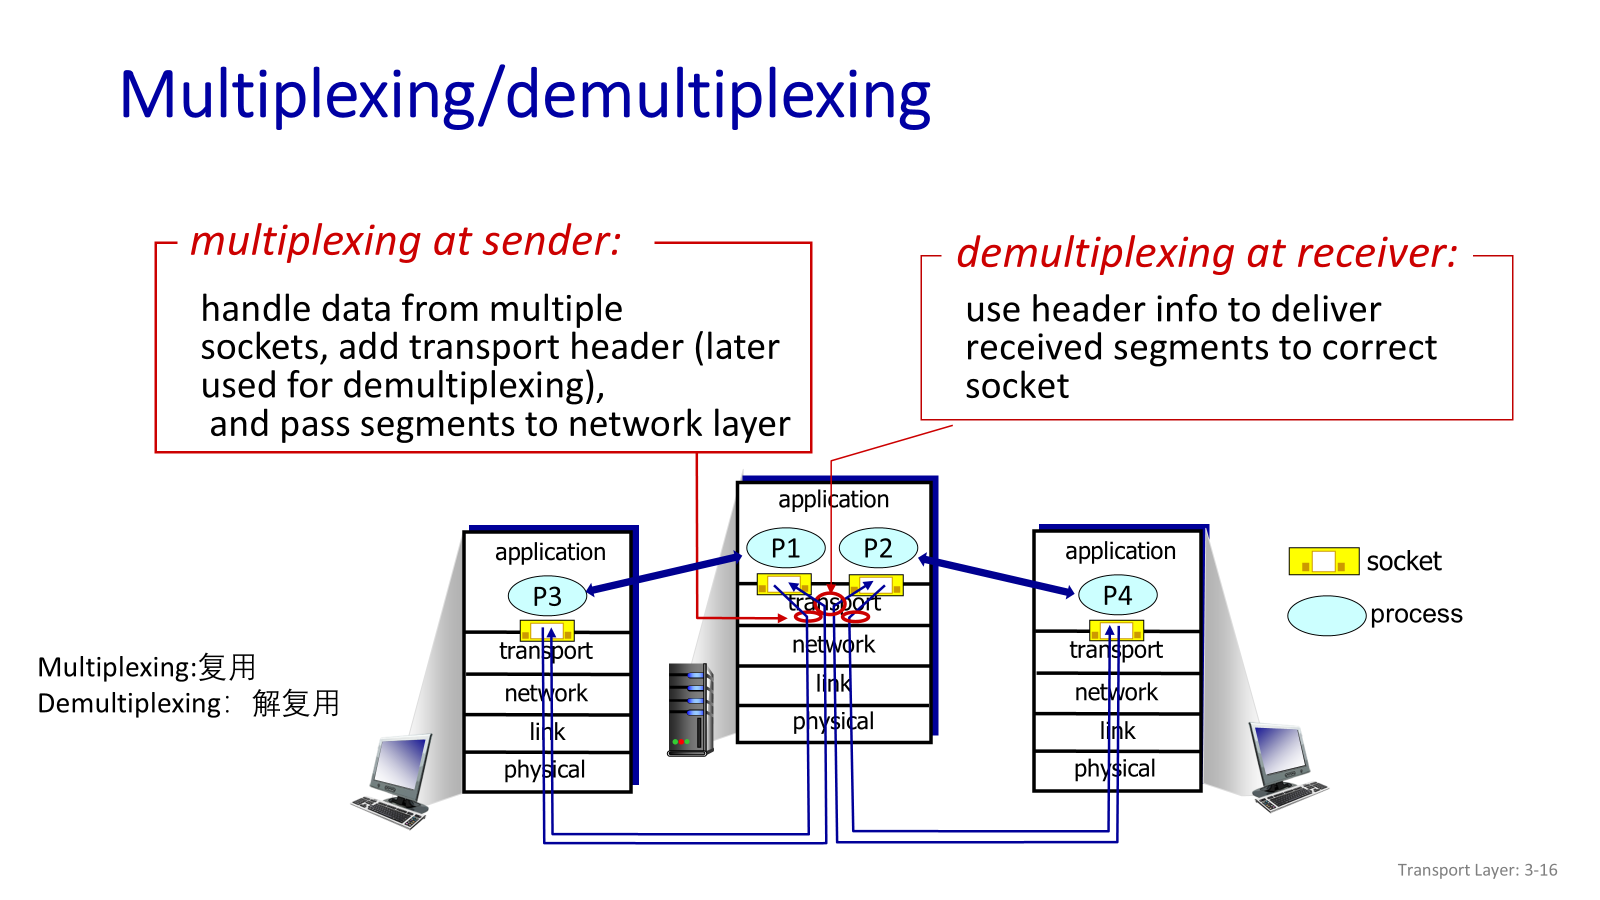
- 复用:就是指多个进程可以使用一个实体来发送/接受
- 根据端口来进行复用的,但是TCP和UDP使用的端口不一样,TCP是四元组,UDP是二元组
在发送方主机多路复用
- 从多个套接字接收来自多个进程的报文,根据套接字对应的IP地址和端口号等信息对报文段用头部加以封装 (该头部信息用于以后的解复用)
在接收方主机多路解复用
- 根据报文段的头部信息中的IP地址和端口号将接收到的报文段发给正确的套接字(和对应的应用进程)
2.1.3 复用工作原理
当应用层交给传输层数据的时候,还会提供信息
- 对于TCP,提交给传输层的有
- 数据本身
- socket(表示src IP, src port, des IP, des port)
- 对于UDP,提交给传输层的有
- 数据本身
- socket (表示src IP,src port)
- cad(表示 desc IP,des port)结构体
区别就在于UDP的socket是不表示目标ip和port的,需要手动传入
当传输层收到信息之后,会对数据进行封装,即在数据前面加上需要的信息,再交给网络层,网络层也能解析头部信息从而进行封装
2.1.4 解复用工作原理
- 解复用作用:TCP或者UDP实体采 用哪些信息,将报文段的 数据部分 交给正确的socket,从而交给正确 的进程
- 主机收到IP数据报
- 每个数据报有源IP地址和目标地 址
- 每个数据报承载一个传输层报 文段
- 每个报文段有一个源端口号和 目标端口号 (特定应用有著名的端口号)
- 主机联合使用IP地址和端口号将报文段发送给合适的套接字
2.2 TCP中的复用与解复用
在面向连接的TCP通信中,一个套接字(Socket)与一个四元组 (4-tuple) 唯一绑定。这个四元组包含了通信双方的全部地址信息:
- 源IP地址
- 源端口号
- 目标IP地址
- 目标端口号
这个四元组完整地定义了一个TCP连接,代表了两个特定进程之间的会话关系。在操作系统内部,会用一个简单的整数(即套接字描述符)来代表这个复杂的四元组关系。
2.2.1 发送端 (复用)
当一个应用进程需要发送数据时,它会向操作系统提供两个核心信息:套接字描述符和要发送的报文(Message)。
- 操作系统根据套接字描述符,查找到与之绑定的四元组信息。
- TCP协议实体利用四元组中的源端口号和目标端口号,构建TCP报文段的头部。
- 随后,TCP将封装好的报文段以及四元组中的源IP地址和目标IP地址一同向下交付给网络层。
- 网络层的IP协议实体利用这两个IP地址,构建IP数据报的头部,最终通过网卡将数据发送出去。
这个过程就是复用:多个应用进程通过各自不同的套接字,将数据汇集到同一个传输层实体(TCP),由它统一处理并向下交付。
2.2.2 接收端 (解复用)
当一个IP数据报到达目标主机后,解复用的过程开始:
- 主机的网络层接收到IP数据报。它会检查数据报头部的目标IP地址,确认是发给自己的。
- 网络层将IP头部剥离,把载荷部分(即TCP报文段)连同原始IP数据报中的源IP地址和目标IP地址信息,一同向上传递给传输层。
- 传输层的TCP实体此时获得了完整的四元组信息:源/目标IP地址(来自网络层)和源/目标端口号(来自TCP头部)。
- TCP实体使用这个独一无二的四元组,在操作系统维护的套接字表格中进行查找,定位到唯一匹配的套接字。
- 一旦找到对应的套接字,也就找到了创建该套接字的进程(或线程),从而将数据准确地交付给正确的应用进程。
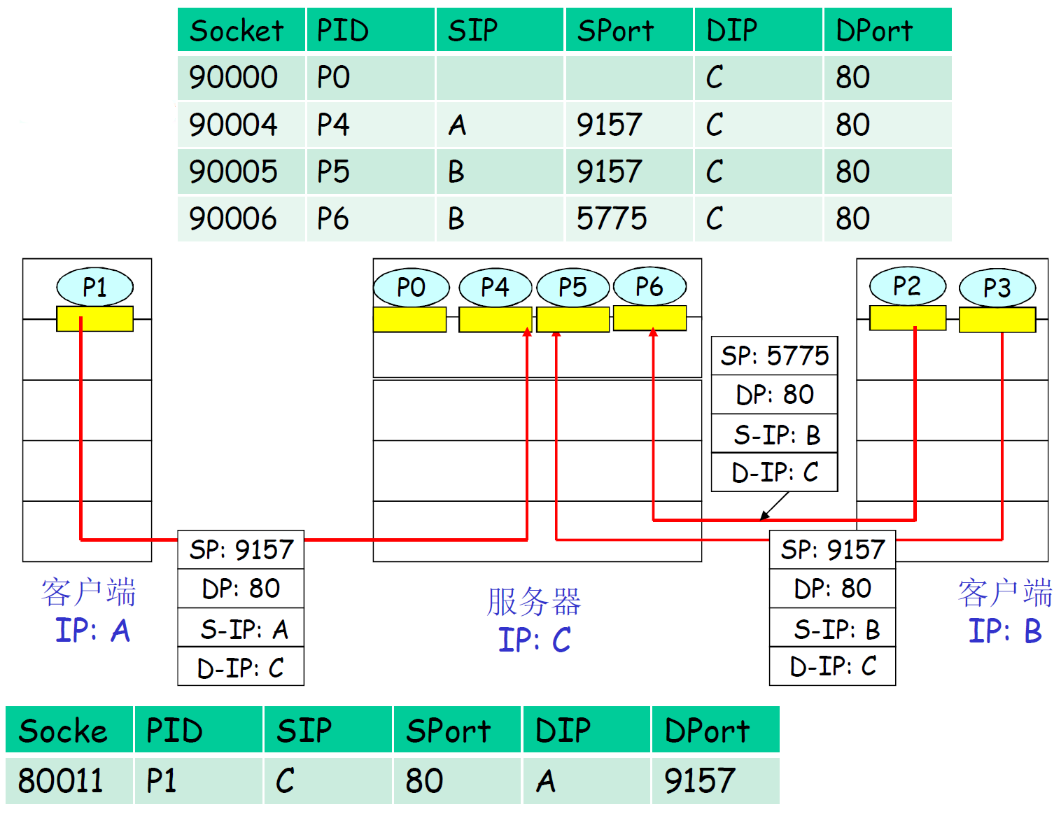
2.2.3 例子
假设一台服务器B在80号端口上运行一个Web服务。现在有三个不同的连接请求:
- 来自客户端A(IP: A, Port: 9157)的请求。
- 来自客户端C(IP: C, Port: 9157)的请求。
- 来自客户端C(IP: C, Port: 5775)的请求。
这三个请求的目标IP都是B,目标端口都是80,但它们会被分发到三个不同的套接字,交给三个不同的应用进程(或线程)处理:
- 连接1 vs 连接2:虽然源端口号(
9157)相同,但源IP地址不同(A vs C),因此是两个不同的连接。 - 连接2 vs 连接3:虽然源IP地址相同(都是C),但源端口号不同(
9157vs5775),因此也是两个不同的连接。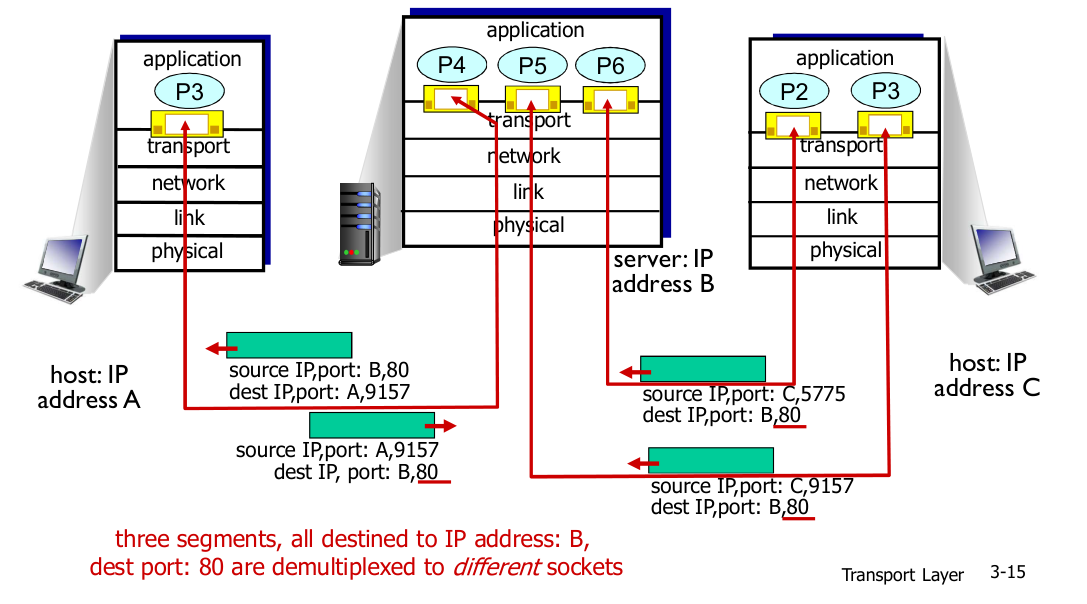
2.2.4 多线程Web Server
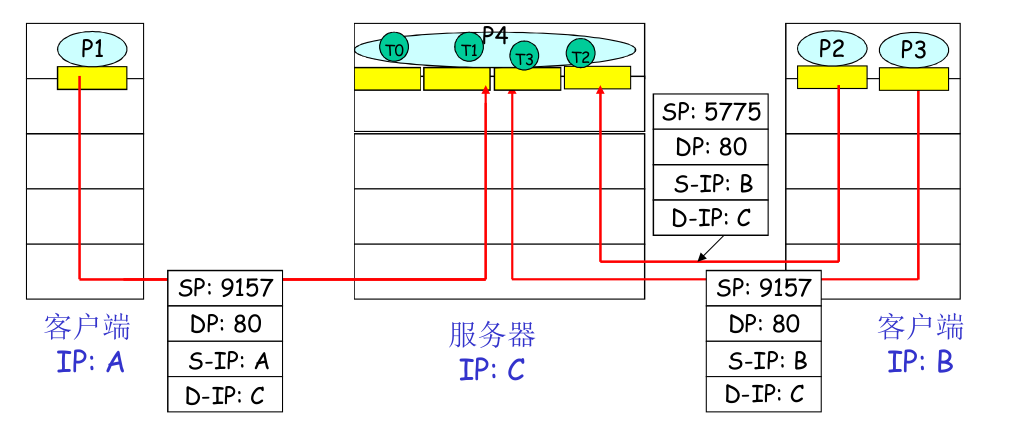
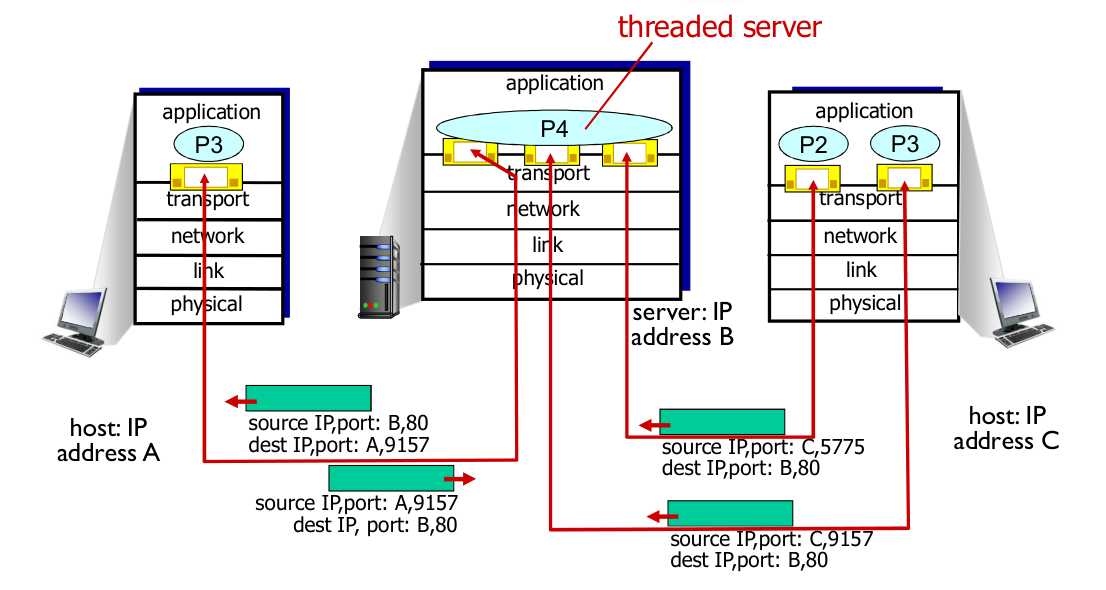
- 一个进程下面可能有多个线程:由多个线程分别为客户提供服务
- 在这个场景下,还是根据4元组决定将报文段内容同一个进程下的不同线程
- 解复用到不同线程
2.3 UDP中的复用与解复用
与TCP不同,无连接的UDP通信中,一个套接字仅仅与一个二元组 (2-tuple) 绑定:
- 本地IP地址
- 本地端口号
UDP套接字在创建时,并不知道将要和谁通信。
2.3.1 创建套接字(回顾):
服务器端:
serverSocket=socket(PF_INET, SOCK_DGRAM,0);
bind(serverSocket, &sad, sizeof(sad));
serverSocket和Sad指定的端口号捆绑
客户端:
ClientSocket=socket(PF_INET, SOCK_DGRAM,0);
没有Bind,ClientSocket和OS为之分配的某个端口号捆绑(客户端使用什么端口号无所谓,客户端主动找服务器)【即隐式的捆绑】
2.3.2 发送端 (复用)
由于UDP套接字本身不包含目标地址信息,因此应用进程在发送数据时必须提供更多信息:
- UDP套接字描述符。
- 要发送的报文(Message)。
- 一个包含了目标IP地址和目标UDP端口号的地址结构体。
UDP协议实体收到这些信息后,利用套接字绑定的信息作为源地址,利用应用层额外提供的信息作为目标地址,来构建UDP数据报的头部,然后向下交付给网络层。
回顾
DatagramSocket mySocket1 = new DatagramSocket(12534);回顾:当创建UDP段采用端口号,可以指定:
- 目标IP地址
- 目标端口号
2.3.3 接收端 (解复用)
在接收端,UDP套接字用二元组标识(目标IP地址、目标端口号)
当一个UDP数据报到达目标主机后:
- 网络层同样会将载荷(UDP数据报)和源/目标IP地址上传给传输层。
- UDP实体进行解复用的依据很简单,它只关注两个信息:目标IP地址和目标端口号。
- 它使用这个二元组在套接字表格中查找,只要一个套接字绑定的IP和端口与数据报的目标IP和端口匹配,数据就会被交付给该套接字所对应的应用进程。
- 如果两个不同源IP地址/源端口号的数据报,但是有相同的目标IP地址和端口号,则被定位到相同的套接字
| PID | Socket | Des IP | Des Port |
|---|---|---|---|
| 12345 | 77888 | 202.38.64.1 | 80 |
| 12346 | 77999 | 202.38.64.1 | 11010 |
| …… |
2.3.4 UDP的例子
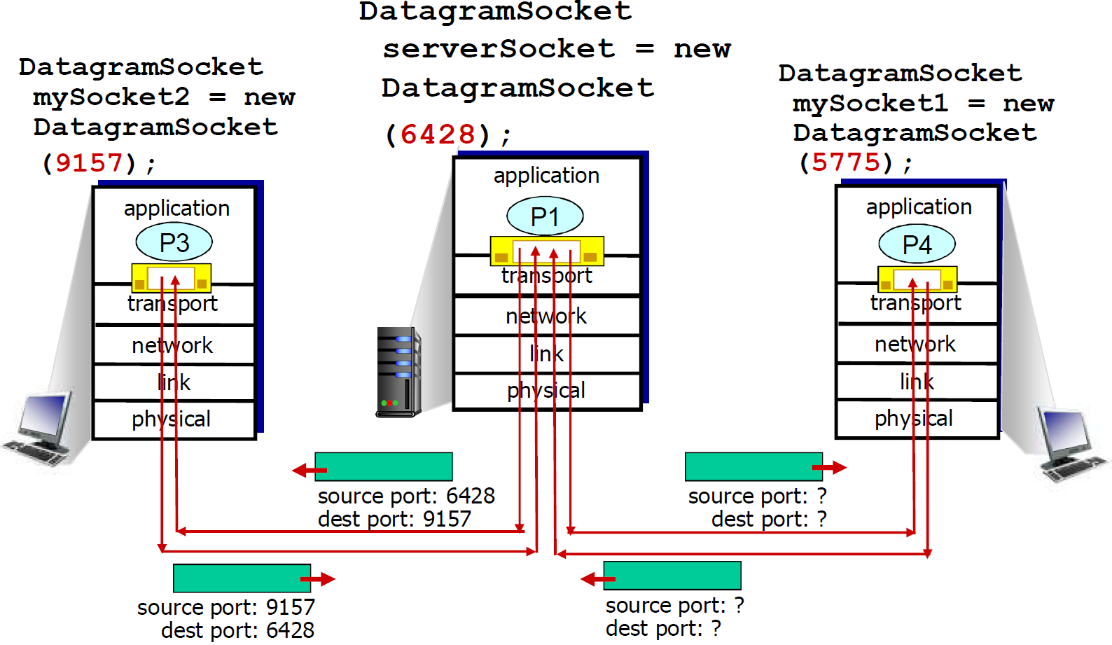
serverSocket = serverSocket=socket(PF_INET,SOCK_DGRAM,0);
bind(serverSocket, sad, sizeof(sad));
2.3.4.1 第一步:服务器创建套接字并监听
- 发生了什么?
在中间这台服务器上,应用程序
P1创建了一个DatagramSocket(数据报套接字),并将其绑定到了6428端口。 - 老师的讲解点:
老师强调,UDP套接字在创建时,只与本地的IP地址和本地的端口号相关联。此时,服务器
P1并不知道谁会给它发消息,它只是告诉操作系统:“所有发送到我这个IP地址、并且目标端口是6428的UDP数据包,都请交给我来处理。”
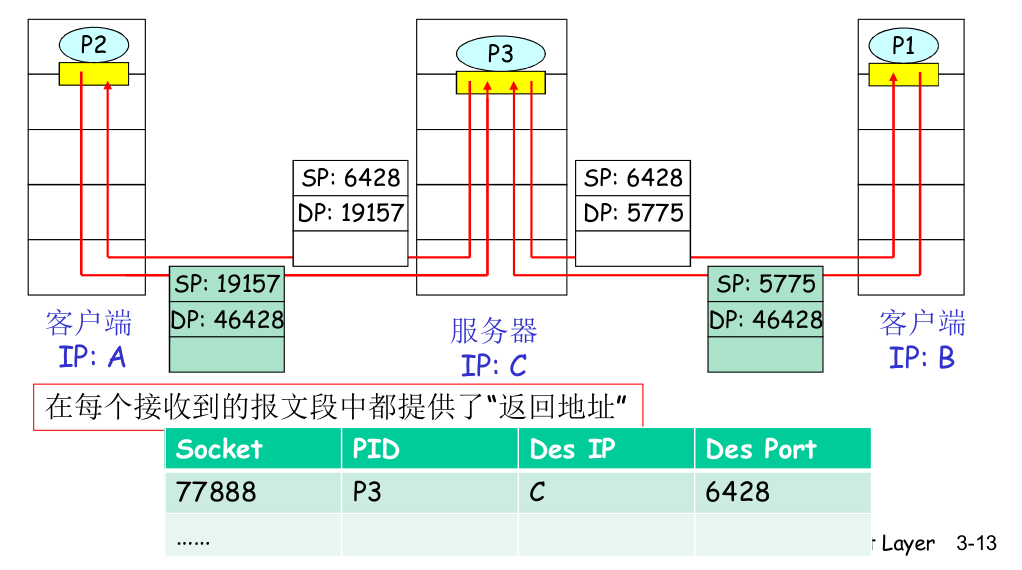
2.3.4.2 第二步:多个客户端发送数据
现在我们切换到第二张PPT的场景(注意,这里的进程和端口号与第一张图略有不同,但原理完全一样)。
- 场景描述:
- 服务器 (IP: C): 应用程序
P3正在监听46428端口。 - 客户端A (IP: A): 应用程序
P2从它自己的19157端口,向服务器C的46428端口发送了一个数据包。 - 客户端B (IP: B): 应用程序
P1从它自己的5775端口,也向服务器C的46428端口发送了一个数据包。
- 服务器 (IP: C): 应用程序
2.3.4.3 第三步:服务器进行解复用
这是整个过程最关键的一步。
-
服务器收到了两个数据包:
- 来自A的数据包:{源IP: A, 源Port: 19157} → {目标IP: C, 目标Port: 46428}
- 来自B的数据包:{源IP: B, 源Port: 5775} → {目标IP: C, 目标Port: 46428}
-
服务器如何决策? 根据我们开头的核心原理,服务器的传输层(UDP模块)在进行解复用时,它只看数据包的目标地址。
- 它看到第一个数据包的目标是
{IP: C, Port: 46428}。它会查询:“哪个应用程序在我这里的46428端口上监听?” 答案是P3。于是,它把这个数据包交给了P3。 - 接着,它看到第二个数据包的目标也是
{IP: C, Port: 46428}。它执行完全相同的逻辑,再次把这个数据包也交给了P3。
- 它看到第一个数据包的目标是
-
老师的讲解点: 老师在录音中反复强调:“你不管是谁发,是你这个IP发的还是你那个IP发的…虽然他们的源IP不一样,源端口也不一样,但是他们的目标IP都是这个机器的IP,目标端口都是
46428,最后是不是都到了这个P3这个应用进程?” 这正是这张图所要表达的核心:多对一的交付关系。
2.3.4.4 第四步:服务器如何回复?—— “返回地址”的重要性
你可能会问,既然P3收到了来自不同客户端的数据,它要怎么回复呢?
这就是第二张PPT中红色方框**“在每个接收到的报文中都提供了‘返回地址’”**的含义。
- 虽然UDP解复用时不使用源IP和源端口,但这些信息是完好无损地包含在接收到的数据包里的。
- 当应用程序
P3收到来自客户端A的数据包后,它可以从这个数据包中解析出源地址是{IP: A, Port: 19157}。如果P3需要回复,它就会创建一个新的数据包,将这个源地址作为目标地址,然后发送出去。 - 同理,当它处理来自客户端B的数据时,它也会知道返回地址是
{IP: B, Port: 5775}。
这样,服务器就能准确地将响应回复给正确的客户端,尽管它本身并没有和任何客户端建立“连接”。
2.3.4.5 总结
这个例子生动地展示了UDP无连接通信的特点:
- 服务器的“开放性”:它在指定端口上监听,可以接收来自任何客户端的数据。
- 解复用的“简单性”:仅根据目标IP和目标端口,就能决定将数据包交给哪个应用程序,非常高效。
- 通信的“无状态性”:服务器不需要维护连接状态。每个收到的数据包都自带了“返回地址”(即源IP和源端口),使得服务器可以按需进行回复。
3 3.3 无连接传输:UDP
3.1 UDP 协议介绍
UDP 的全称是用户数据报协议(User Datagram Protocol)。它在IP协议提供的服务基础上,主要增加了一个多路复用/解复用的功能。
这个功能使得数据传输从IP协议的“主机到主机”服务,提升到了UDP的“进程到进程”服务。
- 为什么叫数据报:因为是无连接的,每个UDP协议数据单元都是独立发送的
- IP也是独立的,也叫数据报
- 因此数据报可能指UDP,也可能指IP
3.1.1 “尽力而为”的服务
除了多路复用/解复用外,UDP没有在IP基础上增加额外的服务品质保障。因此,它和IP一样,提供的是一种“尽力而为”(best-effort)的服务。
这意味着UDP报文在传输过程中可能会:
- 丢失:数据包在网络中可能因为各种原因被丢弃。
- 乱序:后发出的数据包可能因为走了延迟更低的网络路径而先于先发出的数据包到达。
3.1.2 无连接特性
UDP是一种无连接的协议。在使用UDP通信前,两个应用的进程之间不需要握手,每个UDP报文段都被独立地处理。
发送端在发送数据时,上层应用会直接告知它目标IP和目标端口,以及要发送的数据内容。UDP根据这些信息封装数据报并发出,事前并不知道,也不需要知道将要和谁通信。
3.2 UDP 的应用场景
UDP协议经常被用于以下几类应用:
- 流媒体:特别是实时流媒体,这类应用对传输速率敏感,但对少量数据丢失不敏感。
- 事务性应用:例如DNS(域名解析)和SNMP(简单网络管理协议)。这类应用通常只需要一次请求和一次响应就能完成任务,使用无连接的UDP效率更高。
3.2.1 对可靠性的思考与协议栈架构
- 提问:如果我既想利用UDP的高效率、低开销等好处,又希望传输是可靠的,该怎么办?
- 回答:唯一的办法是在UDP之上的应用层自己去实现可靠性机制。
延伸讨论:为什么没有第三个传输层协议?
- 老师补充道,TCP和UDP这两种协议已经能够支撑超过85%的应用场景。协议栈中不再设置第三个折中的协议,是一个架构性问题。
增加新协议会使整个协议栈变得异常复杂,协议之间的协调也会成为一个大问题。因此,目前的架构就是提供两个明确的选择:要么TCP,要么UDP。
3.3 UDP 报文格式
UDP的报文也被称为数据报,因为它和IP一样是无连接的,每个数据单元都独立发送。因此,在上下文中,“数据报”可能指UDP数据报,也可能指IP数据报。
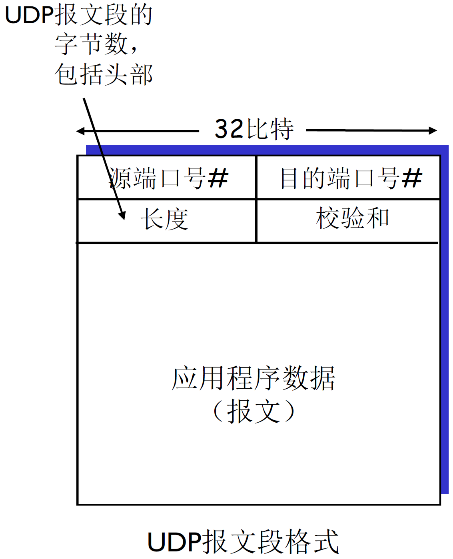
UDP报文由两部分组成:一个固定的8字节头部和数据载荷部分。
- UDP头部(8字节):
- 源端口号(2字节,16比特)
- 目的端口号(2字节,16比特)
- 长度(2字节):以字节为单位,表示整个UDP报文(包括头部和数据)的总长度。
- 校验和(2字节):这是一个差错检测码(EDC),用于检测报文在传输过程中是否出错。
- 应用数据(载荷):
- 这部分是上层应用交付给UDP传输的报文内容,也称为服务数据单元(SDU)。
当接收方通过校验和发现报文出错时,这个UDP报文会被直接丢弃。对于上层应用来说,出错的表现就是数据丢失。
3.4 UDP 的优点
尽管UDP不提供可靠性,但它依然被广泛使用,主要因为它有以下几个核心优点:
- 不建立连接:省去了TCP那样的握手过程,没有连接建立带来的时延和损耗。
- 简单:发送方和接收方都不需要维护连接状态。这大大减轻了服务器的负担。
- 头部开销小:UDP头部只有固定的8字节,而TCP头部至少20字节。这意味着在传输相同数据时,UDP的有效载荷占比更高。
老师用了一个比喻:头部就像运货的卡车本身,是开销(Overhead);载荷才是需要运输的货物。如果卡车本身(头部)太大,运输效率就低了。
- 无拥塞控制和流量控制:UDP不会考虑网络是否拥堵或接收方是否来得及处理。应用层以多快的速度把数据交给UDP,UDP就会以多快的速度把数据发向网络。
老师形容说,TCP像一个“忧虑的人”,时刻考虑对方和网络的状况;而UDP则像一个“直肠子”,上面来多快,它就发多快,非常适合网络摄像头这类需要持续发送数据的实时多媒体应用。
3.5 UDP 校验和
3.5.1 目标与原理
UDP校验和的目标是检测在传输过程中报文段(包括头部和数据)发生的差错,例如比特反转。
- 发送方:对需要保护的数据进行差错控制编码,计算出一个校验和(EDC),并将其放入UDP头部的校验和字段。这个编码关系本质上是一个“和”的关系。
- 接收方:收到数据后,用同样的方法计算校验和。如果计算出的值与报文携带的值相符,则认为数据没有出错。如果不符,则说明数据一定出错了,该报文将被丢弃。
3.5.2 残存错误
提问:通过了校验,数据就一定没有错吗? 回答:不一定。
存在一种概率极小但可能发生的情况:数据(D)和校验和(EDC)在传输中都发生了错误,变成了D’和EDC’,但“巧合的是”D’和EDC’之间仍然满足正确的校验关系。
这种无法被检测出来的错误,被称为“残存错误”。这也是为什么我们有时从网络下载一个大文件后,会发现文件已损坏无法打开的原因之一。
3.5.3 Internet校验和的计算细节
保护范围:老师特别强调,校验和保护的范围(D)不仅仅是UDP的数据部分,还包括UDP头部,甚至还包括一个由IP头部信息构成的“伪头部”。
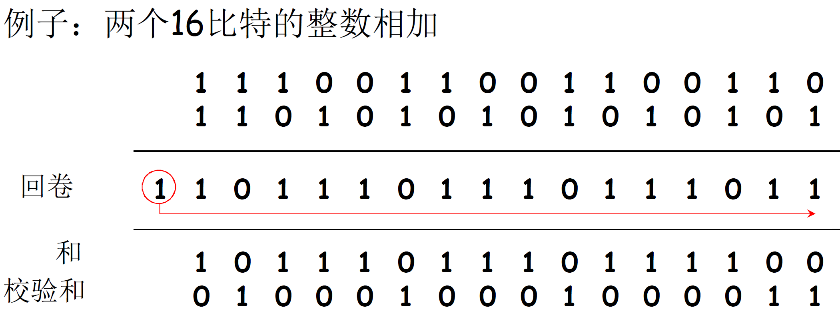
计算步骤:
- 将保护范围内的所有内容看作是一连串的16比特整数序列(如果最后不足16比特,则补0)。
- 对所有这些16比特的数进行二进制反码求和。
求和细节1:进位回卷(End-around carry) 在将两个16比特的数相加时,如果最高位(第16位)产生了进位,这个进位不能丢弃,而是要被“回卷”到结果的最低位上再加一次。
求和细节2:反码 将所有16比特数通过“进位回卷”的方式加在一起后,得到的那个和,再按位取反(0变1,1变0),最终得到的结果才是要填入校验和字段的值。
3.5.4 接收方的校验方法
接收方有一个简化的校验算法,效率更高:
- 将收到的UDP报文的整个保护范围(包括数据、头部、伪头部)以及校验和字段本身,都看作是16比特的数。
- 将所有这些数用“进位回卷”的方式加在一起。
- 判断结果:
- 如果最终的和是16个全1(即
FFFF),则说明校验通过,数据没有检测到错误。 - 如果结果不是16个全1,则说明数据在传输中一定发生了错误。
- 如果最终的和是16个全1(即
4 可靠数据传输(RDT)原理-Stop and Wait 协议
- RDT(Reliable Data Transfer) 在某些应用层、传输层和某些网络的数据链路层都很重要
- 是网络Top 10问题之一
4.1 RDT的抽象模型与核心任务
为了讲解原理,我们使用一个抽象和通用的模型。我们将协议的上层用户统一称为“应用层进程”,包括发送方进程(sending process)和接收方进程(receiver process)。
本层协议的目标是向上层提供可靠的服务。这意味着发送方发送的data,接收方就能原封不动地收到,保证数据无差错、不重复、不丢失且有序。
然而,要实现这一目标,协议本身需要依赖下层提供的服务,而下层提供的服务通常是不可靠数据传输(UDT)。
上层应用将data传递下来,本层协议会将其封装成协议数据单元,我们抽象地称之为packet(在TCP中,这被称为Segment)。然后,协议通过调用下层服务将packet发送出去。由于下层信道不可靠,这个packet可能会在传输中丢失、出错或乱序。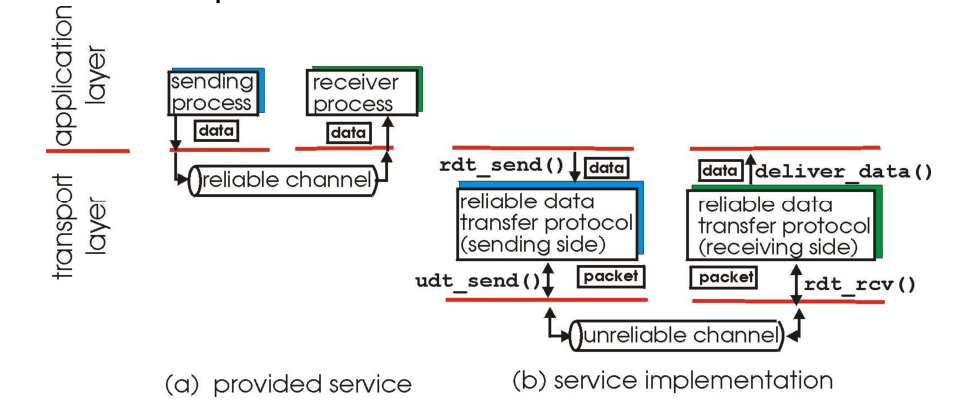
RDT面临的核心挑战是:如何在依赖一个不可靠服务的基础上,通过自身的协议机制和努力,向上层提供一个完全可靠的服务。
4.1.1 RDT的接口定义
为了更好地理解RDT的工作流程,我们明确其与上下层的交互接口。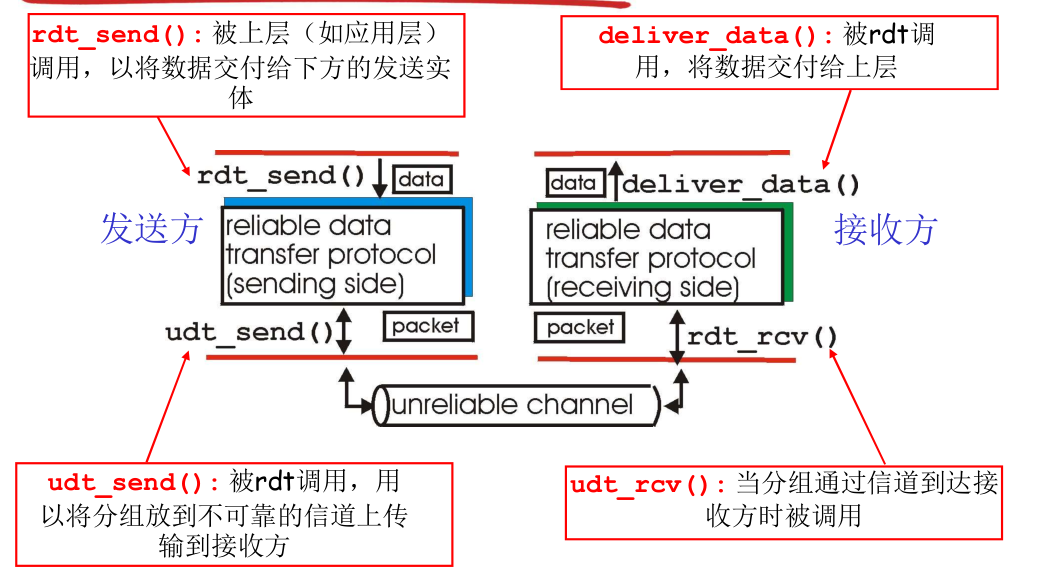
rdt_send():上层调用此接口,将数据(data)交付给RDT发送方。udt_send():RDT发送方调用此接口,将封装好的分组(packet)交给下层的不可靠信道进行传输。rdt_rcv():当下层信道将分组送达时,会调用此接口通知RDT接收方。deliver_data():RDT接收方在处理完收到的分组(如检查、排序)后,调用此接口将有效数据(data)交付给上层应用。
RDT协议实体的工作,就是在这些接口之间进行封装、解封装,并实现一系列复杂的控制逻辑。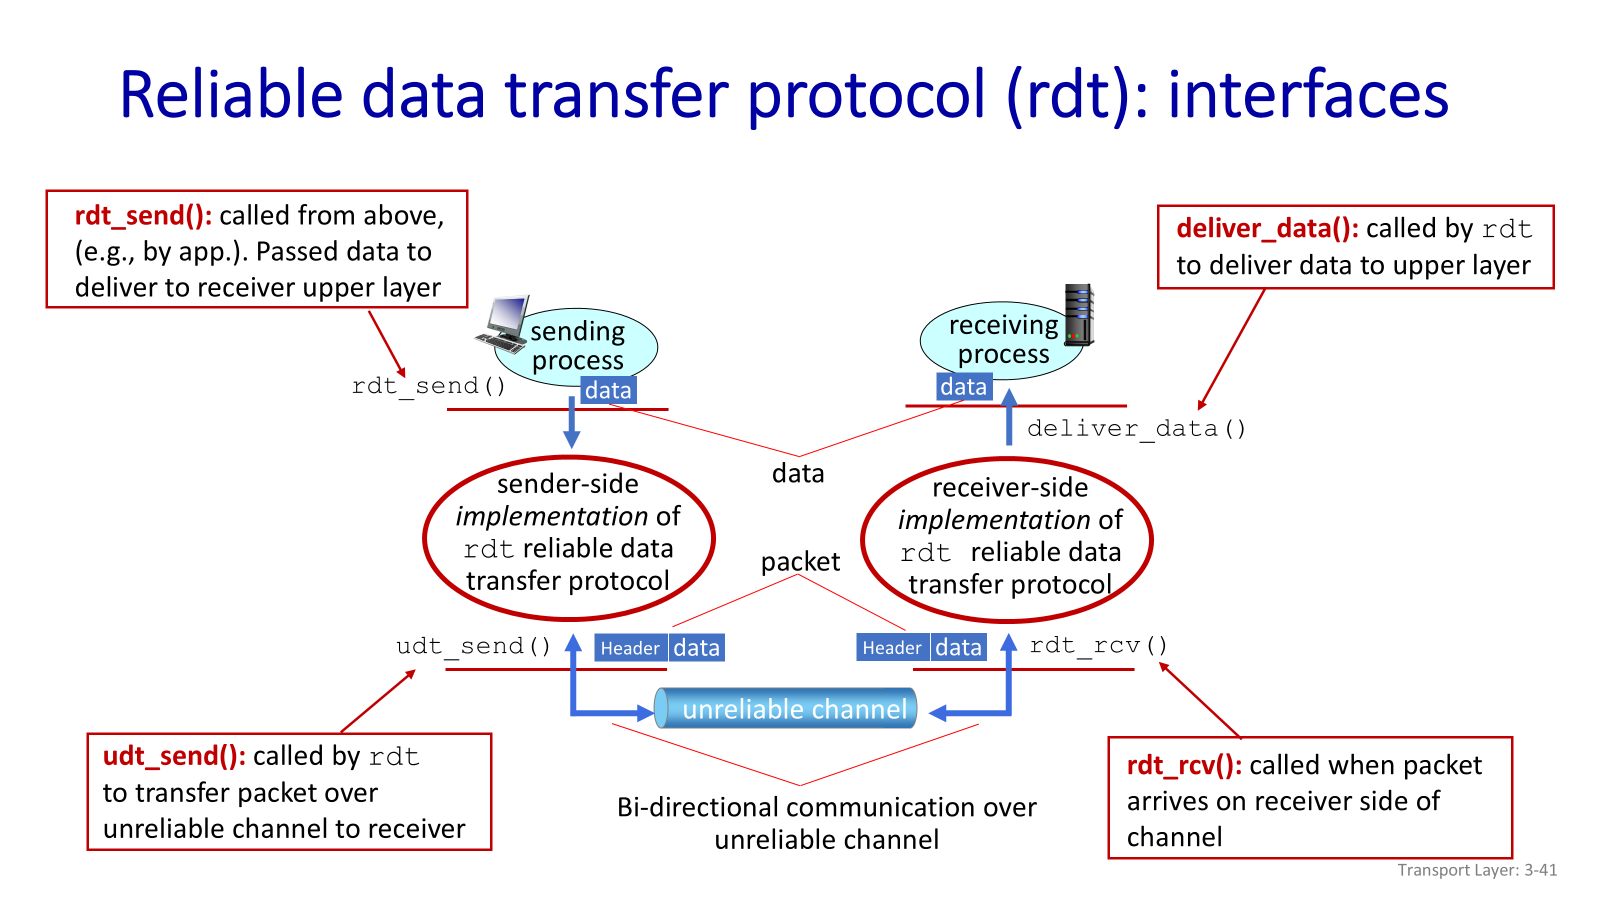
4.1.2 RDT协议的渐进式开发方法
为了避免一次性引入过于复杂的协议,我们采用一种渐进式的方法来设计RDT。我们从一个最理想化的假设开始,然后逐步去除这些假设,使信道越来越不可靠。
每去掉一个假设,下层信道就增加一种不可靠性。为了对抗这种新的不可靠性,我们就需要在RDT协议中增加相应的机制,使其变得更复杂,但目标始终不变:向上层提供可靠的服务。
这个过程说明了一个核心观点:底层信道的不可靠性,直接决定了RDT协议的复杂性。 底层越不可靠,协议就需要付出越大的努力来弥补这个差距。
4.1.3 关于数据流向的说明
在讲解原理时,我们通常只考虑单向的数据传输来简化问题。这并不会影响我们理解,因为一个双向的数据通信,本质上可以分解为两个独立的单向通信问题,其原理是对称的。
但需要强调的是,即使数据是单向流动的,控制信息(如确认、反馈)也必须是双向的。 发送方需要从接收方那里获得反馈,因此底层信道必须支持反向的信息传递。
4.1.4 使用有限状态机(FSM)描述协议
为了更精确、简洁地描述协议的工作机制,我们使用有限状态机(FSM)来进行形式化描述。相比自然语言,FSM更便于理解和检查。
FSM的关键元素包括: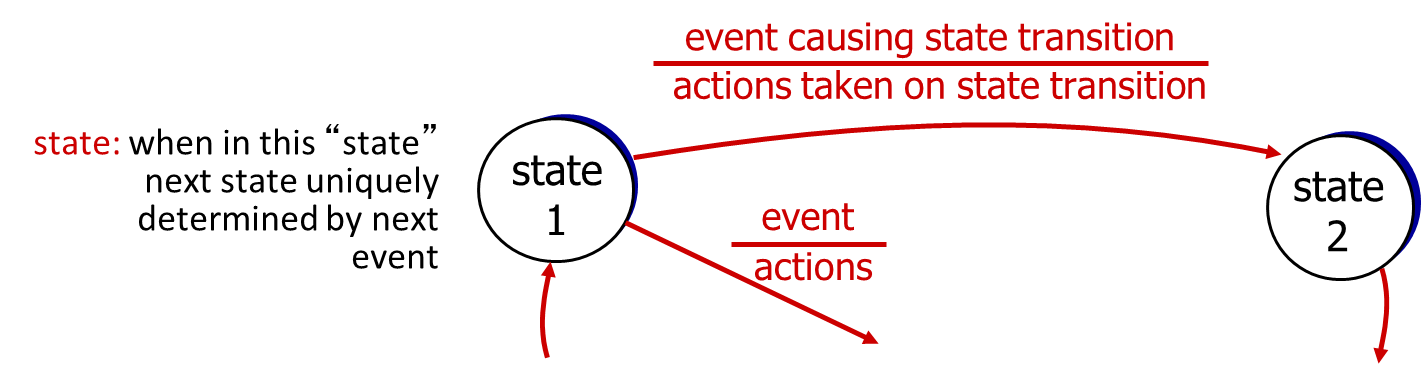
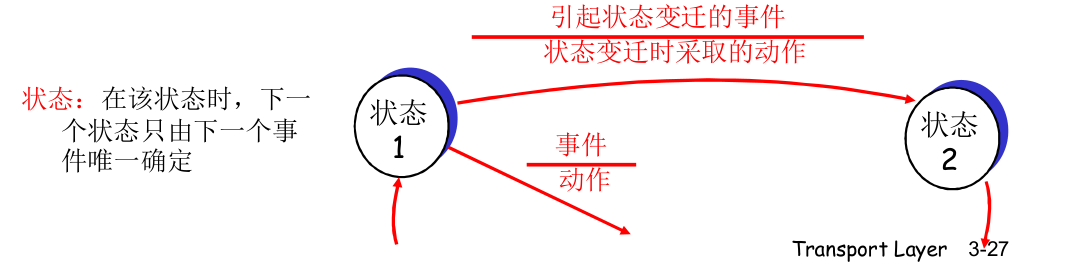
- 状态(State):用圆圈表示,代表协议在某一时刻所处的特定情况。
- 状态变迁(Transition):用箭头表示,代表从一个状态迁移到另一个状态。
- 事件/动作(Event/Action):标注在箭头上,通常写成分数形式。分子是触发状态变迁的事件(Event),分母是变迁过程中协议执行的动作(Action)。
协议处于某个状态时,具体会迁移到哪个新状态,完全由当前发生的事件来决定。
4.2 Rdt1.0:在可靠信道上的可靠数据传输
我们从最简单的情况开始,即Rdt1.0。
核心假设:底层的信道是完全可靠的。这意味着传输中既不会出现比特错误,也不会丢失任何分组。
在这种理想情况下,RDT协议的设计非常简单。
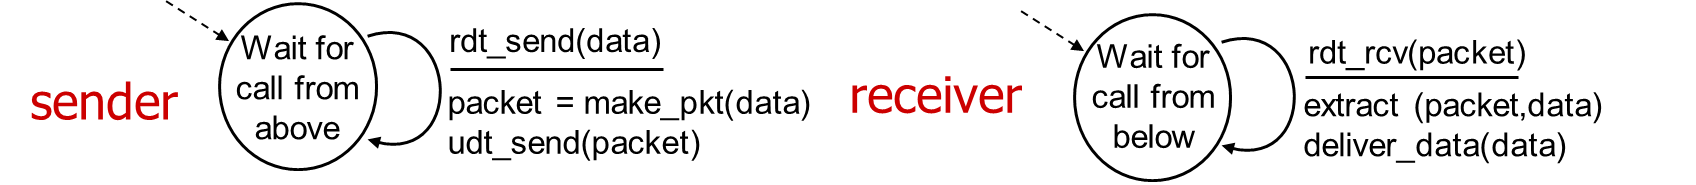
发送方:接收→封装→打走 接收方:解封装→交付 什么都不用干
发送方 (FSM):
- 发送方只有一个状态:“等待上层调用”。
- 当上层调用
rdt_send(data)事件发生时,发送方执行两个动作:首先将数据封装成packet,然后通过udt_send(packet)将它发送出去。 - 完成后,它立刻返回到原来的等待状态,准备处理下一个数据。
接收方 (FSM):
- 接收方也只有一个状态:“等待下层调用”。
- 当
rdt_rcv(packet)事件发生(即收到一个分组)时,它执行两个动作:从packet中提取出data,然后通过deliver_data(data)将数据交给上层。 - 随后,它也返回到等待状态。
在Rdt1.0中,协议实体几乎什么都不用做,仅仅是进行了一次封装和一次解封装。这好比“连长”非常能干可靠,作为“团长”的你无需任何额外操作,只需简单地下达和上传指令即可。
4.3 Rdt2.0:具有比特差错的信道
现在我们去掉第一个假设,允许底层信道在传输分组(packet)时出现比特翻转(bit-flip),即0变成1或1变成0。这意味着传输的数据可能会出错。
为了应对这种情况,我们需要引入新的机制。虽然数据传输是单向的,但控制信息的流动必须是双向的。我们会利用差错检测码(EDC)和接收方的反馈来解决这个问题。
接收方收到分组后,会利用差错控制编码进行校验。
- 如果校验通过(数据未出错),接收方会返回一个确认(ACK, Acknowledgement),表示“谢谢你,我收到了”。
- 如果校验失败(数据已损坏),接收方则返回一个否定确认(NAK, Negative Acknowledgement),可以理解为一种“反向的谢谢”,告知发送方分组出错了。
根据这些反馈,发送方会执行相应的动作:
- 收到
ACK后,发送方就可以发送新的数据分组。 - 收到
NAK后,发送方需要**重传(retransmit)**上一个发送的分组。为此,发送方必须在发送后保留一个分组的副本(缓存)。
Stop and Wait协议
sender sends one packet, then waits for receiver response
4.3.1 Rdt2.0的FSM描述
这个新机制使得协议的FSM变得更加复杂。
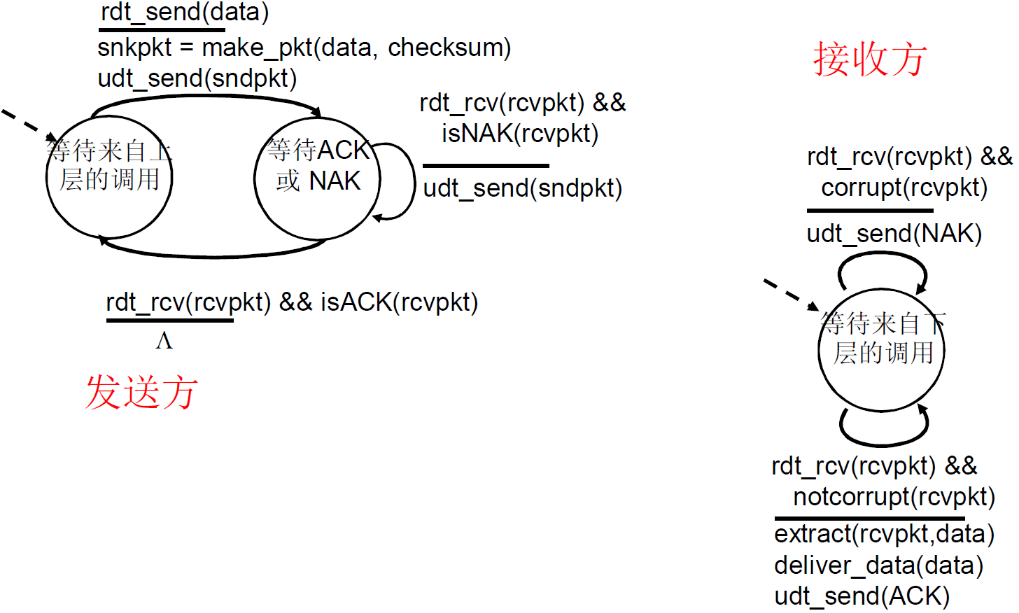
4.3.1.1 发送方 (Sender FSM)
发送方现在有了两个状态:“等待上层调用”和“等待ACK或NAK”。
- 发送过程:当上层调用
rdt_send(data)时,发送方创建包含数据和校验和(checksum)的分组,发送出去,然后进入“等待ACK或NAK”状态。 - 等待反馈:在此状态下,它会等待接收方的回应。
- 如果收到
NAK,说明对方没收到正确的分组,它会重传刚才的那个分组,并继续留在这个状态等待。 - 如果收到
ACK,说明对方已正确接收,它就转换回“等待上层调用”状态,准备发送全新的数据。
NOTE
- 初始:等到来自上层的调用
- 上层调用 rdt_send(data),然后rdt进行打包
snkpkt = make_pkt(data, checksum),此时打包加入了校验和checksum,然后调用udt_send(sndpkt)发送- 到达等待ACK或NAK状态
- 如果
rdt_rcv(rcvpkt) && isNAK(rcvpkt)即收到了响应并且响应是NAK,则重新发送udt_send(sndpkt),然后继续等待- 如果
rdt_rcv(rcvpkt) && isACK(rcvpkt),则什么都不做,回到初始状态
4.3.1.2 接收方 (Receiver FSM)
接收方的状态相对简单,始终是“等待下层调用”。
- 当从下层收到一个分组时,它会进行检查。
- 如果分组是损坏的(
corrupt),它就发送一个NAK作为回应。 - 如果分组是完好的(
notcorrupt),它会提取数据并交付给上层,然后发送一个ACK。
这个过程就像对话一样:我问你“懂了吗?”,如果你说“不懂”(NAK),我就会再讲一遍;直到你说“懂了”(ACK),我才会继续讲新的内容。
NOTE
- 初始状态:等待来自下层的调用
- 如果
rdt_rcv(rcvpkt) && corrupt(rcvpkt),即收到了文件并且 文件出错 的话,udt_send(NAK)发出NAK- 如果
rdt_rcv(rcvpkt) && notcorrupt(rcvpkt),即收到了文件并且文件没有出错
extract(rcvpkt,data)解析文件deliver_data(data)向上层发送数据udt_send(ACK)发送ACK
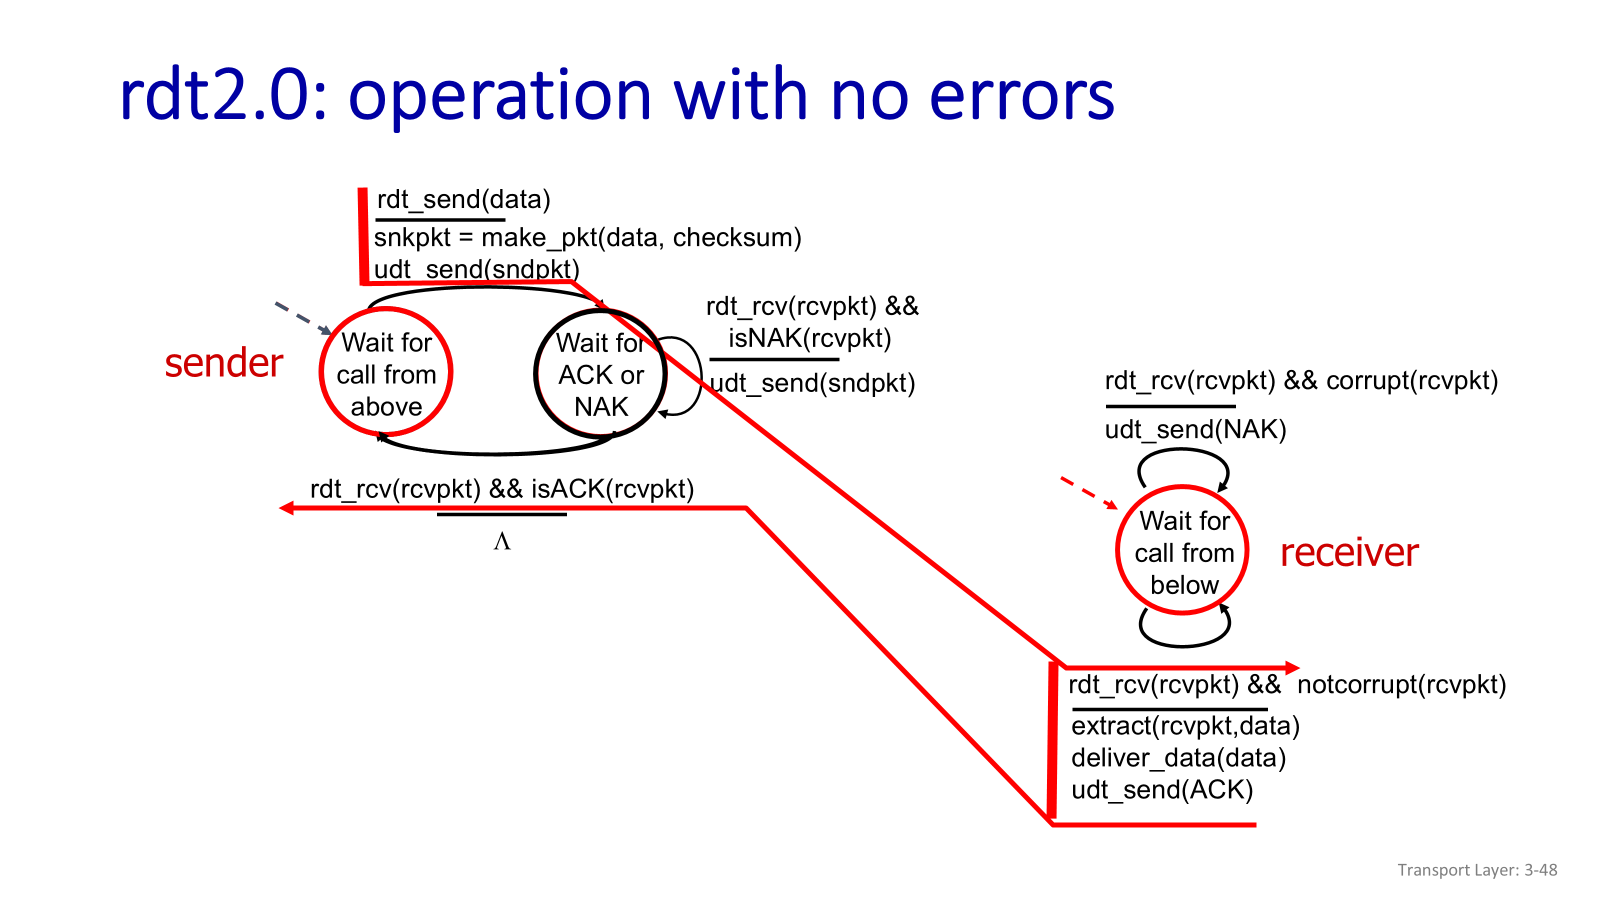
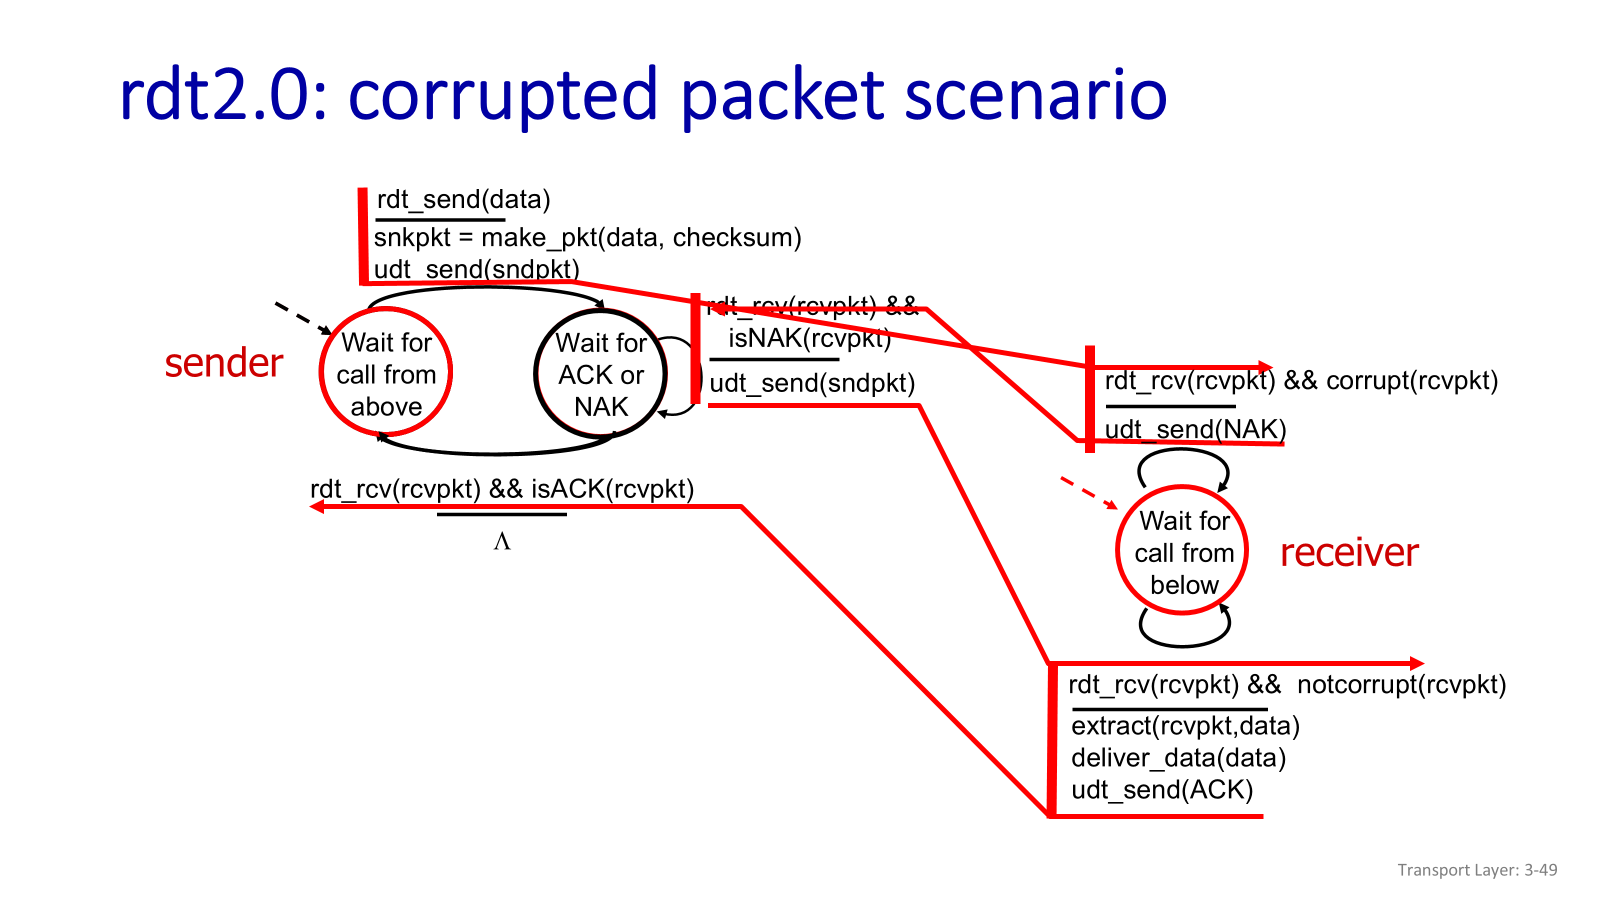
4.3.2 RDT2.0 Operations
4.3.2.1 rdt2.0: operation with no errors
4.3.2.2 rdt2.0: corrupted packet scenario
4.3.3 Rdt2.0的致命缺陷
Rdt2.0看起来不错,但它有一个致命的问题。我们假设了数据分组会出错,但ACK和NAK本身也是分组,它们在信道中传输时,同样可能会出错!
就如老师所说:“都在江湖飘,哪能不挨刀?”
如果ACK或NAK在传输中损坏了,发送方收到的就是一个无法识别的、乱码的消息。此时发送方就陷入了两难:
- 它不知道接收方是肯定还是否定。如果它选择重传,但接收方其实已经收到了并发送了
ACK,这就会造成重复。 - 如果它选择发送新数据,但接收方其实没收到并发送了
NAK,这就会造成数据丢失。
由于协议无法处理这种情况,说明它是不完备的。
4.4 Rdt2.1:处理出错的ACK/NAK
如果ACK/NAK出错?
- 发送方不知道接收方发生了什么事情!
- 发送方如何做?
- 重传?可能重复
- 不重传?可能死锁(或出 错)
- 需要引入新的机制 : 序号
为了解决Rdt2.0的缺陷,我们需要引入一种新的机制:序号(Sequence Number)。
核心思想是:当发送方收到一个损坏的、无法识别的反馈时,它采取最保守的策略——重传当前分组。
这样做可能会导致接收方收到重复的分组。但通过给每个分组增加序号,接收方现在有能力检测出这个重复。如果接收方发现收到的分组序号和上一个一样,它就知道这是一个重复分组,会直接将其丢弃,但仍然会为这个序号再次发送一个ACK。
这个额外的ACK至关重要,它能确保发送方最终能收到一个明确的信号,从而继续发送下一个新的分组,使得双方恢复同步。
处理重复:
- 发送方在每个分组中加 入序号
- 如果ACK/NAK出错,发送方重传当前分组
- 接收方丢弃(不发给上层)重复分组
- 接收方通过 序号判断 ,是否重复接收同样的包,在进行下一次流程/发送ack
4.4.1 停止等待协议 (Stop-and-Wait)
Rdt2.1这种“发送一个分组,然后停下来,等待对方确认后,再发送下一个”的模式,被称为停止等待协议(Stop-and-Wait Protocol)。
在这种协议中,因为在任何时刻信道中最多只有一个待确认的分组,所以我们只需要一个1位的序号(0和1)就足够了。这个序号足以区分当前的分组和紧接着的下一个分组,从而检测出重复。
后续我们会学习流水线协议,它允许一次性发送多个未经确认的分组,那时就需要更多位的序号了。
4.4.2 Rdt2.1的FSM描述
引入序号后,协议的状态数增加了一倍,因为它必须记住当前期望的序号是0还是1。
4.4.2.1 发送方 (Sender FSM)
发送方的状态从2个变成了4个,分别是:“等待上层调用0”、“等待ACK/NAK 0”、“等待上层调用1”和“等待ACK/NAK 1”。状态0和1的逻辑是完全对称的。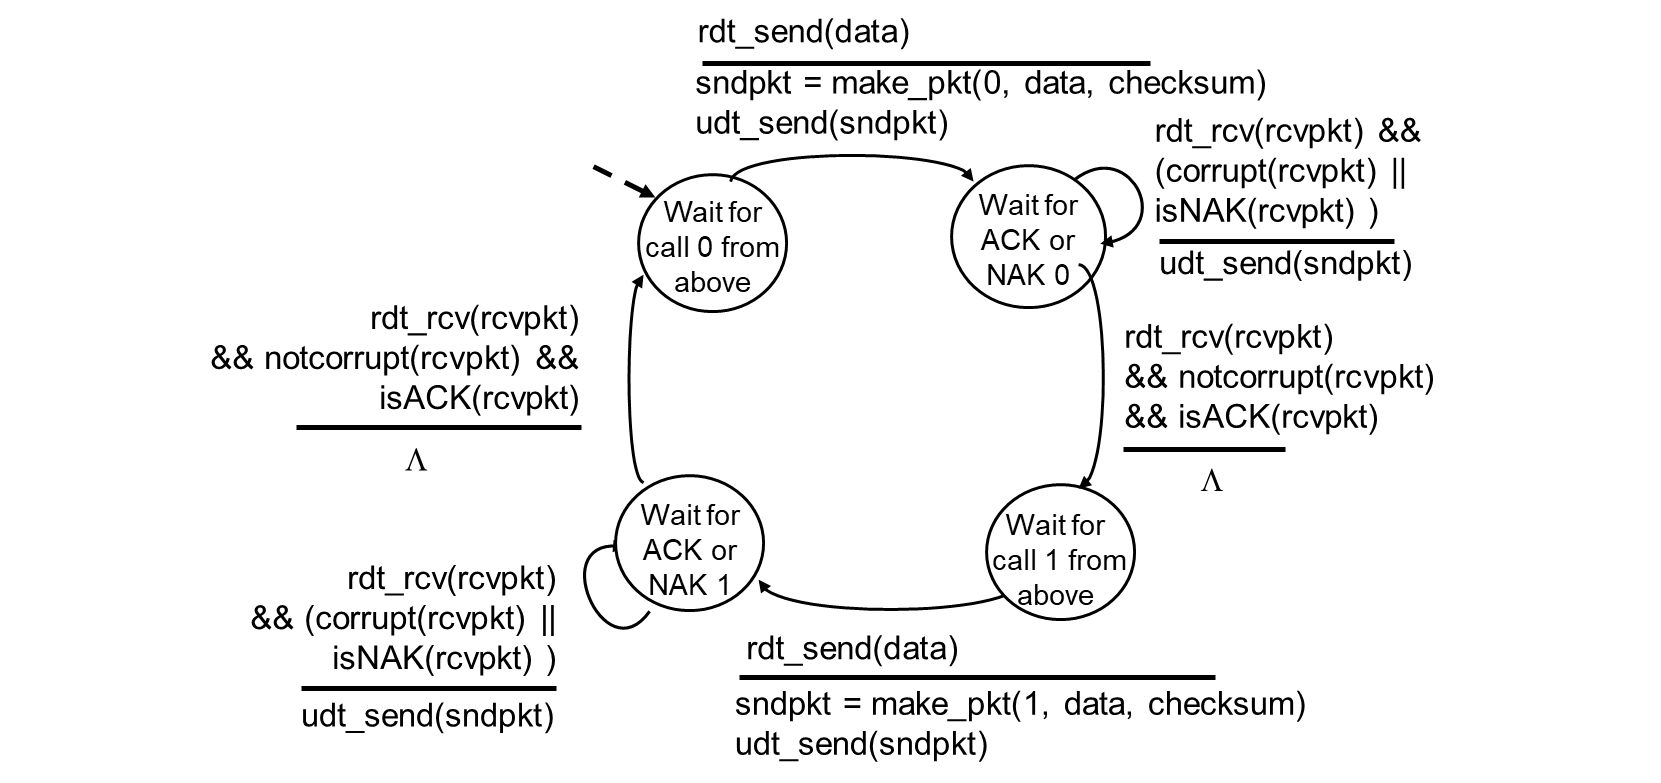
例如,当发送方发送了序号为0的分组后,它会进入“等待ACK/NAK 0”状态。此时,如果收到损坏的反馈或NAK,它会重传0号分组。只有当收到一个未损坏的ACK时,它才会转换到“等待上层调用1”状态,准备发送1号分组。
- 在分组中加入序列号
- 两个序列号(0,1)就 足够了
- 一次只发送一个未经确认 的分组
- 必须检测ACK/NAK是否 出错(需要EDC )
- 状态数变成了两倍
- 必须记住当前分组的序列号为0还是1
4.4.2.2 接收方 (Receiver FSM)
接收方的状态从1个变成了2个:“等待下层的0号分组”和“等待下层的1号分组”。
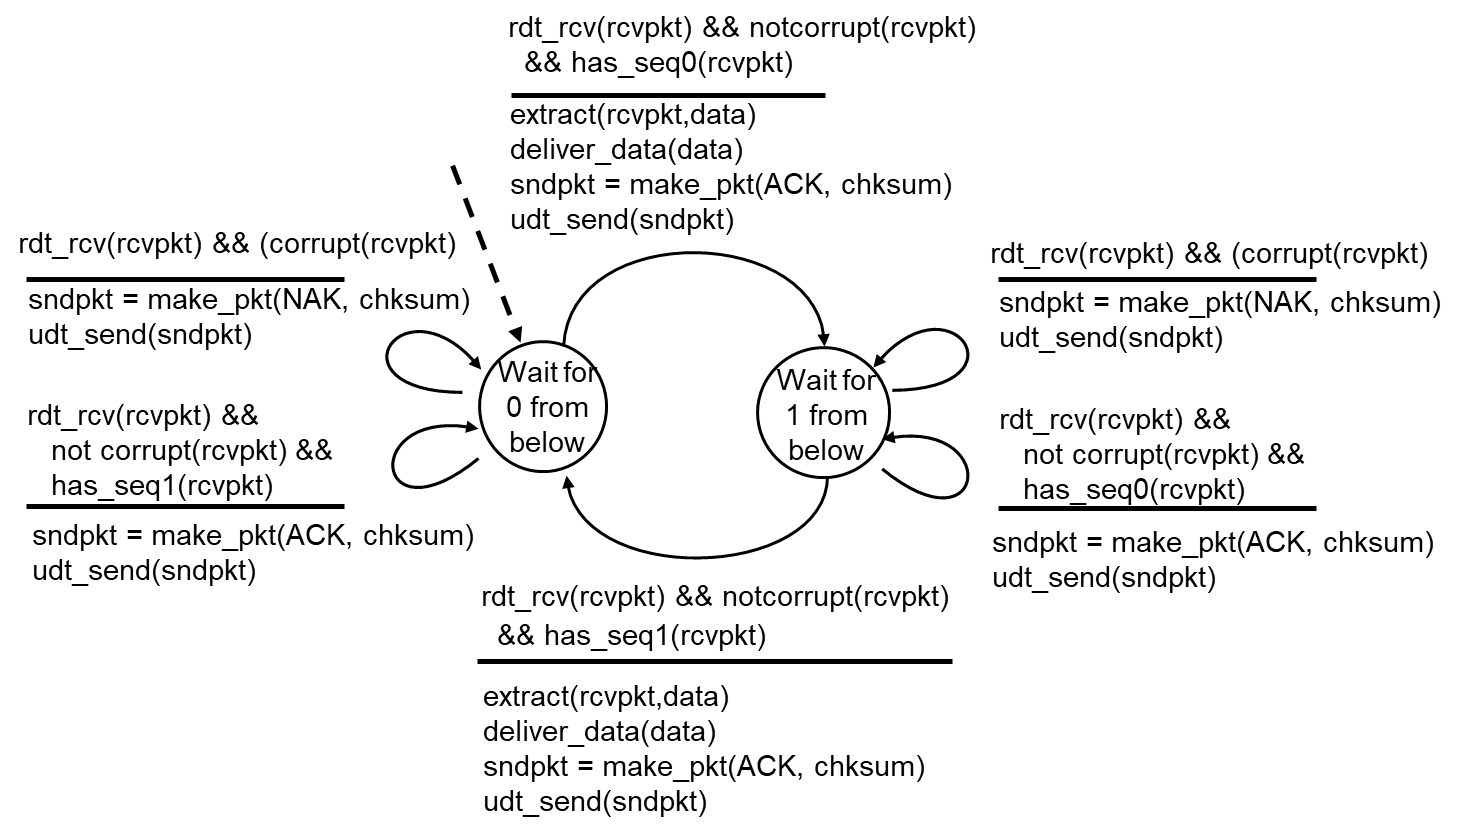
例如,当接收方处于“等待1号分组”状态时,可能会发生三种事件:
- 正确情况:收到了一个完好无损的1号分组。此时,它提取数据、向上交付、发送
ACK,并转换到“等待0号分组”状态。 - 重复情况:收到了一个完好无损的0号分组。这说明它之前发送的对0号分组的
ACK丢失或损坏了。它会丢弃这个重复的0号分组,但会重新发送一个ACK,并继续停留在“等待1号分组”状态。 - 出错情况:收到了一个损坏的分组。它会发送一个
NAK,并继续停留在“等待1号分组”状态。
- 必须检测接收到的分组是否是重复的
- 状态会指示希望接收到的 分组的序号为0还是1
注意:接收方并不知道 发送方是否正确收到了其ACK/NAK
4.4.3 Rdt2.1的讨论
没有“确认的确认”
一个关键点是,接收方在发送ACK或NAK后,并不知道发送方是否成功收到了这个反馈。协议中并没有设计“对确认的确认”机制。
如果这么设计,就会陷入无限循环:确认的确认需要确认,确认的确认的确认也需要确认,永无止境。
接收方只能通过发送方的后续行为来推断。如果发送方发送了下一个序号的分组(如pkt1),接收方就知道它之前对pkt0的ACK被成功收到了。如果发送方又重传了一遍pkt0,接收方就知道它之前的ACK没有被收到。
4.4.4 RDT2.1的运行
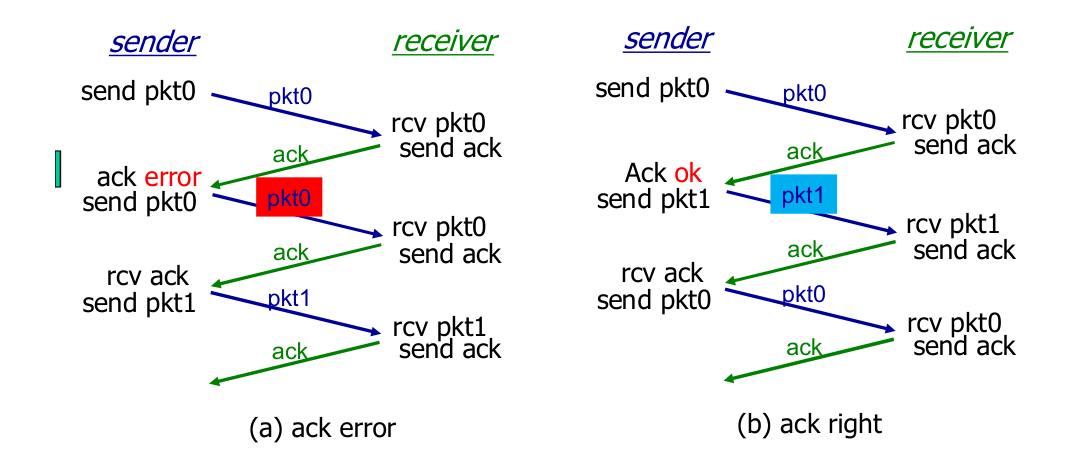
接收方不知道它最后发送的ACK/NAK是否被正确地收到
- 发送方不对收到的ack/nak给确认,没有所谓的确认的确认;
- 接收方发送ack,如果后面接收方收到的是:
- 老分组p0?则之前的ack错误
- 下一个分组?P1,之前的ack正确
01仅仅是标识老旧的符号,并不表示顺序,如果上方右侧的pkt1的ack错误的话,下次sender返回的还是pkt1
4.5 Rdt2.2:一个无NAK(NAK-Free)的协议
接下来是Rdt2.1的一个升级版本,Rdt2.2。它的核心功能与Rdt2.1完全相同,但实现方式更巧妙:它完全不使用否定确认(NAK),只使用带有编号的确认(ACK)。
4.5.1 核心思想与动机
在Rdt2.1中,我们有两种反馈信息:ACK(正向确认)和NAK(反向确认)。当协议变得更复杂,比如后面要学的流水线协议,需要同时处理多个分组的确认时,为每个分组都维护两种反馈会非常麻烦。
Rdt2.2通过一种方式简化了这一点:用对前一个分组的重复ACK,来代替对当前分组的NAK。
- 功能同rdt2.1,但只使用ACK(ack 要编号)
- 接收方对 最后 正确接收的分组发ACK,以替代NAK
- 接收方必须显式地包含被正确接收分组的序号
- 对当前分组的反向确认(NAK)可以用前面一个分组的正向确认代替
- 比如已经ACK0了,接受到了分组错误,sender本来应该收到ACK1,但是收到了ACK0,说明ACK1不会发过来,就错误
- 当收到重复的ACK(如:再次收到ack0)时,发送方与收到NAK采取相同的动作:重传当前分组
- 为后面的一次发送多个数据单位做一个准备
- 一次能够发送多个
- 每一个的应答都有:ACK,NACK;麻烦
- 使用对前一个数据单位的ACK,代替本数据单位的nak
- 确认信息减少一半,协议处理简单
4.5.2 协议流程与优点
我们通过一个例子来理解其工作流程:
- 发送方发送
packet 0,接收方正确收到后,回复ACK0。 - 发送方继续发送
packet 1,但这个分组在传输中损坏了。 - 接收方检测到
packet 1出错。此时,它不发送NAK,而是再次发送一个ACK0。 - 发送方收到了这个重复的
ACK0。因为它正在等待对packet 1的确认,所以这个ACK0明确地告诉它:“你刚才发的packet 1我没收到,我最后正确收到的是packet 0”。 - 于是,发送方重传
packet 1。 - 这次
packet 1被正确接收,接收方回复ACK1,双方恢复同步,继续传输。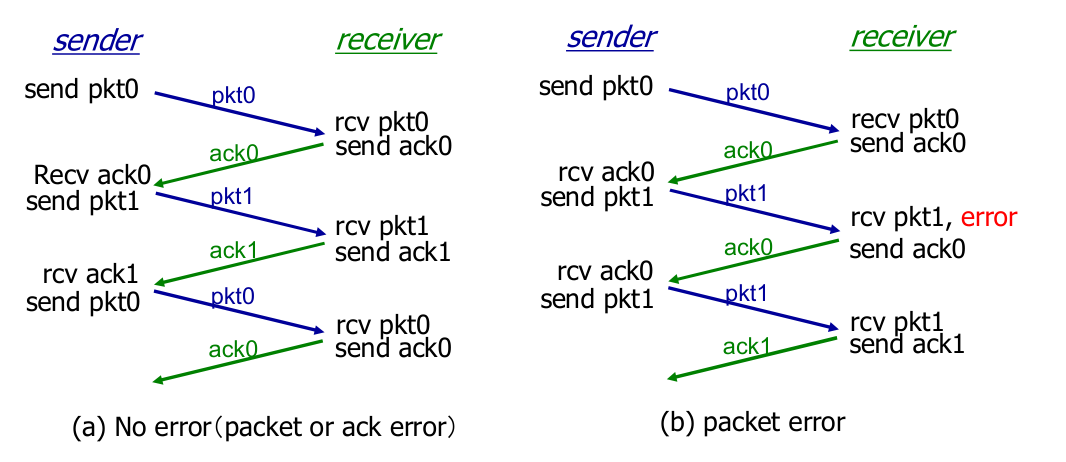
这种设计的优点是显著的:
- 简化协议:确认信息只有一种(
ACK),协议处理逻辑更简单。 - 减少信息量:确认信息的种类减少了一半。
- 为未来做准备:为一次发送多个分组的流水线协议奠定了基础。
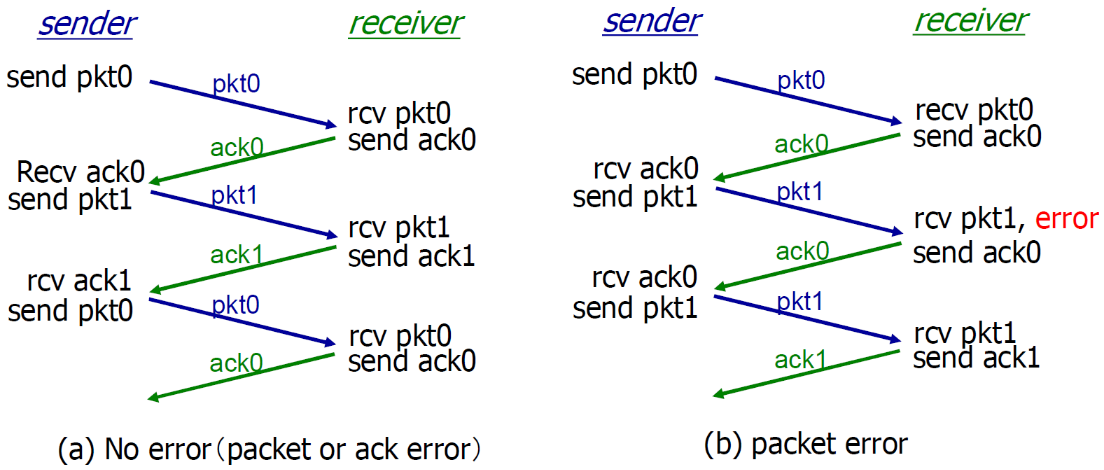
packet 0出错
接收方:收到一个无法通过校验和检查的损坏分组。
- 在Rdt2.1协议中,接收方会直接发送一个
NAK(否定确认)。- 在Rdt2.2(无NAK协议)中,它会发送一个对“上一个”分组的
ACK。因为当前期望的是0号分组,所以它会发送ACK1,这个非预期的ACK起到了和NAK同样的效果。发送方:在发送
packet 0后,它会等待ACK0。当它收到NAK或非预期的ACK1时,就会明白packet 0传输失败。结果:发送方会重传
packet 0。这个过程会一直持续,直到接收方最终成功收到一个完好的packet 0为止。
这种方法也能解决ACK出错的问题
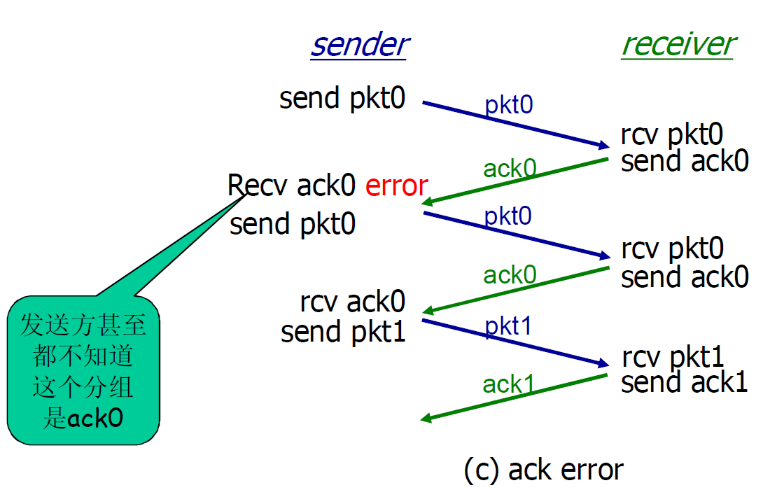
4.5.3 处理出错的ACK
这个无NAK的协议同样能很好地处理ACK本身出错的情况,其鲁棒性与Rdt2.1相同。
设想ACK0在返回途中损坏了。
- 发送方会收到一串乱码,它无法判断是什么。按照最坏情况打算,它会重传
packet 0。 - 接收方此时会收到一个重复的0号分组。由于分组本身带有序号,接收方可以轻易检测出这是重复的。
- 接收方会丢弃这个重复分组,并再次发送一个
ACK0。 - 这个新的
ACK0最终能让发送方确认0号分组已成功,从而继续发送1号分组,使双方重新同步。
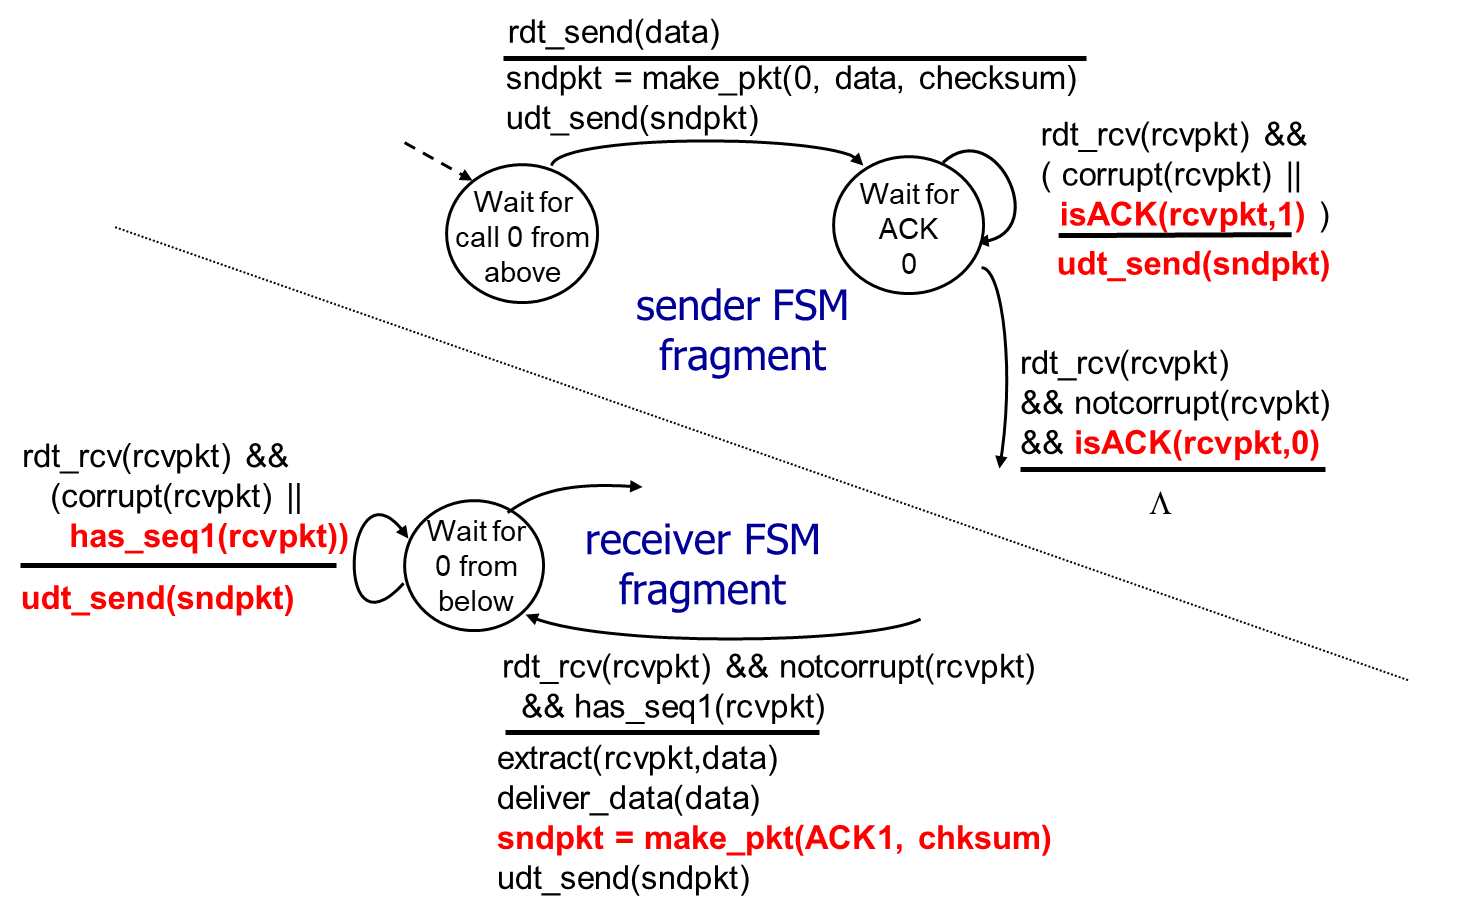
4.5.4 与Rdt2.1的FSM对比【rdt2.2: sender, receiver fragments】
Rdt2.2的有限状态机(FSM)在结构上和Rdt2.1几乎完全一样。唯一的区别在于接收方遇到损坏分组时的动作。
在Rdt2.1中,接收方会发送NAK。而在Rdt2.2中,它会发送一个对上一个正确分组的ACK。这个改动虽然小,但从协议设计的角度看,是一种优化和演进。
4.6 Rdt3.0:具有比特差错和分组丢失的信道
现在,我们去掉最后一个理想化的假设:底层信道现在不仅可能出错,还可能丢失分组。无论是数据分组还是ACK确认分组,都有可能在传输过程中彻底消失。
分组丢失的一个常见原因是路由器的队列溢出。当网络拥堵时,路由器来不及处理到来的分组,其内部缓存队列被占满,后续到达的分组就会被丢弃(drop)。
如果不对分组丢失做任何处理,协议将陷入死锁(deadlock)。发送方发送了一个分组后,会永远等待一个不会到来的ACK;而接收方则会永远等待一个已经丢失了的分组。
4.6.1 超时重传机制
为了打破这种死锁,Rdt3.0引入了一个至关重要的机制:超时重传(Timeout Retransmission)。
其工作原理如下:
- 发送方在每发送一个分组后,启动一个倒计时定时器(timer)。
- 这个定时器的时长被设定为一个“合理”的时间,通常略长于一个正常的往返时间(RTT)。
- 如果在定时器倒计时结束前,发送方收到了对应的
ACK,就一切正常,并取消该定时器。 - 如果定时器超时,而
ACK仍未到达,发送方就有理由相信分组或其ACK已经丢失。此时,它会重新发送同样的分组,并重启定时器。
这种超时重传机制可能会引入重复。例如,如果只是ACK丢失,或者分组只是延迟较大而非丢失,那么重传就会造成重复。但这并不是一个新问题,因为我们已经有序号机制来让接收方检测并丢弃重复的分组。
4.6.2 超时时间的设定
超时时间的设定非常关键,它在不同网络层次的实现方式也不同:
- 数据链路层:通信通常在两个直接相连的设备间进行,往返延迟(RTT)非常稳定且分布集中。因此,可以设置一个固定的、确定的超时时间。
- 传输层(如TCP):通信需要跨越整个互联网,路径复杂多变,导致RTT的波动范围很大。设置一个固定值是不合适的。因此,TCP采用一种自适应(adaptive) 的超时机制,它会持续测量RTT,并动态地计算出一个合适的超时时间。
4.6.3 Rdt3.0的运行流程与FSM
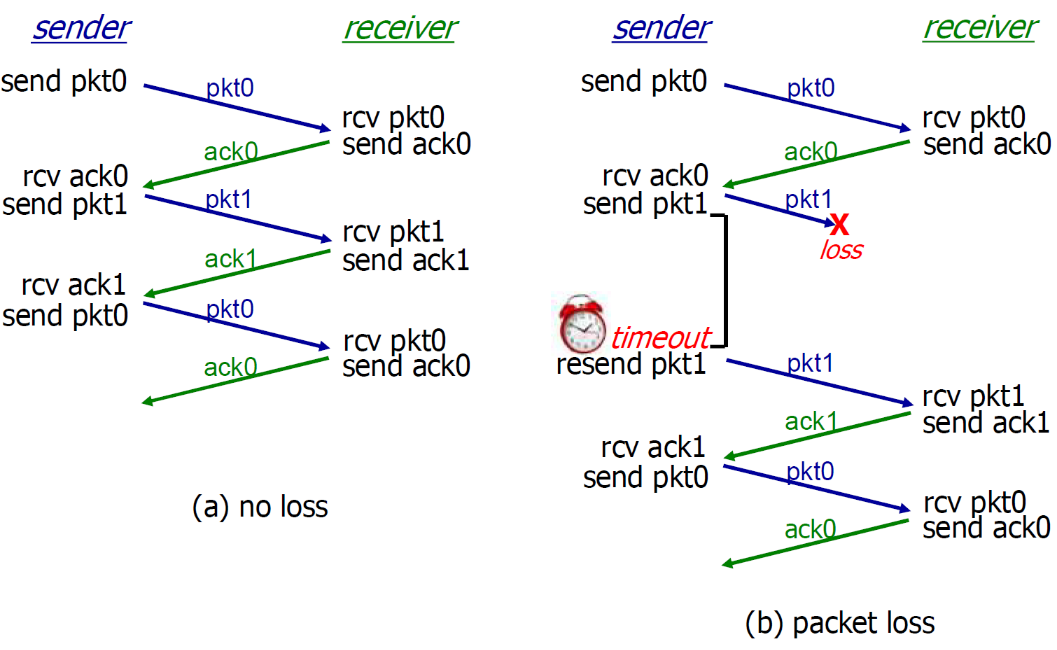
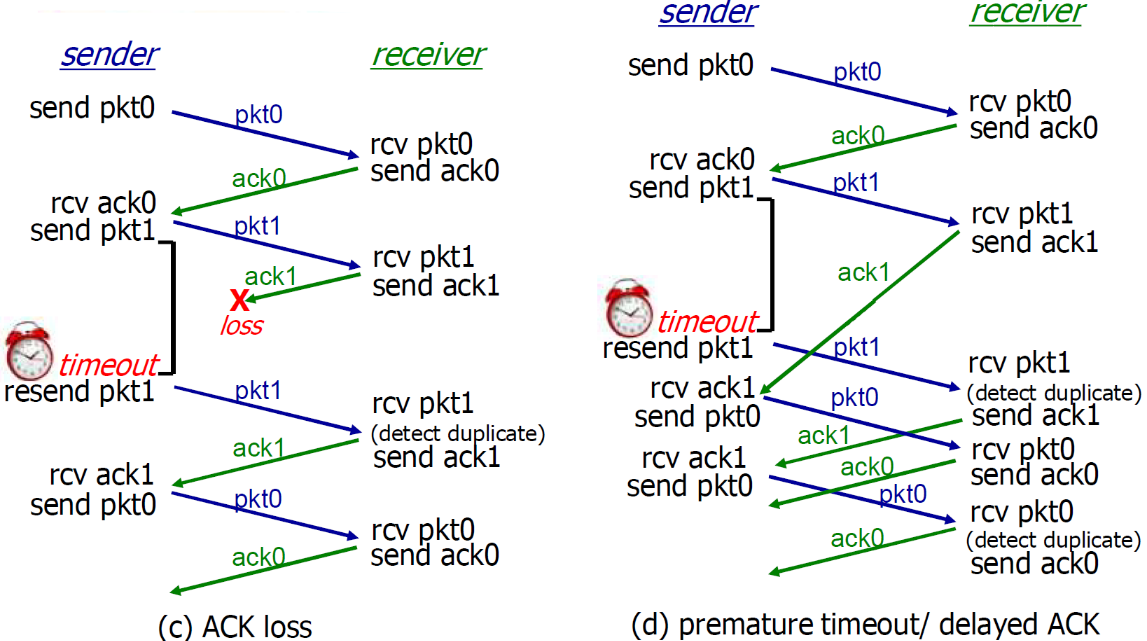
示意图示意图
- b:可以看到p丢失的情况下可以正常工作
- c:可以看到ACK丢失的情况下依旧可以正常工作(sender发送了pkt1,然后receiver收到pkt1发现是旧的之后,接收,发哦送了ack1)
- d:超时时间设置的过短了
Rdt3.0的FSM在Rdt2.2的基础上增加了定时器管理:
- 新的动作:发送分组后,立即
start_timer。收到正确的ACK后,stop_timer。 - 新的事件:在等待
ACK的状态中,增加了一个timeout事件。 - 超时后的动作:如果发生
timeout,则重传分组并重新start_timer。
我们来看几种典型场景下的运行情况:
- 分组丢失 (Packet Loss):发送方发送
pkt1后启动定时器。pkt1在网络中丢失。定时器超时后,发送方重传pkt1。接收方收到重传的pkt1后,发送ACK1,双方恢复同步。 - ACK丢失 (ACK Loss):发送方发送
pkt1,接收方成功收到并发送ACK1,但ACK1在返回途中丢失。发送方因未收到ACK1而超时,重传pkt1。接收方收到重复的pkt1后,会丢弃它,但仍会重新发送一个ACK1。这个新的ACK1最终能让发送方继续前进。 - 过早超时 (Premature Timeout):如果超时时间设置得太短(例如,正常RTT是100ms,但超时设为90ms),即使分组只是延迟较大,也会被误判为丢失。
- 这会导致不必要的重传,接收方会收到重复的分组,并为每个分组都回复
ACK。 - 发送方相应地也会收到重复的
ACK,并可能因此发送重复的下一个分组。 - 结论:协议仍然可以正确工作,但效率会变得极低,信道中充满了大量重复的分组和确认。
- 这会导致不必要的重传,接收方会收到重复的分组,并为每个分组都回复
4.6.4 发送方和接收方的FSM
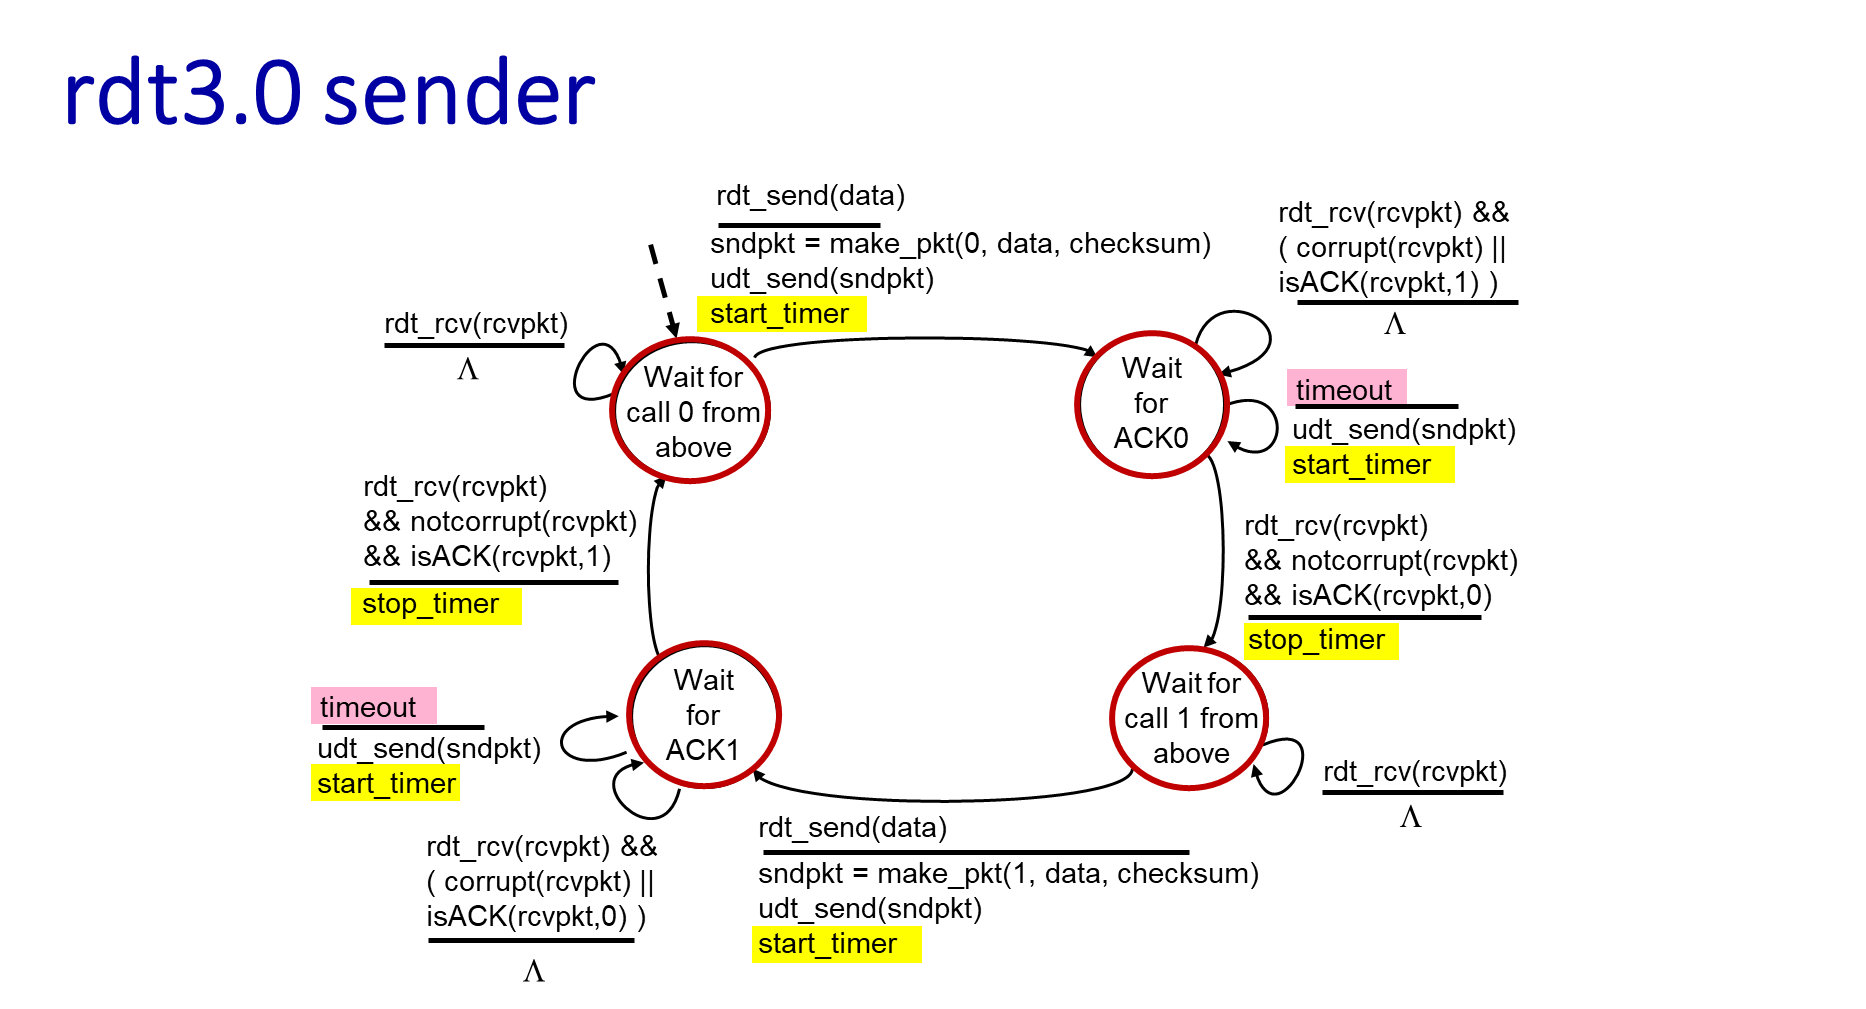
注意:接收方的FSM和rdt2.2的一样!
4.7 停止等待协议的性能瓶颈
至此,Rdt3.0已经是一个功能完备、能在有差错和有丢包的信道上实现可靠传输的协议了。然而,它存在一个巨大的性能问题。
停止等待协议的性能,在链路容量(或称带宽时延积)较大的情况下会变得非常差。
老师用了两个生动的比喻来解释这个现象:
- 高速公路:从合肥到北京的高速公路(信道)很长,可以容纳成千上万辆车。如果规定必须等第一辆车到达北京并电话确认后,下一辆车才能从合肥出发,那么在任何时刻,这条路上都只有一辆车在跑,绝大部分路面都是空闲的,利用率极低。
- 偏远火车站:一个偏远的小站,一天只有一趟火车经过。火车通过车站的几分钟是“繁忙”的,剩下超过23个小时都是“空闲”的。这个车站的利用率也同样极低。
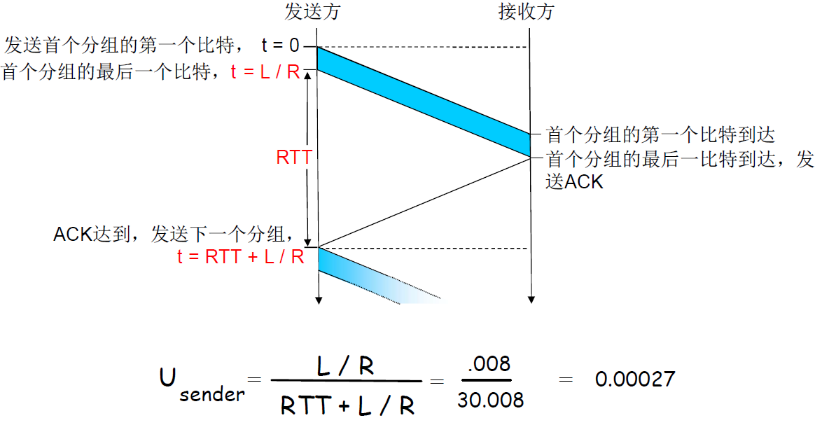
4.7.1 性量化分析
我们通过一个具体的例子来精确计算其效率:
- 链路带宽 (R): 1Gbps ( b/s)
- 单向传播时延: 15 ms
- 分组大小 (L): 1 KB (8 kb)
- 往返时延 (RTT): ms = 30 ms
4.7.1.1 1. 计算发送时间 ()
发送时间是指将一个完整的分组推上信道所需的时间。
公式:
计算:
发送一个1KB的分组仅需8微秒。
4.7.1.2 2. 计算信道利用率 ()
利用率是指在一个完整的工作周期(从发送分组到收到确认)中,发送方真正用于发送数据的时间所占的比例。
公式:
计算:
这意味着信道的利用率只有 0.027%!超过99.9%的时间里,信道都处于空闲等待状态。
WARNING
注意:这里算总周期时间要用RTT
4.7.1.3 3. 计算有效吞吐量 (Throughput)
有效吞吐量是实际观察到的数据传输速率。
公式: 有效吞吐量
计算: 有效吞吐量
这个结果令人震惊:你花钱购买了1Gbps的昂贵带宽,但由于协议的限制,实际得到的数据传输速率仅有270 kbps。这里的瓶颈不在于物理链路,而在于网络协议本身。
4.7.2 解决方案: 流水线技术 (Pipelining)
要解决停止等待协议的性能瓶颈,就必须打破“一次只发送一个分组”的规则。
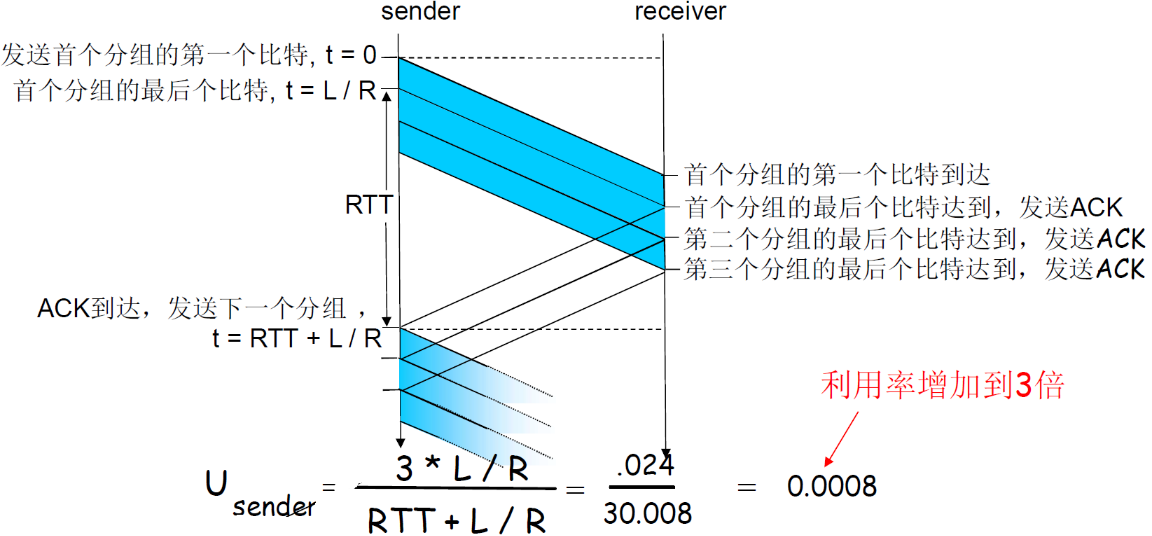
解决方案是允许发送方连续发送多个分组,而无需等待前一个分组的确认,这被称为流水线(Pipelining) 技术。通过让多个分组同时在信道中“飞行”,可以极大地提高信道利用率和吞吐量。
通过流水线技术,信道利用率可以得到显著提升。如果我们允许发送方一次性发送 个分组,那么发送时间就变成了 倍。
新的利用率公式:
例如,如果一次发送3个分组 (),利用率将变为原来的3倍:
4.7.2.1 流水线的极限
我们不能无限制地增加 来提高利用率。当 增加到某个值,使得发送 个分组的时间 () 恰好等于一个RTT时,信道就基本上被填满了,利用率接近100%。
一旦利用率达到100%,性能的瓶颈就从协议转移到了链路带宽本身。这就是我们希望达到的理想状态,即物理资源的性能被充分压榨。这正如同“短筒效应”:补齐了协议这块短板后,性能的极限就由链路带宽这块新的“短板”来决定了。
5 可靠数据传输原理-流水线协议 (Pipelined Protocol)
5.1 从停止等待到流水线协议
我们在之前的课程中已经了解了 RDT 3.0 协议,它是一个相对完美的可靠数据传输协议,能够应对分组的出错与丢失。但它存在一个致命问题:在信道容量较大时,其利用率非常低。
为了解决这个问题,我们需要引入一种新的机制,允许一次性发送多个分组,而不需要等待前一个分组的确认。我们把这种一次可以发送多个未经确认分组的协议,统称为 流水线协议 (Pipeline Protocol)。
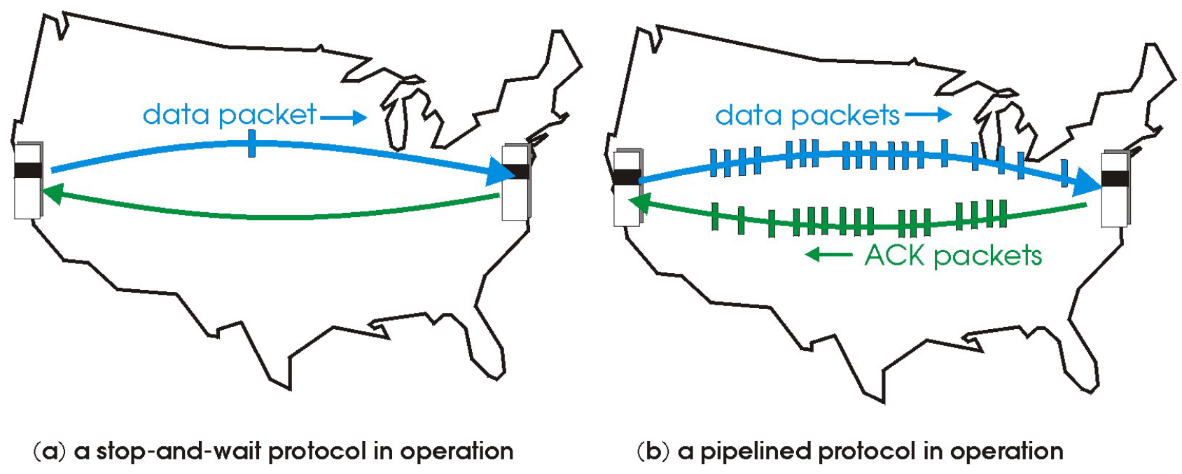
流水线协议的核心思想是让数据分组像流水线一样,源源不断地从发送方流向接收方,同时确认信息也不断地从接收方返回。这样可以使链路在任何时刻都保持忙碌,从而将链路利用率提升至接近100%。
5.1.1 流水线协议的两个核心机制
要实现一次发送多个未经确认的分组,协议必须解决两个基本问题:
-
需要更大的序号空间:既然要连续发送多个分组,我们就必须用多个比特位来表示分组的序号。例如,如果我们使用 个比特来表示序号,那么总的序号空间就是 。
-
需要发送方和接收方缓冲区:
- 发送方缓冲区:用于暂存那些已经发送出去、但还未收到确认的分组。这样,一旦发生超时或者收到错误报告,发送方可以从缓冲区中取出相应分组进行重传。
- 接收方缓冲区:主要用于协调速度不匹配的问题。因为上层应用程序从接收缓冲区读取数据的速率,与网络中分组到达的速率可能不一致。同时,它也用来缓存乱序到达的分组,以便排序后交付给上层。
5.2 滑动窗口协议 (Sliding Window Protocol)
基于流水线思想,我们主要会学习两种具体的协议:回退N步协议 (Go-Back-N, GBN) 和 选择性重传协议 (Selective Repeat, SR)。接下来,我们会先介绍一个更通用的概念——滑动窗口协议,它是理解 GBN 和 SR 的基础。
我们可以这样来区分它们:
- 当 发送窗口 = 1,接收窗口 = 1 时,它就是 停止等待协议 (Stop-and-Wait)。我们之前学习的 RDT 3.0 就属于这一类。
- 当 发送窗口 > 1,接收窗口 = 1 时,它就是 回退N步协议 (Go-Back-N, GBN)。
- 当 发送窗口 > 1,接收窗口 > 1 时,它就是 选择性重传协议 (Selective Repeat, SR)。
| slide window | sw(sending window) | rw(receiving window) | 协议 | 说明 |
|---|---|---|---|---|
| =1 | =1 | stop-wait | 如果发送窗口和接收窗口数量都为1,是stop-wait协议 | |
| 流水线协议 | >1 | =1 | GBN | 如果发送窗口>1,接收窗口=1,是GBN协议 |
| 流水线协议 | >1 | >1 | SR | 如果发送窗口和接受窗口都 > 1 是SR协议 |
其中,发送窗口大于1的协议(GBN 和 SR),我们都称之为流水线协议。它们的根本区别在于接收窗口的大小。
5.2.1 发送方:发送缓冲区与发送窗口
发送缓冲区
- 发送缓冲区是内存中的一块区域,用于存放所有可能需要发送或重传的分组。它的作用是存放那些已经发送但尚未得到确认的分组。
- 发送缓冲区的大小决定了发送方在未收到任何确认的情况下,最多可以连续发送多少个分组。这个值不是越大越好,因为链路的利用率最高只能是100%,过大的缓冲区并不能带来更多收益。
- 缓冲区内的分组可以分为两类:
- 已发送但未确认的:这些分组必须保留在缓冲区中,以备超时重传。
- 可发送但未发送的:如果上层应用有新的数据,可以封装成这些分组并立即发送。
发送窗口
- 发送窗口可以看作是发送缓冲区的一个子集或范围。它精确地定义了那些“已发送但未被确认”的分组序号所构成的空间。
- 发送窗口的最大值不能超过发送缓冲区的大小。我们可以通过一个形象的方式来理解发送窗口的移动。
5.2.2 发送窗口的移动机制
为了便于学习和表示,我们通常采用一种“相对滑动”的方式来描述窗口的移动:我们假定分组序号是固定不动的,而窗口在这个序号序列上向前滑动。
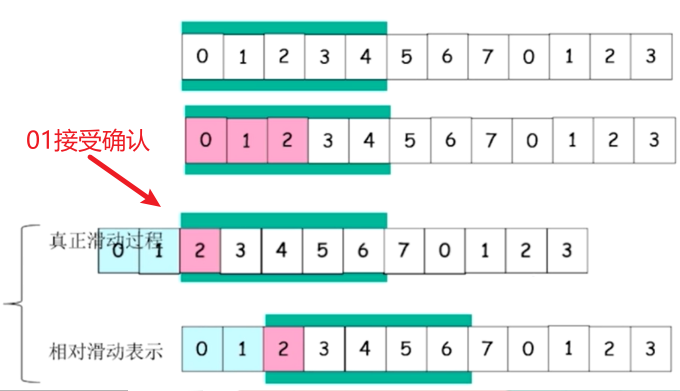
相对滑动表示:就是队列不变,但是缓冲区向前移动了
5.2.2.1 一开始:没有发送任何一个分组
- 后沿=前沿
- 之间为发送窗口的尺寸=0
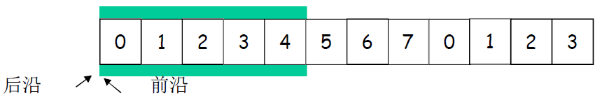
5.2.2.2 发送窗口前沿 (Front Edge) 的移动
每发送一个分组,前沿前移一个单位
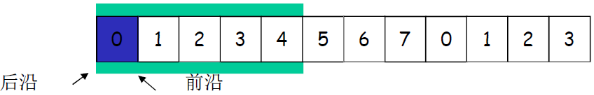
- 移动条件:每当发送方发送一个新的分组时,发送窗口的前沿就会向前移动一个单位。
- 移动极限:发送窗口的前沿不能无限前移。它的极限是当窗口的尺寸达到发送缓冲区的大小时。此时,发送缓冲区已被用满,发送方必须暂停发送新的分组,直到收到已发送分组的确认。
发送窗口 前沿移动的极限 :不能够超过 发送缓冲区的大小
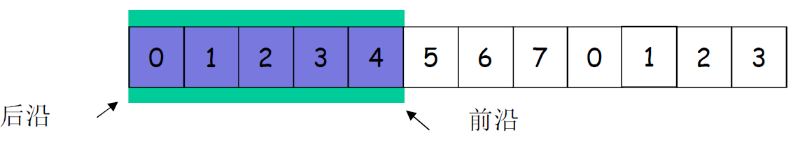
5.2.2.3 发送窗口后沿 (Rear Edge) 的移动
- 移动条件:当发送方收到了“最老”的、也就是序号最小的那个未确认分组的确认后,后沿就可以向前移动。
- 移动结果:后沿向前移动后,一些旧的分组被确认,可以从缓冲区中移除。这样就为新的、即将到来的分组腾出了空间。
- 移动极限:后沿的移动不能超过前沿。最极端的情况是,窗口内所有已发送的分组都被确认了,此时后沿会紧贴着前沿,窗口大小变为0。
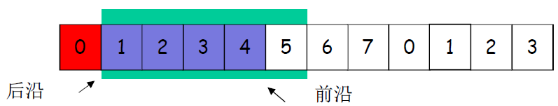
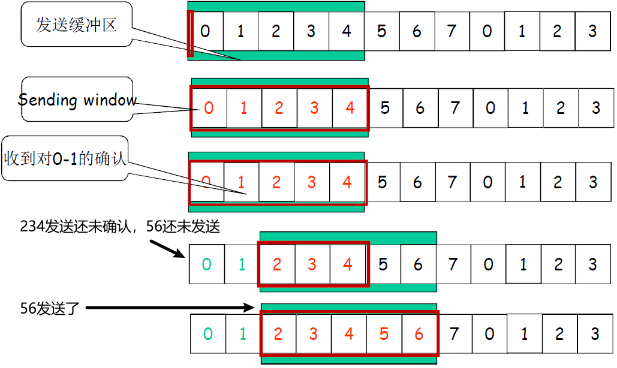
5.2.2.4 一个完整的例子
- 初始状态:发送缓冲区为空,发送窗口大小为0,前后沿贴在一起。
- 发送过程:发送方连续发送了0, 1, 2, 3, 4号这五个分组。每发送一个,前沿就向前移动一格。当这五个分组全部发送完毕后,窗口尺寸达到上限5,前沿停止移动。
- 接收确认:此时,发送方收到了0号和1号分组的确认。于是,发送窗口的后沿向前移动到2号分组的位置。现在,窗口内包含2, 3, 4号这三个“已发送未确认”的分组。同时,发送缓冲区也空出了两个位置(5号和6号)。
- 继续发送:如果上层应用有新的数据,发送方可以立刻发送5号和6号分组。发送后,前沿再次向前移动,窗口尺寸又达到了上限5(包含2, 3, 4, 5, 6号分组),发送再次暂停。
5.2.3 接收方:接收窗口
接收窗口等同于接收缓冲区,它定义了接收方当前愿意接收哪些序号的分组。
情况一:接收窗口大小 = 1 (GBN 协议)
当接收窗口大小为1时,接收方只能按顺序接收分组。
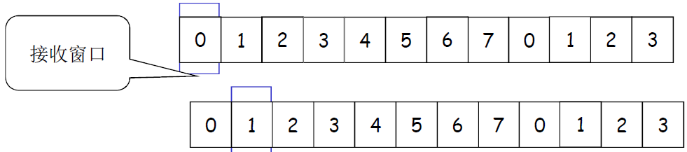
- 例如,窗口当前在2号位置,意味着接收方只等待2号分组的到来。
- 如果此时3号分组先到了,接收方会将其直接丢弃,因为它是一个“乱序”分组。
- 丢弃后,接收方会重新发送一个对最后一个按序收到的分组的确认(在这个例子中是1号分组,即发送 ACK 1)。这个确认是在告诉发送方:“我仍在等待2号分组”。
情况二:接收窗口大小 > 1 (SR 协议)
当接收窗口大小大于1时,接收方可以接收并缓存乱序的分组。
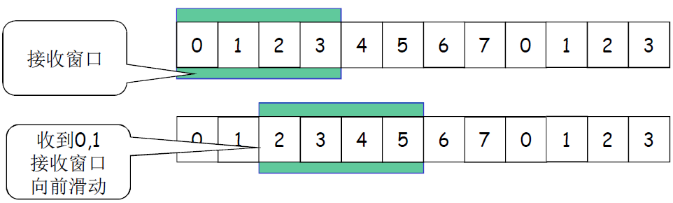
- 窗口的滑动:只有当序号最小的那个期望分组(即窗口下沿对应的分组)到达时,接收窗口才能向前滑动。例如,窗口范围是 [2, 3, 4, 5, 6],只有当2号分组到达后,窗口才能滑动。
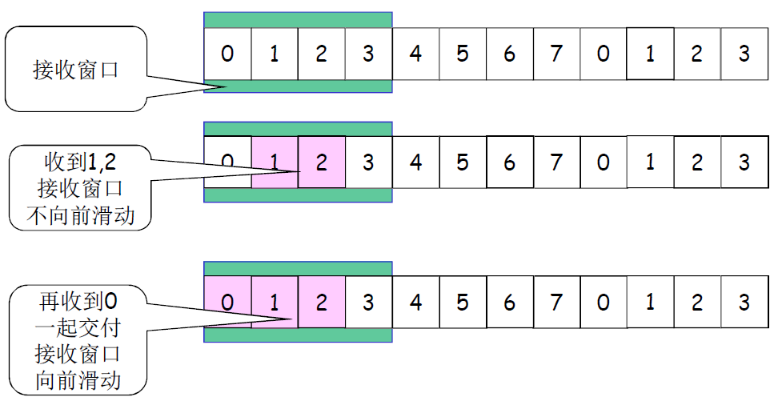
- 对乱序分组的处理:如果2号未到,但3号和4号先到了,由于它们落在接收窗口的范围内,接收方会接收并缓存它们。但此时窗口不能向前滑动。
- 发送确认:与GBN不同,SR协议对每一个成功接收的分组都发送一个单独的确认。收到3号,就发ACK 3;收到4号,就发ACK 4。这种确认方式是非累积的。ACK 3只代表收到了3号,不代表3号之前的所有分组都已收到。
5.2.3.1 一个完整的例子 (SR)
- 初始状态:接收窗口范围为 [0, 1, 2, 3, 4]。
- 接收过程:0号分组到达,被接收,窗口向前滑动一格,变为 [1, 2, 3, 4, 5],并发送 ACK 0。
- 乱序到达:此时2号分组丢失,但3号和4号分组到达了。接收方会接收并缓存3号和4号,同时分别发送 ACK 3 和 ACK 4。但接收窗口不能移动,因为窗口下沿期望的2号分组还未到达。
- 等待的分组到达:随后,2号分组终于到达。接收方接收2号分组,并发现2, 3, 4号现在是连续的。于是,它将这三个分组的数据一起、按顺序地交付给上层应用。
- 窗口滑动:因为2, 3, 4号都已处理完毕,接收窗口可以一次性向前滑动三格,新的范围变为 [5, 6, 7, 8, 9]。
5.2.4 正常情况下两个窗口的互动
在没有发生丢包或出错的理想情况下,发送窗口和接收窗口的互动是一个流畅的循环过程:
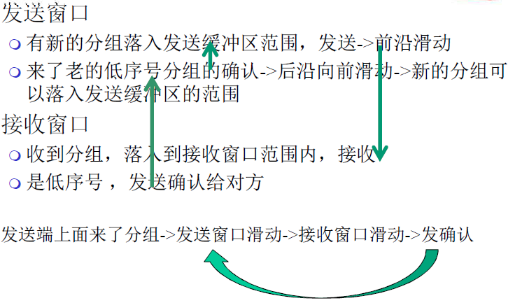
- 动力来源:发送方的上层应用有数据要发送。
- 发送方动作:新的分组进入发送缓冲区,发送方将其发出,发送窗口的前沿向前滑动。
- 接收方动作:分组按顺序到达接收方的窗口下沿。接收方接收分组,发送确认,并将接收窗口向前滑动。
- 发送方响应:发送方收到来自接收方的确认,这些确认对应其窗口下沿的分组。于是,发送窗口的后沿也向前滑动。
- 循环:后沿的滑动为发送缓冲区腾出了新的空间,使得上层应用可以继续提交数据,整个过程循环往复。
这个过程的根本驱动力在于发送方上层用户的持续数据发送。
5.3 正常情况下的GBN
5.3.1 Go-Back-N: Sender
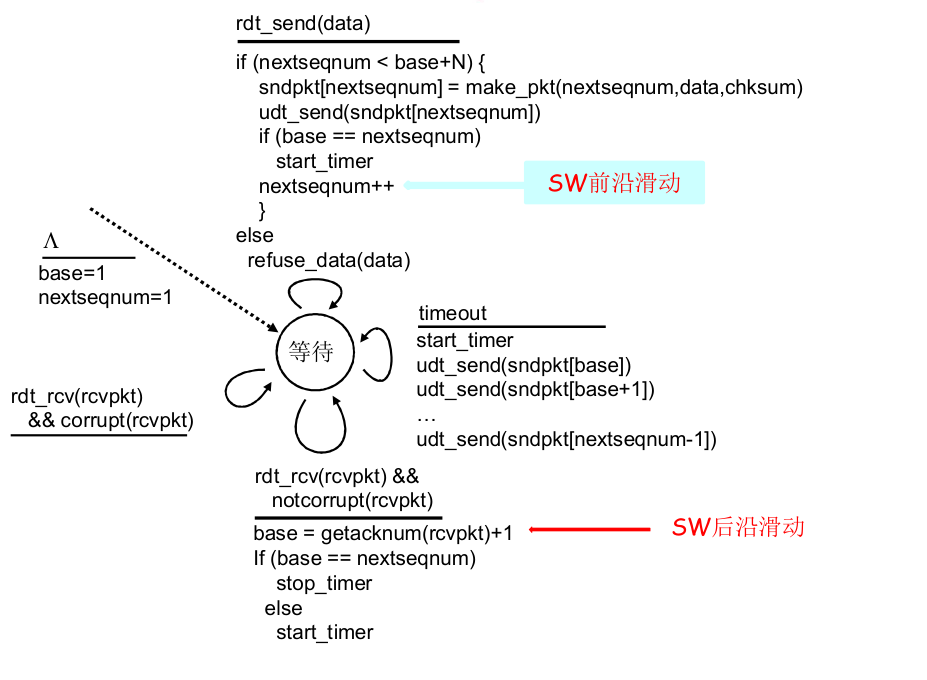
-
sender: “window” of up to , consecutive transmitted but unACKed pkts
- -bit seq in pkt header
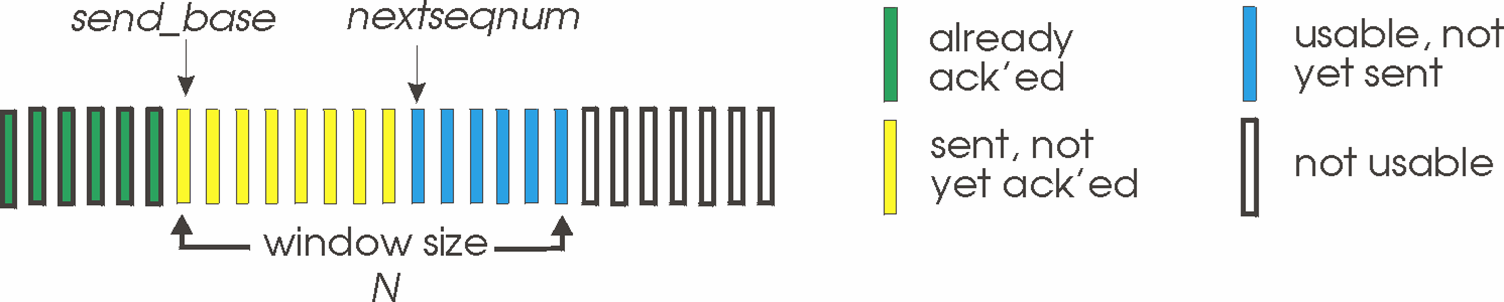
- -bit seq in pkt header
-
cumulative ACK: : ACKs all packets up to, including seq
- on receiving : move window forward to begin at
-
Uses one timer (for oldest in-flight packet)
-
: retransmit packet and all higher seq packets in window
5.3.2 Go-Back-N: receiver
- ACK-only: always send ACK for correctly-received packet so far, with highest in-order seq # (equaling )
- may generate duplicate ACKs
- need only remember
- on receipt of out-of-order packet:
- can discard (don’t buffer) or buffer: an implementation decision
- re-ACK pkt with highest in-order seq
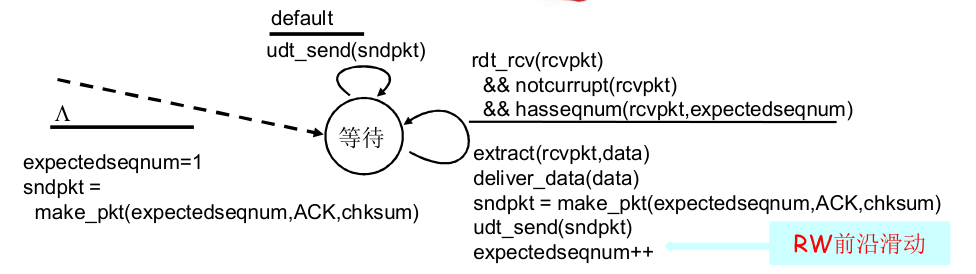
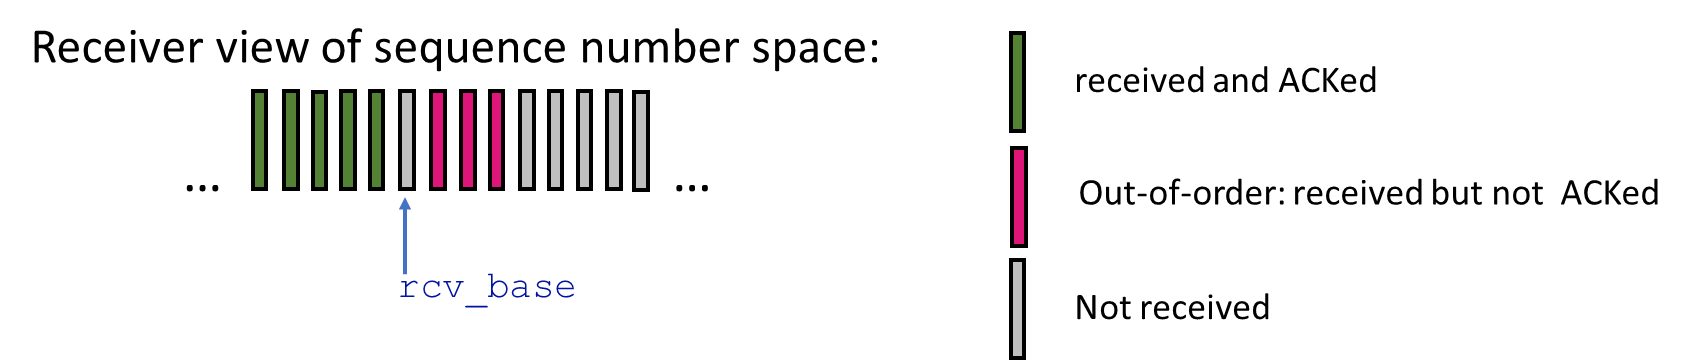
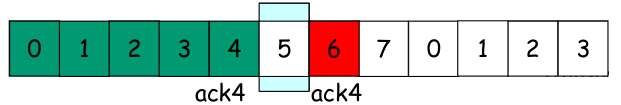
- 只发送ACK:对顺序接收的最高序号的分组
- 可能会产生重复的ACK
- 只需记住expectedseqnum;接收窗口=1
- 只一个变量就可表示接收窗口
- 对乱序的分组:
- 丢弃(不缓存)→ 在接收方不被缓存!
- 对顺序接收的最高序号的分组进行确认-累计确认
5.3.3 Go-Back-N in action
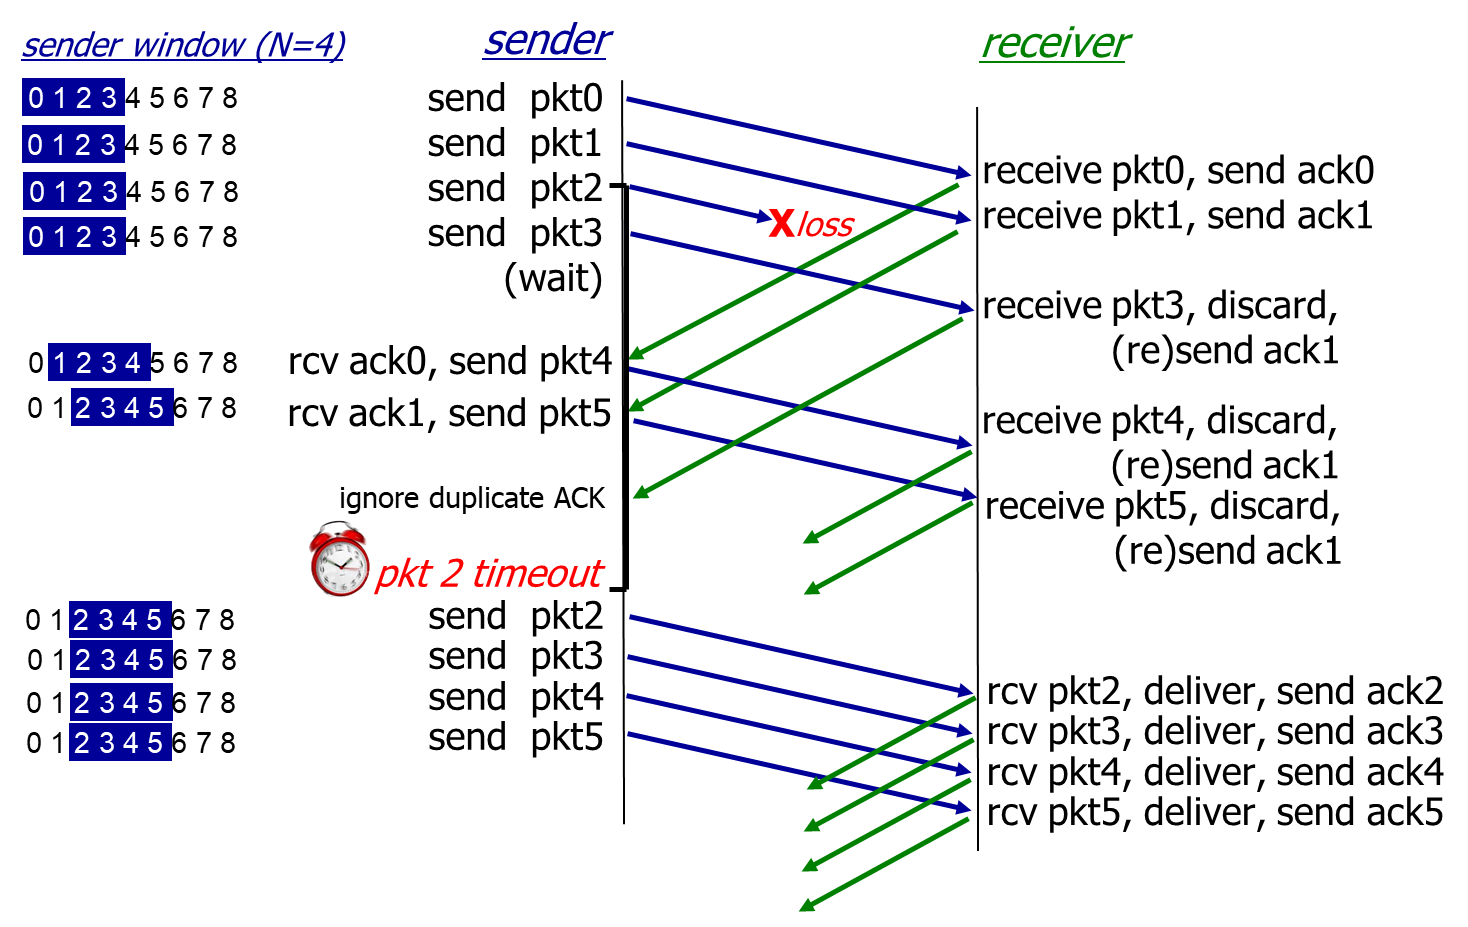
在接收端,乱序的不缓存;因此哪个n分组丢失了GB到那个分组n;即使n以后的分组传送都是正确的
5.4 正常情况的Selective repeat(选择重传)
- receiver individually acknowledges all correctly received packets
- buffers packets, as needed, for eventual in-order delivery to upper layer
- sender times-out/retransmits individually for unACKed packets
- sender maintains timer for each unACKed pkt
- sender window
- consecutive seq
#s - limits seq
#sof sent, unACKed packets
- consecutive seq
- 接收方对每个正确接收的分组,分别发送ACKn(非累积确认)
- 接收窗口
- 可以缓存乱序的分组
- 最终将分组按顺序交付给上层
- 接收窗口
- 发送方只对那些没有收到ACK的分组进行重发-选择性重发
- 发送方为每个未确认的分组设定一个定时器
- 发送窗口的最大值(发送缓冲区)限制发送未确认分组的个数
5.4.1 Selective repeat: sender, receiver windows
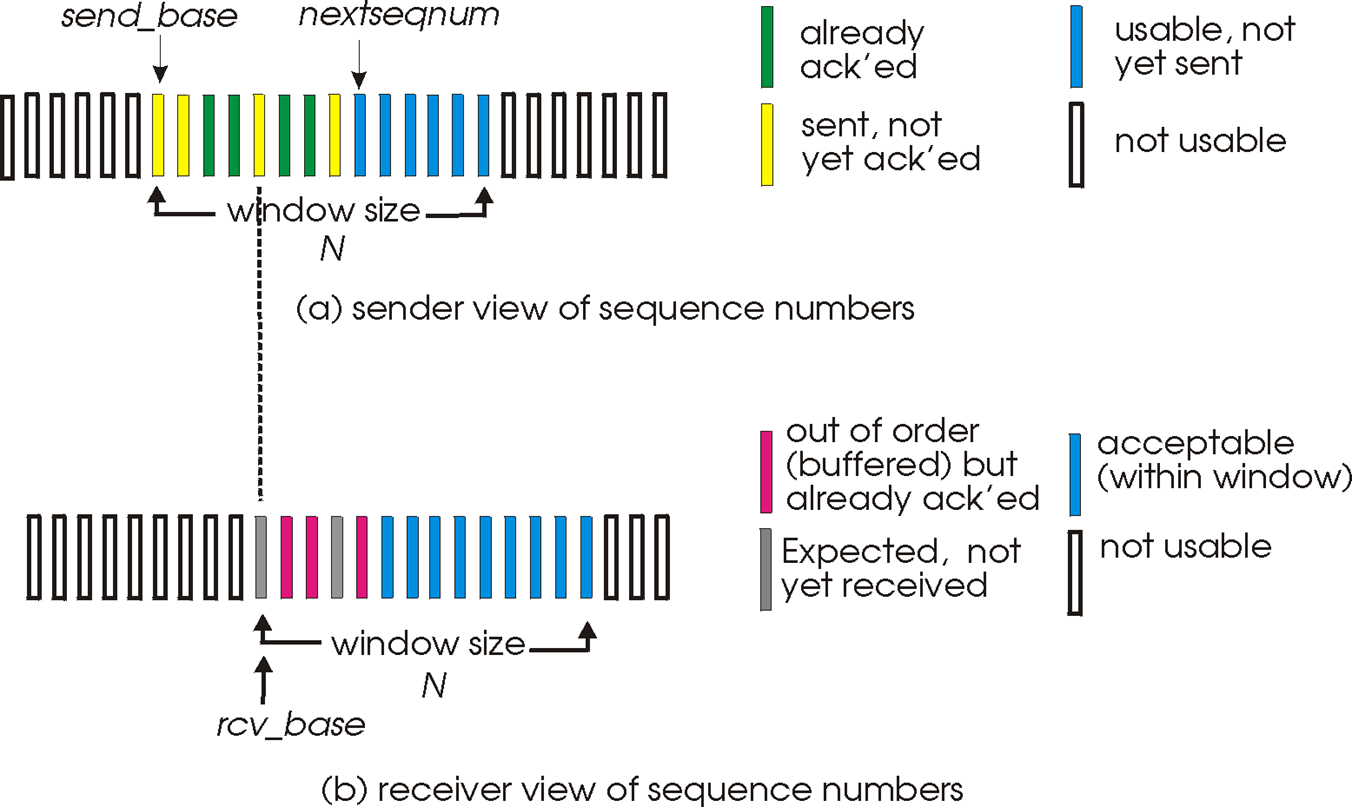
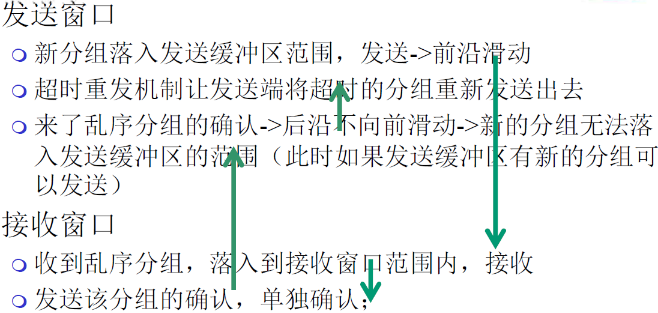
5.4.2 发送方
- 从上层接收数据:
- 如果下一个可用于该分组的序号可在发送窗口中,则发送
- timeout(n):
- 重新发送分组,重新设定定时器
- ACK(n) in :
- 将分组标记为已接收
- 如为最小未确认的分组序号,将移到下一个未确认序号
- data from above:
- if next available seq # in window, send packet
- timeout(n):
- resend packet , restart timer
- ACK(n) in :
- mark packet as received
- if is the smallest unACKed packet, advance window base to next unACKed seq #
5.4.3 接收方
- 分组
- 发送
- 乱序:缓存
- 有序:该分组及以前缓存的序号连续的分组交付给上层,然后将窗口移到下一个仍未被接收的分组
- 分组
- 其它:
- 忽略该分组
- packet in
- send
- out-of-order: buffer
- in-order: deliver (also deliver buffered, in-order packets), advance window to next not-yet-received packet
- packet in
- (this is also necessary!)
- otherwise:
- ignore
5.4.4 Selective Repeat in action
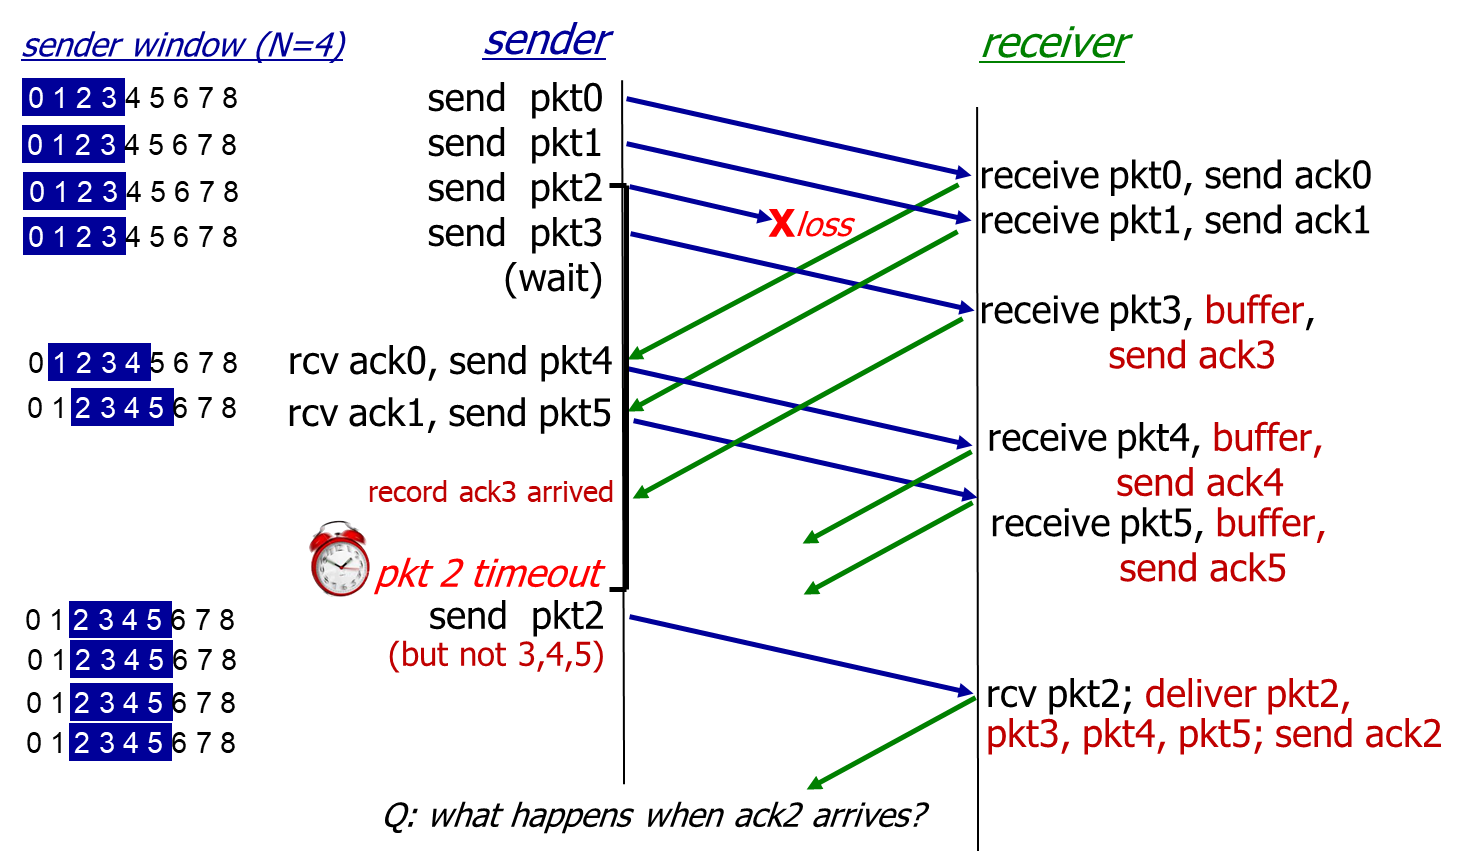
5.5 异常情况下的窗口互动:GBN vs SR
现在我们来看一下当网络出现问题(如丢包)时,两种协议的窗口是如何互动的。
5.5.1 Go-Back-N (GBN) 的异常处理
- 发送方:发送分组,前沿向前滑动。
- 网络问题:中间某个分组(如2号)在传输中丢失。
- 接收方:后续的分组(3号、4号)虽然到达,但因为它们是乱序的(接收窗口仍在等待2号),所以被全部丢弃。
- 接收方确认:每当收到一个乱序分组,接收方都会重新发送对最后一个按序到达分组(1号)的重复确认 (ACK 1)。
- 发送方响应:发送方不断收到重复的 ACK 1,这使得它的发送窗口后沿无法向前滑动。
- 超时:最终,等待2号分组确认的定时器会超时。
- 重传:超时后,GBN协议会将发送窗口内所有已发送但未确认的分组(即2号、3号、4号等)全部重新发送一遍。这就是“回退N步”这个名字的由来。
5.5.2 Selective Repeat (SR) 的异常处理
- 发送方:发送分组,前沿向前滑动。
- 网络问题:中间某个分组(如2号)在传输中丢失。
- 接收方:后续的分组(3号、4号)到达,因为它们落在接收窗口范围内,所以被接收并缓存。
- 接收方确认:接收方为3号和4号分别发送单独的确认 (ACK 3, ACK 4)。
- 发送方响应:发送方收到了ACK 3和ACK 4,知道了这两个分组已经安全到达,因此不会重传它们。但2号分组的确认迟迟未到。
- 超时:最终,只有2号分组对应的定时器会超时。
- 重传:超时后,SR协议只会选择性地重传那个超时的分组(即2号分组),而不会重传已经被确认的3号和4号。
5.5.3 相同点与不同点总结
相同点:
- 它们都是流水线协议,发送窗口大小都大于1。
- 都允许发送方在未收到确认的情况下,连续发送多个分组。
不同点:
- 接收窗口大小:GBN为1,SR大于1。
- 接收方行为:GBN只能顺序接收,丢弃所有乱序分组;SR可以缓存乱序分组。
- 确认机制:GBN使用累积确认(ACK n 表示n及之前所有分组都已收到);SR使用单独确认(ACK n 只表示n号分组已收到)。
- 发送方定时器:GBN通常只为发送窗口中最老的那个未确认分组维护一个定时器;SR为每一个已发送但未确认的分组都维护一个独立的定时器。
- 超时重传策略:GBN超时后会重传窗口内的所有分组(Go-Back-N);SR超时后只重传那个超时的分组(Selective Repeat)。
| 事件 | GBN (回退 N 步) | SR (选择重传) |
|---|---|---|
| 处理方式 | ||
| 丢失 (Lost) | 发送方: 丢失分组的计时器超时。重传所有已发送但未确认的分组(即从丢失的那个开始,回退 N 步)。 接收方: 丢弃所有在丢失分组之后到达的失序分组。 | 发送方: 丢失分组的计时器超时。仅重传那一个丢失的分组。 接收方: 缓存所有在丢失分组之后到达的失序分组。 |
| 损坏 (Corrupt) | 接收方检测到校验和错误,丢弃该分组。这在效果上等同于“丢失”。发送方将超时并重传 N 个分组。 | 接收方检测到校验和错误,丢弃该分组。效果上等同于“丢失”。发送方将超时并仅重传这一个损坏的分组。 |
| 延时 (Delayed) | 分组延时: 如果延时导致发送方超时,发送方会重传 N 个分组。接收方会收到重复分组,但由于它们是“失序”的(接收方已在期待更大的序号),会丢弃它们。 ACK 延时: 如果 ACK 延时导致超时,发送方同样会重传 N 个分组,导致大量不必要的重传。 | 分组延时: 如果延时导致超时,发送方会重传那 1 个分组。接收方最终会收到 2 个相同的分组,它会接受第一个,并再次 ACK 第二个(重复包)。 ACK 延时: 如果 ACK 延时导致超时,发送方仅重传那 1 个分组,网络开销小。 |
| 优缺点 | ||
| 优点 | 接收端逻辑简单。接收方不需要缓存,只需维护一个 expected_seq 变量即可。 | 效率高,吞吐量大。只重传真正丢失或损坏的分组,最大限度地减少了不必要的重传,尤其是在高延迟和高丢包率的网络中。 |
| 缺点 | 效率低,浪费带宽。一个分组的丢失会导致大量后续正确到达的分组被重传。 | 实现复杂。接收端需要缓存机制来暂存失序的分组。发送端需要为每个未确认的分组维护一个单独的计时器。 |
5.5.4 优缺点与适用范围
| Go-Back-N (GBN) | Selective Repeat (SR) | |
|---|---|---|
| 优点 | 协议实现相对简单,接收方不需要复杂的缓存管理。 | 传输效率高,出错时重传的代价小,网络带宽利用更充分。 |
| 缺点 | 一旦发生丢包,会造成大量不必要的重传,浪费网络带宽。 | 协议实现复杂,发送方和接收方都需要更多的缓存和更复杂的逻辑(如多个定时器)。 |
适用范围:
- GBN:适用于网络质量非常好、出错率极低的环境。在这种环境下,出错是罕见事件,没有必要为了处理这种罕见事件而增加协议的日常复杂性。
- SR:适用于链路容量大(高带宽、高延迟)、出错率相对较高的环境。在这种网络中,一次出错回退N步的代价太大,使用选择性重传可以显著提高效率。
5.6 关于窗口大小的进一步讨论
这是一个重要的问题,也是一个常见的作业题:如果我们用 个比特来表示分组序号,那么发送窗口的最大尺寸应该是多少?
- 对于 GBN 协议,发送窗口的最大值是 。
- 对于 SR 协议,发送窗口的最大值是 。
为什么SR协议的窗口大小要被限制在序号空间的一半?如果超过这个值,可能会导致新、旧窗口之间的序号重叠,使得接收方无法区分一个分组到底是第一次传输的新分组,还是重传的旧分组,从而引发严重的协议错误。
5.6.1 Selective repeat: a dilemma!
Selective repeat:a dilemma with too-large windows!
example:
- seq
#s: (base 4 counting) - window size
Q: what relationship is needed between sequence # size and window size to avoid problem in scenario (b)?
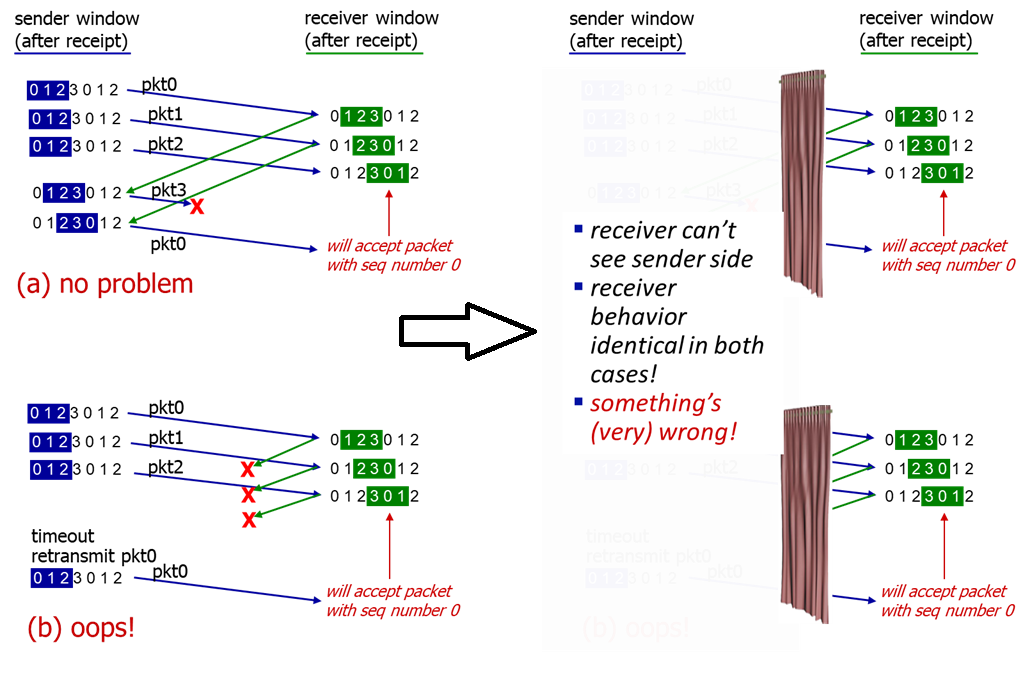
5.6.2 1. 选择性重传 (Selective Repeat, SR)
- 规则 窗口大小 ≤ 序号空间的一半 ()
- 问题核心 接收方分不清收到的分组是【新窗口的新分组】还是【旧窗口的重传分组】。
- 一句话解释 因为SR的接收方比较“聪明”,可以缓存乱序分组,这可能导致它的接收窗口(新窗口)与发送方因超时而重传的窗口(旧窗口)的序号范围产生重叠。
- 解决方案 将窗口大小严格限制在序号空间的一半,就能保证“新窗口”和“旧窗口”的序号永远没有交集。这样接收方仅凭收到的分组序号,就能准确判断它属于哪个窗口,消除歧义。
5.6.3 2. 回退N步 (Go-Back-N, GBN)
- 规则 窗口大小 ≤ 序号空间 - 1 ()
- 问题核心
在“所有ACK都丢失”的极端情况下,接收方分不清【下一轮的新
pkt0】和【上一轮重传的旧pkt0】。 - 一句话解释
因为GBN的接收方很“笨”(一根筋),只会严格按顺序接收。只有当发送方发出的分组占满了整个序号空间时,接收方的期望序号才会“绕一圈”回到0,此时才可能与重传的旧
pkt0混淆。 - 解决方案
让窗口大小比序号空间至少小1。这样,接收方收完一个完整的窗口后,它期待的下一个序号就永远不会是0。当旧的
pkt0重传过来时,接收方发现序号对不上,就会直接丢弃,歧义消除。
| 协议 | 窗口大小限制 | 防止的歧义 | 核心原因 |
|---|---|---|---|
| SR | ≤ 序号空间 / 2 | 新旧窗口重叠 | 接收方“太聪明”,会缓存乱序分组 |
| GBN | ≤ 序号空间 - 1 | 发满一圈后重叠 | 接收方“太笨”,只会顺序接收 |
5.7 附加的一个链接【可视化】
https://www.tkn.tu-berlin.de/teaching/rn/animations/gbn_sr/
6 面向连接的传输:TCP
6.1 TCP 协议的特性
- point-to-point:
- one sender, one receiver
- reliable, in-order byte steam:
- no “message boundaries”
- full duplex data: (全双工)
- bi-directional data flow in same connection
- MSS (maximum segment size):
- typical MSS = 1460 bytes
- cumulative ACKs
- pipelining:
- TCP congestion and flow control set window size
- connection-oriented:
- handshaking (exchange of control messages) initializes sender, receiver state before data exchange
- flow controlled:
- sender will not overwhelm receiver
| 序号 | 特点 | 说明 |
|---|---|---|
| 1 | 点对点 | 一个发送方,一个接收方(不支持一对多) |
| 2 | 可靠的、按顺序的字节流 | 可靠:不出错,不丢失,不乱序; 没有报文边界:A→B,A提供两个报文,则B可能收到1个大的报文,或者4个小的报文;报文接线要靠应用进程自己维护 |
| 3 | 管道化(流水线) | TCP拥塞控制和流量控制设置窗口大小 |
| 4 | 发送和接收缓存 | 发送缓存:为了重复发送 接受缓存:为了跳转发送和接受的速度差 |
| 5 | 全双工数据 | 在同一连接中数据流双向 流动 MSS:最大报文段大小 MSS的大小 + TCP头部 + IP头部 = 一个报文段(TCP实体会将应用层传来的数据打成若干MSS大小,然后加上TCP头部) |
| 6 | 面向连接 | 在数据交换之前,通过握 手(交换控制报文) 初始 化发送方、接收方的状态 变量 |
| 7 | 有流量控制 | 发送方不会淹没接收方 |
- 点对点:
- 一个发送方,一个接收方
- 可靠的、按顺序的字节流:
- 没有报文边界
- 管道化(流水线):
- TCP拥塞控制和流量控制设置窗口大小
- 发送和接收缓存
- 全双工数据:
- 在同一连接中数据流双向流动
- MSS:最大报文段大小
- 面向连接:
- 在数据交换之前,通过握手(交换控制报文)初始化发送方、接收方的状态变量
- 有流量控制:
- 发送方不会淹没接收方
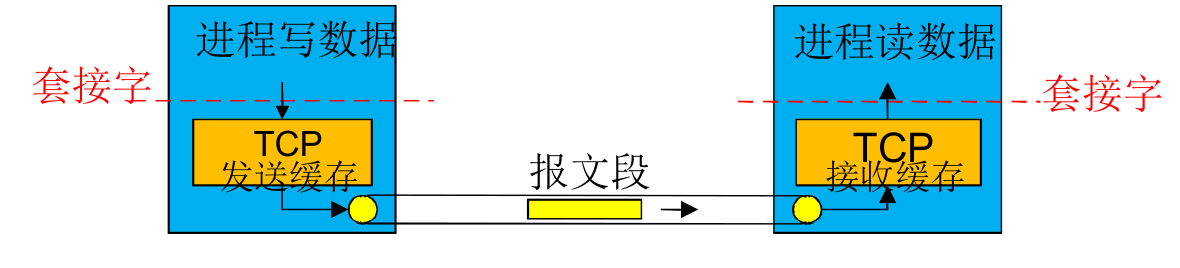
TCP的通信双方都拥有缓存区:
- 发送缓存:用于临时存储已发送但尚未收到确认的数据,以便在发生超时的情况下进行重传。
- 接收缓存:用于匹配发送方的数据传输速率和接收方应用进程的数据读取速率。如果发送速率快于读取速率,数据可以先暂存在接收缓存中。
6.2 报文段 TCP segment structure
6.2.1 最大报文段大小 (MSS)
应用层传递下来的数据报文可能非常长,TCP会将其视为一个连续的字节流,并按照最大报文段大小(Maximum Segment Size, MSS) 进行切分。
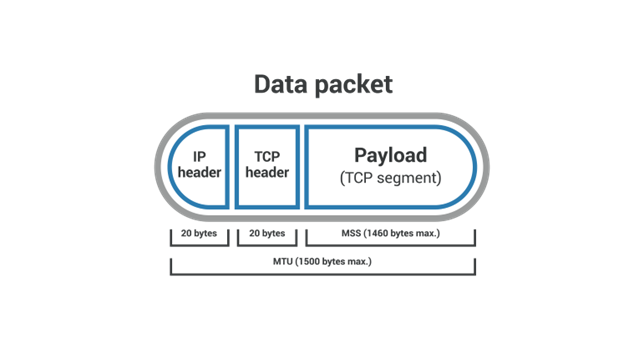
MSS的确定与底层网络的最大传输单元(Maximum Transmission Unit, MTU) 密切相关。以太网的MTU为1500字节,这意味着一个以太网帧的数据部分(载荷)最大为1500字节。
为了避免在网络层发生IP分片,MSS的计算通常如下:
MSS = MTU - IP头部大小 - TCP头部大小
例如,在一个典型的网络环境中(IPv4),IP头部为20字节,TCP头部也为20字节。那么:
MSS = 1500 - 20 - 20 = 1460 字节
 这样,一个大小为MSS的数据块,加上TCP头部和IP头部后,其总长度正好可以被封装在一个以太网帧的载荷部分,从而提高了传输效率。
6.2.2 TCP Segment结构
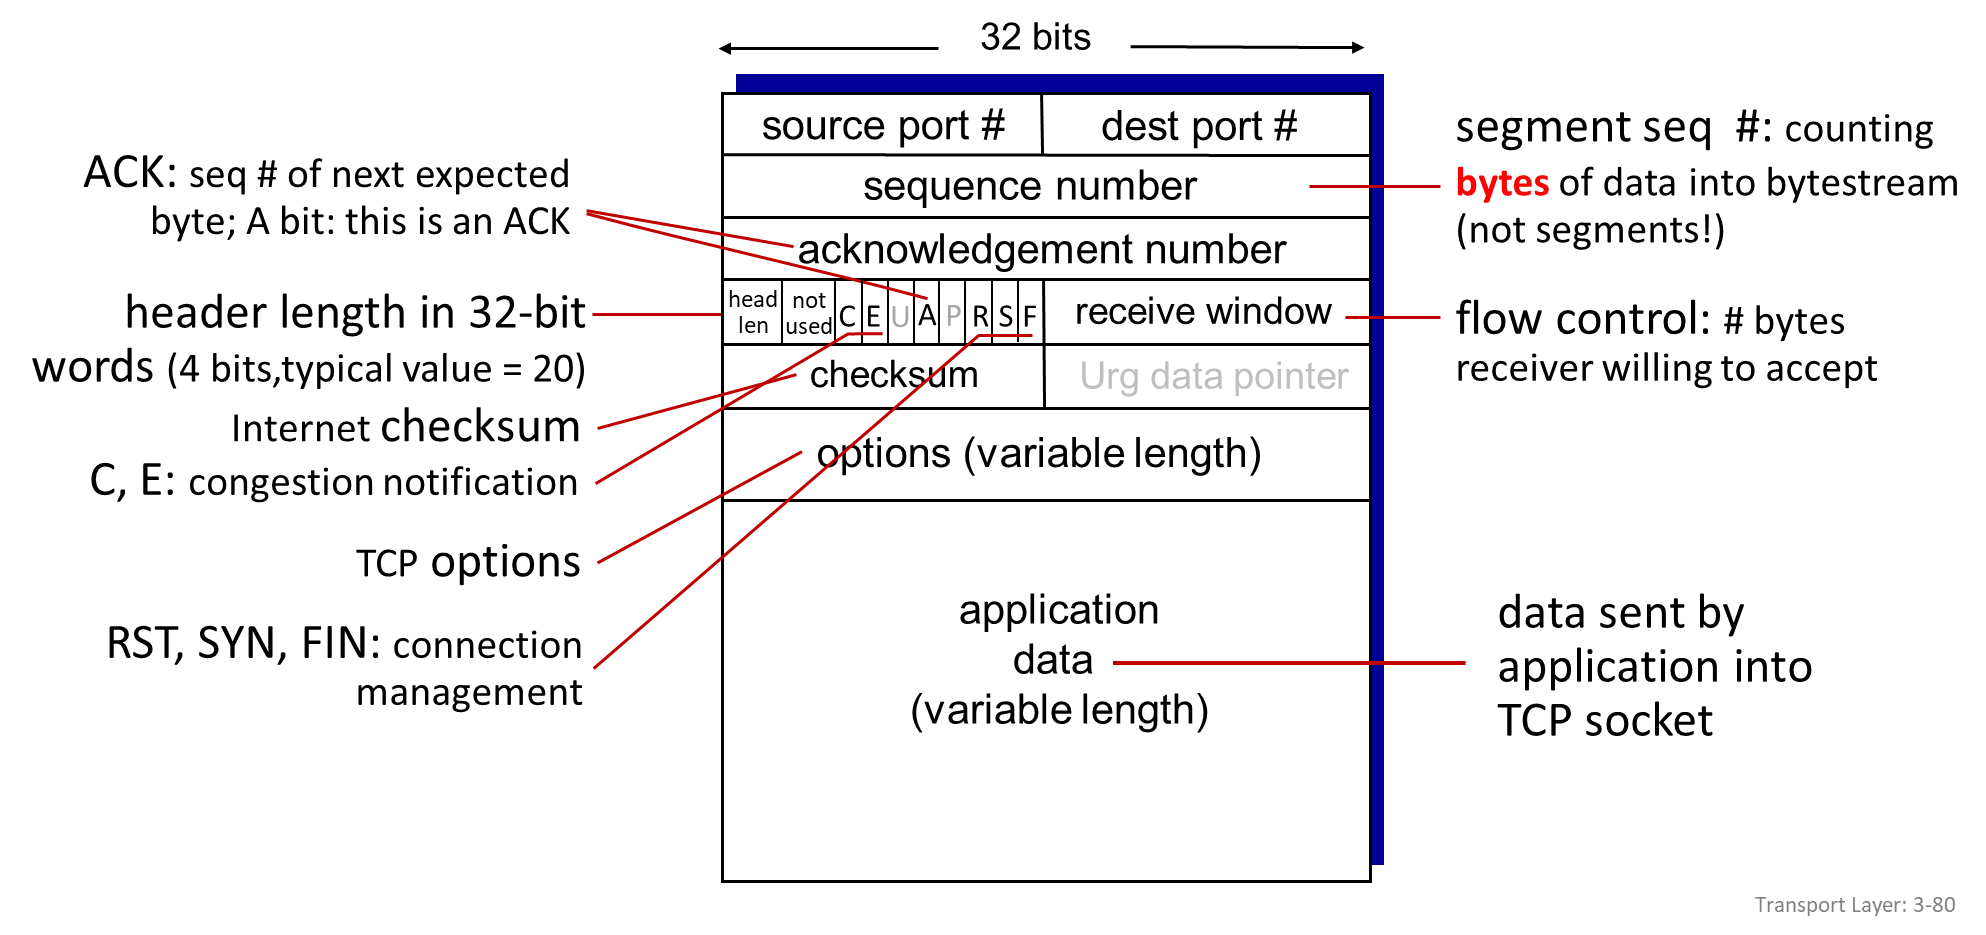
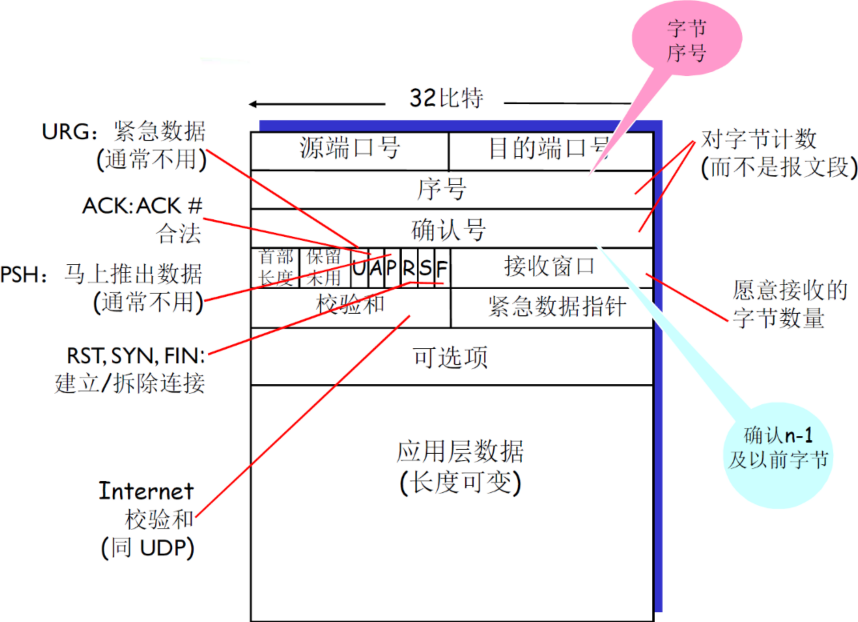
- The 32-bit sequence number field and the 32-bit acknowledgment number field are used by the TCP sender and receiver in implementing a reliable data transfer service, as discussed below.
- The 16-bit receive window field is used for flow control. We will see shortly that it is used to indicate the number of bytes that a receiver is willing to accept.
- The 4-bit header length field specifies the length of the TCP header in 32-bit words. The TCP header can be of variable length due to the TCP options field. Typically, the options field is empty, so that the length of the typical TCP header is 20 bytes.
- The optional and variable-length options field is used when a sender and receiver negotiate the maximum segment size (MSS) or as a window scaling factor for use in high-speed networks. A time-stamping option is also defined. See RFC 854 and RFC 1323 for additional details.
- The flag field contains 6 bits. The ACK bit is used to indicate that the value carried in the acknowledgment field is valid; that is, the segment contains an acknowledgment for a segment that has been successfully received. The RST, SYN, and FIN bits are used for connection setup and teardown, as we will discuss at the end of this section. The CWR and ECE bits are used in explicit congestion notification, as discussed in Section 3.7.2. Setting the PSH bit indicates that the receiver should pass the data to the upper layer immediately. Finally, the URG bit is used to indicate that there is data in this segment that the sending-side upper-layer entity has marked as “urgent.” The location of the last byte of this urgent data is indicated by the 16-bit urgent data pointer field. TCP must inform the receiving-side upper-layer entity when urgent data exists and pass it a pointer to the end of the urgent data. (In practice, the PSH, URG, and the urgent data pointer are not used. However, we mention these fields for completeness.)
| 项目 | 说明 | 补充 |
|---|---|---|
| 序号 | 报文段首字节的在整个字节流的偏移量(offset),如是X,X+MSS,X+2*MSS等 | 两个应用进程的初始序号X不一定是从0开始,为了防止老的连接上的,滞留在网络中的分组,对新的连接的分组造成影响 是字节流的偏移量,不是一个文件的偏移量,应用层给TCP的都是字节流 初始序号X是自己定 ,并没有实际意义 |
| 确认号 | 期望从另一方收到的下一个字节的序号 累积确认 | 比如receiver发送ACK=5,表明receiver已经接受到了4及以前的报文段,希望接受到5 |
| 首部长度 | 以4个字节为单位 | 根据首部长度来判断 载荷(实际数据)从哪里开始,因为后面的可选项是不确定的 |
| 保留未用 | 未来可能使用的位,但是现在还没有用到 |
TCP传输的数据单元被称为报文段(Segment)。它由TCP头部和数据载荷两部分组成。
6.2.2.1 序号 (Sequence Number)
序号是TCP实现可靠传输的关键。它不是按报文段计数(如第1个、第2个报文段),而是以字节为单位进行编号。
- 定义:序号字段的值,是该TCP报文段数据载荷的第一个字节在整个字节流中的偏移量(Offset)。
- 例如,如果一个字节流被切分成多个1460字节的段,且初始序号为0,那么第一个段的序号是0,第二个段的序号是1460,第三个是2920,以此类推。
初始序号 (ISN):在建立连接时,通信双方会各自协商一个初始序号。这个序号通常不是从0或1开始的固定值,而是一个随机生成的值。这样做是为了防止网络中延迟的、来自旧连接的报文段对新的、使用相同端口号的连接产生干扰。
6.2.2.2 确认号 (Acknowledgment Number)
确认号同样以字节为单位,用于告知对方已经成功接收到哪些数据。
定义:确认号的含义是“我期望从你那里收到的下一个字节的序号”。
如果接收方发送的确认号为Y,这代表:
- 它已经成功接收了所有序号在
Y-1以及之前的所有字节。 - 它现在正在等待序号为
Y的字节。
这个定义与我们之前讨论的一些简单协议略有不同,需要特别注意。同时,TCP的确认是累积确认,一个确认号Y意味着Y之前的所有数据都已收到,这点与Go-Back-N协议类似。
Recall that TCP is full-duplex, so that Host A may be receiving data from Host B while it sends data to Host B (as part of the same TCP connection).Each of the segments that arrive from Host B has a sequence number for the data flowing from B to A. The acknowledgment number that Host A puts in its segment is the sequence number of the next byte Host A is expecting from Host B
就是说因为TCP是双全工的,所以A向B发送的同时,也会填入ACK
6.2.2.3 其他重要头部字段
- 首部长度:以4字节为单位,指明了TCP头部的长度。因为头部中包含可变长度的“选项”字段,所以需要这个字段来确定数据载荷的起始位置。
- 标志位 (Flags):如
SYN,ACK,FIN等,用于控制连接的建立、数据传输和连接的释放。 - 接收窗口:用于流量控制。接收方通过这个字段告知发送方,自己还有多少可用的缓存空间。
- 检验和 (Checksum):用于校验TCP头部和数据在传输过程中是否出错。
- 紧急指针:一个较老的字段,现在基本上已经不再使用。
6.2.2.4 对乱序报文段的处理
TCP协议标准没有规定接收方必须如何处理乱序到达的报文段。具体的实现者可以自行决定是缓存这些乱序的段,还是直接将其丢弃。
6.2.3 TCP sequence numbers, ACKs
没有规定接收方如何处理乱序的报文段:可以缓存,也可以抛弃掉
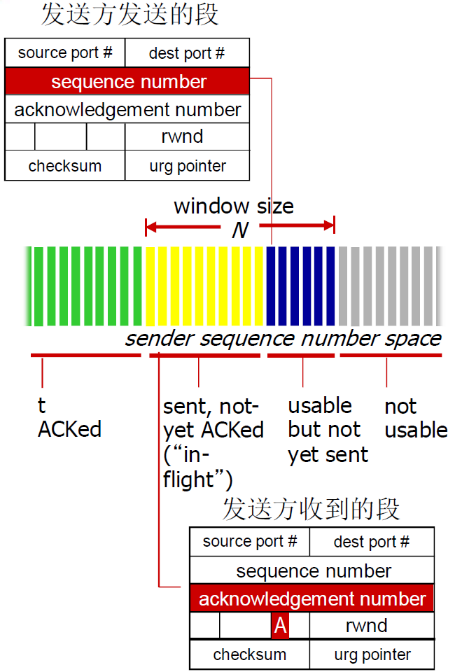
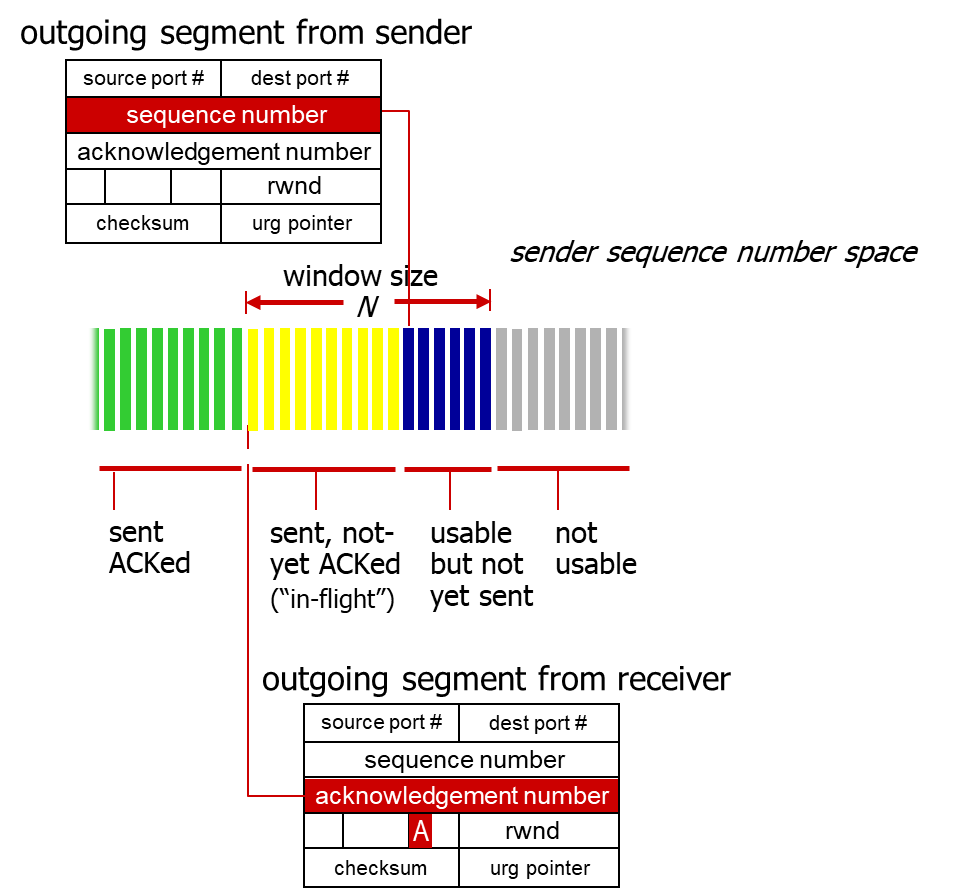
- Sequence numbers:
- byte stream “number” of first byte in segment’s data
- Acknowledgements:
- seq # of next byte expected from other side
- cumulative ACK
- Q: how receiver handles out-of-order segments
- A: TCP spec doesn’t say, - up to implementor
6.2.4 TCP 序号和确认号实例
我们通过一个telnet应用的“回显”场景来理解序号和确认号的交互过程。在回显中,客户端(Host A)输入的每个字符都会被服务器(Host B)发送回来。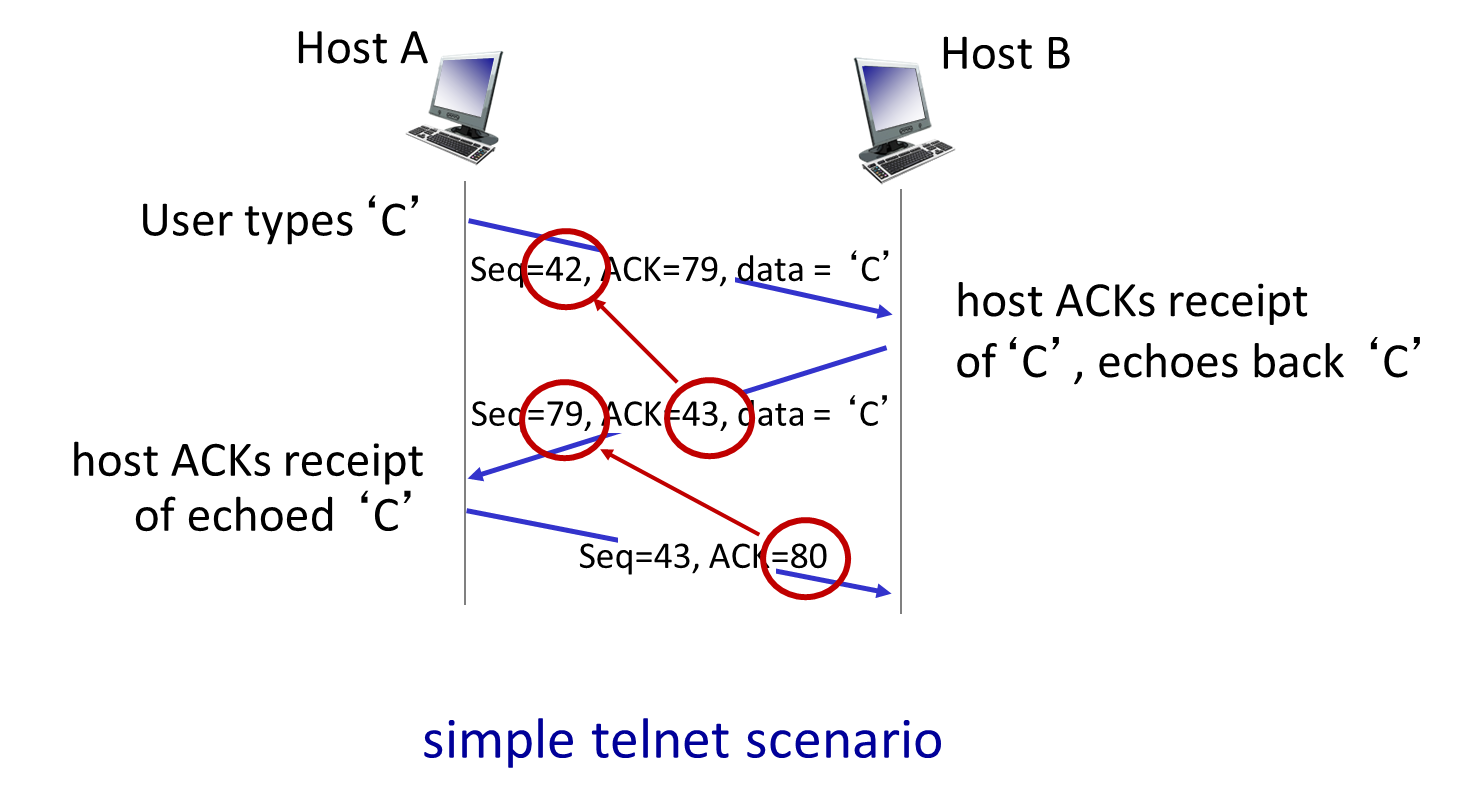
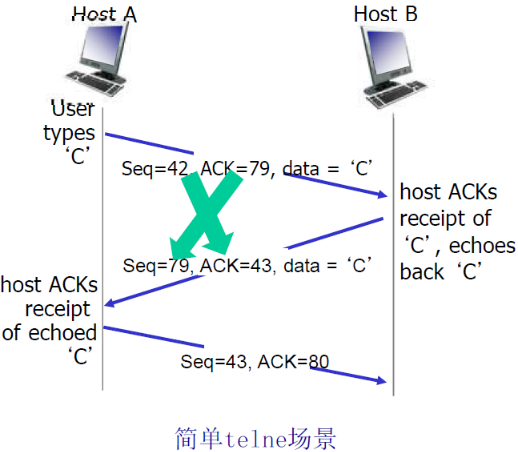
假设连接建立时,A协商的初始序号是42,B协商的初始序号是79。
-
A → B: 用户在A上输入字符 ‘C’。
- Seq=42: 因为这是A发送的第一个字节,序号为初始序号。
- ACK=79: A告诉B,它期望接收从序号79开始的字节。
- Data=‘C’: 报文段的数据是一个字节。
-
B → A: B收到 ‘C’ 后,将其回显给A,并对收到的数据进行确认。
- Seq=79: B发送的数据从它的初始序号79开始。
- ACK=43: B已经收到了A发送的序号为42的字节,因此它期望下一个字节是43。
- Data=‘C’: 回显的字符。
通过这个例子,我们可以清晰地看到双方如何使用Seq来标识自己发送的数据,并使用ACK来确认收到的数据和表明自己的期望。
主要还是记住ACK的含义:
- ACK=100
- 表明接受到99及以前的字节
- 请求100开始的字节,就是告诉Sender感觉发送100开始的段
- TCP以前的例子说明ACK=100,表明100已经接受了,但是在TCP协议中有区别,是请求100
6.3 TCP 可靠数据传输 (TCP’s reliability implementations)
6.3.1 TCP:Go-Back-N 与 Selective Repeat 的混合体
我们已经知道,TCP是一种管道化(Pipelining)协议,允许发送方在未收到确认的情况下连续发送多个报文段。管道化协议主要分为 Go-Back-N (GBN) 和 Selective Repeat (SR) 两类。那么,TCP究竟属于哪一种呢?
实际上,TCP是这两种协议的混合体。它在IP提供的不可靠服务基础上,通过结合两者的特点,构建了自己强大的可靠数据传输(RDT)机制。
TCP在IP不可靠服务的基础上 建立了rdt
- 类似 Go-Back-N 的方面:
- 累积确认 (Cumulative Acknowledgment):接收方发送的确认号代表了它期望收到的下一个字节的序号。一个
ACK=555的确认,意味着554及之前的所有字节都已按序收到。 - 单个重传定时器 (Single Retransmission Timer):尽管网络中可能同时存在多个“在飞的”(in-flight)未确认报文段,但发送方只使用一个定时器。这个定时器与已发送但最早未被确认的那个报文段相关联。
- 累积确认 (Cumulative Acknowledgment):接收方发送的确认号代表了它期望收到的下一个字节的序号。一个
- 类似 Selective Repeat 的方面:
- 超时处理:当定时器超时时,发送方仅仅重传最早的那个未确认报文段,而不是像GBN那样重传所有已发送但未确认的报文段。
此外,TCP协议规范并没有规定接收方如何处理乱序到达的报文段,实现者可以自行选择缓存这些段或直接丢弃。
6.3.1.1 重传的触发事件(发生重复的确认的情况)
TCP发送方的重传行为主要由以下两种事件触发:
- 超时 (Timeout):这是最基本的重传机制。如果发送方在规定的超时时间内没有收到对某个报文段的确认,它会假定该报文段已丢失,并进行重传。
- 收到冗余的重复确认 (Duplicate ACKs):如果发送方连续收到了三个对于同一个序号的冗余确认(即总共4个相同的ACK),它会不等定时器超时,就立刻重传对应的报文段。
这种由冗余ACK触发的、在定时器超时之前发生的重传,被称为快速重传 (Fast Retransmit)。由于超时时间设置得通常比较保守(均值+4倍标准差),快速重传机制能更早地发现并恢复丢包,显著提高了传输效率。
6.3.2 TCP 往返延时 (RTT) 和超时
TCP通过超时重传来保证可靠性。超时定时器的设置至关重要。
- 设置太短:会导致过早超时,即使报文段和它的确认仍在网络中正常传输,发送方也会进行不必要的重传,降低链路利用率。
- 设置太长:如果一个报文段真的丢失了,发送方需要等待很长时间才能发现并重传,导致对丢包的反应过慢,同样影响性能。
Q: how to set TCP timeout value?
- longer than RTT, but RTT varies!
- too short: premature timeout, unnecessary retransmissions
- too long: slow reaction to segment loss
TCP的通信环境非常复杂。两个主机可能在同一个局域网内,也可能分处大洋两岸,中间经过无数路由器。
-
局域网中的两个计算机的延迟很小,而且稳定,可以设置成固定值
-
对于两个主机所处的位置非常远的情况
- 长期来看:RTT的分布非常分散,变化范围很大。因此,设置一个固定的超时时间是不现实的。【这是针对于中间会有很多跳的】
- 短期来看:RTT的分布又相对集中和稳定。【但是如果是局域网的话也会其实也比较稳定】
这表明,TCP的超时时间设置必须是动态的、自适应的,能够根据近期网络的状况进行调整。
- 超时时间的设置是 动态的、自适应的
- 要定期的测量RTT,测量器平均值和方差
- 超时时间 = 平均值 + 4*方差
6.3.3 RTT的估计与超时时间的计算
TCP采用一种自适应的方法来动态计算超时时间。
Q: how to estimate RTT?
6.3.3.1 1. 测量样本RTT (SampleRTT)
发送方在发送一个报文段时启动计时器,当收到该报文段的确认时停止计时器,两者之间的时间差就是一个往返时间的测量样本 (SampleRTT)。
- 注意:为了测量的准确性,TCP一次只对一个已发送但未确认的报文段进行计时。
- 忽略重传:如果一个报文段发生了重传,那么对它的RTT测量将被忽略,因为无法判断收到的确认是针对第一次发送还是重传。
- SampleRTT: measured time from segment transmission until ACK receipt
- ignore retransmissions
- SampleRTT will vary, want estimated RTT “smoother”
- average several recent measurements, not just current SampleRTT
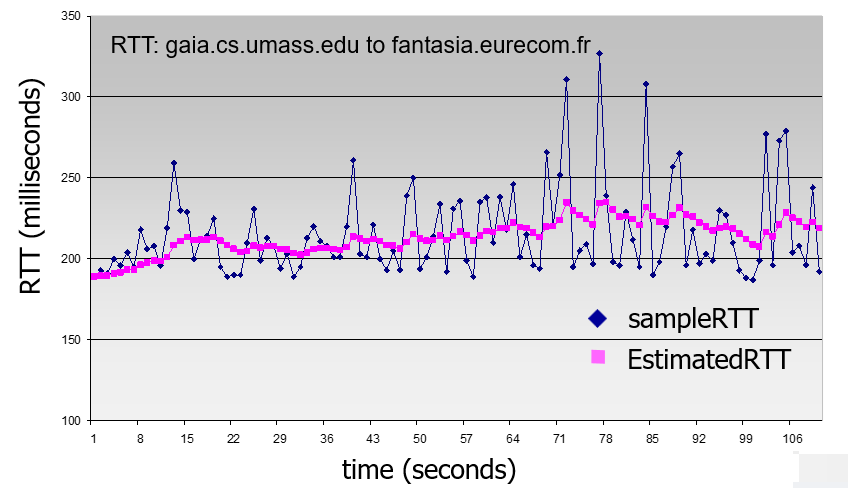
6.3.3.2 2. 平滑RTT估计值 (EstimatedRTT)
SampleRTT会有较大的波动,不能直接用来设置超时。TCP使用指数加权移动平均 (EWMA) 算法来计算一个更平滑的RTT估计值。
- 这个公式给最近的
SampleRTT赋予了权重α,而历史EstimatedRTT的权重是(1-α)。 - 随着时间的推移,过去测量值的影响会呈指数级衰减,这使得
EstimatedRTT能很好地反映近期的网络延迟状况。 - 推荐值:
α = 0.125。
6.3.3.3 3. 计算RTT偏差 (DevRTT)
仅有平均值还不够,我们还需要考虑RTT的波动程度。波动越大,超时时间的“安全边界”就应该越大。DevRTT用于估算SampleRTT与EstimatedRTT之间的偏差。
- 这也是一个EWMA,它计算的是偏差的移动平均值,可以看作是对标准差的估计。
- 推荐值:
β = 0.25。
6.3.3.4 4. 设置最终的超时时间 (TimeoutInterval)
最终的超时时间由估计的RTT平均值和一个安全边界构成。
EstimatedRTT是对网络延迟的基准估计。4 * DevRTT是一个动态调整的安全边界(Safty Margin)。当网络延迟波动较大时(DevRTT增大),这个边界也会随之增大,从而使超时设置更加鲁棒。
6.3.3.5 为什么不使用重传报文的 RTT:
这是因为 “确认的歧义性” (ACK Ambiguity),Karn 算法阐明了这一点。
假设:
- 发送方在 时刻发送了报文 P。
- P 丢失了(或被严重延迟)。
- 发送方在 时刻超时,重传了报文 P。
- 发送方在 时刻收到了对 P 的 ACK。
歧义点: 这个在 收到的 ACK 是对应于 的原始传输(只是它被严重延迟了),还是对应于 的重传?
- 如果 ACK 对应原始传输,那么真实的 RTT 样本是 (一个很大的值)。
- 如果 ACK 对应重传,那么 RTT 样本是 (一个较小的值)。
发送方无法区分这两种情况。如果错误地使用了 来更新 RTT 估计(而 ACK 实际上对应 ),会导致 SRTT 被错误地拉低,使得未来的 RTO 值过短,引发不必要的重传。
因此,Karn 算法规定:不应使用重传报文的 RTT 样本来更新 SRTT 和 RTTVAR。
6.3.4 简化的TCP发送方模型
为了更好地理解TCP的工作原理,我们首先忽略流量控制、拥塞控制、重复确认的细节,来分析一个简化的TCP发送方模型。其核心是围绕三个关键事件进行处理。
6.3.4.1 初始化
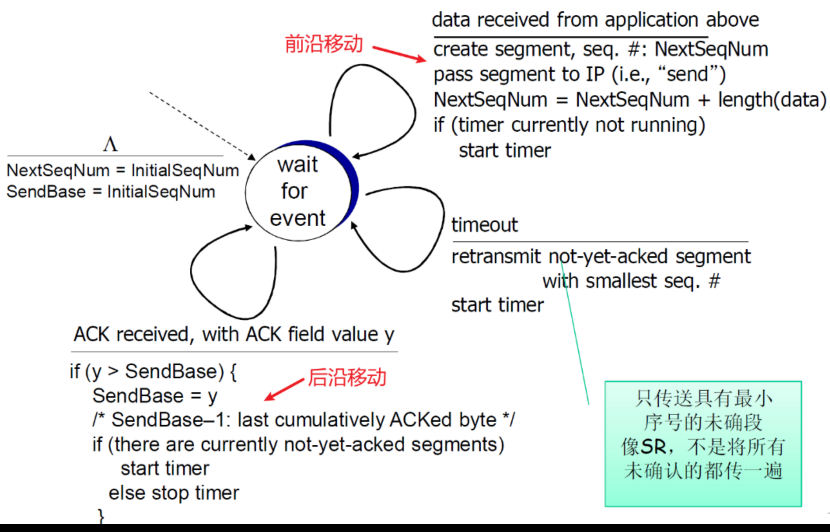
发送方维护两个重要的变量:SendBase 和 NextSeqNum。
- SendBase: 最早的、已发送但未被确认的字节的序号。可以看作是发送窗口的后沿。
- NextSeqNum: 下一个将要发送的字节的序号。可以看作是发送窗口的前沿。
在连接建立时,这两个变量都被初始化为双方协商好的初始序号 (Initial Sequence Number, ISN)。
6.3.4.2 事件1:从应用层接收到数据
event: data received from application
- create segment with seq #
- seq # is byte-stream number of first data byte in segment
- start timer if not already running
- think of timer as for oldest unACKed segment
- expiration interval: TimeOutInterval
当应用层有数据需要发送时,发送方执行以下操作:
- 以
NextSeqNum作为序号,创建一个新的TCP报文段。 - 将报文段交给IP层进行发送。
- 更新
NextSeqNum的值:NextSeqNum = NextSeqNum + length(data)。这个动作相当于将发送窗口的前沿向前滑动。 - 如果当前没有正在运行的定时器,则启动一个。这个定时器总是与
SendBase所指向的最老的未确认报文段相关联。
6.3.4.3 事件2:定时器超时
event: timeout
- retransmit segment that caused timeout
- restart timer
如果定时器超时事件发生,说明最老的未确认报文段可能已经丢失。
- 发送方会重传
SendBase指向的那个报文段以及其后面的报文段。 - 然后,重新启动定时器。
6.3.4.4 事件3:收到ACK确认
event: ACK received
- if ACK acknowledges previously unACKed segments
- update what is known to be ACKed
- start timer if there are still unACKed segments
当收到一个确认号为 y 的ACK时:
- 检查
y > SendBase: 如果y大于当前的SendBase,说明有新的数据被确认了。 - 更新
SendBase: 将SendBase的值更新为y。这个动作相当于将发送窗口的后沿向前滑动,因为y-1及之前的数据都已被确认,无需再保留在发送缓存中。 - 处理定时器:
- 如果此时还有已发送但未确认的报文段(即
SendBase < NextSeqNum),则重新启动定时器。 - 如果所有已发送的报文段都已被确认(即
SendBase == NextSeqNum),则关闭定时器。
- 如果此时还有已发送但未确认的报文段(即
6.3.5 TCP Receiver: ACK generation [RFC 5681]
RFC文档对接收方何时以及如何生成ACK给出了一些建议,旨在提高网络效率。
- 延迟ACK (Delayed ACK):当一个按序到达的报文段抵达时,接收方不立即发送ACK,而是等待一小段时间(如500ms)。如果在这段时间内有第二个按序报文段到达,接收方就可以只发送一个累积ACK来同时确认这两个报文段,从而减少网络中ACK报文的数量。
- 立即发送ACK(针对乱序): 当接收到一个乱序的报文段时(即收到的序号大于期望的序号),这通常意味着中间有报文段丢失了。此时,接收方应该立即发送一个重复的ACK,其确认号仍然是那个它正在等待的、丢失了的报文段的序号。这个行为是触发快速重传的关键。
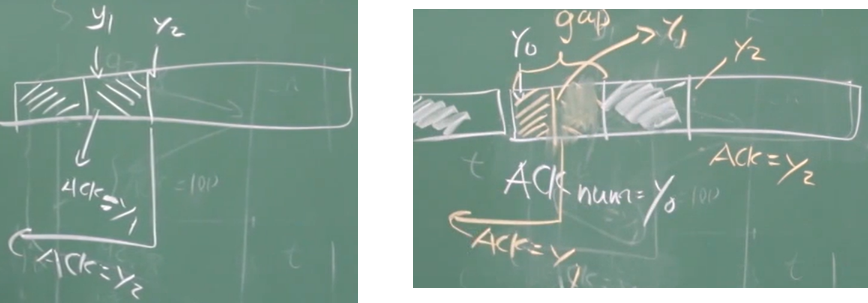
- 立即发送ACK(填补间隔): 当一个报文段到达,并能部分或全部填补之前因丢包造成的序号“间隔”(Gap)时,接收方也应立即发送ACK,以尽快将最新的接收状态通知给发送方。
| Event at receiver | TCP receiver action |
|---|---|
| arrival of in-order segment with expected seq #. All data up to expected seq # already ACKed | delayed ACK. Wait up to 500ms for next segment. If no next segment, send ACK |
| arrival of in-order segment with expected seq #. One other segment has ACK pending | immediately send single cumulative ACK, ACKing both in-order segments |
| arrival of out-of-order segment higher-than-expect seq. #. Gap detected | immediately send duplicate ACK, indicating seq. # of next expected byte |
| arrival of segment that partially or completely fills gap | immediate send ACK, provided that segment starts at lower end of gap |
| 接收方的事件 | TCP接收方动作 | 补充 |
|---|---|---|
| 所期望序号的报文段按序到达。所有在期望序号之前的数据都已经被确认 | 延迟发送ACK(提高效率,少发一个ACK)。对另一个按序报文段的到达最多等待500ms。如果下一个报文段在这个时间间隔内没有到达,则发送一个ACK。 | 就是当接受到y₀之后,不发送ACK=y₀+1,而是当顺序接受到y₁之后,发送ACK=y₁+1。注意必须是顺序接受到,如果是乱序,仍然请求y₀+1。如果超时还未接受到,再发y₀+1 |
| 有期望序号的报文段到达。另一个按序报文段等待发送ACK | 立即发送单个累积ACK,以确认两个按序报文段。 | 就是上一条说的情况 |
| 比期望序号大的报文段乱序到达。检测出数据流中的间隔 | 立即发送重复的ACK,指明下一个期待字节的序号 | 如果收到了y₀,然后乱序收到了y₂,那么重新请求ACK=y₀+1 |
| 能部分或完全填充接收数据间隔的报文段到达 | 若该报文段起始于间隔(gap)的低端,则立即发送ACK(给确认。反映下一段的需求)。 | 请求ACK=y₀+1,此时已经乱序收到了y₂的内容。请求之后得到的gap并不能填充y₀到y₂的空间,只能达到y₁,因此重新请求ACK=y₁+1 |
// 初始化
NextSeqNum = InitialSeqNum
SendBase = InitialSeqNum

// 一直循环
loop (forever) {
    // 判断事件
    switch(event)

    // 如果收到了应用层的数据
    event: data received from application above
        // 用NextSeqNum创建TCPsegment
        create TCP segment with sequence number NextSeqNum
        // 如果定时器不在运行的话,开始
        if (timer currently not running)
            start timer
        // 传给IP
        pass segment to IP
        // 前沿移动
        NextSeqNum = NextSeqNum + length(data)

    event: timer timeout
        retransmit not-yet-acknowledged segment with
        smallest sequence number
    start timer

    event: ACK received, with ACK field value of y
        if (y > SendBase) {
            SendBase = y
            if (there are currently not-yet-acknowledged segments)
            start timer
        }
} /* end of loop forever */
注释:
- SendBase-1: 最后一个累积确认的字节
例:
- SendBase-1 = 71;
- y = 73,因此接收方期望73+;
- y > SendBase,因此新的数据被确认
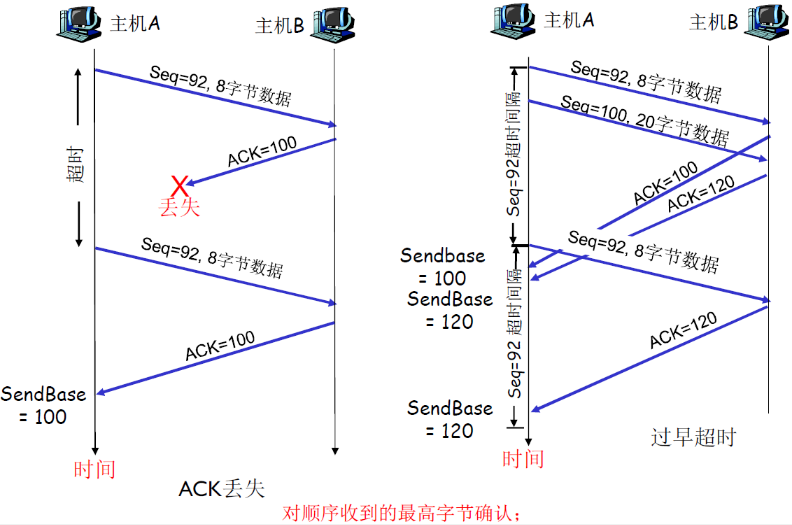
6.3.6 TCP重传场景分析
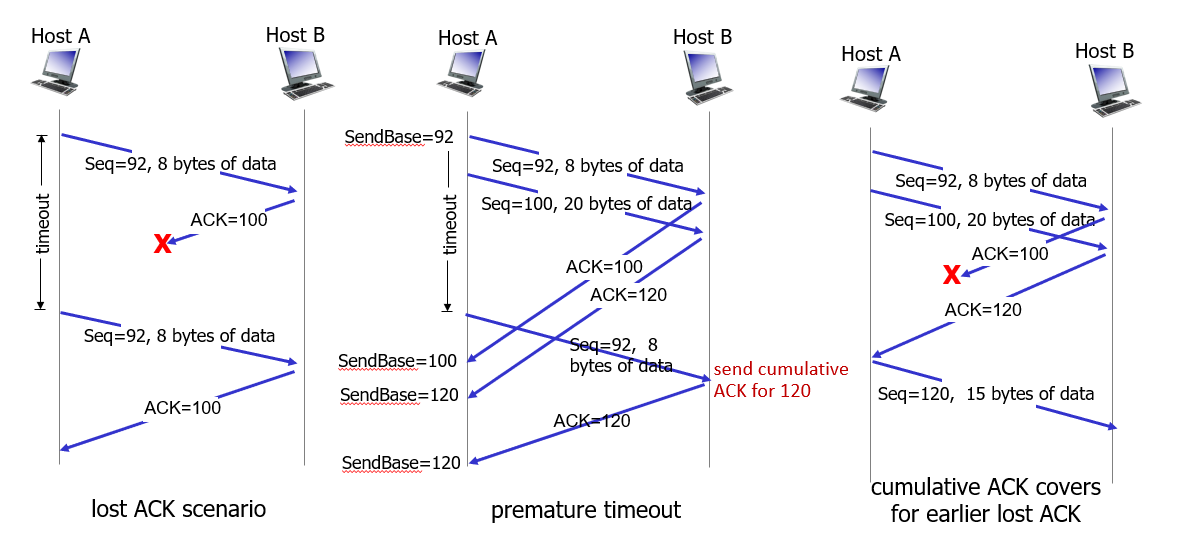
6.3.6.1 场景一:ACK丢失
- 主机A发送
Seq=92的报文段(含8字节数据,即92-99)。 - 主机B正确接收,并回复
ACK=100(表示已收到99,期望100)。 - 不幸的是,
ACK=100在网络中丢失。 - 主机A的定时器超时,它会重传最老的未确认段,即
Seq=92。 - 主机B再次收到
Seq=92的段,发现是重复的,但仍会回复ACK=100。
6.3.6.2 场景二:过早超时
- A发送
Seq=92,B回复ACK=100。 - A紧接着发送
Seq=100(含20字节数据,即100-119)。 - 假设A的超时定时器设置得过短,在收到
ACK之前就超时了。 - A会重传最老的未确认段,即
Seq=92。 - B在稍后收到了重传的
Seq=92。但此时B已经成功接收了119及之前的所有字节,所以它会回复一个累积确认ACK=120,告知A它期望从120开始接收。
在发生超时后,TCP会把超时的间隔设置为原来的2倍,而不是用EstimatedRTT和DevRTT;而定时器在另外两个事件(即收到上层数据和收到ACK)中任意一个启动时TimeInterval还是用原来的算法推算得到
6.3.6.3 场景三:累计确认避免了第一个报文段的重传
如果第一个报文段的ACK在网络中丢失,但是在超时事件发生之前收到一个ACK=120的确认报文,则发送方可以知道接收方已经收到119以及之前的内容,而不会重传Seq=92的数据。
6.3.7 快速重传机制
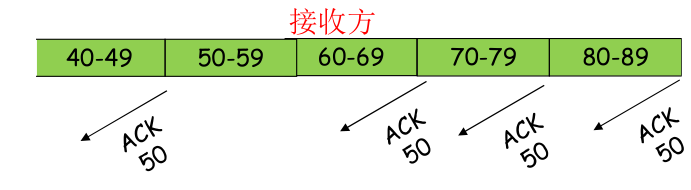
6.3.7.1 原理
- 超时周期往往太长:
- 在重传丢失报文段之前的延时太长
- 通过重复的ACK来检测报文段丢失
- 发送方通常连续发送大量报文段
- 如果报文段丢失,通常会引起多个重复的ACK
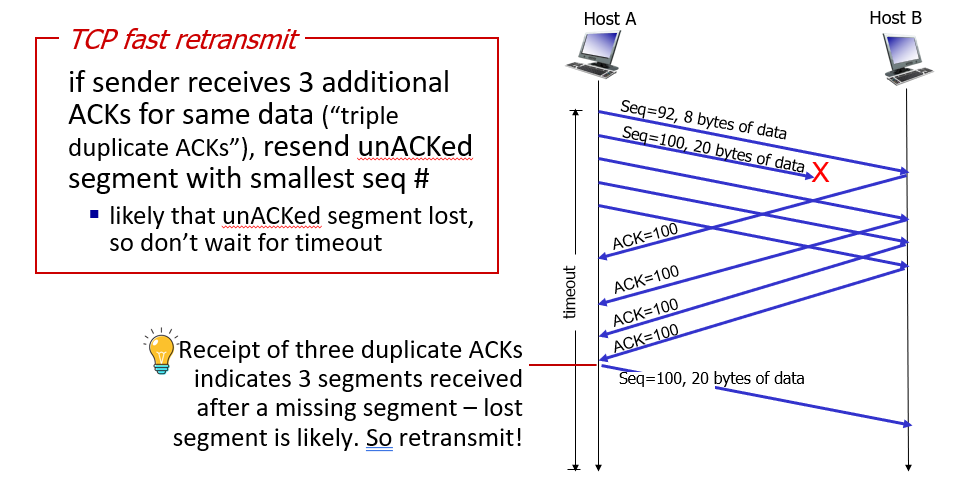
- 如果发送方收到同一数据的3个冗余ACK,重传最小序号的段:
- 快速重传:在定时器过时之前重发报文段
- 它假设跟在被确认的数据后面的数据丢失了
- 第一个ACK是正常的;
- 收到第二个该段的ACK,表示接收方收到一个该段后的乱序段;
- 收到第3,4个该段的ack,表示接收方收到该段之后的2个,3个乱序段,可能性非常大段丢失了
超时重传的等待时间可能很长。快速重传是一种优化机制,它通过观察收到的ACK序列来提前判断丢包。
当一个报文段丢失后,发送方会继续发送后续的报文段。这些后续的报文段在接收方看来都是“乱序”的。根据上述ACK生成建议,接收方每收到一个乱序的报文段,就会立即回复一个重复的ACK,该ACK的确认号指向它当前真正期望的那个丢失的报文段。
因此,如果发送方收到了一个正常的ACK,紧接着又收到了三个完全相同的冗余ACK,它就可以高度确信,这个ACK所指向的报文段已经在网络中丢失了。
6.3.7.2 触发与执行
- 触发:发送方收到某个序号
y的3个冗余ACK(即总共收到4个ACK=y)。 - 执行:发送方不等定时器超时,立刻重传序号为
y的那个报文段。
这个算法极大地提高了TCP对单个报文段丢失的响应速度,是现代TCP协议中不可或缺的一部分。
6.3.7.3 伪代码
event: ACK received, with ACK field value of y
    if (y > SendBase) {
        SendBase = y
        if (there are currently not-yet-acknowledged segments)
            start timer
    }
    else {//已确认报文段的一个重复确认
        increment count of dup ACKs received for y
        if (count of dup ACKs received for y = 3) {
            resend segment with sequence number y
        }
    }
6.3.8 是GBN还是SR?
- TCP是累计式的,正确接收但是失序的报文,但是不会被接收方逐个确认,这个看起来像GBN。TCP只用在
Sender维护一个已发送过但是没有被确认的最小字节号SendBase和下一个要发送的字节号NextSeqNum。 - 但是TCP会缓存失序的报文
- 更重要的是:如果发送方发送了N个报文并且全部成功接收,但是有个分组k(k<N)的确认报文ACK没有成功被接收方收到
- GBN会重新发送
k和k之后的所有报文 - 而TCP最多重新发送报文
k,如果对于报文段k+1的确认报文再k超时之前到达,TCP不会重新发送报文k
- GBN会重新发送
6.4 TCP 流量控制 (Flow Control)
6.4.1 流量控制的目的与原理
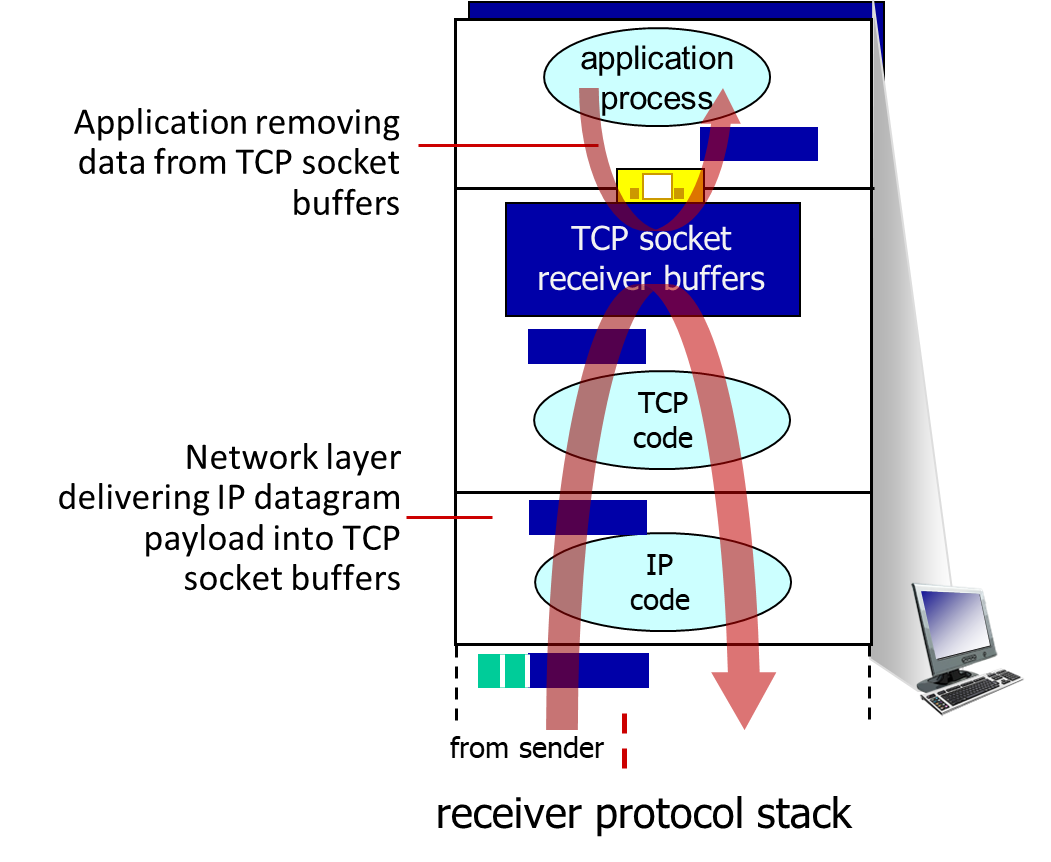
Q: What happens if network layer delivers data faster than application layer removes data from socket buffers?
流量控制的核心目的,是防止发送方发送数据的速度过快,超出了接收方的处理能力,从而导致接收方缓冲区溢出。
在接收端,有一个接收缓冲区(RcvBuffer)。网络层(IP)将数据包送入这个缓冲区,而上层的应用进程则从这个缓冲区中读取数据。如果应用读取数据的速度跟不上数据进入的速度,缓冲区就会被逐渐填满。
6.4.2 实现机制:通告接收窗口 (rwnd)
为了实现流量控制,TCP采用了一种基于反馈的机制。
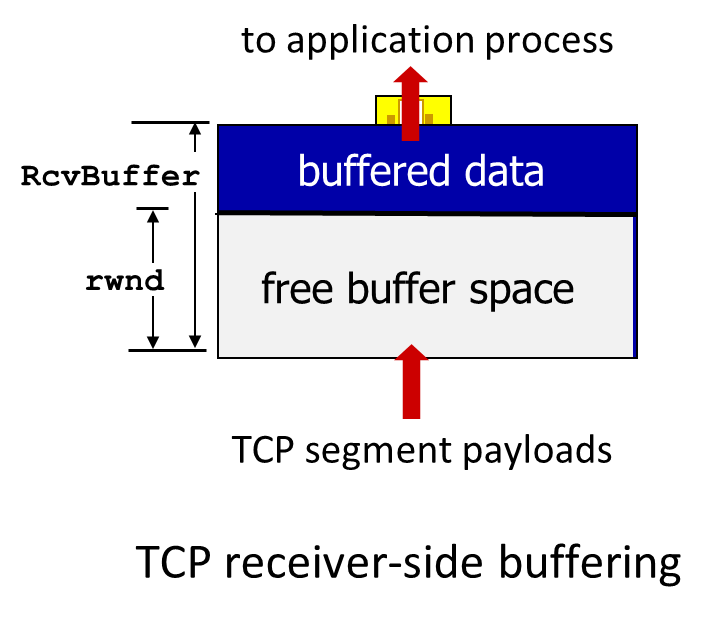
- 接收方会计算其接收缓冲区中当前剩余的空闲空间大小。这个值被称为接收窗口 (Receive Window,
rwnd)。 - 接收方将这个
rwnd的值,放置在它发送给发送方的TCP报文段头部的相应字段中。
发送方在收到这个rwnd值后,就会限制自己“在飞的”(即已发送但未收到确认的)数据总量,使其不超过接收方通告的rwnd值。这样一来,就确保了发送的数据不会超出接收方的容纳能力。
6.4.2.1 捎带技术 (Piggybacking) 的应用
这个rwnd值的反馈过程,巧妙地利用了捎带技术。由于TCP连接是全双工的,数据可以在两个方向上同时流动。
老师的“猪羊”比喻:想象A给B送猪,B给A送羊。如果每次送完货后,都要单独寄一封信来确认收货,那就太麻烦了。更高效的方式是,B在给A送羊的时候,在羊身上贴个纸条,写着:“你上次送来的第X号猪我已经收到了”。
TCP就是这样做的。当接收方需要向发送方发送数据时,它会把对接收数据的确认(ACK)以及自己的接收窗口大小(rwnd)等控制信息,“捎带”在它自己发送的数据报文段中。这避免了为发送纯粹的控制信息而产生额外的网络开销。
这个思路值得学习,可以用到其他地方
- 之前对单纯的RDT的研究中,Sender和Receiver是分开的
- 因此发送方只发送data,接收方只发送ACK,如下
- 但是在TCP中,数据是双向传输的,每一方既可以看做sender,又可以看做receiver
- 假如AB通信,那么A作为sender要发送数据data,又要作为receiver要发送ACK,这样就很麻烦了
- 因此,可以将一些信息(不仅仅是ACK)包含在数据中心,在发数据的时候捎带发送
看下面的结构
可以用确认号来表示ACK
也可以用接收窗口来表示缓冲区的剩余大小(用于流量控制)
在后面讨论的时候,我们会研究单向传递,但是实际上是双向的,如下
- 尽管主机B发送ACK,但是ACK是包含在B给A的data当中的
- 这里是只研究A→B的单向传递
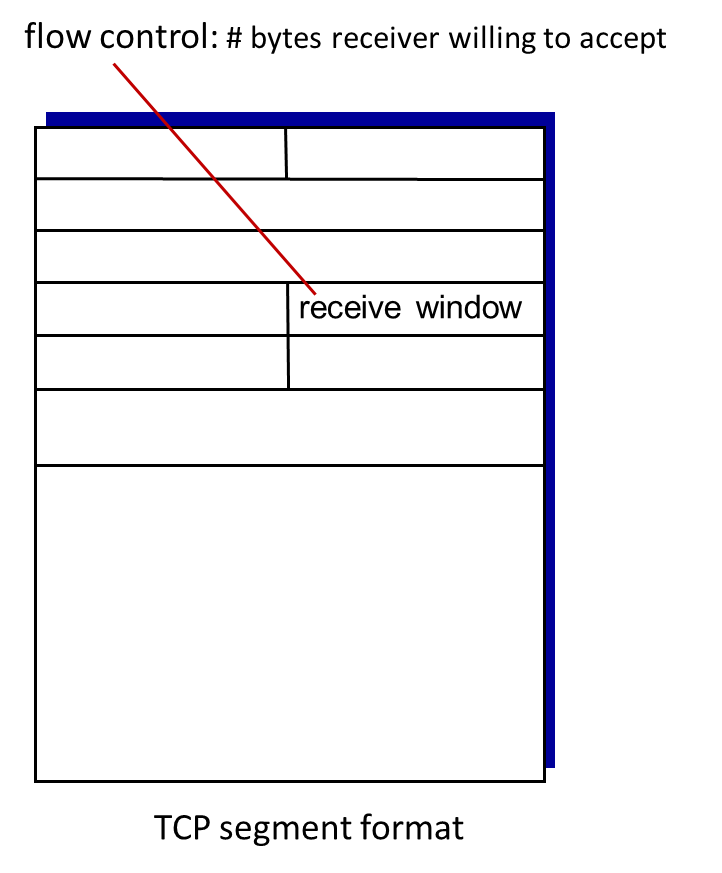
6.4.2.2 rwnd 的计算
- TCP receiver “advertises” free buffer space in rwnd field in TCP header
- RcvBuffer size set via socket options (typical default is 4096 bytes)
- many operating systems autoadjust RcvBuffer
- sender limits amount of unACKed (“in-flight”) data to received rwnd
- guarantees receive buffer will not overflow
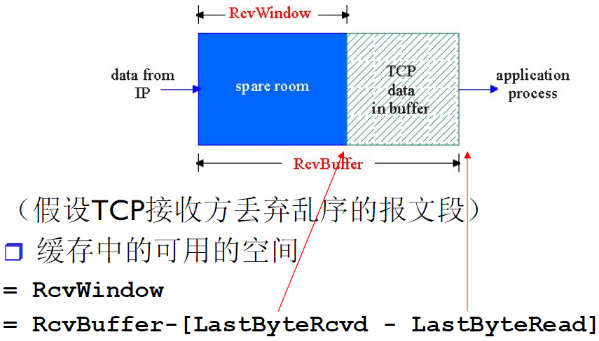
接收方通过维护两个变量来计算rwnd:LastByteRcvd(最后一个已接收并放入缓冲区的字节的序号)和 LastByteRead(最后一个已被应用进程读取的字节的序号)。
- 已缓冲但未读取的数据量 =
LastByteRcvd - LastByteRead rwnd(空闲空间) =RcvBuffer(总大小)-(已缓冲但未读取的数据量)
缓存中可以用的空间= RcvWindow = RcvBuffer - [LastByteRcvd - LastByteRead]
这个rwnd值被动态地反馈给发送方,从而实现了精细且自适应的流量控制。
NOTE
有一个BUG,就是如果接收方已经满了,则发送方永远不可能知道接收方什么时候清空。则此时发送方每次只发送有一个字节的数据段。这些报文段将会被接收方确认,最终缓存开始清空,而
cwnd的值非0.
6.5 TCP 连接管理
TCP连接的生命周期包括三个主要阶段:连接建立、数据传输和连接释放。
6.5.1 连接建立的本质
当两个应用进程希望通过TCP通信时,它们需要先“握手”来建立连接。这个过程的本质包含三个核心要素:
- 相互确认意愿:通信双方都必须明确知道,对方也愿意与自己建立连接。
- 准备资源:双方都需要为即将到来的通信分配必要的系统资源,如发送/接收缓冲区,并初始化相关的控制变量(如
SendBase,NextSeqNum等)。 - 交换并确认参数:双方必须交换并确认一些关键的初始参数,其中最重要的就是初始序号 (Initial Sequence Number, ISN)。A需要告诉B它将从哪个序号
x开始发送数据,B也需要告诉A它将从哪个序号y开始发送,并且双方都要对对方的初始序号进行确认。
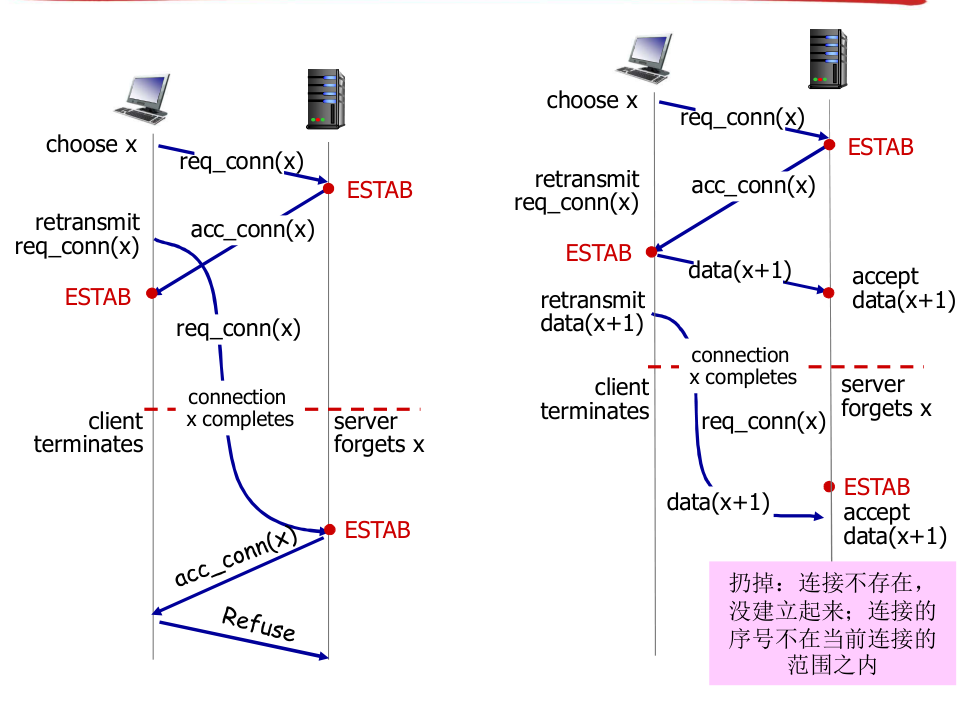
6.5.2 两次握手的问题【不可行】
Q: will 2-way handshake always work in network?
- variable delays
- retransmitted messages (e.g.
req_conn(x)) due to message loss - message reordering
- can’t “see” other side
Q:在网络中,2次握手建立连接总是可行吗?
- 变化的延迟(连接请求的段没有丢,但可能超时)
- 由于丢失造成的重传 (e.g.
req_conn(x)) - 报文乱序
- 相互看不到对方
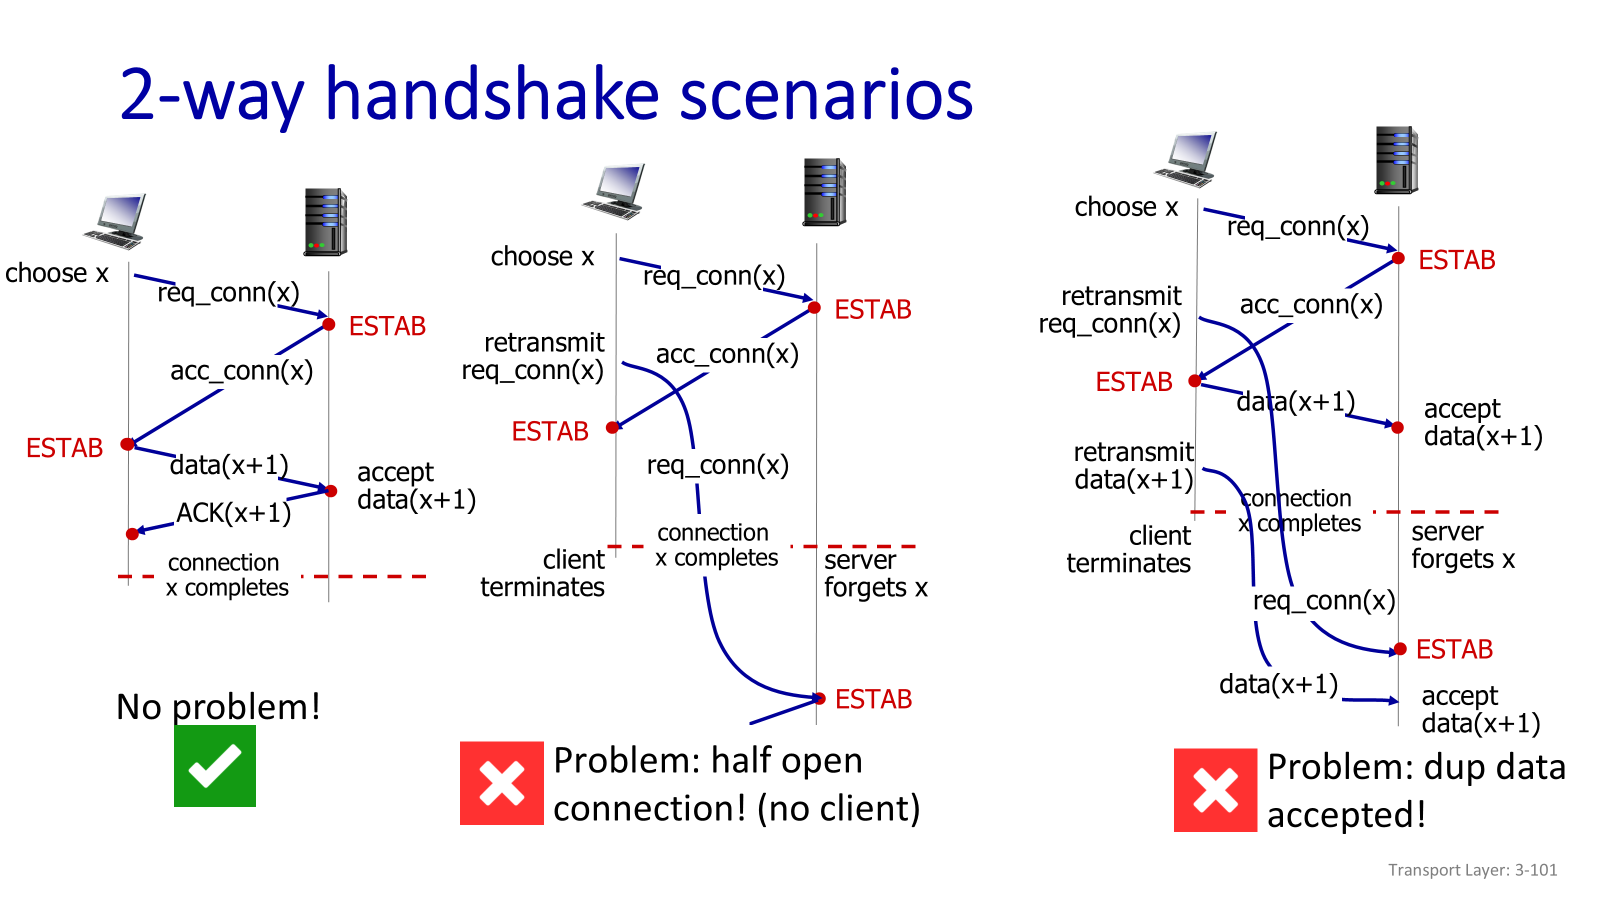
6.5.2.1 问题一:半连接 (Half-Open Connection)
假设客户端发送了一个连接请求,但该请求在网络中延迟了。客户端因超时而重发了第二个请求,这个请求成功地与服务器建立了连接,完成了数据传输,最后关闭了连接。
一段时间后,那个延迟的第一个请求终于到达了服务器。如果采用两次握手,服务器收到这个请求后,会回复一个确认,并单方面地认为连接已建立,从而为这个“连接”分配资源。但此时客户端早已不再关心这个连接,不会有任何后续动作。这就导致服务器维持了一个无效的“半连接”,白白消耗了系统资源。
6.5.2.2 问题二:接收老数据
与上一个场景类似,假设一个旧的、延迟的数据包,在一个新连接建立后才到达服务器。由于两次握手无法区分新旧连接,服务器可能会错误地将这个来自旧连接的数据包当作新连接的有效数据来接收,造成数据混乱。
6.5.3 三次握手:解决方案
为了解决上述问题,TCP采用了三次握手。其核心逻辑是:我选择的初始序号,需要得到你的确认;你选择的初始序号,也需要得到我的确认。 这个过程最少需要三次交互才能完成。
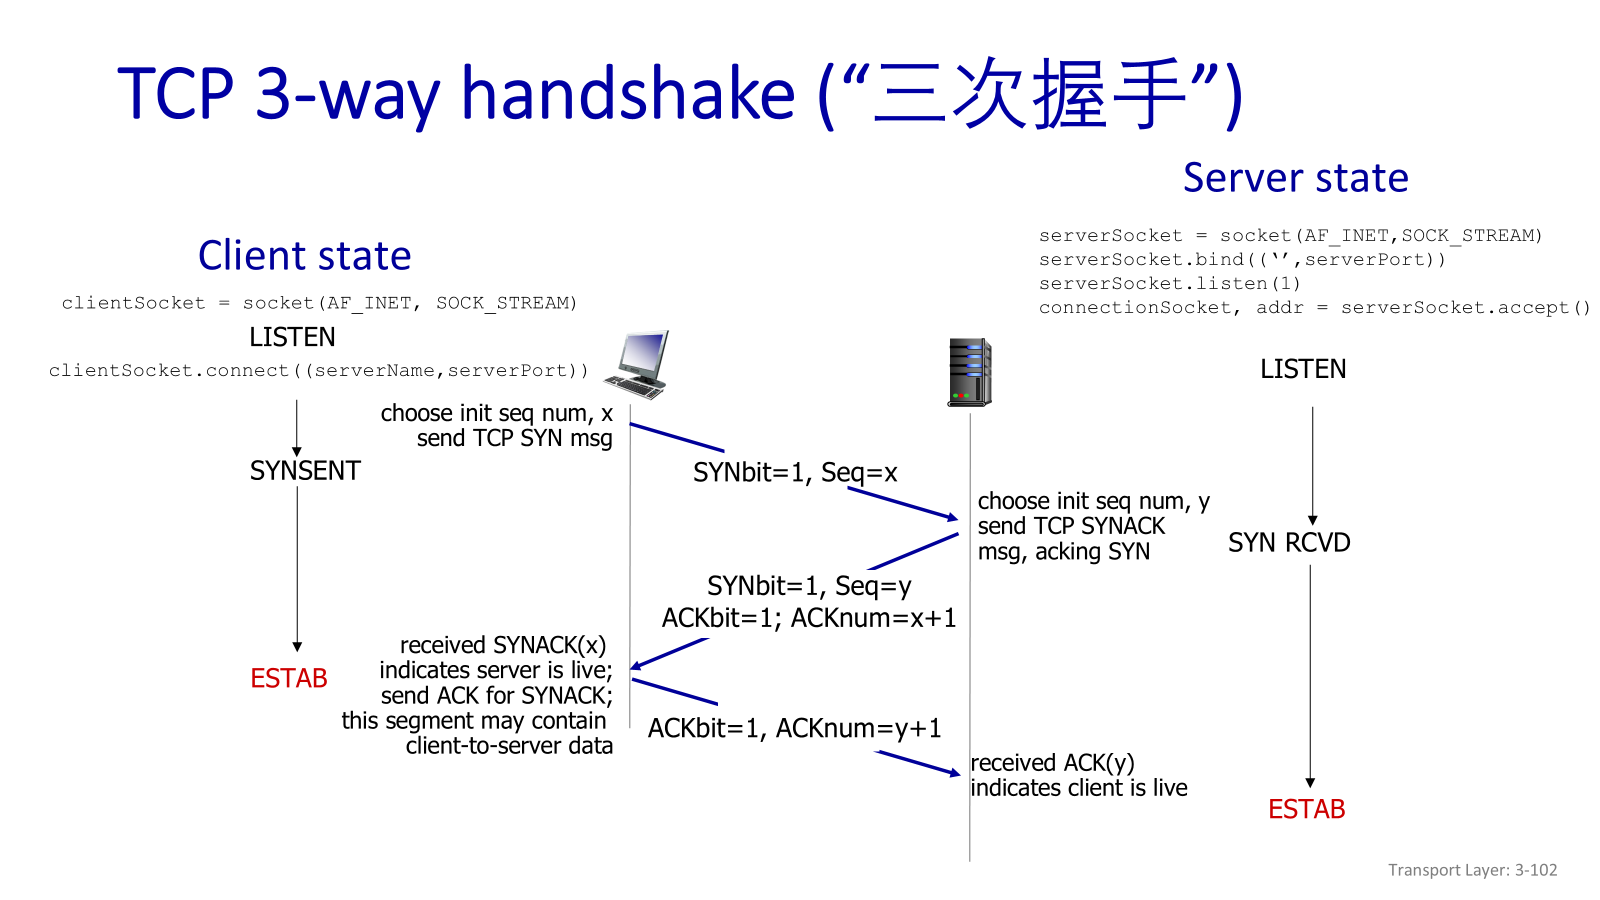
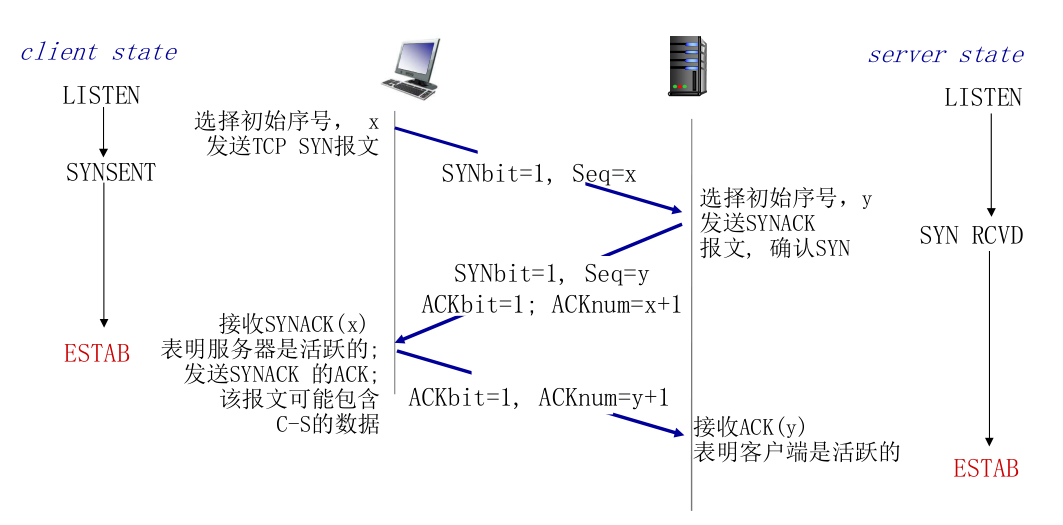
解决方案:变化的初始序号+双方确认对方的序号(3次握手)
| 属性 | 说明 |
|---|---|
| SYNbit=1 | 请求建立连接 |
| Seq = x | 建立请求的时候选择初始信号 |
| ACKbit = 1 | 表明该信号是ACK信号 |
| ACKnum = x + 1 | 表示同意Seq=x的请求 |
6.5.3.1 流程
- 第一次握手 (SYN): 客户端向服务器发送一个
SYN报文段,其中包含客户端自己选择的初始序号Seq=x。 - 第二次握手 (SYN-ACK): 服务器收到
SYN后,回复一个SYN-ACK报文段。这个报文段包含了服务器选择的初始序号Seq=y,同时通过Acknum=x+1来确认收到了客户端的SYN。 - 第三次握手 (ACK): 客户端收到
SYN-ACK后,发送一个ACK报文段,通过Acknum=y+1来确认收到了服务器的SYN。此时,连接正式建立。第三次握手通常可以捎带第一个数据包。
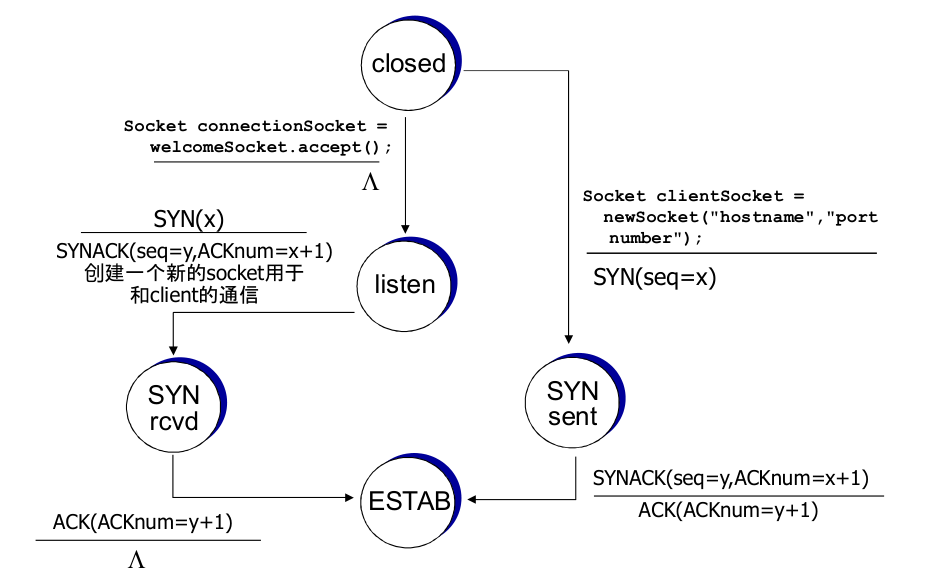
来回顾一下TCP的报文段
- 其中,SYN=1的时候,表示连接请求
6.5.3.2 如何解决问题
- 解决半连接:在半连接场景中,当服务器收到旧的
SYN并回复SYN-ACK后,客户端会发现这个ACK并不是它所期望的。因此,客户端会发送一个重置(RST)报文或直接忽略它,从而服务器就不会维持那个无效的连接。 - 解决老数据:三次握手通过使用随机的初始序号来解决此问题。每个新连接都会协商一组新的、随机的ISN。当一个来自旧连接的数据包到达时,服务器会检查其序号。由于这个序号不在当前新连接所约定的序号范围之内,服务器会将其识别为无效数据并丢弃。虽然可能发生两次序列号的初始值是一样的可能,但是32位的序号空间使得新旧连接的序号范围发生重叠的概率极低。【其是会随着时间变化的】
6.5.4 TCP 连接释放
TCP连接的释放是一个四次握手的过程,因为TCP是全双工的,连接的两个方向需要被独立地关闭。
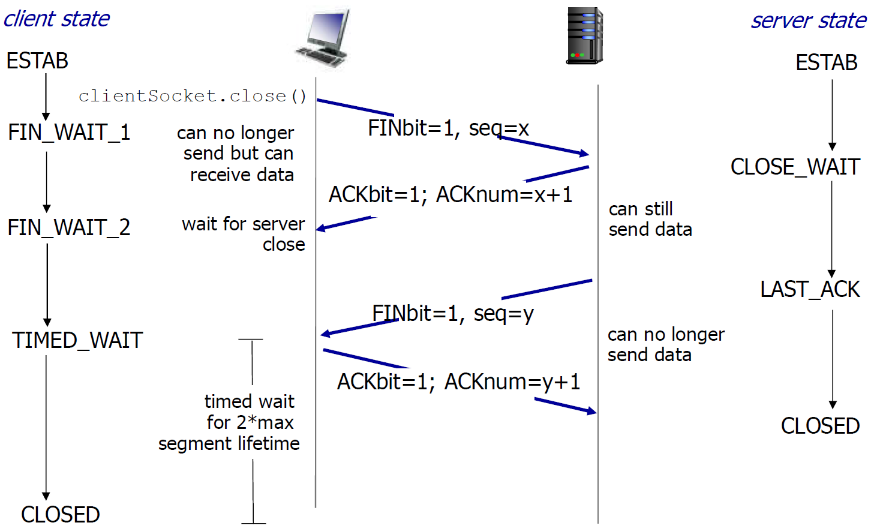
- 第一次 (FIN): 某一方(如客户端)决定关闭连接,向对方发送一个
FIN报文段,表示“我这边没有数据要发送了”。 - 第二次 (ACK): 对方收到
FIN后,回复一个ACK报文,表示“收到了你的关闭请求”。此时连接处于半关闭状态:发送FIN的一方不能再发送数据,但另一方如果还有数据未发完,仍然可以继续发送。 - 第三次 (FIN): 当对方也完成了所有数据发送后,它会发送自己的
FIN报文段,表示“我这边也准备好关闭了”。 - 第四次 (ACK): 最初发起关闭的一方收到对方的
FIN后,回复最后一个ACK。在等待一段固定的时间(2*MSL,两倍最大报文段生存时间)以确保这个ACK被对方收到后,连接彻底关闭。
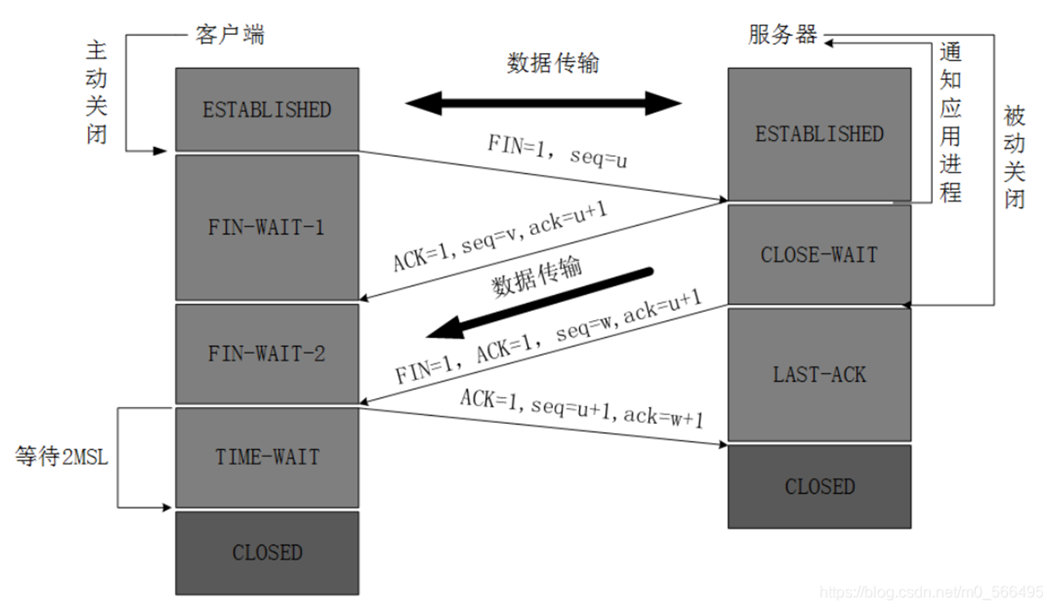
6.5.4.1 两军问题 (Two Generals’ Problem)的对比
TCP的连接释放过程并非绝对完美,它受制于一个经典的分布式计算问题——“两军问题”。
这个问题描述了两支友军需要在一个不可靠的信道上协调攻击时间。无论它们之间来回发送多少次确认信息,发送最后一条信息的那一方,永远无法100%确定对方是否收到了这条信息。
同理,在TCP连接释放时,发送最后那个ACK的一方,也无法绝对保证对方收到了它。因此,TCP的连接释放是一个“大概齐”的、工程上的解决方案,而非理论上完美的。TIME_WAIT状态就是为了应对这种不确定性而设计的。
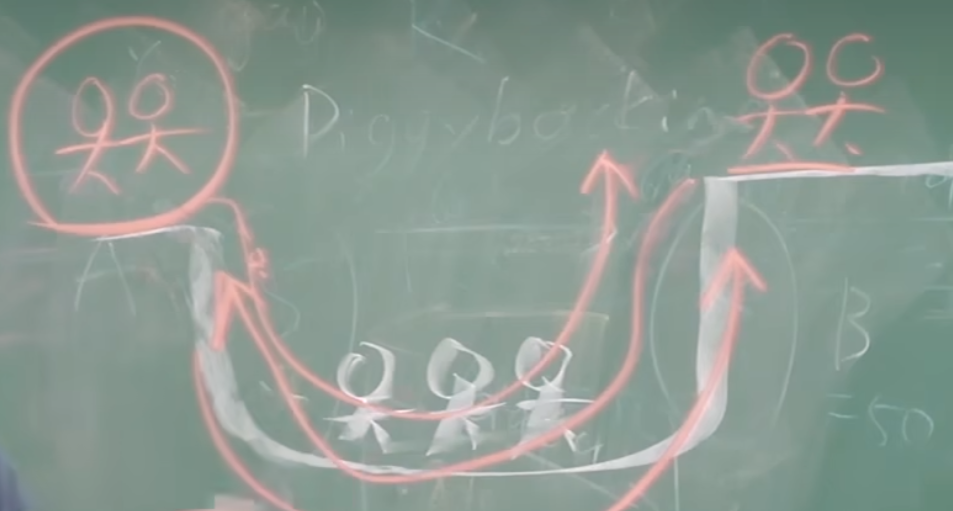
6.5.5 补充问题
【问题1】为什么连接的时候是三次握手,关闭的时候却是四次握手?
答:因为当Server端收到Client端的SYN连接请求报文后,可以直接发送SYN+ACK报文。其中ACK报文是用来应答的,SYN报文是用来同步的。但是关闭连接时,当Server端收到FIN报文时,很可能并不会立即关闭SOCKET,所以只能先回复一个ACK报文,告诉Client端,“你发的FIN报文我收到了”。只有等到我Server端所有的报文都发送完了,我才能发送FIN报文,因此不能一起发送。故需要四步握手。
6.5.6 TCP链接管理的例题
6.5.6.1 1. 请简述 TCP 客户端和服务端建立连接的“三次握手”。并画出三次握手过程的简单示意图,并注明 SYN, ACK, FIN 标志位以及 SEQ 序列号的变化。你可以随意指定第一个 SEQ 序列号。
简述: TCP 三次握手(Three-way Handshake)是 TCP 协议建立一个可靠连接的过程。这个过程确保了客户端和服务端双方都具有收发数据的能力,并同步了双方的初始序列号 (ISN, Initial Sequence Number)。
-
第一次握手 (SYN): 客户端向服务端发送一个连接请求报文段。
- 该报文段的
SYN标志位被设置为 1。 - 客户端随机选择一个初始序列号
seq=x。 - 此时,客户端进入
SYN_SENT状态。
- 该报文段的
-
第二次握手 (SYN-ACK): 服务端收到客户端的
SYN报文后,如果同意连接,则回复一个确认报文段。- 该报文段的
SYN标志位被设置为 1(表示这也是一个发起连接的请求)。 ACK标志位被设置为 1(表示确认)。- 服务端也随机选择一个自己的初始序列号
seq=y。 - 确认号
ack被设置为x+1(表示已收到客户端的seq=x)。 - 此时,服务端进入
SYN_RCVD状态。
- 该报文段的
-
第三次握手 (ACK): 客户端收到服务端的
SYN-ACK报文后,会向服务端发送一个确认报文段。ACK标志位被设置为 1。- 序列号
seq被设置为x+1(表示这是对x的后续)。 - 确认号
ack被设置为y+1(表示已收到服务端的seq=y)。 - 此时,客户端进入
ESTABLISHED状态。服务端收到这个ACK后,也进入ESTABLISHED状态。连接建立成功。
简单示意图 (FIN 标志位在握手过程中为 0):
   客户端 (Client)                       服务端 (Server)
      (CLOSED)                             (LISTEN)
         |                                     |
         |  1. SYN=1, ACK=0, seq=x             |
         |------------------------------------>|
         |  (状态: SYN_SENT)                   |
         |                                     | (状态: LISTEN -> SYN_RCVD)
         |  2. SYN=1, ACK=1, seq=y, ack=x+1    |
         |<------------------------------------|
         |                                     |
         | (状态: SYN_SENT -> ESTABLISHED)     |
         |  3. ACK=1, seq=x+1, ack=y+1         |
         |------------------------------------>|
         |                                     | (状态: SYN_RCVD -> ESTABLISHED)
         |                                     |
      (连接已建立)                         (连接已建立)
6.5.6.2 2. 请简述 TCP 客户端和服务端的关闭连接的“四次挥手”。并画出四次挥手过程的简单示意图,并注明 SYN, ACK, FIN 标志位以及 SEQ 序列号的变化。你可以随意指定第一个 SEQ 序列号。
简述: TCP 四次挥手(Four-way Handshake)是 TCP 协议终止一个连接的过程。由于 TCP 是全双工的,连接的关闭需要在两个方向上分别进行。
(假设由客户端主动发起关闭)
- 第一次挥手 (FIN): 客户端(数据已发送完毕)向服务端发送一个连接释放报文段。
FIN标志位被设置为 1(表示请求关闭连接)。ACK标志位为 1(通常在数据传输中 ACK 始终为 1)。- 指定一个序列号
seq=u(u是客户端在此连接上已发送数据的最后一个字节的序号 + 1)。 - 确认号
ack=v(v是客户端期望收到的下一个字节的序号)。 - 此时,客户端进入
FIN_WAIT_1状态。
- 第二次挥手 (ACK): 服务端收到客户端的
FIN报文后,回复一个确认报文段。ACK标志位被设置为 1。- 序列号
seq=v。 - 确认号
ack被设置为u+1(表示已收到客户端的seq=u)。 - 此时,服务端进入
CLOSE_WAIT状态。客户端收到这个ACK后,进入FIN_WAIT_2状态。 - 注意: 此时连接处于“半关闭”状态,客户端不能再发送数据,但服务端如果还有数据未发完,仍然可以发送。
- 第三次挥手 (FIN): 服务端(所有数据也已发送完毕)向客户端发送一个连接释放报文段。
FIN标志位被设置为 1。ACK标志位被设置为 1。- 指定一个序列号
seq=w(w是服务端在此连接上已发送数据的最后一个字节的序号 + 1。如果中途没有发数据,w可能等于v)。 - 确认号
ack=u+1(重复确认客户端的关闭请求)。 - 此时,服务端进入
LAST_ACK状态。
- 第四次挥手 (ACK): 客户端收到服务端的
FIN报文后,回复最后一个确认报文段。ACK标志位被设置为 1。- 序列号
seq=u+1。 - 确认号
ack被设置为w+1(表示已收到服务端的seq=w)。 - 此时,客户端进入
TIME_WAIT状态。 - 服务端收到这个
ACK后,立即进入CLOSED状态。 - 客户端在
TIME_WAIT状态等待 2*MSL(最大报文段生存时间)后,也进入CLOSED状态,连接彻底关闭。
简单示意图 (SYN 标志位在挥手过程中为 0):
   客户端 (Client)                       服务端 (Server)
   (ESTABLISHED)                         (ESTABLISHED)
         |                                     |
         |  1. FIN=1, ACK=1, seq=u, ack=v      |
         |------------------------------------>|
         |  (状态: FIN_WAIT_1)                 |
         |                                     | (状态: ESTABLISHED -> CLOSE_WAIT)
         |  2. ACK=1, seq=v, ack=u+1           |
         |<------------------------------------|
         |                                     |
         | (状态: FIN_WAIT_1 -> FIN_WAIT_2)    |
         |  ... (服务端可能继续发送剩余数据) ...   |
         |                                     |
         |  3. FIN=1, ACK=1, seq=w, ack=u+1    |  (服务端数据发送完毕)
         |<------------------------------------|
         |                                     | (状态: CLOSE_WAIT -> LAST_ACK)
         | (状态: FIN_WAIT_2 -> TIME_WAIT)     |
         |  4. ACK=1, seq=u+1, ack=w+1         |
         |------------------------------------>|
         |                                     | (状态: LAST_ACK -> CLOSED)
         | (等待 2*MSL 后进入 CLOSED 状态)      |
         |                                     |
      (CLOSED)                              (CLOSED)
6.5.6.3 3. 请谈谈你的理解,为什么 TCP 中要采用“三次握手”和“四次挥手”?
为什么是“三次握手”?
- 采用三次握手是为了确保通信双方都具有可靠的发送和接收能力,并防止已失效的连接请求导致错误。
- 同步双方序列号: 三次握手过程交换了双方的 ISN(初始序列号),为后续数据的可靠传输(确认和重排)奠定基础。
- 防止“已失效的连接请求” (Old Duplicate SYN):
- 设想两次握手: 如果是两次握手(客户端发
SYN,服务端回ACK并建连),可能会出现问题:客户端发送的第一个SYN报文因网络延迟,在超时后客户端重发了第二个SYN并成功建立了连接。在此连接关闭后,那个延迟的旧SYN终于到达了服务端。 - 两次握手的后果: 服务端会误认为这是一个新的连接请求,于是回复
ACK并分配资源建立连接。但客户端对此一无所知(因为它已处于CLOSED状态),不会发送任何数据。这导致服务端单方面维护一个“僵尸连接”,浪费资源。 - 三次握手的解决: 在三次握手模型中,服务端收到旧
SYN后回复SYN-ACK。客户端收到这个它并不期望的SYN-ACK时,会发现这个ack号不是它所期望的,或者它当前不处于SYN_SENT状态,于是会发送一个RST(Reset) 报文来中止这个错误的连接,从而避免了服务端资源的浪费。
- 设想两次握手: 如果是两次握手(客户端发
- 确保双方能力:
- 第一次握手 (Client → Server):服务端知道“客户端的发送能力正常”。
- 第二次握手 (Server → Client):客户端知道“服务端的发送和接收能力都正常”。
- 第三次握手 (Client → Server):服务端知道“客户端的接收能力正常”。
- 至此,双方都确认了对方的收发能力均正常,可以开始通信。
为什么是“四次挥手”? 采用四次挥手是因为 TCP 是全双工通信,连接的关闭需要双向独立进行。
- 全双工的本质: 在 TCP 连接中,数据流是双向的。一方(如客户端)决定关闭连接(发送
FIN),仅仅表示它自己这一方已经没有数据要发送了。 - 分离 ACK 和 FIN:
- 当服务端收到客户端的
FIN(第一次挥手)时,它可能还有数据没有发送完毕(例如,一个正在处理的数据库查询结果)。 - 因此,服务端必须先立即回复一个
ACK(第二次挥手),告诉客户端:“你的关闭请求我收到了。” 这时连接进入“半关闭”状态。 - 服务端会继续发送它剩余的数据。直到所有数据都发送完毕后,服务端才能发送它自己的
FIN报文(第三次挥手),表示“我这边也准备好关闭了”。 - 最后客户端回复
ACK(第四次挥手)确认。
- 当服务端收到客户端的
- 总结: 如果将第二次(ACK)和第三次(FIN)挥手合并,就意味着服务端在收到客户端关闭请求时,必须立即也准备好关闭,这在实际应用中是不现实的。四次挥手将“确认对方的关闭”和“发起自己的关闭”这两个动作解耦,允许数据在半关闭状态下继续传输,保证了数据的完整性。
6.5.6.4 4.ACK是不是总全是1
除了第一个SYN报的ACK的是0,其他全部是1。这样体现了TCP的双全工的特点。
6.6 课本其他的补充:
6.6.1 如果我们的TCP请求到了一个没有开启TCP监听的服务器?
Now that we have a good understanding of TCP connection management, let’s revisit the nmap port-scanning tool and examine more closely how it works. To explore a specific TCP port, say port 6789, on a target host, nmap will send a TCP SYN segment with destination port 6789 to that host. There are three possible outcomes:
- The source host receives a TCP SYNACK segment from the target host. Since this means that an application is running with TCP port 6789 on the target post, nmap returns “open.”
- The source host receives a TCP RST segment from the target host. This means that the SYN segment reached the target host, but the target host is not running an application with TCP port 6789. But the attacker at least knows that the segments destined to the host at port 6789 are not blocked by any firewall on the path between source and target hosts. (Firewalls are discussed in Chapter 8.)
- The source receives nothing. This likely means that the SYN segment was blocked by an intervening firewall and never reached the target host.
6.6.2 TCP的泛洪攻击
SYN 洪水攻击 (SYN Flood Attack):
- 一种经典的拒绝服务 (DoS) 攻击。
- 攻击者向服务器发送大量 TCP SYN 段(连接请求)。
- 服务器为每个 SYN 分配连接变量和缓冲区(建立“半开放连接”),并发送 SYNACK,等待客户端返回 ACK 以完成三次握手。
- 攻击者从不发送 ACK 来完成握手。
- 服务器的连接资源(用于半开放连接)因此被耗尽,导致合法用户的连接请求被拒绝。
SYN Cookies (防御机制):
- 一种应对 SYN 洪水攻击的有效防御机制。
- 工作原理:
- 当服务器收到 SYN 段时,它 不会 立即分配连接资源。
- 服务器会创建一个特殊的初始 TCP 序列号,即“cookie”。
- 这个 “cookie” 是通过一个哈希函数计算得出的,输入包括:源和目标 IP 地址、源和目标端口号,以及一个只有服务器知道的秘密数字。
- 服务器将这个 “cookie”作为初始序列号,在 SYNACK 包中发送给客户端。重要的是,服务器此时不会记住关于这个 SYN 的任何状态信息。
- 对于合法客户端: 客户端会返回一个 ACK 段。根据 TCP 协议,这个 ACK 段中的确认号(acknowledgment field)会等于服务器发来的初始序列号(即 “cookie”)+ 1。
- 服务器验证: 服务器收到 ACK 后,会检查这个确认号。它从确认号中减 1(得到原始 “cookie” 值),然后使用 ACK 包中的(源/目 IP、源/目端口)和它自己的秘密数字,再次运行哈希函数。
- 如果计算结果与 ACK 中包含的 “cookie” 值一致,服务器就确认这个 ACK 对应于之前发送的 SYNACK,并认为这是一个合法的连接请求。此时,服务器才真正分配资源,建立一个完整的连接套接字。
- 对于攻击者: 如果客户端没有发回 ACK 段(因为它是攻击者或伪造的源 IP),这个原始的伪造 SYN 不会造成任何危害,因为服务器从一开始就没有为它分配任何资源。
6.7 其他习题补充
6.7.1 在握手和挥手阶段 丢失数据包或 ACK 怎么办?
TCP 的可靠性就体现在这里。它使用定时器和重传 (Retransmission) 机制来处理。
-
握手阶段丢包:
- 丢了第一次 (SYN): 服务器什么也收不到,什么也不做。客户端的 会超时,然后重传 包(通常会重试几次,每次等待时间更长)。
- 丢了第二次 (SYN-ACK): 客户端会因为收不到 而超时重传 。服务器会收到重复的 ,并重传 。
- 丢了第三次 (ACK): 客户端认为连接已建立,但服务器没收到 。服务器会超时重传 。客户端收到重传的 后,会发现这个连接已经建立过了,于是重新发送 。
-
挥手阶段丢包:
- 丢了第一次 (FIN): 客户端(主动方)会超时重传 。
- 丢了第三次 (FIN): 服务器(被动方)会超时重传 。
- 丢了第四次 (ACK): 这是最关键的。服务器会因为没收到最后的 而超时重传 。此时,客户端正处于
TIME_WAIT状态,它仍然能处理这个重传的 ,并重新发送 ,然后重置自己的 计时器。这就是TIME_WAIT状态的核心作用之一:确保被动关闭方能可靠地关闭。
6.7.2 Client 能否确定服务端已关闭?
不完全能“实时确定”,但 TCP 机制能“最终保证”双方都关闭。
这个问题要分情况看:
-
Client 如何知道 Server 开始 关闭了?
- 很简单,当 Client 收到 Server 发来的 包(四次挥手的第三步)时,Client 就知道 Server 已经处理完所有数据,正在请求关闭。
-
Client 如何(间接)确定 Server 已经 关闭了?
- 如上所述,当 Client 收到 Server 的 并回复最后的 后,Client 会进入
TIME_WAIT状态。 TIME_WAIT状态的意义: 客户端会等待 (最大报文段生存时间)的时长。- 为什么这么做?
- A. 防止最后的 丢失。 如果 丢了,Server 会重传 。
TIME_WAIT状态的 Client 仍能收到这个 并重发 ,帮助 Server 正确关闭。 - B. 防止旧连接的包干扰新连接。
- A. 防止最后的 丢失。 如果 丢了,Server 会重传 。
- 结论: Client 不能立即“确定” Server 已经收到了它发的最后那个 并进入
CLOSED状态。但通过TIME_WAIT机制,Client 最大努力地确保了 Server 能成功关闭。从 Client 自己的角度看,只要TIME_WAIT计时器结束,它就认为这个连接(包括服务器端)已经彻底、安全地终止了。
- 如上所述,当 Client 收到 Server 的 并回复最后的 后,Client 会进入
7 拥塞控制原理
7.1 拥塞控制概述
网络中前10位的问题!
拥塞控制(Congestion Control) 在网络领域没有一个非常权威的定义。一个通俗的理解是:“太多的数据需要通过网络来传输,超过了网络的处理能力”。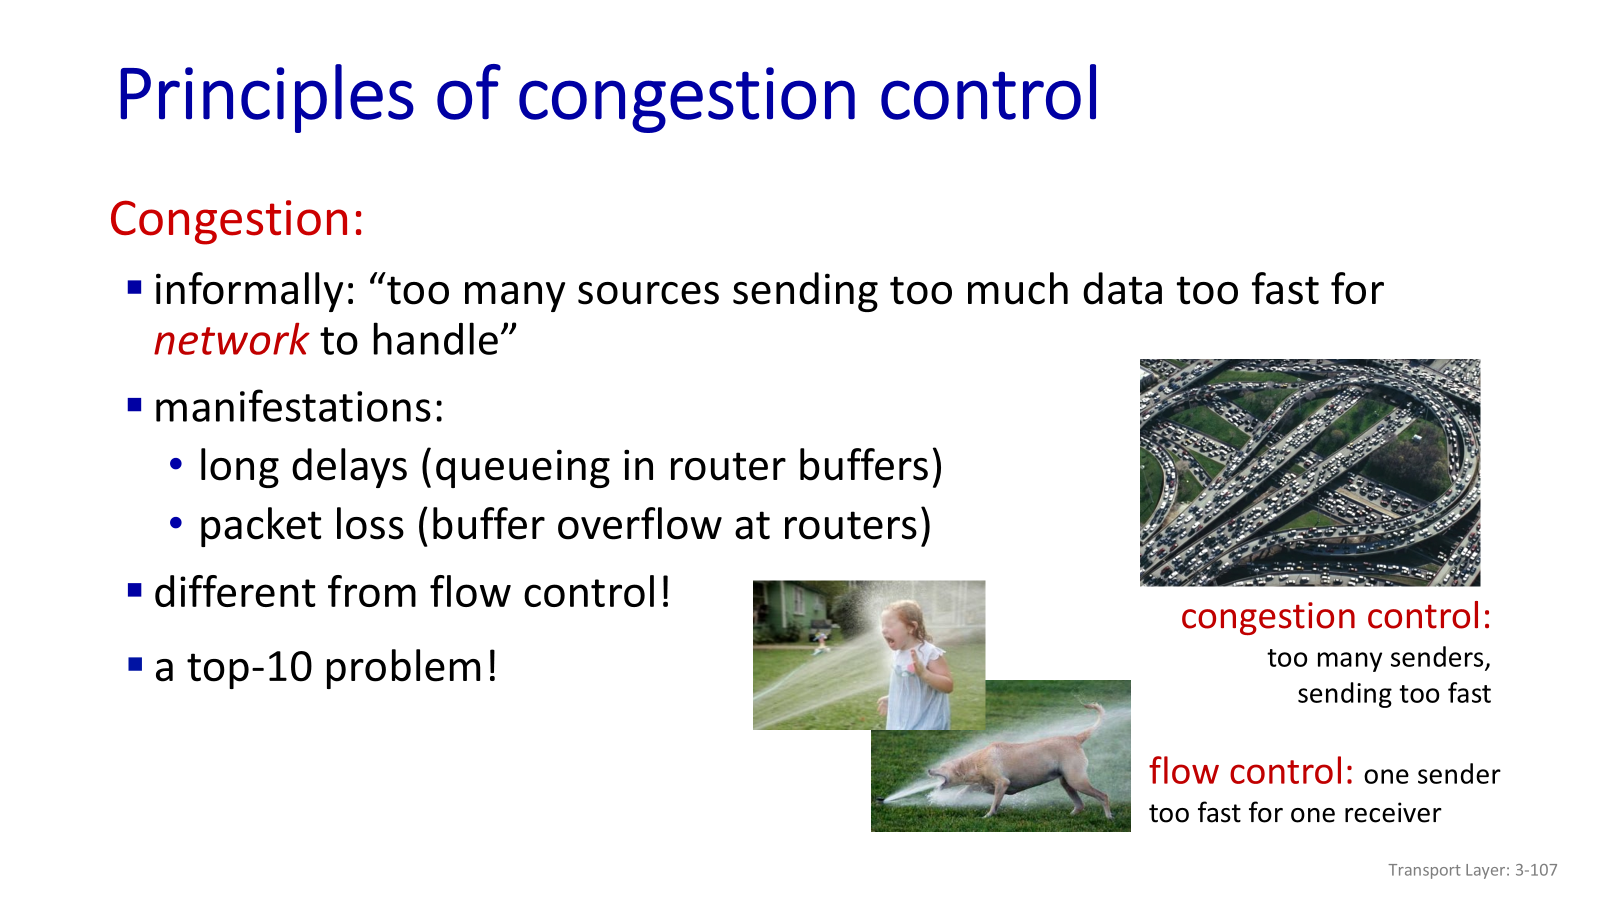
这与流量控制(Flow Control) 是不同的概念。流量控制主要解决的是接收端处理能力不足的问题,而拥塞控制解决的是网络作为共享资源,其整体处理能力不足的问题。
当网络发生拥塞时,通常有两种主要表现:
- 分组丢失率显著增高:在拥塞的网络中,路由器的缓冲区队列被占满,后续到达的分组(Packet)会被丢弃,导致丢失率远高于网络通畅时的情况。
- 延迟显著增加:分组在路由器的队列中排队等待转发的时间会变得非常长。
老师用了一个生动的例子来说明延迟的增加:平时开车从学校到医院可能只需要20分钟,但在周五下午六点的高峰期,同样的路程可能需要80分钟。网络拥塞时的延迟增加也是同样的道理。
不过,与现实交通堵塞不同的是,网络拥塞会导致分组被丢弃(路由器队列满了就会把分组“扔掉”),而现实中的汽车不会被交警扔到河里。
拥塞控制的核心目标并非完全避免拥塞,而是在尽可能不发生拥塞的情况下,最大限度地利用网络带宽。这是一个需要在“提高发送速率”和“避免网络拥堵”这两个矛盾目标之间寻找平衡的过程。
7.2 拥塞的原因与代价
我们通过三个逐步深入的场景来分析拥塞的原因和它带来的代价。
7.2.1 场景一:无限缓冲与无重传
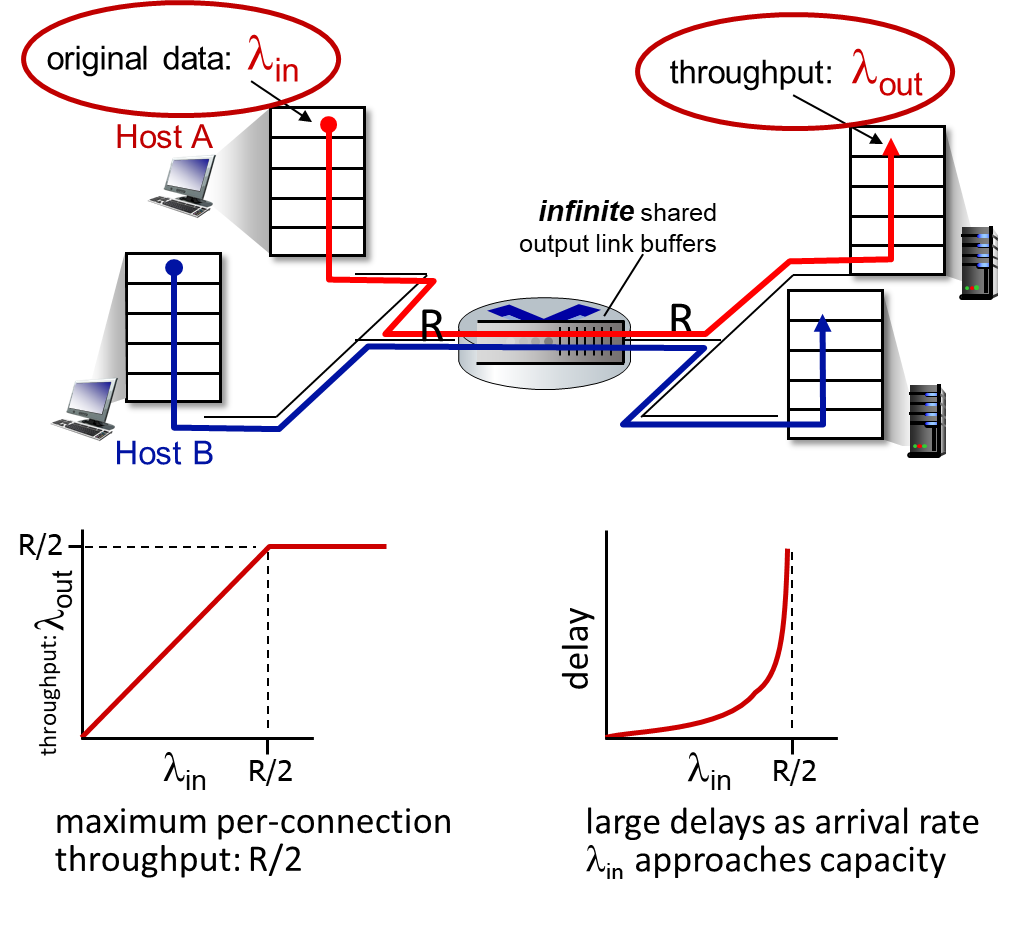
场景设置:
- 两个发送端(A, B)和两个接收端(C, D)。
- 所有数据都经过一个共享的路由器。
- 这个路由器的缓冲区是无限大的,意味着分组不会因为缓冲区溢出而丢失。
- 输出链路的总带宽为 R (bps),因此每个连接可用的最大带宽是 R/2。
- 此场景下没有重传机制。
分析:
-
从吞吐量(Throughput)角度看: 随着发送速率 的增加,接收端的接收速率 也会等比例线性增加。然而,当 达到链路容量的一半(R/2)时,吞吐量就达到了上限,无法再增加了。无论发送端再注入多少数据,输出速率都将稳定在 R/2。
-
从延迟(Delay)角度看: 当发送速率 逐渐接近链路容量 R/2 时,流量强度也随之接近1。此时,分组在路由器队列中的排队延迟会急剧增加,呈现出“陡增”的趋势。
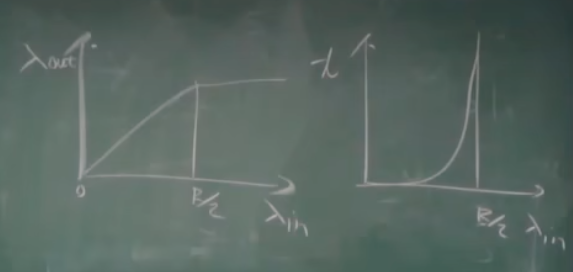
结论:这个场景揭示了拥塞的第一个表现——即使没有分组丢失,当网络负载接近其处理能力上限时,也会导致极大的延迟。
7.2.2 场景二:有限缓冲与有重传
场景设置:
- 与场景一类似,但路由器的缓冲区是有限的。
- 引入了超时重传机制。当发送方认为分组丢失时(例如超时),它会重新发送该分组。
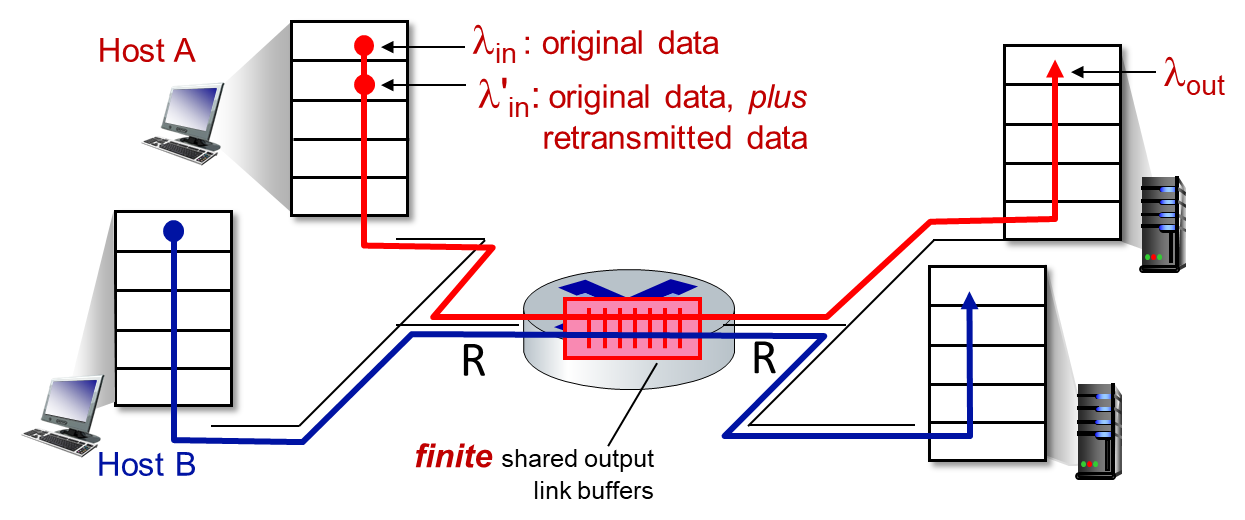
分析: 在这个场景下,我们需要区分两种输入速率:
- :应用层产生的原始数据的速率。
- :传输层向网络中注入数据的实际速率,它包含了原始数据和重传数据。因此,。
随着网络负载增加,丢包和延迟都会出现,导致重传增多, 会比 大得越来越多。
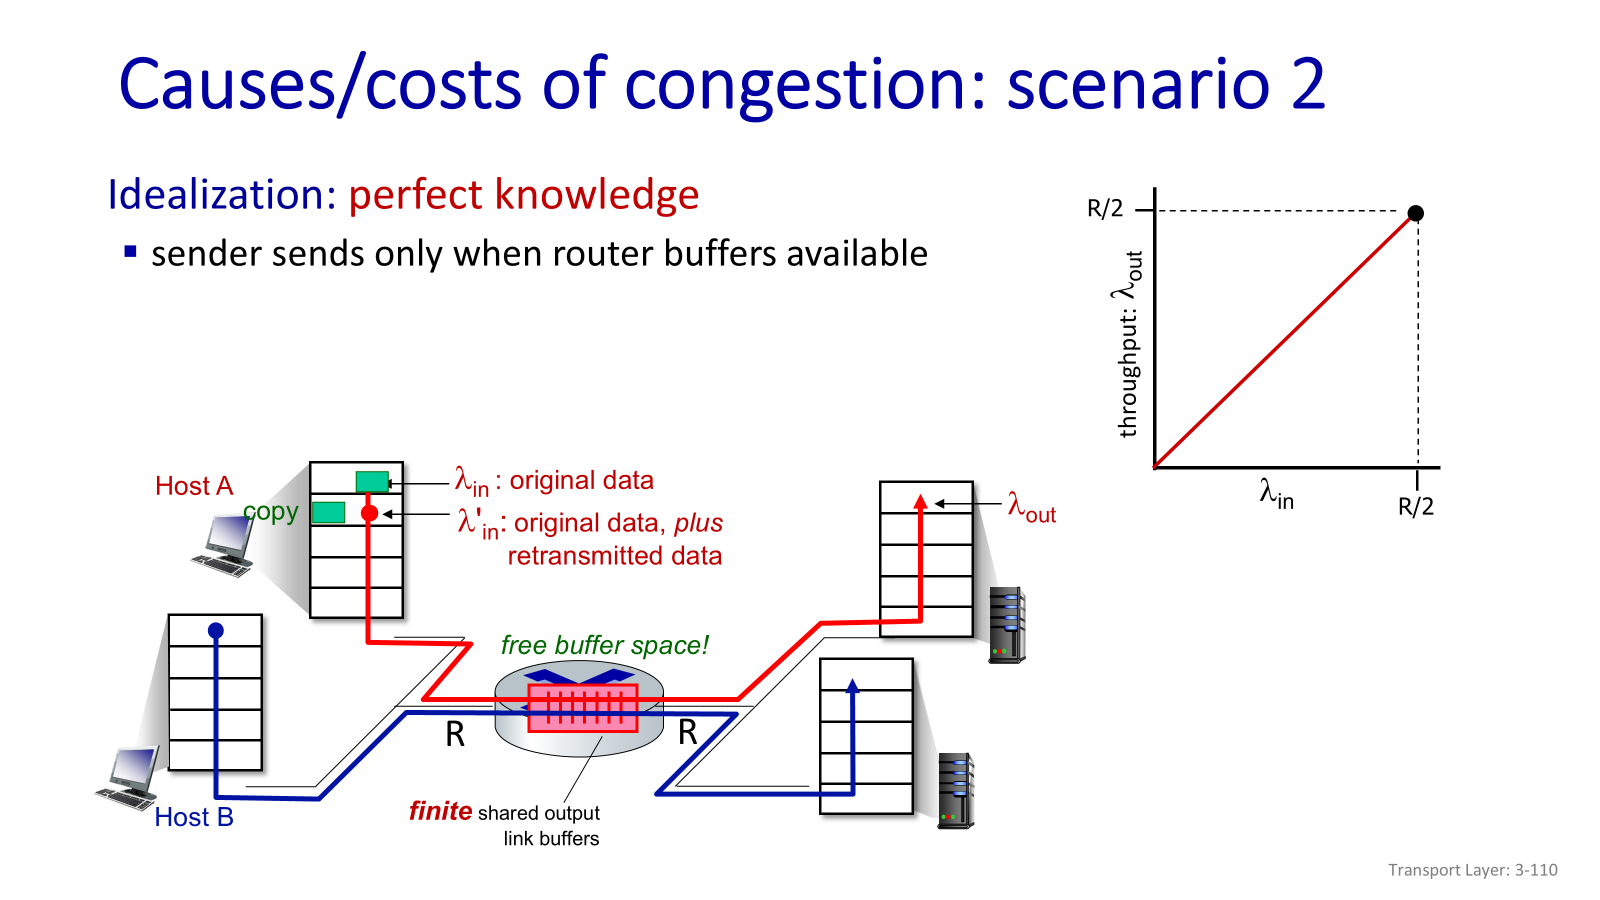
理想化情况: 老师首先介绍了一种理想化的情况:发送端能够“不可思议地”知道路由器缓冲区的空闲情况。只有在有空闲空间时才发送数据,这样就不会发生丢包,也就不需要重传。然而,这种假设在现实中是不可能实现的。
现实情况与代价: 在现实中,发送端无法预知路由器的状态,因此重传是不可避免的。这带来了新的代价:
-
代价一:网络效率降低,有效输出(Goodput)减少 由于重传的存在,网络中传输的流量 () 中有很大一部分是重复的分组。为了让接收端收到1个单位的有效数据,发送端可能需要向网络中注入1.2个、1.8个甚至更多单位的数据。
老师在这里用了一个形象的比喻:在一个无重力的星球上,用水管射水可以指哪打哪。但在有重力的地球上,为了击中目标,你必须把枪口抬高一些。同样,在拥塞的网络中,为了达到理想的有效输出(goodput),发送方必须付出更高的发送成本。
-
代价二:不必要的重传加剧拥塞 一个更严重的问题是,有时分组并没有真正丢失,只是在拥塞的路由器中经历了较长的延迟。然而,发送端的超时定时器已经到期,于是它重新发送了这个分组。
这种“不必要的重传”会向一个本已拥塞不堪的网络中注入更多的流量,从而使拥塞状况急剧恶化。老师强调,拥塞的恶化是一个非线性的过程,如果不加以控制,网络状况会加速变坏,很快就会变得无法使用。
7.2.2.1 图片模拟过程
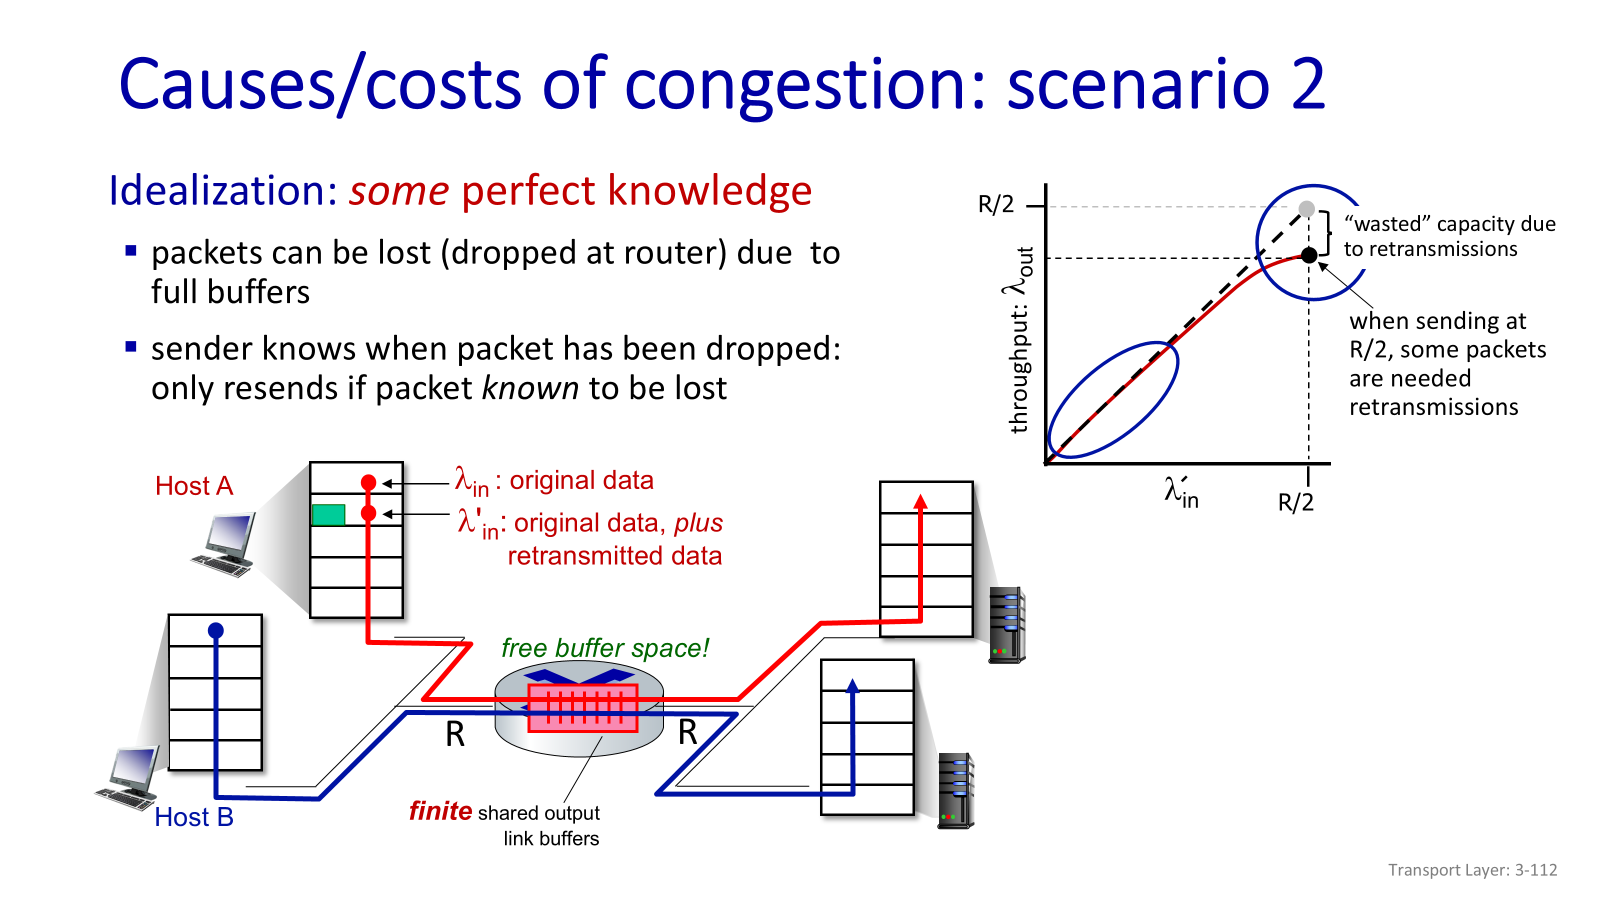
Idealization: perfect knowledge【发送端有完美的信息】
- sender sends only when router buffers available【只在缓冲可用时发送】
- no loss
Idealization: some perfect knowledge【掌握丢失信息】
- packets can be lost (dropped at router) due to full buffers
- sender knows when packet has been dropped: only resends if packet known to be lost
-
分组可以丢失,在路由器由 于缓冲器满而被丢弃
-
如果知道分组丢失了,发送方重传分组
当越接近,那么重传的比例越多,那么有效的输出速率也就越难达到同样的值

Realistic scenario: un-needed duplicates
- packets can be lost, dropped at router due to full buffers – requiring retransmissions
- but sender times can time out prematurely, sending two copies, both of which are delivered
- 分组可能丢失,由于缓冲器 满而被丢弃
- 发送端最终超时,发送第2 个拷贝,2个分组都被传出
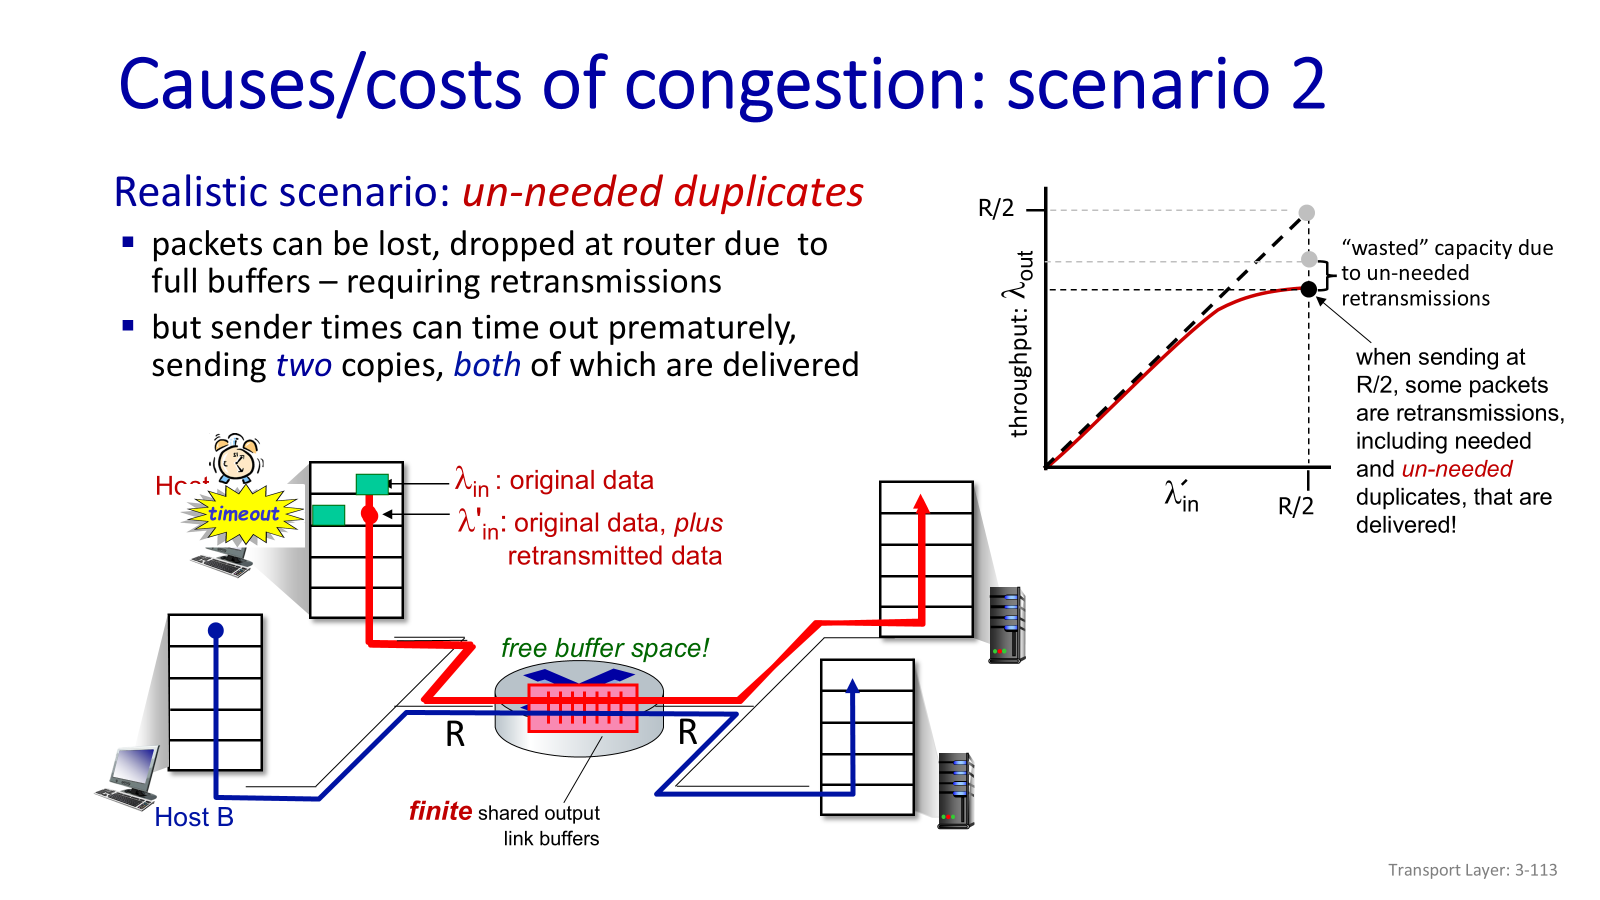
输出比输入少原因:
- 重传的丢失分组
- 没有必要重传的重复分组
“costs” of congestion:
- more work (retransmission) for given receiver throughput
- unneeded retransmissions: link carries multiple copies of a packet
- decreasing maximum achievable throughput
7.2.3 场景三:多跳路径与资源浪费
场景设置:
- 一个更复杂的网络拓扑,有多条路径和多个路由器。
- 例如,主机A向C发送数据(红色流量),需要经过两个路由器。
分析: 在严重拥塞的情况下,路由器的缓冲区基本上一直处于满的状态。当一个缓冲区位置空出来时,会立刻被新到达的分组填满。
考虑红色流量的路径:它成功通过了第一个路由器,消耗了该段链路的带宽资源。但当它到达第二个路由器时,可能因为该路由器的缓冲区被其他流量(例如绿色流量)占满而被丢弃。
代价三:上游传输能力的浪费
- 这个场景揭示了拥塞的另一个巨大代价:当一个分组在其中途的某个节点被丢弃时,所有在此之前为它传输数据所消耗的上游网络资源(如带宽、路由器处理能力)就全部被浪费了。在网络本就拥塞、资源极其宝贵的时候,这种浪费的后果尤为严重。
最终,网络可能陷入一种“死锁”状态:所有发送端都在拼命地向网络中注入数据,但由于中间节点的严重拥塞和丢包,最终没有任何有效数据能够成功到达接收端。网络有大量的输入,却没有输出。
7.2.3.1 图片解释
- 四个发送端:A→D,D→A,B→C,C→B(就是AD,BC相互连接)
- multi-hop paths
- timeout/retransmit
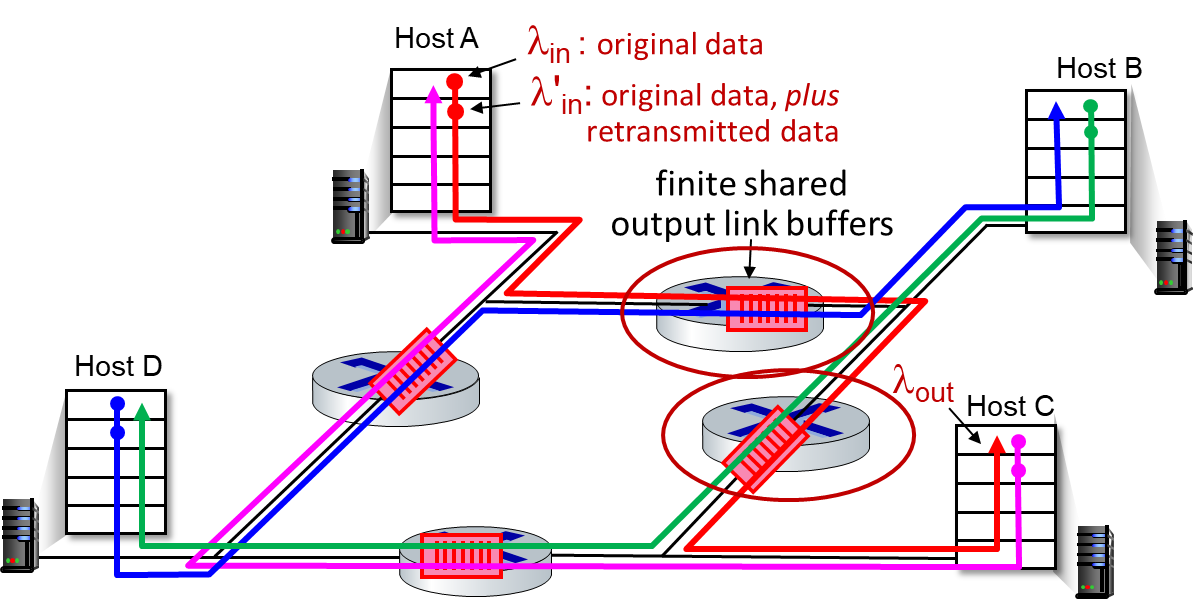
Q: what happens as and increase? A: as red increases, all arriving blue pkts at upper queue are dropped, blue throughput 0
- 当红色的增加时,所有到来的蓝色分组都在最上方的队列中丢弃了,蓝色吞吐→0
- 同理,绿色的也可能抢走红色的(在右边的路由器)
- 粉色的可能抢走绿色的(下边的路由器)
- 蓝色的抢走粉色的(左边的路由器)
- 总之,网络中 有输入,但是没有输出
another “cost” of congestion:
- when packet dropped, any upstream transmission capacity and buffering used for that packet was wasted!
 上面的左图中,右半部分 与 不为 的情况都是拥塞的情况
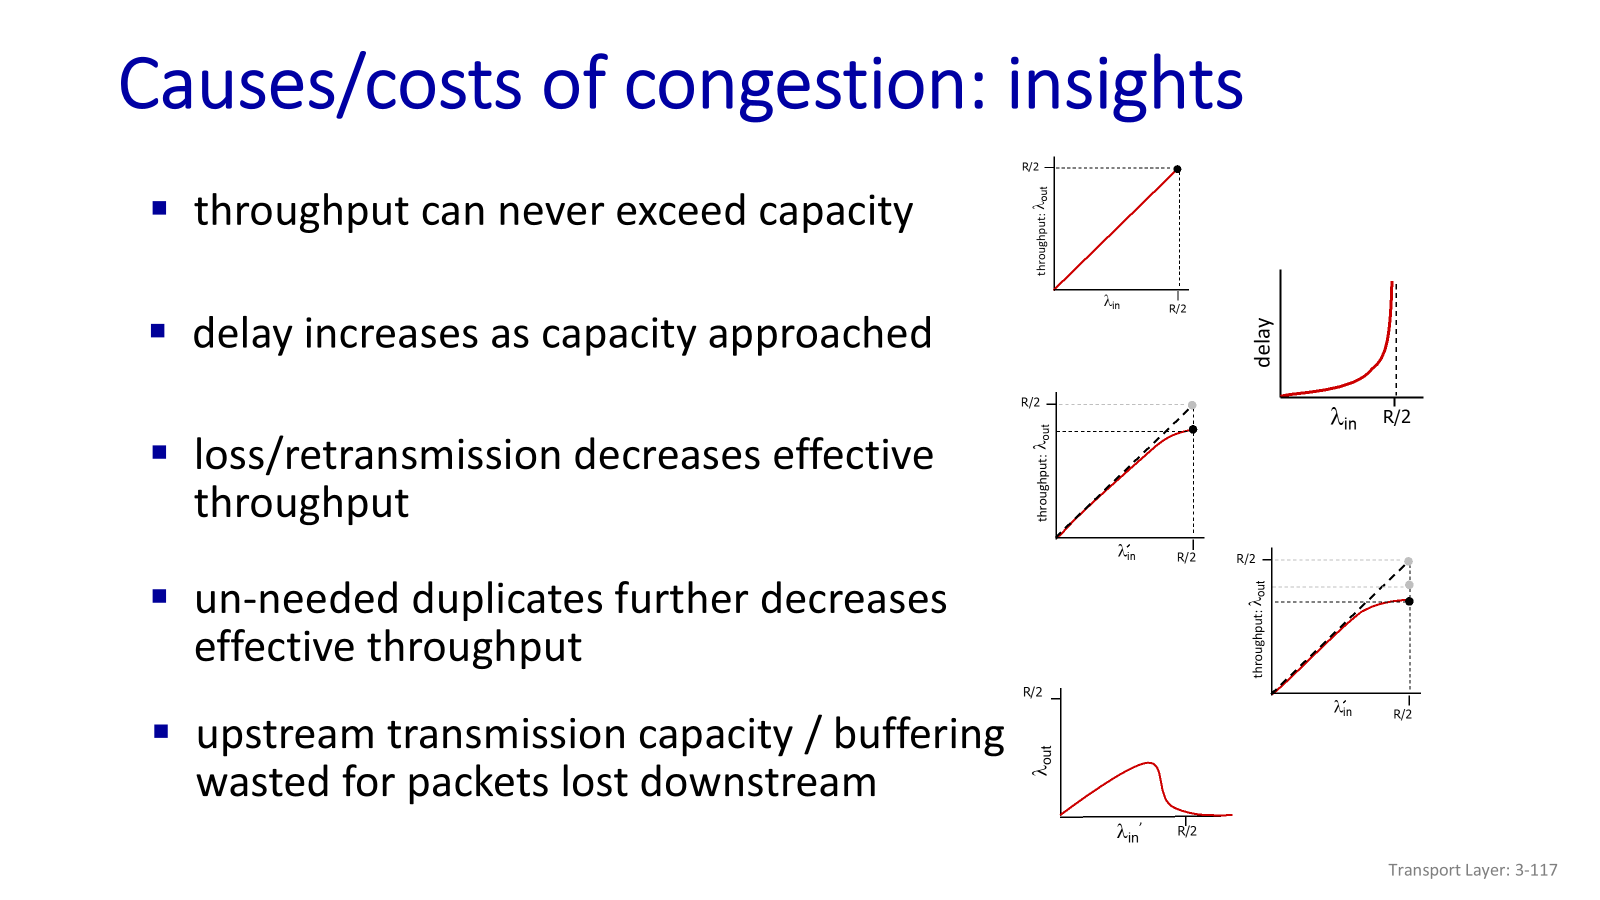
7.2.4 Causes/costs of congestion: insights
- throughput can never exceed capacity
- delay increases as capacity approached
- loss/retransmission decreases effective throughput
- un-needed duplicates further decreases effective throughput
- upstream transmission capacity / buffering wasted for packets lost downstream
- 延迟大
- 为了达到一个有效输出,网络需要更多的输入速率(重传)
- 没有必要的重传(加剧了网络的拥塞),链路中包括了多个分组的拷贝
- 是那些没有丢失,经历的时间比较长(拥塞状态)但是超时的分组
- 降低了的“goodput”
- 当分组丢失时,任何“关于这个分组的上游传输能力” 都被浪费了
7.3 拥塞控制方法
通常有两种主流的拥塞控制方法:
-
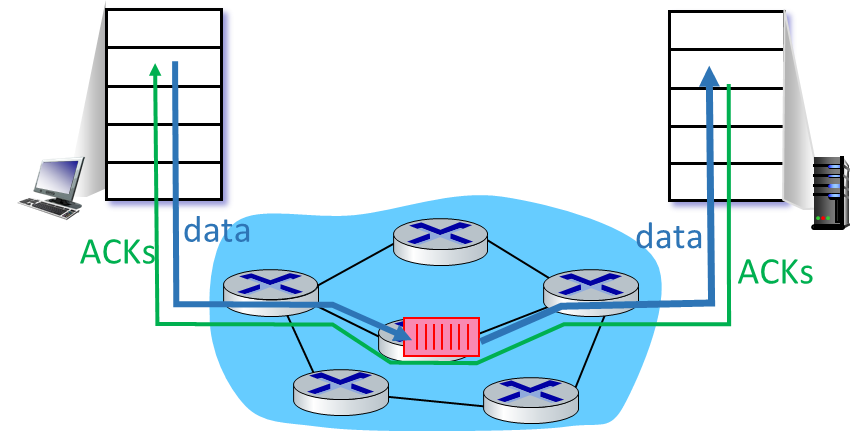
端到端拥塞控制 (End-to-end Congestion Control) 这种方法中,网络本身不提供任何关于拥塞状态的明确反馈信息。端系统(发送方)必须通过自己观察到的现象(如丢包和延迟增加)来推断网络是否发生了拥塞。TCP协议采用的就是这种方法。例如,当TCP发送方检测到超时或收到三个冗余的ACK时,它就认为网络发生了拥塞,并主动降低其发送速率。
-
网络辅助的拥塞控制 (Network-assisted Congestion Control) 在这种方法中,网络中的路由器或交换机会主动向端系统提供关于拥塞状态的反馈信息。这种反馈可以是:
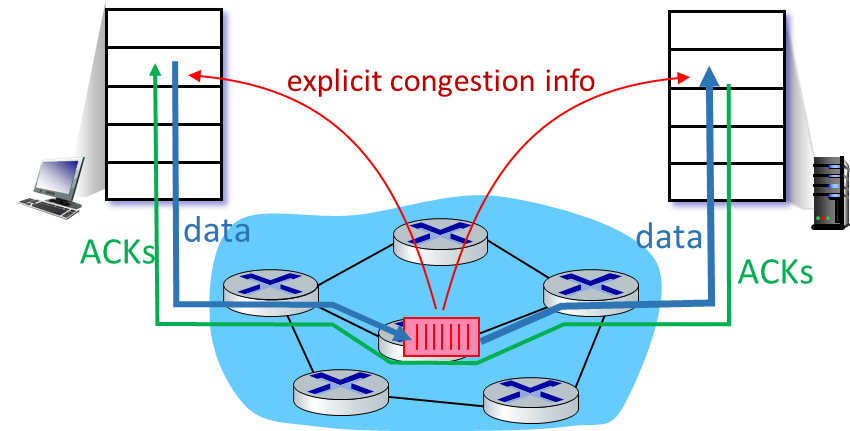
- 一个简单的拥塞指示位(例如,TCP/IP的ECN机制)。
- 一个明确的速率值,告知发送端应该以多快的速度发送数据。
英文版本的
End-end congestion control:
- no explicit feedback from network
- congestion inferred from observed loss, delay
- approach taken by TCP
Network-assisted congestion control:
- routers provide direct feedback to sending/receiving hosts with flows passing through congested router
- may indicate congestion level or explicitly set sending rate
- TCP ECN, ATM, DECbit protocols
7.4 案例学习:ATM ABR 拥塞控制
这里以ATM网络的ABR服务为例,介绍网络辅助的拥塞控制是如何工作的。
7.4.1 ATM网络简介与延迟特性
ATM(Asynchronous Transfer Mode,异步传输网络)是一种网络技术。它的数据传输单元被称为信元(cell),这是一种长度固定的小分组,总共53个字节(5字节头部 + 48字节数据)。
老师在这里特别对比了ATM与其它交换技术的延迟特性:
- 线路交换:在每个交换节点只延迟1个比特的传输时间,延迟非常小且固定。
- 分组交换:在每个节点需要存储并转发整个分组,由于分组大小可变且通常较大(可达数千字节),延迟也较大且不确定。
- 信元交换 (ATM):由于信元的大小(53字节)远小于普通分组但大于1比特,且长度固定,因此它在每个节点的存储转发延迟介于线路交换和分组交换之间。这种延迟是可预测且易于调度的。
正因为这些特性,ATM网络被认为同时具备了线路交换和分组交换的优点。虽然由于技术复杂等原因没有大规模普及,但在银行系统等一些专业领域仍有应用。
7.4.2 ABR服务与控制机制
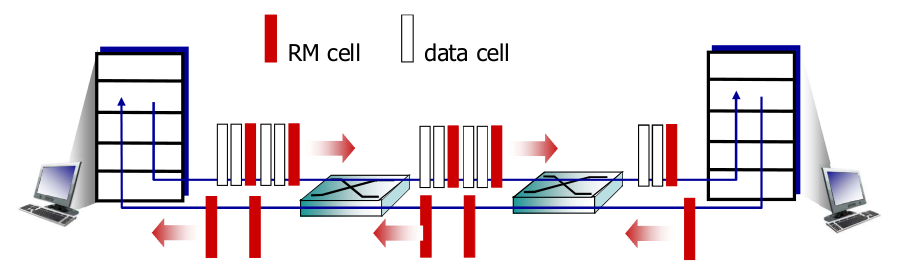
ABR(Available Bit Rate,可用比特率)是ATM提供的一种“弹性服务”。
- 网络轻载时:允许用户尽可能多地使用当前网络可用的带宽,甚至可以超过其协商的速率。
- 网络拥塞时:要求用户将其发送速率降低到一个最小保障速率以下。
ABR的拥塞控制是一种典型的网络辅助方法,它通过一种特殊的资源管理信元(RM cell) 来实现。
工作流程:
- 发送端在发送数据信元(data cell)的流中,会间隔性地插入RM信元。
- 这些RM信元会沿着数据路径到达接收端,然后由接收端再将其发回给发送端。
- 路径上的ATM交换机在转发RM信元时,会根据自身的拥塞状况修改其中的字段,从而向发送端提供反馈。
RM信元中的关键字段:
- NI (No Increase) bit:当交换机检测到轻微拥塞时,会将此位置1,告诉发送端“不要再增加速率了”。
- CI (Congestion Indication) bit:当交换机发生明确拥塞时,会将此位置1,指示发送端必须“降低速率”。
- ER (Explicit Rate) field:这是一个速率值字段。每个交换机都会检查这个字段的值,如果该值高于自己当前能支持的速率,交换机就会把它降低到自己能支持的水平。因此,当RM信元走完一圈回到发送端时,ER字段的值就代表了从源到目的地的整条路径上的瓶颈速率(即所有设备能支持的最小速率)。
通过这种机制,发送端可以非常精确地了解到整条路径的拥塞情况和可用的带宽,并据此来调整自己的发送速率,从而实现高效的拥塞控制。 好的,这是根据您提供的课堂录音文字稿和相关课件内容,为您整理的课堂笔记。笔记严格遵循了教师的授课顺序,并包含了所有要点、案例和补充说明。
8 TCP 拥塞控制
8.1 概述
TCP的拥塞控制是典型的端到端的拥塞控制。这意味着网络本身不提供任何关于拥塞的辅助信息。发送端和接收端这两个“端系统”需要依靠自己的测量和感知来判断网络路径上是否可能发生了拥塞。
如果端系统判断发生了拥塞,它就会主动降低发送速率;反之,如果没有拥塞,它就会尝试提高发送速率。
这种设计完全符合TCP/IP架构的核心原则:保持网络核心的简单性,将复杂的功能放在网络的边缘。网络核心只负责提供最基础的转发服务,而复杂的控制逻辑(如拥塞控制、流量控制)则由边缘主机上的传输层来完成。
8.1.1 拥塞控制的核心问题
要实现一个完整的拥塞控制机制,首先需要解决几个基本问题,这和我们学习其他控制理论是类似的。
-
如何检测拥塞? 我们需要有方法来判断网络是否发生了拥塞,甚至要能区分是“轻微拥塞”还是“严重拥塞”。
-
控制策略是什么?
- 拥塞发生时:当检测到拥塞(无论是轻微还是严重)时,应该如何降低发送速率?降低的幅度应该有所不同。
- 拥塞缓解时:当网络状况良好时,又该如何“跃跃欲试”地去增加发送速率,以尽可能地利用网络资源,提高数据吞吐量。
接下来,我们将围绕这两个核心问题展开讨论。
8.2 如何检测拥塞?
发送端主要通过两个关键事件来判断网络是否发生了拥塞。
8.2.1 1. 超时事件(代表严重拥塞)
当发送方发送的一个数据段(Segment)超时,即在规定的时间内没有收到确认(ACK),这被视为网络发生严重拥塞的一个明确信号。
- 主要原因:超时最可能的原因是,数据包在途经某个路由器时,由于该路由器的缓冲区已满,数据包被直接丢弃了。这是网络拥塞的典型表现。
- 次要原因(可能导致误判):数据包在物理链路上传输时,可能因为电磁干扰等原因导致比特出错(0变成1或1变成0)。这样的数据包在后续的链路层或IP层校验时会失败,从而被丢弃。
教师特别强调,虽然第二种情况(比特错误)并非由网络拥塞引起,但此时发送端降低速率是一种“误动作”。然而,在有线网络环境中,因拥塞导致丢包的概率远大于因传输错误导致丢包的概率。
因此,即使存在少量误判,TCP依然将“超时”统一认定为拥塞的标志。这种策略从整体上看是正确且有效的,不会影响拥塞控制的总体效果。
8.2.2 2. 三次重复的ACK(代表轻微拥塞)
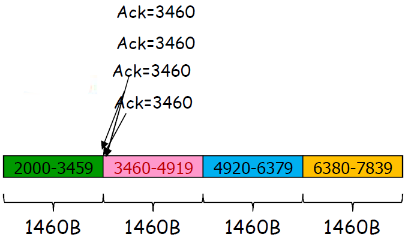
当发送方连续收到三个(或以上)对于同一个数据段的重复确认(Duplicate ACKs),这被视为网络发生轻微拥塞的信号。
我们来理解这个过程:
- 假设发送方连续发送了1、2、3、4、5号数据段。
- 接收方成功收到了1号段,于是回复一个ACK,表示“我已收到1,期待2”。
- 不幸的是,2号数据段在网络中丢失了。
- 随后,3号数据段抵达了接收方。由于2号还没到,接收方只能再次发送对1号段的ACK,即“我还是在等2号”。这是第1个重复ACK。
- 接着,4号数据段也到了。接收方继续发送对1号段的ACK。这是第2个重复ACK。
- 最后,5号数据段也到了。接收方再次发送对1号段的ACK。这是第3个重复ACK。
当发送方收到这总计(1个正常ACK + 3个重复ACK)后,它就能推断出:虽然2号段很可能丢失了,但它后面的3、4、5号段都成功抵达了。这说明网络并没有完全瘫痪,只是出现了一些不稳定的迹象。因此,这被认为是一种“轻微拥塞”。
8.3 TCP拥塞控制策略详解
- approach: senders can increase sending rate until packet loss (congestion) occurs, then decrease sending rate on loss event
Multiplicative decrease detail: sending rate is
- Cut in half on loss detected by triple duplicate ACK (TCP Reno)
- Cut to 1 MSS (maximum segment size) when loss detected by timeout (TCP Tahoe)
Why AIM*D?
- AIMD – a distributed, asynchronous algorithm – has been shown to:
- optimize congested flow rates network wide!
- have desirable stability properties
8.3.1 通过拥塞窗口(CongWin)控制发送速率
TCP管理网络拥塞的主要工具是拥塞窗口(Congestion Window,简称CongWin)。它是发送方维护的一个变量,用于限制发送方在任意时刻可处于“飞行中”(已发送但未确认)的数据包总量。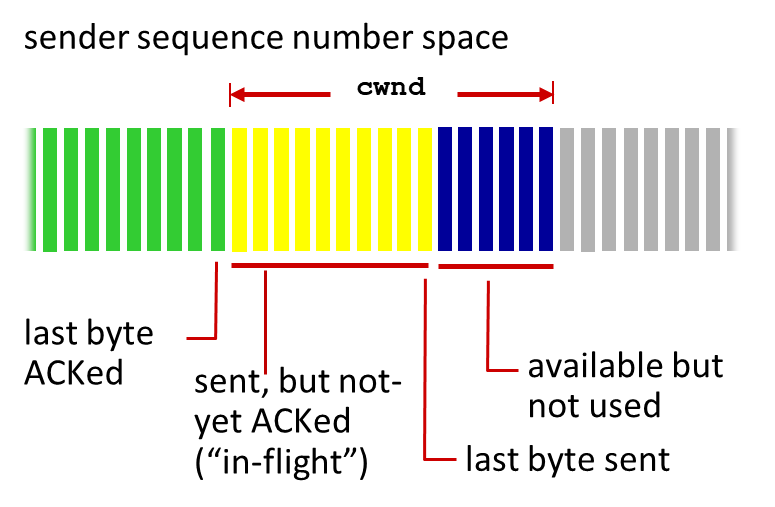
- 定义:
CongWin表示发送方在收到确认(ACK)之前,最多可向网络传输的字节数。 - 控制规则:发送方必须始终确保“飞行中”的数据量不超过拥塞窗口的大小,即:
- 近似发送速率:通过调整
CongWin的大小,TCP可大致控制其发送速率。该速率可近似表示为:
尽管这种控制并非绝对精确(因为往返时间RTT会波动),但借助TCP持续的反馈循环(接收ACK),它仍能有效工作
来自英语课件
TCP sending behavior:
- roughly: send
cwndbytes, wait RTT for ACKS, then send more bytesTCP rate bytes/sec
- TCP sender limits transmission:
cwndis dynamically adjusted in response to observed network congestion (implementing TCP congestion control)
8.3.2 总体策略:探测带宽容量
TCP的目标是在不引发拥塞的前提下,尽可能充分利用网络带宽。
- 慢启动(Slow Start)
- AIMD:线性增、乘性减少(Additive Increase, Multiplicative Decrease)
- 超时事件后的保守策略
8.3.2.1 2.1 策略一:慢启动(Slow Start,SS)
当连接刚建立时,TCP对网络可用带宽毫无了解,因此会以“谨慎启动、快速加速”的方式寻找合理的发送速率。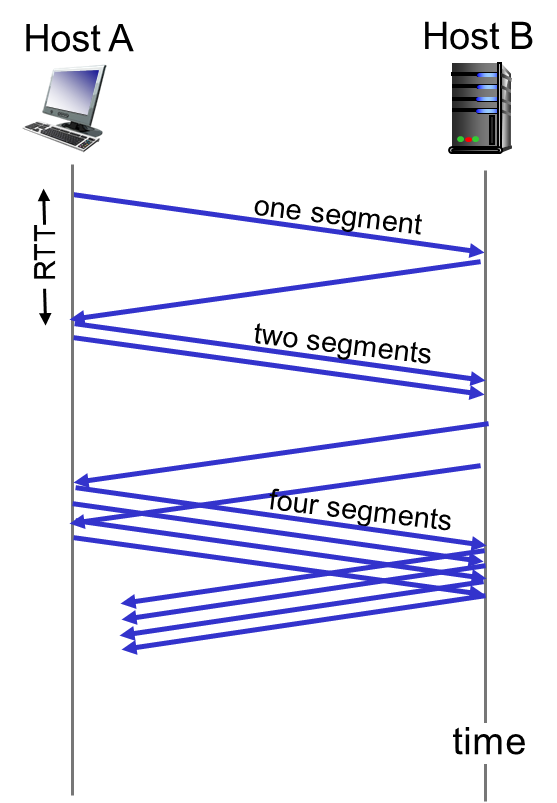
- 初始状态:
CongWin初始值设为较小值,通常为1个MSS(最大分段大小,Maximum Segment Size)。这会导致初始发送速率极低(例如,若MSS为1460字节、RTT为200毫秒,初始速率约为58.4 Kbps)。
因此,TCP需要一个机制来快速地探测并利用可用带宽,这个机制就是“慢启动”。
- 指数增长:为快速发现网络可用容量,
CongWin会呈指数级增长,两种表述方式等价:- 按RTT增长:每经过一个RTT,
CongWin就翻倍(1→2→4→8→16……)。 - 按ACK增长:每收到一个新的ACK,
CongWin就增加1个MSS。
- 按RTT增长:每经过一个RTT,
- 目的:初始速率虽慢,但增长呈指数级,能让TCP快速提升发送速率。然而,这种指数增长不可持续,最终必然导致数据包丢失——这意味着网络容量上限已被触及。
英文课件
- when connection begins, increase rate exponentially until first loss event:
- initially cwnd = 1 MSS
- double cwnd every RTT
- done by incrementing cwnd by 1 for every ACK received
- summary: initial rate is slow, but ramps up exponentially fast
指数增长的必然结果
教师用了一个经典故事来比喻指数增长的威力:国王与棋盘。一个农民请求国王在棋盘的第一个格子上放1粒米,第二个放2粒,第三个放4粒… 很快,整个国家的米都不够放。
同样地,任何网络都无法承受无限的指数级流量增长。因此,慢启动阶段最终必然会导致网络拥塞和数据包丢失,从而触发超时事件。
8.3.2.2 策略二:From slow start to congestion avoidance(拥塞避免)
Q: when should the exponential increase switch to linear?
A: when cwnd gets to 1/2 of its value before timeout.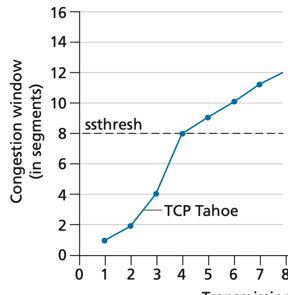
- variable ssthresh
- on loss event, ssthresh is set to 1/2 of cwnd just before loss event
- If cwnd >= ssthresh, switch to increase cwnd by 1 per RTT:
- Done by increasing cwnd by 1/cwnd per ACK received
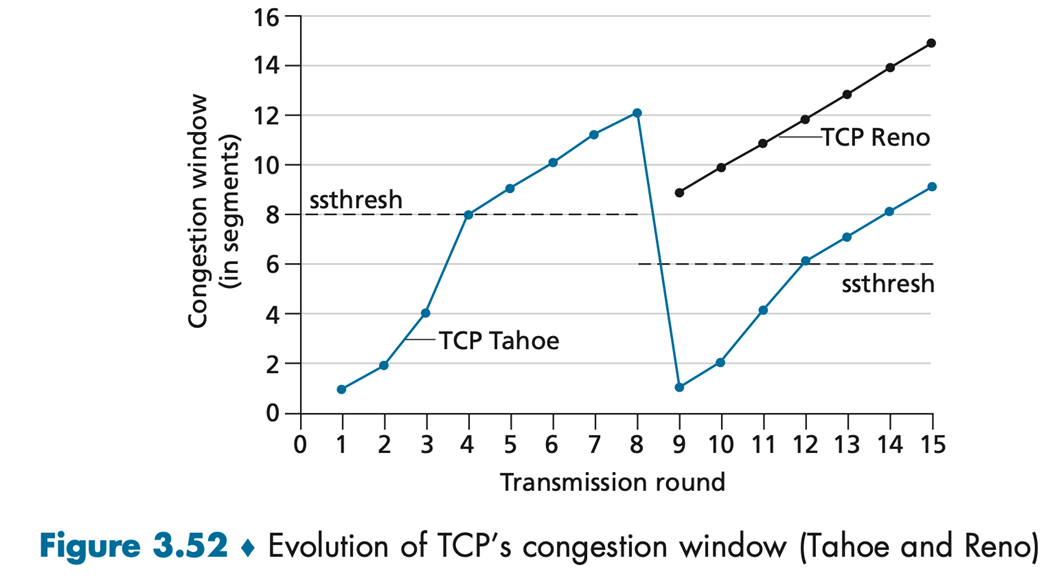
8.3.2.3 策略三:Detecting, reacting to loss;Fast Recovery(拥塞检测;快速恢复)
Case1:loss indicated by timeout:
cwndset to 1 MSS;- Go back to slow start phase;
- window then grows exponentially (as in slow start) to threshold, then grows linearly
Case2:loss indicated by 3 duplicate ACKs:
- TCP Tahoe
- always sets
cwndto 1 (timeout or 3 duplicate acks)
- always sets
- TCP RENO
- dup ACKs indicate network capable of delivering some segments
cwndis cut in half, and added by 3, then grows linearly. This is called Fast Recovery(快速恢复).
8.3.2.4 AIMD法则
一旦TCP对网络容量有了大致了解,就会切换到更保守的策略,以“温和探测”的方式尝试获取更多带宽。这种行为由AIMD(加法增、乘法减,Additive Increase, Multiplicative Decrease) 原则定义。
- 加法增(Additive Increase,AI):当网络未出现拥塞(即ACK正常到达)时,TCP会谨慎地让
CongWin呈线性增长。在拥塞避免阶段,这意味着每经过一个RTT,CongWin增加1个MSS。这正是TCP发送速率“锯齿形”变化中“探测”的部分。【比如我们在一个RTT内发了10个包,则收到一个包的ACK则增加1/10个cwnd】 - 乘法减(Multiplicative Decrease,MD):当检测到拥塞事件(数据包丢失)时,TCP会大幅降低发送速率——将
CongWin按乘法因子缩减(通常减半)。这种快速退避对迅速缓解网络压力至关重要。
这种持续的“线性增加、减半下降”的过程,使得CongWin的变化曲线在宏观上呈现出一种锯齿形。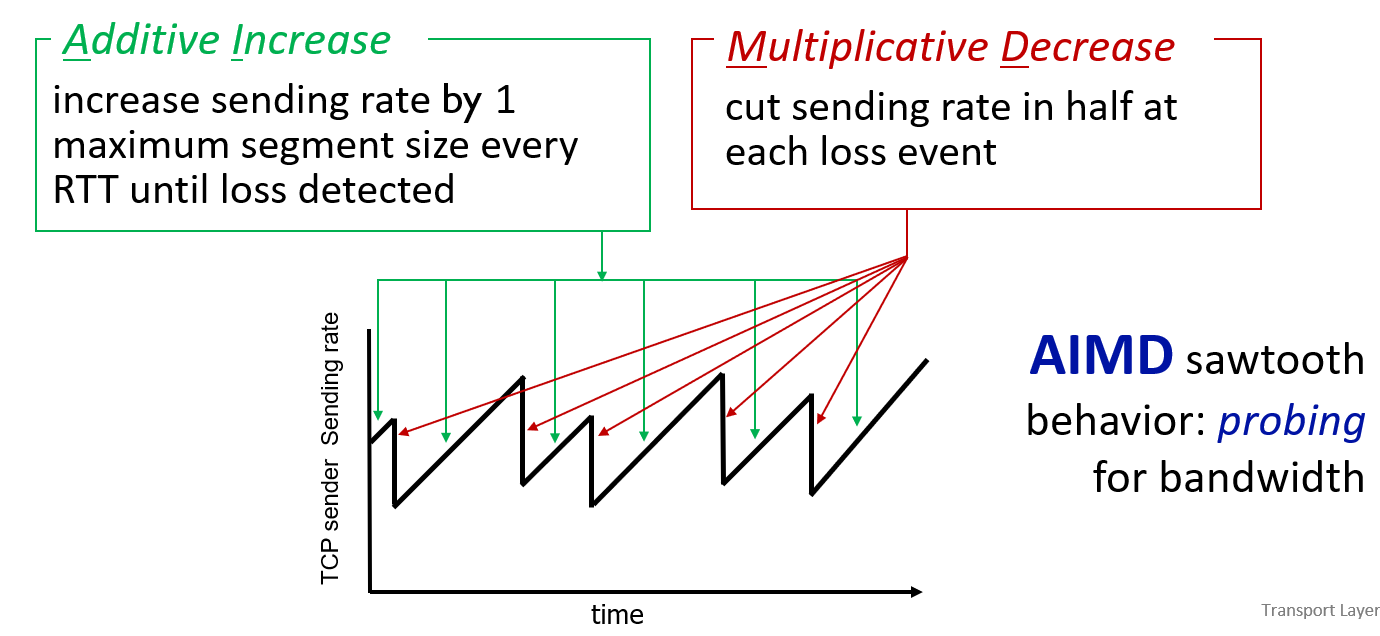
AIMD sawtooth behavior: probing for bandwidth
8.3.2.5 中文总结
TCP通过一个名为慢启动阈值(Slow Start Threshold,简称ssthresh) 的变量,决定何时从激进的“慢启动”阶段切换到保守的“拥塞避免”阶段。其逻辑通过对网络事件的特定响应来实现。
我们可以用“酒精耐受度探测”的类比来理解:
- 慢启动:给客人递酒的量呈指数级增加(1杯、2杯、4杯、8杯),以快速找到其酒量上限。
- 超时(“喝晕”):客人喝太多(如16杯)后晕过去——这是严重事件。你知道其酒量上限低于16杯,于是将“警告阈值”(
ssthresh)设为该量的一半(8杯),下次再从1杯开始谨慎尝试。 - 3次重复ACK(“微醺”):客人喝到一定量(如12杯)后开始摇晃——虽未晕,但已明显接近酒量上限,这是轻微拥塞信号。你会立即减少递酒量(如减半至6杯),之后从这个量开始,每次只加1杯(线性增长)。
该类比可直接映射到TCP的行为,具体如下表所示:
| 网络事件 | TCP的响应 | 新状态 |
|---|---|---|
| 超时(严重拥塞) | 1. 将ssthresh设为CongWin / 2;2. 将 CongWin重置为1个MSS;3. 重置重复ACK计数。 | 慢启动(SS) |
| 3次重复ACK(轻微拥塞) | 1. 将ssthresh设为CongWin / 2;2. 将 CongWin设为ssthresh + 3个MSS(这是“快速恢复”机制的一部分);3. 重传丢失的分段。 | 拥塞避免(CA) / 快速恢复 |
收到新ACK且CongWin < ssthresh | CongWin = CongWin + 1个MSS(实际效果为每RTT翻倍) | 慢启动(SS) |
收到新ACK且CongWin ≥ ssthresh | CongWin = CongWin + MSS * (MSS/CongWin)(实际效果为每RTT增加约1个MSS) | 拥塞避免(CA) |
CongWin 的值是根据网络状况动态变化的。
-
当检测到拥塞时(超时或3个重复ACK),
CongWin会下降。- 发生超时(严重拥塞):
CongWin会被迅速降为1个MSS(最大报文段长度),然后进入一个名为**慢启动(Slow Start, SS)**的阶段。在这个阶段,CongWin会以指数方式增长(每个RTT翻倍)。 - 收到3个重复ACK(轻微拥塞):
CongWin会减为当前值的一半 (CongWin / 2),然后进入一个名为**拥塞避免(Congestion Avoidance, CA)**的阶段。
- 发生超时(严重拥塞):
-
当网络正常时(正常收到ACK),
CongWin会“跃跃欲试”地增加。- 在慢启动(SS)阶段:
CongWin每经过一个RTT就加倍,实现指数级增长。 - 在拥塞避免(CA)阶段:
CongWin每经过一个RTT只增加一个MSS的大小,实现线性增长。
- 在慢启动(SS)阶段:
8.3.2.6 状态机示意
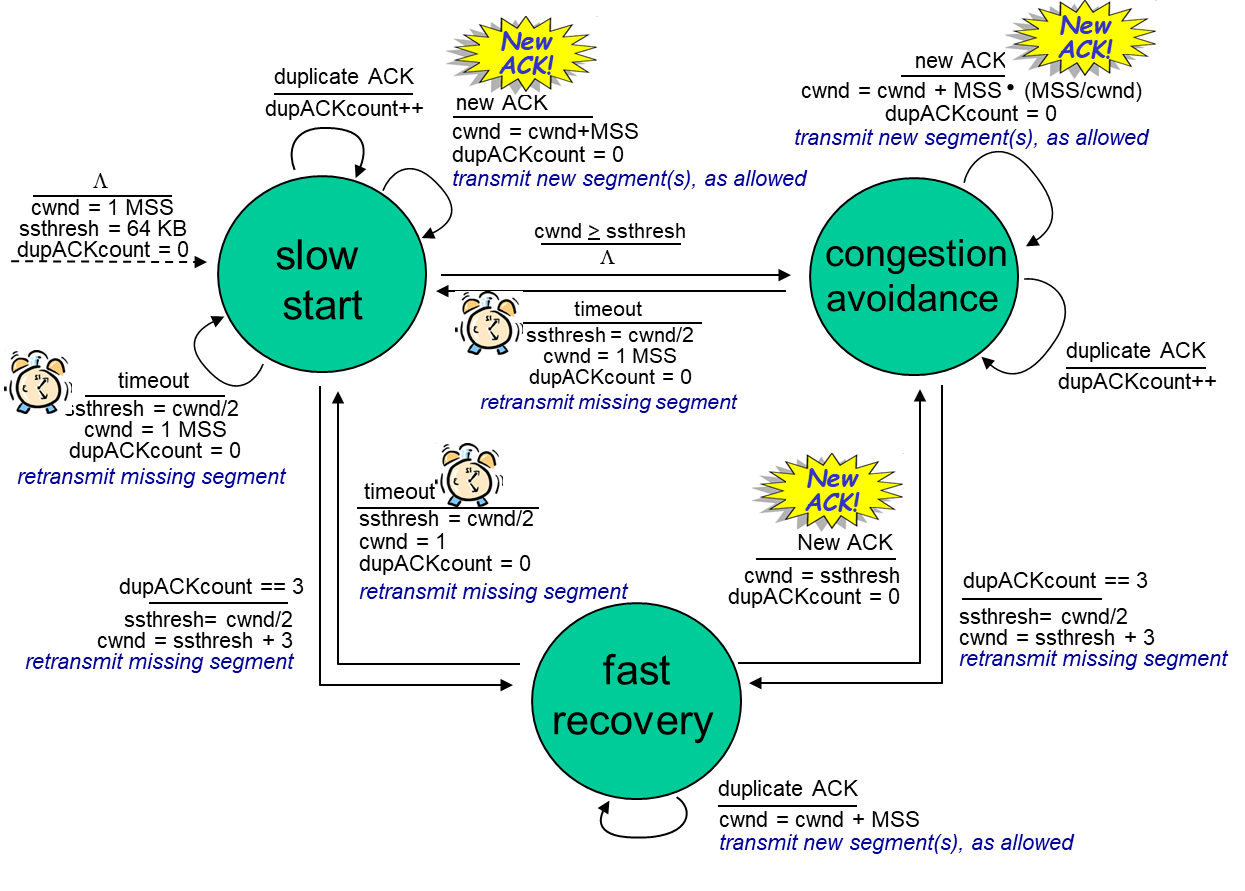
| 事件 | 当前状态 | TCP发送端行为 |
|---|---|---|
| 收到新的ACK | 慢启动 (SS) <br/> CongWin < Threshold | CongWin = CongWin + MSS <br/> (效果是每RTT翻倍) |
| 收到新的ACK | 拥塞避免 (CA) <br/> CongWin > Threshold | CongWin = CongWin + MSS * (MSS/CongWin) <br/> (效果是每RTT增加约1个MSS) |
| 收到3个重复ACK | SS 或 CA | Threshold = CongWin / 2 <br/> CongWin = Threshold + 3 <br/> (直接进入CA阶段) |
| 发生超时 | SS 或 CA | Threshold = CongWin / 2 <br/> CongWin = 1 MSS <br/> (进入SS阶段) |
| 收到1或2个重复ACK | SS 或 CA | 仅增加重复ACK计数器,CongWin和Threshold不变,为触发“3个重复ACK”事件做准备。 |
这套规则构成了TCP拥塞控制的有限状态机(FSM),指导着发送端在不同网络状况下的行为。 好的,这是一份根据您提供的教材内容整理的课堂笔记。笔记严格按照内容的讲述顺序编排,并包含了所有的引言和拓展信息。
8.3.3 TCP CUBIC
-
Is there a better way than AIMD to “probe” for usable bandwidth?
-
Insight/intuition:
- : sending rate at which congestion loss was detected
- congestion state of bottleneck link probably (?) hasn’t changed much
- after cutting rate/window in half on loss, initially ramp to to faster, but then approach more slowly
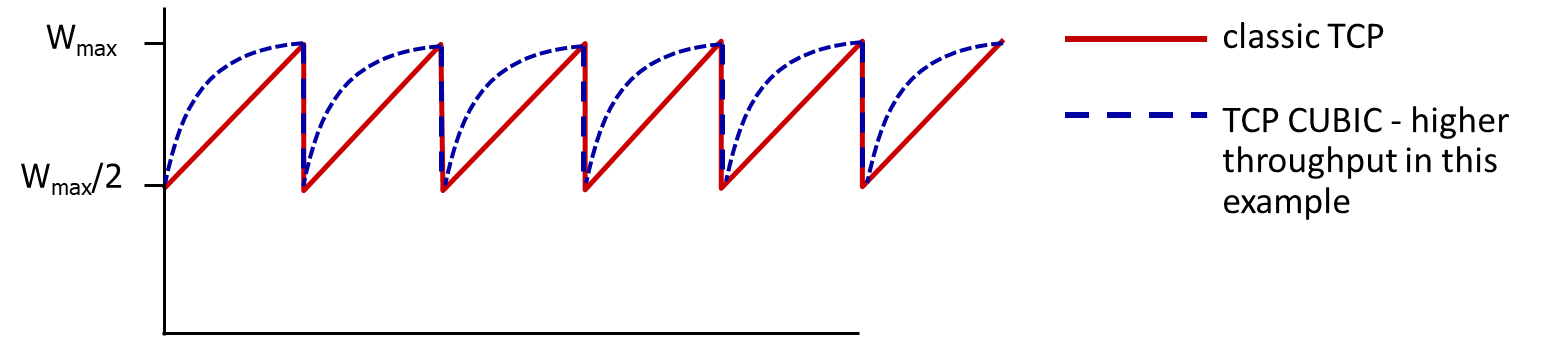
-
K: point in time when TCP window size will reach
- K itself is tuneable
-
increase W as a function of the cube of the distance between current time and K
- larger increases when further away from K
- smaller increases (cautious) when nearer K
-
TCP CUBIC default in Linux, most popular TCP for popular Web servers
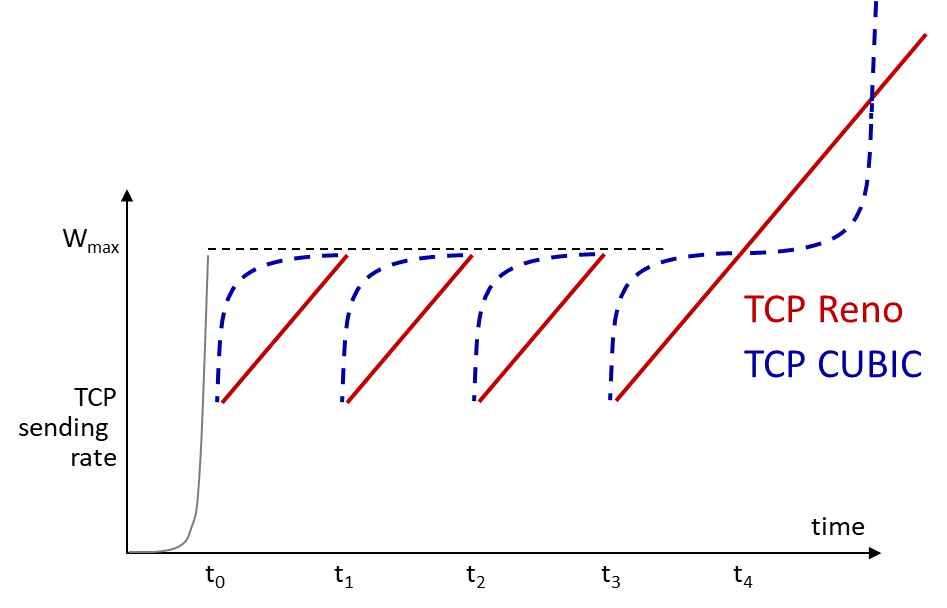
- 定义 W_max:
让
W_max成为 TCP 在“上次检测到丢包时”的拥塞控制窗口大小。 - 定义 K:
让
K成为一个“未来的时间点”。假设没有丢包,CUBIC 的窗口大小将在K时刻再次达到W_max。 - (拓展内容) 有一些“可调的 CUBIC 参数”会决定协议窗口达到
W_max的速度(即K的值)。 - 窗口增长函数:
CUBIC 将拥塞窗口的增长设置为一个关于“当前时间
t”和“目标时间K”之间距离的“立方 (cube)”函数。 - 函数行为(t 接近 K 之前):
当
t远未达到K时(tis further away fromK),窗口大小的增长“非常大”。 当t接近K时,窗口大小的增长会变小。 - 函数效果:
这使得 CUBIC 能够“快速地”爬升到接近丢包前的速率
W_max。 在接近W_max时,它会“谨慎地探测”带宽。 - 函数行为(t 大于 K 时):
当
t大于K时(即超过了预计达到原最大窗口的时间):- 如果
t仍然接近K,立方规则使得窗口增长“很小”。 - 这种“小增长”是好的,前提是“导致丢包的链路拥塞水平没有太大变化”。
- 如果
t继续增大并“超过 K”,窗口会“快速增加”。 - 这种“快速增加”允许 CUBIC 在链路拥塞水平发生显著变化时,“更快地找到新的操作点”。
- 如果
8.3.4 拥塞控制与流量控制的结合
最后需注意,TCP的拥塞控制并非独立运作,它会与流量控制协同工作——流量控制由接收窗口(Receiver Window,简称RecvWin) 管理。
CongWin:反映网络的容量上限。RecvWin:反映接收方的可用缓冲区空间上限。
发送方必须同时遵守这两个限制,因此其实际允许发送的数据量(即可用的发送窗口,SendWin)为两者中的较小值,即:
这一机制确保发送方的传输速率既受限于网络可用带宽,也受限于接收方处理 incoming 数据的能力。
好的,这是根据您提供的最后一部分课堂录音文字稿和相关课件,为您整理的收尾笔记,包括TCP吞吐量、公平性分析以及完整的第三章总结。
8.4 TCP 的平均吞吐量
8.4.1 TCP throughput TCP的吞吐量
在理解了TCP的拥塞控制机制后,我们可以估算其平均吞吐量。
- 基本模型:我们主要关注拥塞避免阶段的行为,因为慢启动阶段由于其指数级增长的特性,持续时间非常短,在长连接中可以忽略不计。
- 窗口变化:在拥塞避免阶段,拥塞窗口
CongWin的大小在一个“锯齿”周期内,从W/2线性增长到W(W是发生丢包事件时的窗口大小)。 - 平均窗口大小:一个周期内的平均窗口大小是其最小值和最大值的平均值,即:
- 平均吞吐量公式:吞吐量是在单位时间内传输的数据量。在一个RTT内,TCP可以发送一个窗口的数据。因此,平均吞吐量可以表示为:
这个公式简洁地描述了由TCP拥塞控制决定的平均数据传输速率。
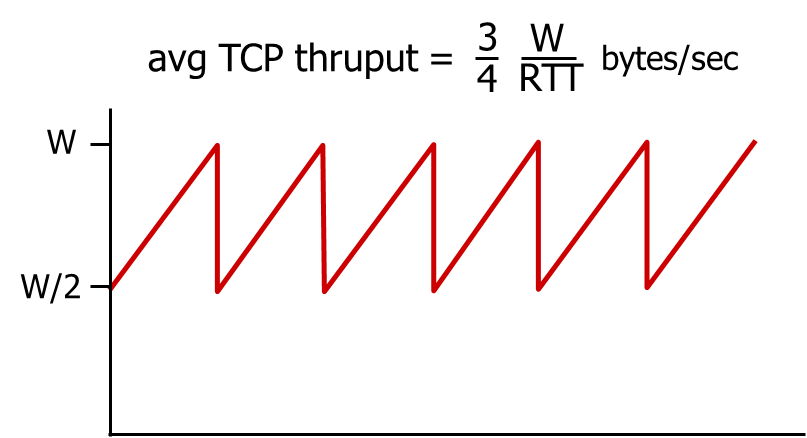
- avg. TCP thruput as function of window size, RTT?
- ignore slow start, assume there is always data to send
- W: window size (measured in bytes) where loss occurs
- avg. window size (# in-flight bytes) is ¾ W
- avg. thruput is 3/4W per RTT
8.4.2 TCP throughput in terms of segment loss rate
- 例如: 1500字节/段, 100ms RTT(往返延迟R=200ms), 如果需要10 Gbps 吞吐量
- T=0.75W/R → 0.75W=TR=12.5MB=83333段【w表示窗口长度】
- 平均需要窗口大小 0.75W = 83,333 in-flight 在传段
- 吞吐量用丢失率表示:
- → L = 2·10⁻¹⁰ (为了达到10Gbps的吞吐,平均50亿段丢失一个) 非常非常小的丢失率!可能远远低于链路的物理丢失率,达不到的
- 如果需要网络带宽增加到未来可用的10Gbps,那就需要更新的TCP版本!
- avg. TCP throuput as function of MSS, and segment loss rate L?
- ignore slow start, assume there is always data to send
- W: window size (measured in segments) where loss occurs
- avg. window size is ¾ W
- avg. throuput is 3/4W per RTT avg TCP thruput bytes/sec
8.4.2.1 TCP over “long, fat pipes”
- Networks with large bandwidth-delay products are called “long fat networks (LFNs)”, e.g. satellite networks
- example: 1500 byte segments, 100ms RTT, want 10 Gbps throughput
- requires W = 83,333 in-flight segments
- throughput in terms of segment loss probability, L [Mathis 1997]: TCP thruput → to achieve 10 Gbps throughput, need a loss rate of L = 2·10⁻¹⁰ - a very small loss rate!
- Not a big concern now in general: new versions/features of TCP (e.g. CUBIC, SACK, etc.) handles the long, high-speed scenarios much better now.
8.4.3 TCP and the congested “bottleneck link”
- TCP (classic, CUBIC) increase TCP’s sending rate until packet loss occurs at some router’s output: the bottleneck link
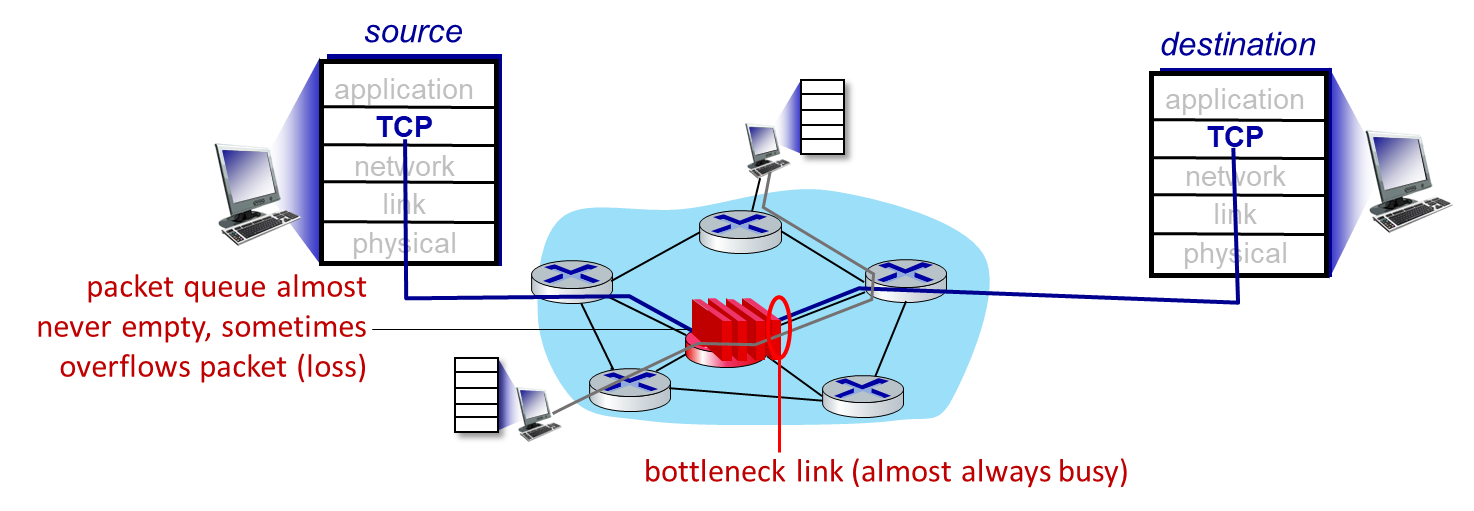
- understanding congestion: useful to focus on congested bottleneck link
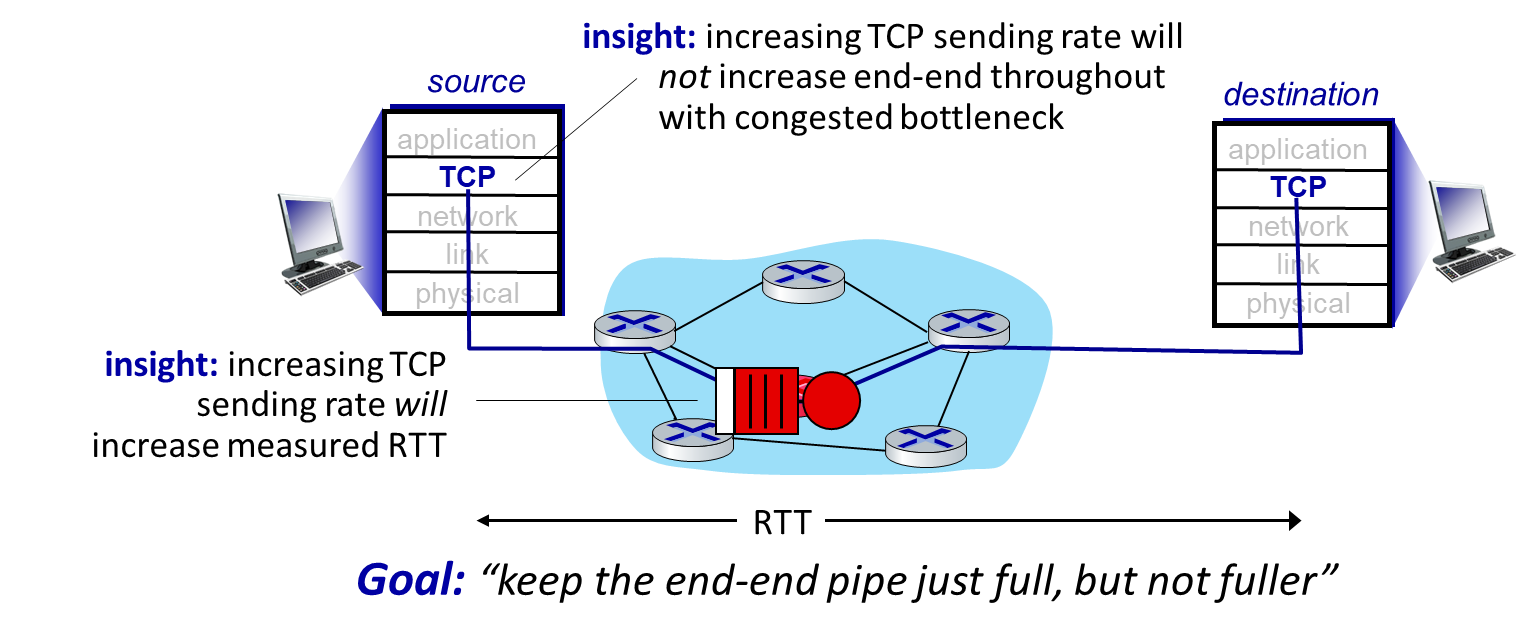
8.4.3.1 Delay-based TCP congestion control
Keeping sender-to-receiver pipe “just full enough, but no fuller”: keep bottleneck link busy transmitting, but avoid high delays/buffering Delay-based approach:
- - minimum observed RTT (uncongested path)
- uncongested throughput with congestion window
cwndiscwnd/
if measured throughput "very close" to uncongested throughput
      increase `cwnd` linearly /* since path not congested */
  else if measured throughput "far below" uncongested throughout
decrease `cwnd` linearly /* since path is congested */- congestion control without inducing/forcing loss
- maximizing throughout (“keeping the just pipe full… ”) while keeping delay low (“…but not fuller”)
- a number of deployed TCPs take a delay-based approach
- BBR (“Bottleneck Bandwidth and Round-trip propagation time”) deployed on Google’s (internal) backbone network
8.4.3.2 Explicit congestion notification (ECN)
TCP deployments often implement network-assisted congestion control:
- two bits in IP header (ToS field) marked by network router to indicate congestion
- policy to determine marking chosen by network operator
- congestion indication carried to destination
- destination sets ECE bit on ACK segment to notify sender of congestion
- involves both IP (IP header ECN bit marking) and TCP (TCP header C,E bit marking)
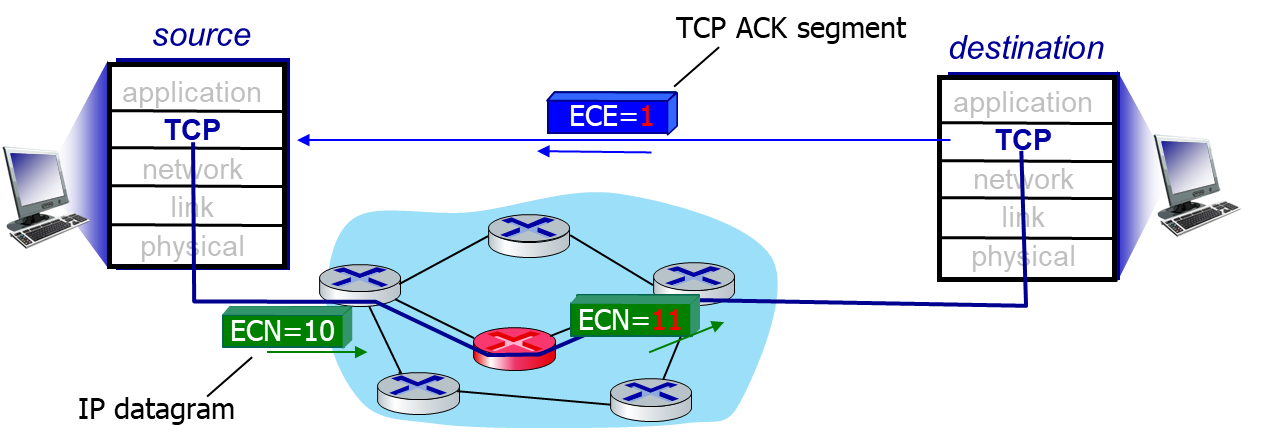
8.5 TCP 的公平性
8.5.1 什么是公平性?
公平性的目标是:如果 K 个TCP连接共同分享一个带宽为 R 的瓶颈链路,那么从长期来看,每个连接都应该获得大约 R/K 的带宽。
Fairness goal: if TCP sessions share same bottleneck link of bandwidth , each should have average rate of
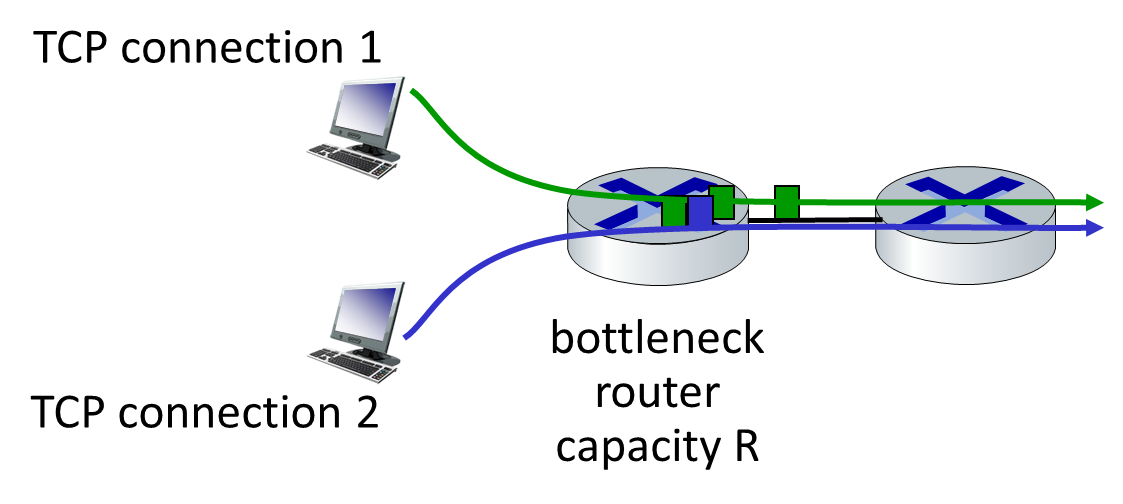
8.5.2 为什么TCP是公平的?
Q: is TCP Fair? Example: two competing TCP sessions:
- additive increase gives slope of 1, as throughout increases
- multiplicative decrease decreases throughput proportionally
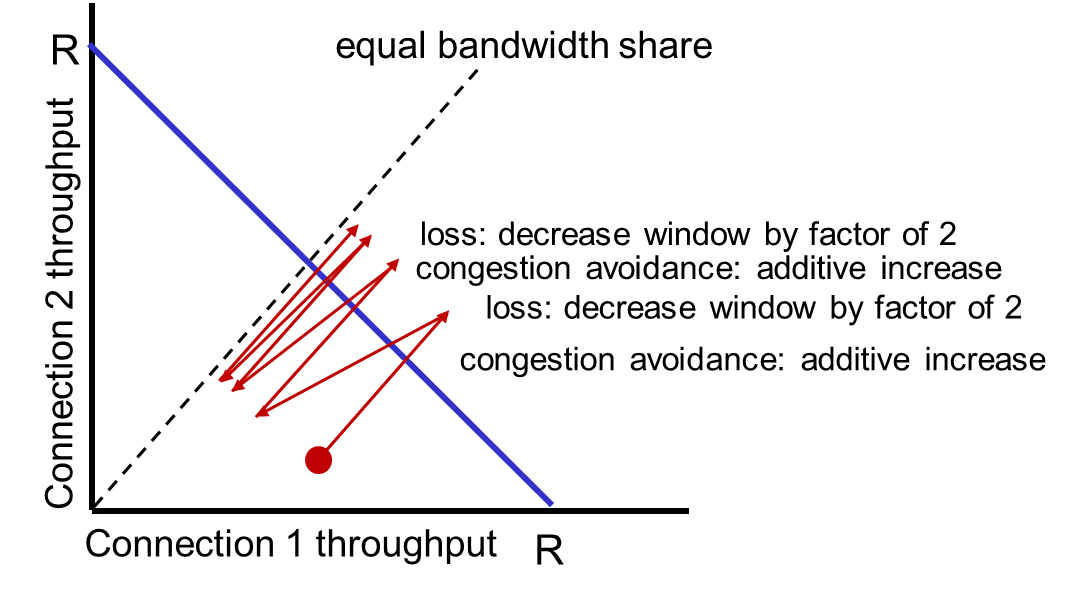
A: Yes, under idealized assumptions:
- same RTT
- fixed number of sessions only in congestion avoidance
教师通过一个两个连接(连接1和连接2)竞争一个瓶颈链路的例子,并使用二维图来解释其原理。
- 坐标系: X轴代表连接1的吞-吐量,Y轴代表连接2的吞吐量。图中有一条斜线
X + Y = R,代表带宽被完全利用。 - 增窗阶段 (Additive Increase):当总吞吐量
X + Y < R时,两个连接都处于拥塞避免阶段。每经过一个RTT,它们各自的窗口都会增加1个MSS。在图上,这个过程表现为状态点沿着45度角的方向向外移动。 - 丢包与减窗 (Multiplicative Decrease):当状态点越过
X + Y = R的线后,网络发生拥塞,两个连接都会经历丢包。此时,它们各自会将拥塞窗口减半。在图上,这个过程表现为状态点沿着一条从原点出发穿过当前点的直线,向原点方向回退一半。 - 收敛过程:这个“沿45度角增加,沿原点方向减半”的循环过程,会使得两个连接的吞吐量不断地向
X = Y这条对角线收敛。最终,两个连接会获得近似相等的带宽,从而实现了公平性。
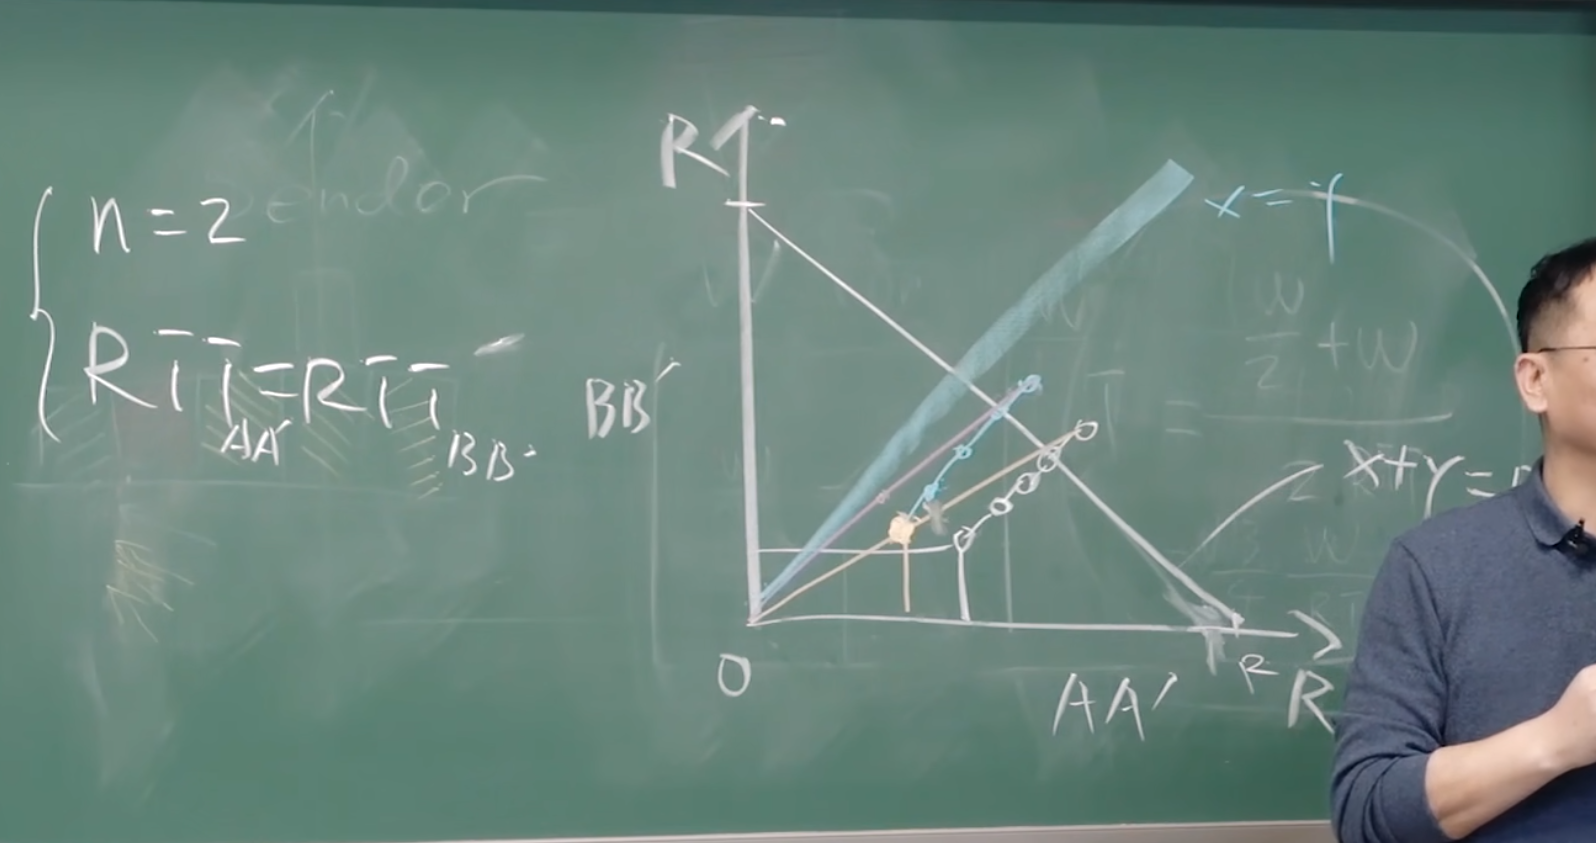
8.5.3 公平性的局限性 must all network apps be “fair”?
教师强调,TCP的公平性是“大致公平”,并非在所有情况下都绝对公平。
- 与UDP竞争不公平:UDP协议没有拥塞控制机制,它会以应用程序设定的速率持续发送数据,不会在网络拥塞时主动减速。这种“侵略性”行为会抢占TCP连接的带宽,因此UDP对TCP是不友好的。
- 并行连接导致的不公:TCP的公平性是针对单个连接而言的,而不是主机。如果主机A建立1个TCP连接,而主机B与同一目标建立了9个TCP连接,那么在瓶颈链路上,主机B总共会获得90%的带宽,而主机A只有10%。
- 不同RTT导致的不公:在加性增阶段,窗口增加的频率是“每个RTT增加1个MSS”。RTT较短的连接,其窗口增长得更快,因此能抢占到更多的带宽。
Fairness and UDP
- multimedia apps often do not use TCP
- do not want rate throttled by congestion control
- instead use UDP:
- send audio/video at constant rate, tolerate packet loss
- there is no “Internet police” policing use of congestion control Fairness, parallel TCP connections
- application can open multiple parallel connections between two hosts
- web browsers do this, e.g., link of rate with 9 existing connections:
- new app asks for 1 TCP, gets rate
- new app asks for 11 TCPs, gets
8.6 TCP拥塞控制习题
8.6.1 3. New Reno 在高带宽、长时延的线路上为什么效率低(提示:线路偶尔丢包)
简答: 因为 New Reno 的“加法增大、乘法减小”(AIMD) 机制在这种环境下恢复太慢。
详细解释:
- 高带宽 x 长时延 = 高BDP: 这种线路被称为“长肥网络”(Long Fat Network, LFN)。其带宽时延积 (BDP) 非常大。BDP代表了需要填满整个网络“管道”所需的数据量。
CWND必须非常大: 为了跑满这种线路的带宽,TCP的CWND必须增长到一个非常大的值(等于或大于BDP)。- 加法增大 (AI) 太慢: New Reno 在“拥塞避免”阶段,
CWND每 RTT 仅增加 。如果 RTT 很长(长时延),且CWND需要增长到几十万(高BDP),这个线性增长的过程会极其缓慢。 - 乘法减小 (MD) 太狠: 提示中说“线路偶尔丢包”。在 LFN 上,即使只是一个非拥塞导致的随机丢包(如线路误码),New Reno 也会触发快速恢复,立即将
CWND砍半。 - “锯齿形”的致命缺陷: 这导致了 New Reno 的
CWND呈现一种“锯齿形”:- 缓慢爬坡: 花费很长时间(例如几分钟)才将
CWND爬到接近BDP。 - 瞬间减半: 遇到一次丢包,
CWND瞬间减半,导致线路利用率暴跌至 50%。 - 再次缓慢爬坡: 再花费很长时间才能恢复。
- 缓慢爬坡: 花费很长时间(例如几分钟)才将
结论: 在 LFN 上,New Reno 绝大部分时间都处于“缓慢爬坡”的恢复阶段,远未达到线路的真实带宽,导致效率极低。
8.6.2 4. TCP DC什么新机制,用ECN来拥塞控制,为什么比new reno好
“TCP DC” 指的是 DCTCP (Data Center TCP)。
新机制:
DCTCP 的核心机制是利用 ECN (Explicit Congestion Notification) 信号,并改变对 ECN 的响应方式。 0
- ECN 标记 (Router): 在数据中心网络中,交换机(路由器)的缓冲区(Buffer)设置得非常浅(以降低延迟)。当队列开始积累(注意:不是满了,只是刚开始有积压)时,交换机不会丢包,而是对流经的数据包设置一个 ECN 标记位。
- ECN 反馈 (Receiver): 接收方收到带 ECN 标记的包后,会在 包中设置
ECE位,将其反馈给发送方。 - DCTCP 响应 (Sender): 这是与 New Reno 根本不同的地方:
- New Reno (标准TCP): 收到 ECN 反馈后,其行为等同于检测到丢包,立即将
CWND减半。 - DCTCP: 它不再将 ECN 视为“丢包”信号。相反,它会估算近期被标记包的比例()。然后,它根据这个比例平滑地、小幅度地降低
CWND。 - 公式(概念):
CWND = CWND * (1 - F / 2)。如果只有 10% 的包被标记,它可能只会将CWND降低 5%,而不是 50%。
- New Reno (标准TCP): 收到 ECN 反馈后,其行为等同于检测到丢包,立即将
为什么比 New Reno 好 (在数据中心环境下):
- 主动响应,防止丢包: New Reno 依赖丢包(或 ECN 减半)来检测拥塞,此时队列已满,延迟已高。DCTCP 响应的是**“队列开始积压”**的早期信号,在丢包发生前就主动控制住了拥塞。
- 保持低延迟(小队列): New Reno 的“锯齿形”倾向于填满缓冲区(Bufferbloat)。DCTCP 的机制通过对早期 ECN 信号的快速、小幅响应,使交换机的队列始终保持在很低的水平,这对于数据中心内的低延迟应用至关重要。
- 高吞吐与平滑: New Reno 的“
CWND减半”反应过于剧烈,导致吞吐量大幅波动。DCTCP 的按比例减小窗口,使得CWND变化非常平滑,能够在保持低延迟的同时,持续跑满链路带宽。
8.6.3 关于公平性的问题
8.6.3.1 1. 为什么“加增乘减 (AIMD)”可以达到公平?
“加增乘减” (Additive Increase, Multiplicative Decrease) 是 TCP-Reno 使用的算法。
- 前提: 假设在某一时刻,两个连接处于一个不公平的状态,例如 Connection 1 的窗口 ,Connection 2 的窗口 。它们共享的链路总容量 (比如 )。
- 加增 (AI) 阶段: 在没有拥塞时,两个连接的窗口每过一个 RTT 都增加 1 MSS。
- 经过 个 RTTs, ,。
- 它们的绝对差距始终保持不变()。
- 拥塞最终会在 时发生。
- 乘减 (MD) 阶段: 拥塞发生时(例如 时 导致丢包),两个连接同时将自己的窗口减半()。
- 变为
- 变为
- 关键分析 (收敛):
- 拥塞前的差距:
- 拥塞后的差距:
- 新差距 () < 旧差距 ()
结论: 在 AIMD 机制下,窗口减少的绝对量与它当前的大小成正比( 减少了 17.5,而 只减少了 7.5)。这意味着“更贪婪”(窗口更大)的连接在拥塞时受到了“更严厉的惩罚”。这种机制使得两个连接的窗口大小在每次拥塞循环后都更加接近,最终收敛到公平状态()。
8.6.3.2 2. 为什么其他组合不可以?
A. “加增减减 (AIAD)”
- 加增 (AI) 阶段: 差距不变(例如 )。
- 减减 (AD) 阶段: 拥塞发生时,两个连接都减去一个固定值 (例如 )。
- 关键分析 (不收敛):
- 拥塞前的差距:
- 拥塞后的差距:
- 新差距 = 旧差距
结论: 在 AIAD 机制下,两个连接的窗口差距永远不会缩小。如果系统开始时不公平,它将永远保持不公平。
B. “乘增乘减 (MIMD)”
- 乘增 (MI) 阶段: 在没有拥塞时,两个连接的窗口都乘以一个因子 (例如 )。
- 假设从 开始。
- 一轮后:。差距变为 。
- 关键分析 (发散):
- 初始差距:
- 新差距:
- 新差距 > 旧差距
结论: 在 MIMD 机制下,“乘增”阶段会使窗口的绝对差距以指数方式扩大。窗口越大的连接,其增长也越快,导致它会更快地抢占所有带宽,使系统更加不公平。虽然“乘减”步骤会试图拉近差距(如 AIMD 所示),但“乘增”步骤导致的发散效应更强,系统无法收敛到公平。
8.7 TCP分叉(中文P177)
根据这篇文章,TCP 分叉 (TCP Splitting) 是一种用来优化云服务(如搜索、邮件)响应性能的技术。
简单来说,它的原理如下:
8.7.1 1. 核心问题
- 用户和云服务的数据中心通常离得很远。
- 这种距离导致了很高的**“往返时间”(RTT)**。
- 文章提到,一次普通的搜索查询,从建立连接到接收完数据,网络延迟大约需要 (1 RTT 建立连接 + 3 RTT 传输数据)。如果 RTT 很高,用户就会感到明显的卡顿。
8.7.2 2. “分叉”的解决方案
TCP 分叉不是让用户 直接 连接到很远的数据中心,而是在中间设置一个“中转站”,即前端服务器 (front-end server)。
这个中转站被部署在靠近用户的地方,然后连接就被“分叉”成了两段:
- 第一段(用户 前端服务器):
- 用户连接到这个附近的服务器。
- 由于距离近,这部分的 (文中的 ) 非常低。
- 第二段(前端服务器 数据中心):
- 前端服务器与远处的数据中心保持一个持久的、高效的连接(使用大拥塞窗口)。
- 这部分的 (文中的 ) 依然很高,但这部分延迟对用户的影响被优化了。
8.7.3 3. 达到的效果
- 用户感知到的响应时间,从原本的 ( 很小, 很大),变成了更优的结构。
- 文章总结,TCP 分叉能将总的网络延迟从大约 减少到 。
- 这大大提高了用户感知的性能,并有助于减少因网络丢包引起的重传。
总之,TCP 分叉就是通过在用户附近设置一个中转服务器,把一个长连接“分叉”成一个短连接和一个长连接,从而巧妙地减少了 TCP 慢启动等过程带来的多倍 RTT 延迟。
9 Evolution of transport-layer functionality (Read Sec. 3.8 by yourself)
9.1 Evolving transport-layer functionality
- TCP, UDP: principal transport protocols for 40 years
- different “flavors” of TCP developed, for specific scenarios:
| Scenario | Challenges |
|---|---|
| Long, fat pipes (large data transfers) | Many packets “in flight”; loss shuts down pipeline |
| Wireless networks | Loss due to noisy wireless links, mobility; TCP treat this as congestion loss |
| Long-delay links | Extremely long RTTs |
| Data center networks | Latency sensitive |
| Background traffic flows | Low priority, “background” TCP flows |
- moving transport–layer functions to application layer, on top of UDP
- HTTP/3: QUIC
9.2 QUIC: Quick UDP Internet Connections
- application-layer protocol, on top of UDP
- increase performance of HTTP
- deployed on many Google servers, apps (Chrome, mobile YouTube app)
9.2.1 QUIC: Quick UDP Internet Connections
adopts approaches we’ve studied in this chapter for connection establishment, error control, congestion control
- error and congestion control: “Readers familiar with TCP’s loss detection and congestion control will find algorithms here that parallel well-known TCP ones.” [from QUIC specification]
- connection establishment: reliability, congestion control, authentication, encryption, state established in one RTT
- multiple application-level “streams” multiplexed over single QUIC connection
- separate reliable data transfer, security
- common congestion control
9.2.2 QUIC: Connection establishment
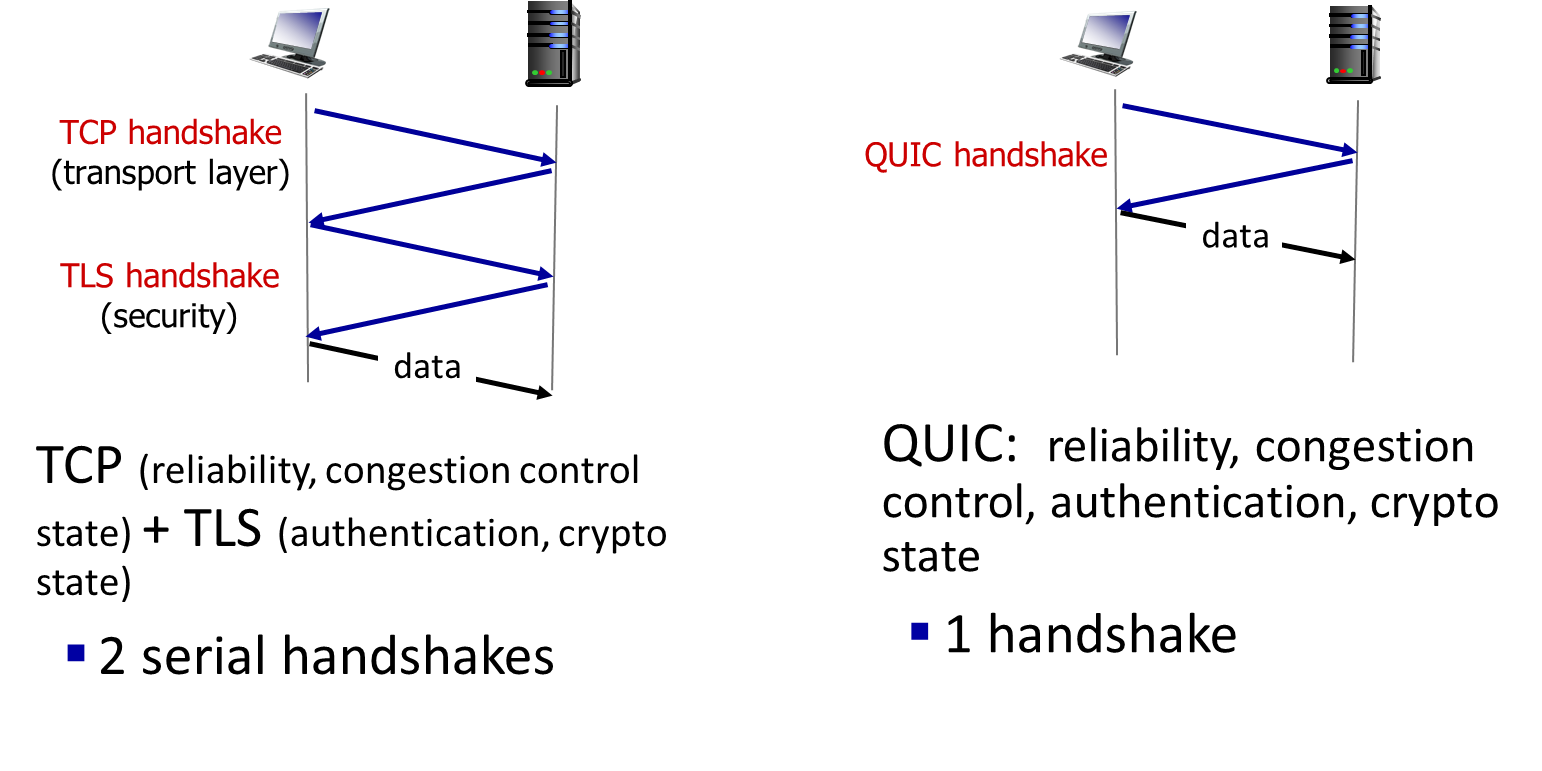
9.2.3 QUIC: streams: parallelism, no HOL blocking
简单就是,如果HTTP1.1中间有错的话,则该报文会被重传阻挡了后面的报文的传送;但是在QUIC里面如果前面有错则暂时跳过,继续传后面的。
10 第三章 运输层总结
课程最后,教师对整个第三章的内容进行了全面回顾。
- 运输层服务: 为应用进程之间提供逻辑通信服务,这与网络层提供的主机到主机通信服务粒度更细。
- 多路复用与分解: 核心机制是端口号。教师强调了TCP套接字(由四元组标识)和UDP套接字(由二元组标识)的区别。
- UDP协议: 无连接的、尽力而为的服务,提供了简单的校验和差错检测。
- 可靠数据传输原理: 通过从rdt1.0到rdt3.0的协议演化,讲解了实现可靠传输的核心思想。为解决rdt3.0效率不高的问题,引入了流水线机制。
- 流水线协议:
- 回退N步 (Go-Back-N): 接收窗口为1,只能按序接收,实现相对简单。
- 选择重传 (Selective Repeat): 接收窗口大于1,可以缓存乱序分组,效率更高但实现更复杂。
- TCP协议:
- 特性: 面向连接的、可靠的字节流服务,提供流量控制和拥塞控制。
- 核心机制: 详细讲解了TCP报文段格式、超时重传与快速重传、流量控制、三次握手建立连接、以及对称式的四次挥手断开连接(并用定时器解决了“两军问题”)。
- 拥塞控制:
- 原理: 讲解了拥塞的原因与代价。
- 两大方法: 网络辅助的拥塞控制(如ATM)和端到端的拥塞控制(TCP采用)。
- TCP实现: 通过超时和三次重复ACK来判断拥塞,并动态调整拥塞窗口,以实现拥塞发生时快速降低速率,网络恢复时又能有效利用带宽。
10.1 背诵
- TCP连接管理中的几个状态(CLOSE_WAIT,FIN_WAIT_1等等这些)
- 拥塞的代价
10.2 其他补充
这份关于 最大最小公平性 (Max-Min Fairness) 的笔记总结如下,旨在帮助你快速理解其核心逻辑:
核心思想
“先满足小需求,后平分剩余量。”
在资源(如带宽)受限时,优先保证需求量最小的用户得到满足;对于需求较大的用户,则公平地平分剩下的资源。
计算三步走
- 算平均: 将总资源除以当前还没分配完的用户数,得到一个“公平份额”。
- 看需求:
- 如果某个用户的需求 < 公平份额:直接满足它,给它想要的全部。
- 如果某个用户的需求 > 公平份额:暂时不予完全满足,等待下一轮分配。
- 分剩余: 从总资源中减去已分配掉的部分,对剩下的用户重复步骤 1 和 2,直到资源分完。
示例回顾
假设总带宽 ,需求分别为:。
| 步骤 | 计算过程 | 结果 |
|---|---|---|
| 第一轮 | 平均额度 。 只要 4,满足它。 | |
| 第二轮 | 剩余带宽 。平均分配给剩下 2 人:。 | - |
| 结果 | 和 的需求都大于 8,最终每人拿 8。 |
两个关键特征
- 不浪费: 任何用户分到的资源都不会超过其请求的量。
- 公平性: 所有没被完全满足的用户,拿到的资源是一样多的(达到一个相等的“上限”)。
笔记要点: 这种算法防止了“大户”垄断资源,保证了“小户”的基本生存。