1 计算机网络 - 第三章习题讲解
1.1 复习题 R3: TCP 段的源端口号和目的端口号
- 问题: 考虑在主机 A 和主机 B 之间有一条 TCP 连接。假设从主机 A 传送到主机 B 的 TCP 报文段具有源端口号 x 和目的端口号 y。对于从主机 B 传送到主机 A 的报文段,源端口号和目的端口号分别是多少?
- 讲解: TCP 连接是双向的。当 A 向 B 发送时,源端口是 x,目的端口是 y。当 B 向 A 发送回应时,源端口和目的端口会交换。
- 答案: 源端口号为 y,目的端口号为 x。
1.2 复习题 R7: UDP Socket 与进程定位
- 问题: 假定在主机 C 上的一个进程有一个具有端口号 6789 的 UDP 套接字。假定主机 A 和主机 B 都用目的端口号 6789 向主机 C 发送一个 UDP 报文段。这两台主机上的 UDP 报文段在主机 C 都将被定向到相同的套接字吗?如果是这样的话,在主机 C 的该进程将怎样知道源于不同主机的这两个报文段?
- 讲解:
- UDP Socket 通常只与本地 IP 地址和本地端口号绑定。
- 当主机 C 上的进程在端口 6789 上监听 UDP 数据报时,它创建了一个 Socket。
- 无论数据报来自主机 A 还是主机 B,只要它们的目的 IP 是 C 的 IP,目的端口是 6789,操作系统内核都会将这些数据报定向到监听在 6789 端口的同一个 UDP Socket。
- 进程可以通过接收 UDP 数据报时返回的源 IP 地址和源端口号来区分数据报的来源。通常使用
recvfrom这样的 API 调用来获取这些信息。
- 答案: 是的,报文段将被定向到相同的套接字。进程可以通过检查报文段的源 IP 地址和源端口号来区分来源。
1.3 复习题 R9: rdt 协议中序号的作用
- 问题: 在我们的 rdt 协议中,为什么需要引入序号?
- 讲解: 引入序号主要是为了区分不同的分组,特别是用于检测冗余(重复)的分组。如果一个分组及其确认丢失,发送方会超时重传。接收方需要通过序号来判断这个重传的分组是新的分组还是之前已经收到过的旧分组。
- 答案: 序号可以用来区分是新数据分组还是重传的旧数据分组(冗余分组),也可以用来判断数据分组是否按序到达。
1.4 复习题 R10: rdt 协议中定时器的作用
- 问题: 在我们的 rdt 协议中,为什么需要引入定时器?
- 讲解: 定时器用于检测可能发生的分组丢失(包括数据分组丢失和确认分组 ACK 丢失)。发送方发送分组后启动定时器。如果在定时器超时之前没有收到相应的确认,发送方就假定该分组或其 ACK 丢失,并进行重传。
- 答案: 防止发送方发送分组后,因分组丢失或对应的 ACK 丢失而无限等待。当定时器超时,发送方会重传分组,以确保可靠传输。这主要用来防止死锁现象。
1.5 复习题 R14: TCP 判断题
a. 主机 A 经过一条 TCP 连接向主机 B 发送一个大文件。假设主机 B 没有数据发往主机 A。因为主机 B 不能捎带确认,则 B 不会向 A 发送确认。
- 判断: 错误 (False)。
- 理由: TCP 协议要求接收方(B)必须发送确认 (ACK) 来告知发送方(A)已成功接收数据。即使 B 没有数据(payload)要发给 A,它也必须发送一个不包含数据的“纯 ACK”报文段来进行确认。捎带确认(Piggybacking)只是一种优化,而不是发送 ACK 的前提条件。
b. 在连接的整个过程中,TCP 的 rwnd (接收窗口) 的长度不会变化。
- 判断: 错误 (False)。
- 理由:
rwnd(接收窗口) 反映了接收方缓冲区的剩余可用空间。当接收方的应用进程从缓冲区读取数据后,可用空间会增加(rwnd变大);当新的 TCP 报文段到达并填充缓冲区时,可用空间会减少(rwnd变小)。因此,rwnd的值在连接期间是动态变化的。
c. 假设主机 A 通过一条 TCP 连接向主机 B 发送一个大文件。A 发送的未确认字节数不能超过接收缓冲区的大小。
- 判断: 正确 (True)。
- 理由: 发送方(A)的未确认字节数(即“在途字节数”)受限于流量控制窗口(即接收窗口
rwnd)。而接收窗口rwnd的大小本身就是根据接收方(B)的接收缓冲区(RcvBuffer)的 可用空间 来设置的,其值永远不会超过接收缓冲区的 总大小(即 )。因此,既然未确认字节数 ,那么它也必然 。
d. 假设主机 A 通过一条 TCP 连接向主机 B 发送一个大文件。如果此连接中一个报文段的序号是 ,则后续报文段的序号必定是 。
- 判断: 错误 (False)。
- 理由: 序号 是该报文段中第一个字节的序号。如果这个报文段携带了 字节的数据,那么这 字节数据的序号范围是 到 。因此,下一个报文段的序号(sequence number)将是 。只有在 (即该报文段只携带 1 字节数据) 的罕见情况下,下一个报文段的序号才是 。在发送大文件时, 通常等于 MSS (最大报文段长度),远大于 1。【老师希望注意这个TCP的编号是用字节为单位的】
e. TCP 段在它的首部中有一个 rwnd 字段。
- 判断: 正确 (True)。
- 理由: TCP 头部(Header)中包含一个 16 位的“接收窗口”(Receive Window)字段,该字段即为
rwnd。接收方使用这个字段来告知发送方自己还有多少缓冲区空间,从而实现流量控制。
f. 假定在一条 TCP 连接中最后的 SampleRTT 等于 1 秒。那么对于该连接的 TimeoutInterval (超时重传时间) 的当前值必定大于等于 1 秒。
- 判断: 错误 (False)。
- 理由:
TimeoutInterval的计算公式通常是 。EstimatedRTT是对多个SampleRTT值的平滑(加权)平均,而DevRTT是 RTT 偏差的平滑平均。 TimeoutInterval总是大于EstimatedRTT,但它与某一个SampleRTT的瞬时值没有必然的 “大于等于” 关系。例如,如果网络之前很慢(EstimatedRTT=2s,TimeoutInterval> 2s),网络突然变快,测得一个SampleRTT= 1s,这个SampleRTT显然是小于TimeoutInterval的。
g. 假设主机 A 通过一条 TCP 连接向主机 B 发送一个序号为 38、数据为 4 字节的报文段。在这同一个报文段中,确认号必定是 42。
- 判断: 错误 (False)。
- 理由: “序号” (Sequence Number) 字段和 “确认号” (Acknowledgment Number) 字段是 TCP 头部中两个功能独立的字段。
- 序号 (本例中为 38): 是发送方 A 用来标识它所发送的数据的。
- 确认号: 是发送方 A 用来 确认它从 B 收到的数据 的。这个值取决于 A 之前从 B 收到了哪些数据,与 A 自己 正在发送的序号 38 和数据(字节 38, 39, 40, 41)毫无关系。 (B 在 收到 这个报文段后,会 回复 一个 ACK 报文段。如果序号 38 之前的数据都已按序收到,那么 B 回复 的报文段中的确认号才会被设为 42 (38 + 4))。
1.6 复习题 R15: TCP 序号与确认号计算
- 问题: 假设主机 A 通过一条 TCP 连接向主机 B 发送两个紧接着的 TCP 报文段。第一个报文段序号为 90,第二个报文段序号为 110。
- a) 第一个报文段中有多少数据?
- b) 假设第一个报文段丢失而第二个报文段到达。那么在主机 B 发送确认报文时,确认号应该是多少?
- 讲解:
- TCP 报文段的序号是该段数据中第一个字节的序号。
- 两个连续报文段,第一个序号是 90,第二个是 110,说明第一个报文段携带的数据字节数是 字节 (序号从 90 到 109)。
- 如果第一个段 (90-109) 丢失,第二个段 (110 开始) 到达 B。由于 TCP 使用累积确认,B 仍然期望收到序号为 90 的字节。
- 答案:
- a) 第一个报文段有 bytes。
- b) 主机 B 发送的 ACK 报文段的确认号仍然是 90。 (ACK号 = 期望收到的下一个字节的序号 + 1,这里应该是指期望收到的起始序号,即 90) (老师写的是 ACK 为顺序收到的最后一个字节序号 + 1,即为期望的起始序号)
1.7 复习题 R17: TCP 公平性
- 问题: 两条 TCP 连接共享一个瓶颈链路。它们都经过一个带宽为 R bps 的瓶颈路由器。它们同时开始发送一个大文件(以相同方向经过瓶颈链路),并且两者同时开始活动。那么这两条 TCP 连接会公平地分享链路带宽 R 吗?
- 讲解: TCP 的拥塞控制机制(AIMD - 加性增、乘性减)旨在实现公平性。当多条连接共享瓶颈链路时,它们会竞争带宽。发生拥塞(丢包)时,连接会减小其发送速率(拥塞窗口)。随着时间的推移,这种增减过程倾向于使共享同一瓶颈链路的 TCP 连接收敛到大致相等的带宽份额。
- 答案: 公平性目标:如果 K 条 TCP 连接分享一个带宽为 R 的瓶颈链路,每一条会话的有效带宽为 R/K。是的,在理想情况下且经过足够长的时间后,它们会趋向于公平地分享带宽 R,各自获得大约 R/2 的带宽。
1.8 复习题 R18: TCP 拥塞控制与 ssthresh
- 问题: 考虑 TCP 的拥塞控制。当发送方定时器超时时,其
ssthresh的值将被设置为当前拥塞窗口值的一半。【但不是原来ssthresh的一半】 - 讲解: 当发生超时事件 (Timeout) 时,TCP 认为网络发生了严重的拥塞。此时:
ssthresh(慢启动阈值) 被设置为当前拥塞窗口cwnd的一半:。- 拥塞窗口
cwnd被重置为 1 MSS (Maximum Segment Size)。 - 发送方进入慢启动阶段。
- 答案: 正确。当发送方发生超时事件时,
ssthresh的值会被设置为当前拥塞窗口cwnd的一半。
1.9 习题 P1: Socket 端口号分配
- 问题: 假设客户 A 向服务器 S 发起一个 Telnet 会话。与此同时,客户 B 也向服务器 S 发起一个 Telnet 会话。给出下面报文段的源端口号和目的端口号:
- a. 从 A 发往 S 的报文段。
- b. 从 B 发往 S 的报文段。
- c. 从 S 发往 A 的报文段。
- d. 从 S 发往 B 的报文段。
- e. 如果 A 和 B 是不同的主机,那么从 A 发往 S 的报文段的源端口号是否可能与从 B 发往 S 的报文段的源端口号相同?
- f. 如果它们是相同的主机,情况会怎样?
- 讲解:
- Telnet 服务器的标准端口号是 23。
- 客户端发起连接时,操作系统会为其分配一个临时的、唯一的源端口号(通常大于 1023)。
- 一个 TCP 连接由四元组唯一标识:(源 IP, 源端口, 目的 IP, 目的端口)。
- A → S: 源 IP=A_IP, 源端口=x (临时), 目的 IP=S_IP, 目的端口=23
- B → S: 源 IP=B_IP, 源端口=y (临时), 目的 IP=S_IP, 目的端口=23
- S → A: 源 IP=S_IP, 源端口=23, 目的 IP=A_IP, 目的端口=x
- S → B: 源 IP=S_IP, 源端口=23, 目的 IP=B_IP, 目的端口=y
- 答案:
- a. A → S: 源端口 x (A 分配的临时端口), 目的端口 23
- b. B → S: 源端口 y (B 分配的临时端口), 目的端口 23
- c. S → A: 源端口 23, 目的端口 x
- d. S → B: 源端口 23, 目的端口 y
- e. 如果 A 和 B 是不同主机,x 和 y 可能相同。因为源端口号是在各自的主机上分配的,它们可能碰巧选择了相同的临时端口号。但由于源 IP 不同,(A_IP, x, S_IP, 23) 和 (B_IP, y, S_IP, 23) 仍然是不同的连接。
- f. 如果 A 和 B 是相同主机,x 和 y 必须不同。在同一台主机上,操作系统必须为不同的 TCP 连接分配不同的端口号组合,以唯一标识每个连接。通常这意味着临时端口号 x 和 y 不能相同。
1.10 习题 P3: UDP 检验和计算
- 问题: UDP 和 TCP 使用反码运算来计算它们的检验和。假设有下面 3 个 8 比特字节:01010011, 01100110, 01111010。这些 8 比特字节和的反码和是多少?(写出计算过程)UDP 为什么采用检验和的反码?反码方案,接收方如何检测出差错?比特差错仍可能检测不出来吗?举例。
- 讲解:
- 反码求和:
- 将数据看作 16 比特的整数序列(这里是 8 比特,需要扩展或分组,题目似乎简化了,按 8 比特直接加)。
- 01010011 + 01100110 = 10111001
- 10111001 + 01111010 = (1) 00110011 (产生进位)
- 将进位加回到结果的最低位(回卷):00110011 + 1 = 00110100
- 求反码: 对和 00110100 按位取反,得到 11001011。这就是检验和。
- 为何用反码: 反码求和相对简单,特别是进位回卷可以用硬件高效实现。
- 接收方检测: 接收方将收到的所有数据(包括收到的检验和字段)按同样方式(16位一组反码求和,进位回卷)加起来。如果结果所有位都是 1(即 -0 的反码表示),则认为没有差错。
- 无法检测的差错: 如果传输中发生比特差错,但恰好使得最终的和仍然是全 1,则差错无法被检测。例如,如果某个 16 位字中的某一位从 1 变为 0,同时另一个 16 位字中对应位从 0 变为 1,总和可能不变。或者多个比特错误相互抵消。
- 反码求和:
- 答案:
- 和的反码: 11001011
- UDP 使用反码是因为其求和计算相对容易实现。
- 接收方将所有 16 位字(包括检验和)相加,如果结果是全 1,则无差错。
- 可能无法检测出差错,例如,如果两个比特位发生翻转,一个从 0→1,另一个从 1→0,且它们的和不变。
1.11 P6
P6. 考虑我们为纠正协议 rdt2.1 所做的尝试。展示在图 3.60 中的接收方(一个不正确的接收方)与图 3.11 中的发送方(rdt2.1 的标准发送方)一起运行时,如何能使发送方和接收方进入死锁状态,即它们各自都在等待一个永远不会发生的事件。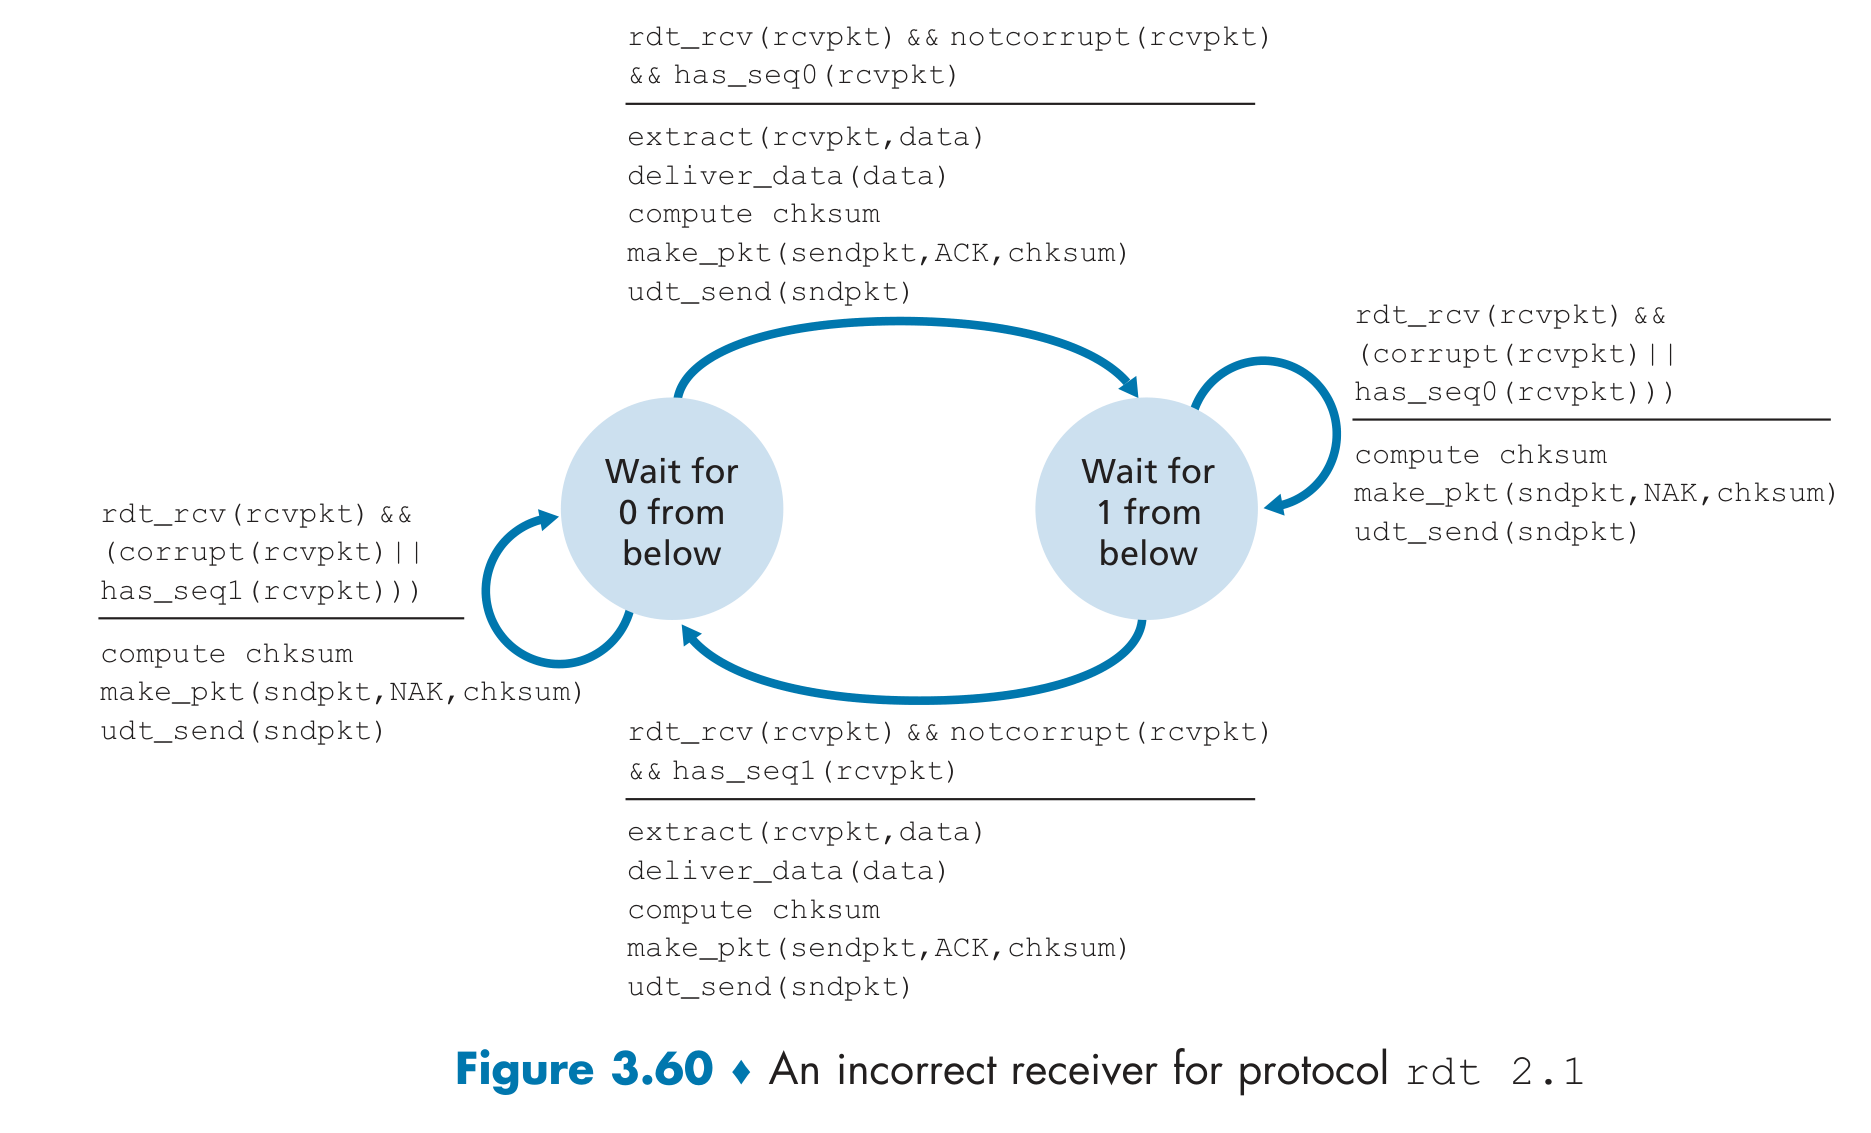
1.11.1 问题解答 (P6)
图 3.60 中接收方的致命缺陷在于:
- 当它在“Wait for 0”状态时,如果收到了一个(未损坏的)Packet 1,它会发送 NAK (而不是像 rdt2.1 标准接收方那样发送 ACK 1)。
- 同理,当它在“Wait for 1”状态时,如果收到了一个(未损坏的)Packet 0,它也会发送 NAK。
我们可以利用这个缺陷来构造一个死锁场景,这个场景涉及ACK/NAK 报文的损坏。
死锁场景如下:
- 发送方 (状态: Wait for call 0):发送 Packet 0。进入 “Wait for ACK/NAK 0” 状态。
- 接收方 (状态: Wait for 0):正确接收 Packet 0。发送 ACK (确认 0)。进入 “Wait for 1” 状态。
- 发送方 (状态: Wait for ACK/NAK 0):正确接收 ACK (确认 0)。进入 “Wait for call 1” 状态。
- 发送方 (状态: Wait for call 1):发送 Packet 1。进入 “Wait for ACK/NAK 1” 状态。
- 接收方 (状态: Wait for 1):正确接收 Packet 1。发送 ACK (确认 1)。进入 “Wait for 0” 状态。
- 【关键步骤】:这个从接收方发往发送方的 ACK (确认 1) 报文在传输中损坏了。
- 发送方 (状态: Wait for ACK/NAK 1):收到了一个损坏的 ACK/NAK 报文。rdt2.1 发送方会将损坏的 ACK/NAK 视为 NAK。
- 发送方 (状态: Wait for ACK/NAK 1):作为对 NAK 的响应,重传 Packet 1。继续保持在 “Wait for ACK/NAK 1” 状态。
- 接收方 (状态: Wait for 0):收到了重传的 Packet 1(该报文未损坏)。
- 【触发缺陷】:接收方当前在 “Wait for 0” 状态,但它收到了
has_seq1(rcvpkt)。根据图 3.60 的 FSM,它将执行compute_chksum,make_pkt(sndpkt, NAK, chksum)并udt_send(sndpkt)。 - 接收方 (状态: Wait for 0):发送一个 NAK。继续保持在 “Wait for 0” 状态。
- 发送方 (状态: Wait for ACK/NAK 1):收到了这个 NAK。
- 发送方 (状态: Wait for ACK/NAK 1):作为响应,再次重传 Packet 1。继续保持在 “Wait for ACK/NAK 1” 状态。
- …返回步骤 9…
死锁形成:
- 发送方 永远卡在 “Wait for ACK/NAK 1” 状态。它不断地重传 Packet 1,并期望收到一个 ACK 1。
- 接收方 永远卡在 “Wait for 0” 状态。它不断地收到 Packet 1,并根据其错误的 FSM 不断地回复 NAK,同时期望收到 Packet 0。
发送方在等待 ACK 1(永远不会来),接收方在等待 Packet 0(也永远不会来)。双方陷入死锁。
1.12 P7
P7. 在协议 rdt3.0 中,从接收方流向发送方的 ACK 报文没有序列号(尽管它们确实有一个 ACK 字段,其中包含它们正在确认的报文的序列号)。为什么我们的 ACK 报文不需要序列号?
1.12.1 问题解答 (P7)
这里的“没有序列号”是指 ACK 报文本身不需要一个独立于数据包的序列号(例如 ACK_seq_num = 0, 1, 2, ...)。它们只需要一个 ACK 字段来指明它们正在确认哪个数据包(例如 “ACK 0” 或 “ACK 1”)。
原因是:rdt3.0 是一个停等 (Stop-and-Wait) 协议。
- 发送方的状态提供了上下文: 在任何给定时刻,发送方只在一个状态中:要么在“等待 ACK 0”,要么在“等待 ACK 1”。
- ACK 的唯一目的: ACK 的唯一目的是告诉发送方“我已正确收到了你发的那个包”。
- 不需要对 ACK 排序:
- 假设发送方发送了 Packet 0 并正在“等待 ACK 0”。
- 如果它收到了 “ACK 0”,它就知道成功了,然后转换到“等待 ACK 1”的状态。
- 如果它收到了一个 “ACK 1”(这一定是一个来自上一个周期的、延迟的、重复的 ACK),发送方会简单地忽略它,因为它正在等待 “ACK 0”。
- 如果 ACK 丢失了,发送方会超时并重传 Packet 0。接收方会收到一个重复的 Packet 0,并重新发送 “ACK 0”。
因为发送方一次只等待一个特定的 ACK,所以 ACK 报文流本身不需要被编号或排序。ACK 字段中包含的序列号(0 或 1)足以让发送方明确知道接收方收到了哪一个包。
1.13 习题 P8: rdt3.0 与 FSM
- 问题: 画出协议 rdt3.0 发送方中的 FSM。
- 讲解:
rdt3.0只是引入了可能发送的东西会丢失的问题,但是 - 答案: 和
rdt2.2的一模一样
1.14 习题 P15: 链路利用率计算
P15. 考虑显示在图 3-17 中的网络跨越国家的例子。窗口长度设置成多少时,才能使该信道的利用率超过 90%?假设分组的长度为 1500 字节(包括首部字段和数据)。
1. 确定已知参数
- 分组长度 (L):
- 链路带宽 (R): (即 1 Gbps,根据图片中的计算 得出)
- 往返时延 (RTT): (从笔记和图片推断)
- 目标利用率 (U):
2. 计算传输时延 ()
传输时延是发送一个分组(Packet)所需的时间。
为了方便后续计算,将单位统一为毫秒 (ms):
3. 套用链路利用率公式
对于窗口大小为 N 的流水线协议,链路利用率 的公式为:
4. 求解窗口大小 (N)
我们需要使利用率 超过 90% ()。将已知数值代入不等式:
5. 确定最终答案
因为窗口长度 N 必须是整数,所以 N 必须大于 2250.9。
答案: 窗口长度 N 至少需要是 2251。
【注意有时候做题,当发送窗口足够大的时候,这个利用率可能就是100%】
1.15 习题 P23: GBN 与 SR 协议的序号空间大小
- 问题: 考虑 GBN 协议和 SR 协议。假设序号空间的长度为 k,那么为了避免出现图 3-27 中的问题,对于两种协议中的每一种,允许的发送方窗口最大为多少?
- 讲解:
- 序号空间大小为 (序号从 0 到 )。
- GBN (Go-Back-N): 接收窗口大小恒为 1。为了区分序号空间中的新旧分组,发送窗口 必须小于序号空间的大小。最大窗口为 。如果等于 ,则无法区分第一轮的序号 0 和第二轮的序号 0。
- 例: k=3, 序号 0-7 ()。如果 W=8,发送 0-7,ACK 全丢,超时重传 0。接收方期望 0 (新一轮),收到 0 (可能是上一轮重传),无法区分。如果 W=7,发送 0-6,ACK 全丢,超时重传 0。接收方期望 7,收到 0,知道是重传,丢弃。
- SR (Selective Repeat): 发送窗口和接收窗口大小可以大于 1。为了避免新旧窗口序号重叠导致无法区分的问题,发送窗口 和接收窗口 的和必须小于等于序号空间大小。通常假设发送和接收窗口大小相等,即 。因此,最大窗口为 。
- 例: k=3, 序号 0-7。如果 W=5 (大于 ),发送 0-4。接收方收到 0-4,窗口滑动到 5-1 (56701)。发送方 ACK 全丢,超时重传 0。接收方窗口是 56701,期望收到 5,但收到 0。此时 0 也在接收窗口内,接收方会误认为这是一个新的分组 0,而不是旧的重传。如果 W=4,发送 0-3。接收方收到 0-3,窗口滑动到 4-7 (4567)。发送方 ACK 全丢,超时重传 0。接收方窗口 4567,期望 4,收到 0。0 不在窗口内,丢弃。
- 答案:
- 对于 GBN,发送窗口最大为 。
- 对于 SR,发送窗口最大为 。
1.16 习题 P24: GBN 与 SR 协议特性判断
1.16.1 a) 对于 SR 协议,发送方可能会收到落在其当前窗口之外的分组的 ACK。
- 答案:正确 (True)
- 解释:
这种情况是可能发生的,尤其是在网络延迟导致 ACK 延迟和分组重传时。一个典型的场景如下:
- 发送:发送方窗口为
[1, 2, 3],并发送了分组 1, 2, 3。 - 接收与确认:接收方在
t1时刻收到了 1, 2, 3,并发送了 ACK 1, ACK 2, ACK 3。 - 超时与重传:由于网络延迟,
t1发送的 ACKs 没有及时到达。发送方在t2时刻超时,并重传了分组 1, 2, 3。 - 接收重复确认:接收方在
t3时刻收到了重复的分组 1, 2, 3,并再次发送了 ACK 1, ACK 2, ACK 3。 - 窗口滑动:在
t4时刻,发送方收到了t1时刻发出的第一批 ACKs (1, 2, 3)。它因此将窗口向前滑动到[4, 5, 6]。 - 收到过时 ACK:在
t5时刻,发送方收到了t3时刻发出的第二批(重复的)ACKs (1, 2, 3)。此时,发送方的窗口已经是[4, 5, 6],因此 ACKs 1, 2, 3 所对应的序号已落在其当前窗口之外。
- 发送:发送方窗口为
1.16.2 b) 对于 GBN 协议,发送方可能会收到落在其当前窗口之外的分组的 ACK。
-
答案:正确 (True)
-
解释: 与 SR 协议类似,GBN 也可能发生这种情况。GBN 使用累积确认,其
base(窗口的起始序号)之前的 ACK 都会被视作窗口之外的 ACK。沿用与 (a) 相同的场景:
- 发送:发送方 GBN 窗口为
[1, 2, 3](base=1),并发送了分组 1, 2, 3。 - 接收与确认:接收方在
t1收到 1, 2, 3,并依次发送了累积确认 ACK 1, ACK 2, ACK 3。 - 超时与重传:
t1的 ACKs 延迟。发送方在t2时刻超时(例如等待 ACK 1 超时),并重传所有已发送但未确认的分组,即 1, 2, 3。 - 接收重复确认:接收方在
t3收到重复的分组 1,丢弃它并重新发送已收到的最高序号 ACK,即 ACK 3(或 ACK 1, 2, 3,取决于具体实现)。 - 窗口滑动:在
t4时刻,发送方收到了t1发出的第一批 ACKs,最终收到了 ACK 3。base更新为 4,窗口滑动到[4, 5, 6]。 - 收到过时 ACK:在
t5时刻,发送方收到了t3发出的第二批(重复的)ACKs,例如 ACK 1, ACK 2, ACK 3。此时base已经是 4,这些 ACK 的序号(1, 2, 3)均小于base,因此它们落在当前窗口之外。
- 发送:发送方 GBN 窗口为
1.16.3 c) 当发送方和接收方窗口长度都为 1 时,比特交替协议与 SR 协议相同。
- 答案:正确 (True)
- 解释:
- 比特交替协议 (Alternating-Bit Protocol):本质上是 rdt3.0 协议,是一种停等协议。其发送窗口和接收窗口大小均为 1,并使用 0 和 1 两个序号交替。
- SR 协议:当 SR 协议的发送窗口 且接收窗口 时,发送方一次只能发送 1 个分组,并且必须等待该分组的 ACK 才能继续发送下个分组。这在功能上完全等同于停等协议。SR 协议中 “选择性” 的特性(如乱序接收、缓存)也因窗口为 1 而失去意义。如果此时 SR 协议只使用 {0, 1} 两个序号,它就与比特交替协议完全相同。
1.16.4 d) 当发送方和接收方窗口长度都为 1 时,比特交替协议与 GBN 协议相同。
- 答案:正确 (True)
- 解释:
- GBN 协议:GBN 的接收窗口 总是 1。当其发送窗口 时,它也变成了一个停等协议。
- 特性退化:
- 窗口为 1:发送方一次只发送 1 个分组,因此 GBN 的 “回退N” 机制(Go-Back-N)在这种情况下退化了——如果发生超时,“N” 的值永远是 1(即只重传那个唯一未被确认的分组)。
- 确认机制:GBN 的累积确认在这种情况下也退化为对单个分组的普通确认,因为它只能确认那个刚收到的唯一分组。
- 结论:由于 且 时,GBN 协议在功能上等同于停等协议,因此它与比特交替协议(使用 {0, 1} 序号的停等协议)是功能等价的。
1.17 P26 TCP能够传送的最大报文
P26. 考虑将一个大小为 字节的巨大文件从主机 A 传输到主机 B。假设 MSS (最大报文段大小) 为 536 字节。
a. 为使 TCP 序列号不被耗尽, 的最大值是多少?(提示:TCP 序列号字段有 4 字节)。
b. 对于你在 (a) 中得到的 值,计算传输该文件需要多长时间。假设在每个报文段上总共添加了 66 字节的传输层、网络层和数据链路层头部,然后将生成的L数据包通过 155 Mbps 的链路发送出去。忽略流量控制和拥塞控制,因此 A 可以背对背地、连续地发送报文段。
1.17.1 💡 问题解答
以下是对这个问题的详细解答:
1.17.1.1 a. 的最大值
- 理解 TCP 序列号: 题目中提到,TCP 序列号字段(Sequence Number field)有 4 字节。
- 计算序列号空间: 4 字节等于 。一个 32 位的字段可以表示 个唯一的值(从 0 到 )。
- 序列号的含义: 在 TCP 中,序列号是用来标识字节流中的字节的,而不是用来计算报文段的。每个序列号都对应数据流中的一个字节。
- 计算 L 的最大值: 由于有 个唯一的序列号,这意味着在一个序列号循环(即序列号从 回绕到 0)之前,我们最多可以唯一地标识 个字节。如果文件大小 超过这个值,序列号就将被“耗尽”并开始重用(回绕)。
- 结论: 因此,为使 TCP 序列号不被耗尽, 的最大值就是序列号空间的大小。
- (这大约等于 4 GiB 或 4.295 GB)
注意: 这一部分的计算与 MSS(536 字节)无关,因为序列号是按字节计数的。
1.17.1.2 b. 传输文件所需的时间
- 文件大小 (L): 我们使用 (a) 中得到的值:。
- MSS: 每个 TCP 报文段所能携带的最大数据量为 536 字节。
- 计算报文段总数: 我们需要计算传输整个文件需要多少个报文段。
- (使用向上取整,因为最后一个报文段可能不满)
- 计算总传输数据量: 我们需要计算在物理链路上实际发送的总数据量,这包括文件数据()和所有报文段的头部。
- 转换为比特 (bits): 链路速度是以“比特每秒”(bps) 为单位的,所以我们必须将总字节数转换为比特。
- 计算传输时间: 链路速度为 155 Mbps。
1.17.2 答题概要
- a. 的最大值: (或 4,294,967,296 字节)。
- b. 传输时间: 约 248.97 秒。
您需要我解释更多关于 TCP 序列号或传输时间计算的细节吗?
1.18 习题P27(跳过)
主机 A 和 B 经一条 TCP 连接通信,并且主机 B 已经收到了来自 A 的所有字节(注:根据上下文,B 期望收到的下一个字节序号是 127)。
假定主机 A 随后向主机 B 发送两个紧接着的报文段:
- 第一个报文段:包含 80 字节的数据。其序号 (Sequence Number) 是 127,源端口号 (Source Port) 是 302,目的端口号 (Destination Port) 是 80。
- 第二个报文段:包含 40 字节的数据。
规则:无论何时主机 B 接收到来自主机 A 的报文段,它都会发送确认(ACK)。
a. 在从主机 A 发往 B 的第二个报文段中,序号、源端口号和目的端口号各是什么?
- 答: 序号为 207,源端口号为 302,目的端口号为 80。
b. 如果第一个报文段在第二个报文段之前到达,在第一个到达报文段的确认中,确认号、源端口号和目的端口号各是什么?
- 答: 确认号是 207,源端口号是 80,目的端口号是 302。
c. 如果第二个报文段在第一个报文段之前到达,在第一个到达报文段的确认中,确认号是什么?
- 答: 确认号是 127,表示它仍在等待字节 127 及之后。
**d. 假定由 A 发送的两个报文段按序到达 B。第一个确认丢失了而第二个确认在第一个超时间隔之后到达。画出时序图…
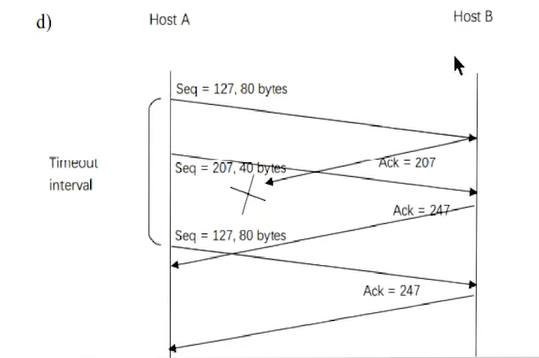
1.18.1 详细解析
初始状态分析:
- 主机 B 期望收到的下一个字节序号 (ExpectedSeqNum) 是 127。
- 主机 A 发送的第一个报文段 (Seg 1):
Seq = 127Data = 80 字节- 该报文段覆盖的字节范围是:[127, 127 + 80 - 1] = [127, 206]
- 主机 A 发送的第二个报文段 (Seg 2):
- TCP 序号是连续的,第二个报文段的序号应紧跟在第一个报文段数据之后。
Seq = 127 + 80= 207Data = 40 字节- 该报文段覆盖的字节范围是:[207, 207 + 40 - 1] = [207, 246]
a) 第二个报文段的详情
- 序号 (Seq Num):如上分析,为 207。
- 源端口 (Source Port):在同一条 TCP 连接中,从 A 发往 B 的所有报文段的源端口和目的端口保持不变。因此,源端口仍为 302。
- 目的端口 (Dest Port):同理,目的端口仍为 80。
- 结论:与答案 (a) 一致。
b) 报文段按序到达 (Seg 1 先到)
- B 收到 Seg 1 (Seq=127):
- B 检查发现,收到的序号 127 与它期望的序号 127 一致。
- B 成功接收该报文段(包含字节 127-206)。
- B 更新其期望的下一个字节序号为:127 + 80 = 207。
- B 发送 ACK:
- 根据 TCP 规则,ACK 报文中的确认号 (Ack Num) 应该是下一个期望收到的字节序号。
- 因此,确认号 = 207。
- 对于 B 发送的 ACK 报文,端口号会交换:源端口(B 的端口)= 80,目的端口(A 的端口)= 302。
- 结论:与答案 (b) 一致。
c) 报文段乱序到达 (Seg 2 先到)
- B 收到 Seg 2 (Seq=207):
- B 检查发现,它期望的序号是 127,但收到的序号是 207。
- 这是一个乱序(out-of-order)的报文段。B 意识到丢失了 Seq=127 的报文段。
- B 可能会缓存 Seg 2(如果 B 实现了该功能)。
- B 发送 ACK:
- 根据 TCP 的规则(特别是用于触发快速重传的机制),当收到一个序号大于期望值的报文段时,接收方必须立即发送一个重复的 ACK (Duplicate ACK)。
- 这个重复 ACK 的确认号 (Ack Num) 必须是它当前仍在等待的那个序号,即 127。
- 这等于在告诉 A:“我收到了一个报文段,但我仍在等待 127 号字节。”
- 结论:与答案 (c) 一致。
1.19 习题P32:TCP往返时间估计
本习题探讨TCP中估计往返时间(ERTT)、偏差(DEV)和重传超时(RTO)间隔的计算方法。
1.19.1 往返时间估计公式
TCP采用指数加权移动平均(EWMA)算法来估计往返时间及其变化:
- 估计往返时间(ERTT):这是对测量往返时间样本(
SampleRTT)的平滑平均值。- 教师指出,的推荐值通常为0.125,但本题可能使用其他值(如0.1)。决定了最新样本与历史平均值的权重分配比例。
- 偏差(DEV):用于衡量实际往返时间与估计平均值的偏离程度。
- 的推荐值通常为0.25,用于控制最新往返时间偏差与历史偏差平均值的权重比例。
- 重传超时(RTO):TCP在重传未确认报文段前等待的时间间隔。
- 增加4倍偏差的余量是为了应对往返时间的波动。
1.19.2 习题拆解与推导
本题要求基于一系列n个往返时间测量样本(其中为最新样本)分析ERTT的计算过程。(注:教师在时间轴上使用索引1、2、3、4表示样本的到达顺序,1为第一个样本,4为最后一个/最新样本。此处采用标准约定,表示最新样本,令。)
1.19.2.1 (a)(b)部分:ERTTₙ的表达式
通过展开递归公式,可将表示为所有历史样本和初始估计值的函数: …… 推广展开式可得:
用求和符号表示为: 该公式表明,是样本1到样本n的加权平均值,同时包含初始估计值相关项。权重随样本陈旧程度(j值减小)呈指数衰减,最新样本的权重最大,为。
1.19.2.2 (c)部分:n趋于无穷大时的极限
需计算。 考虑项,由于,因此。 当时,,初始值的影响随时间逐渐消失。
此时极限为所有历史样本的无穷加权和:
若将教师推导的求和式()中的索引j理解为“时长”(j=1表示最新样本,j=2表示上一个样本,以此类推),则该式准确反映了EWMA计算中对陈旧样本分配的指数衰减权重。当时,权重之和趋近于1。
1.20 习题P40:TCP Reno拥塞控制分析
本习题通过分析TCP Reno拥塞窗口(cwnd)在传输轮次中的变化曲线,理解其在不同阶段的行为特征。
1.20.1 阶段识别
- 慢启动阶段:拥塞窗口呈指数增长,发生在轮次[1, 6]和[23, 26]。
- 拥塞避免阶段:拥塞窗口呈线性增长(约每RTT增加1个最大报文段长度MSS),发生在轮次[6, 16]和[17, 22]。
1.20.2 事件分析
- 第16轮次后:拥塞窗口大幅下降但未降至1,表明发生了快速重传/快速恢复事件,触发条件为收到3个重复确认。
- 慢启动阈值(ssthresh)设置为
cwnd/2 = 42/2 = 21。 - TCP Reno将拥塞窗口设置为慢启动阈值(21),随后进入拥塞避免阶段(线性增长)。(注:部分变体在快速恢复阶段初始会增加3个MSS。图表显示拥塞窗口从约21开始线性增长。)
- 慢启动阈值(ssthresh)设置为
- 第22轮次后:拥塞窗口骤降至1个MSS,表明发生了重传超时。
- 慢启动阈值设置为
cwnd/2 = floor(29/2) = 14。 - 拥塞窗口重置为1个MSS。
- TCP进入慢启动阶段。
- 慢启动阈值设置为
1.20.3 慢启动阈值(ssthresh)数值
- 第1轮次:初始慢启动阈值为32。
- 第18轮次:第16轮次发生3个重复确认事件后,慢启动阈值设置为21,并持续至第18轮次。
- 第24轮次:第22轮次发生超时事件后,慢启动阈值设置为14,并持续至第24轮次。
1.20.4 报文段传输时机
- 第70个报文段:通过累加慢启动阶段各轮次发送的报文段数量确定发送时机:
- 第1轮:1个
- 第2轮:2个(累计3个)
- 第3轮:4个(累计7个)
- 第4轮:8个(累计15个)
- 第5轮:16个(累计31个)
- 第6轮:32个(累计63个)
- 第7轮:拥塞窗口从33开始线性增长,第64个及后续报文段在此轮发送。
- 因此,第70个报文段在第7轮次发送。
1.20.5 TCP Tahoe的行为(假设场景)
本题(i)(j)(k)部分要求分析假设使用TCP Tahoe时的行为。Tahoe将3个重复确认与超时事件同等处理。
- (i)部分 - Tahoe在第19轮次的状态(第16轮次发生3个重复确认后):
- 第16轮次:拥塞窗口=42,触发事件。
- Tahoe将慢启动阈值设置为42/2 = 21。
- Tahoe将拥塞窗口设置为1个MSS,进入慢启动阶段。
- 第17轮:拥塞窗口=1。
- 第18轮:拥塞窗口=2。
- 第19轮:拥塞窗口=4。
- 因此,第19轮次时,慢启动阈值=21,拥塞窗口=4。
- (j)部分 - Tahoe在第26轮次的状态(第22轮次发生超时后):
- 第22轮次:拥塞窗口≈29,触发超时事件。
- Tahoe将慢启动阈值设置为floor(29/2) = 14。
- Tahoe将拥塞窗口设置为1个MSS,进入慢启动阶段。
- 第23轮:拥塞窗口=1。
- 第24轮:拥塞窗口=2。
- 第25轮:拥塞窗口=4。
- 第26轮:拥塞窗口=8。
- 因此,第26轮次时,慢启动阈值=14,拥塞窗口=8。
- (k)部分 - Tahoe在第17-22轮次发送的报文段数量(假设从第16轮次事件开始使用Tahoe):
- 第16轮次Tahoe触发事件后,慢启动阈值=21,拥塞窗口=1:
- 第17轮:发送1个报文段(拥塞窗口=1)。
- 第18轮:发送2个报文段(拥塞窗口=2)。
- 第19轮:发送4个报文段(拥塞窗口=4)。
- 第20轮:发送8个报文段(拥塞窗口=8)。
- 第21轮:发送16个报文段(拥塞窗口=16)。
- 第22轮:发送21个报文段(拥塞窗口达到慢启动阈值21)。
- 第17-22轮次累计发送的报文段数量=1 + 2 + 4 + 8 + 16 + 21 = 52个。
1.21 P43
P43. 主机 A 正在通过 TCP 连接向主机 B 发送一个巨大的文件。在这个连接上,永远不会有数据包丢失,计时器也永远不会超时。将主机 A 连接到互联网的链路传输速率表示为 bps。假设主机 A 中的进程能够以 bps 的速率将数据发送到其 TCP 套接字,其中 。再假设 TCP 接收缓冲区足够大,可以容纳整个文件,而发送缓冲区只能容纳文件的百分之一。
是什么阻止了主机 A 中的进程以 bps 的速率持续将数据传递到其 TCP 套接字?是 TCP 流量控制吗?TCP 拥塞控制?还是其他什么?请详细说明。
1.21.1 题目解答
答案: 阻止主机 A 进程持续以 速率发送数据的是有限的 TCP 发送缓冲区 (Send Buffer),这既不属于 TCP 流量控制,也不属于 TCP 拥塞控制。
详细阐述:
-
分析问题中的三个关键部分:
- 应用程序进程 (Process in Host A): 试图以 的速率向 TCP 套接字(Socket)写入数据。
- TCP 发送缓冲区 (Send Buffer): 位于主机 A 的操作系统内核中。它是一个有限大小的缓冲区(文件大小的 1%),用于临时存储应用程序写入、但尚未被网络发送出去的数据。
- 网络链路 (Link): 只能以 的速率将数据从发送缓冲区发送出去。
-
核心机制:
- 应用程序进程以 的速率“推”数据到发送缓冲区。
- TCP 协议栈以 的速率从发送缓冲区“拉”数据并发往网络。
- 由于 ,进程填充缓冲区的速率是 TCP 协议栈清空缓冲区速率的 10 倍。
- 尽管发送缓冲区可以容纳“巨大文件”的 1%,但它终究是有限的。因此,这个缓冲区将非常迅速地被填满。
- 当 TCP 发送缓冲区满时,操作系统会执行一个关键操作:它会阻塞 (block) 试图向套接字写入更多数据的应用程序进程。该进程的
write()系统调用将不会立即返回,而是会暂停(使进程进入睡眠状态)。 - 只有当 TCP 协议栈以速率 成功将一些数据发送出去,并从缓冲区中清除了这些数据(通常在收到接收方的 ACK 确认后),缓冲区才会腾出空间。这时,操作系统才会唤醒被阻塞的进程,允许它向缓冲区再写入少量数据,然后进程可能再次被阻塞。
- 因此,尽管进程有能力以 速率发送,但由于发送缓冲区这个“中转站”的容量有限且出口()狭窄,它被强制“走走停停”。从长远来看,该进程向套接字写入数据的平均速率将被迫降低到与链路的传输速率 相匹配。
-
为什么不是 TCP 流量控制?
- TCP 流量控制(Flow Control)是用于防止发送方(主机 A)淹没接收方(主机 B)的接收缓冲区。
- 它通过接收方在 ACK 包中通告其接收窗口(
rwnd)大小来实现。 - 题目中明确指出“TCP 接收缓冲区足够大,可以容纳整个文件”,这意味着
rwnd将始终非常大,绝不会成为限制因素。
-
为什么不是 TCP 拥塞控制?
- TCP 拥塞控制(Congestion Control)是用于防止发送方淹没网络(即路由器和链路)。
- 它通过拥塞窗口(
cwnd)来限制发送速率,并根据“数据包丢失”或“超时”等网络拥塞信号来动态调整cwnd。 - 题目中明确指出“永远不会有数据包丢失,计时器也永远不会超时”,这表明网络中没有发生拥塞。因此,
cwnd会持续增长,也不会成为限制因素。
结论: 真正的瓶颈在于主机 A 本地:应用程序的写入速率()远远超过了本地网络接口的发送速率(),导致数据在有限的发送缓冲区中堆积。当缓冲区满时,操作系统会阻塞该应用程序,从而将其实际平均发送速率限制在 。
1.22 习题P47:TCP吞吐量公式
本习题基于拥塞避免阶段的理想化锯齿模型,推导并分析TCP吞吐量与窗口大小(W)、往返时间(RTT)和丢包率(L)之间的关系。
1.22.1 锯齿模型
TCP拥塞避免阶段的窗口大小通常在最小值(丢包后为W/2)和最大值(丢包前为W)之间线性波动。
1.22.2 平均吞吐量(近似公式)
一个锯齿周期内的平均窗口大小约为。 平均吞吐量(T)大致等于平均窗口大小除以往返时间:
1.22.3 一个周期内发送的报文段数量(N)推导
计算一个周期内(窗口从W/2线性增长至W)发送的总报文段数量(N)。各轮次对应的窗口大小为W/2、W/2+1、……、W。 这是一个等差数列求和问题。 项数(轮次)= 。 和 当窗口大小W较大时,可近似为:
1.22.4 丢包率(L)
在该理想化模型中,每个周期(窗口大小达到W时)恰好发生一次丢包事件,触发窗口减小。 丢包率(L)等于丢包数量除以发送的总报文段数量:
1.22.5 窗口大小(W)与丢包率(L)的关系
由丢包率公式可推导出最大窗口大小W关于丢包率L的表达式:
1.22.6 吞吐量与丢包率的公式
将W关于L的表达式代入吞吐量近似公式(): 数值上,,因此: 若吞吐量T以比特每秒(bps)为单位,最大报文段长度MSS以比特为单位,则:
1.23 习题P53:吞吐量公式的应用
本习题将推导的公式应用于具体场景。
1.23.1 场景参数
- 最大报文段长度(MSS)= 1500字节 = 12000比特
- 往返时间(RTT)= 100毫秒 = 0.1秒
- 丢包率(L)=
1.23.2 计算过程
使用公式计算最大可实现的平均吞吐量:
1.23.3 分析与启示
- 计算结果表明,在丢包率极低()的情况下,遵循理想化模型的TCP在100毫秒RTT的链路中可实现约10.35吉比特/秒的吞吐量。
- 高速传输需求:公式表明,要实现更高的吞吐量,丢包率必须大幅降低。例如,要达到100吉比特/秒的吞吐量,计算显示丢包率需降至约。
- 基于丢包的拥塞控制局限性:如此极低的丢包率(至)已接近物理链路(尤其是光纤)的固有误码率。这意味着在高速低误码网络中,报文段丢失更可能由随机传输错误导致,而非实际的网络拥塞。
- TCP响应机制的不合理性:标准TCP将任何丢包都视为拥塞,并通过减小窗口大小应对。若丢包源于传输错误,这种窗口减小操作并无必要,反而会人为限制吞吐量,导致TCP无法充分利用高速链路。这凸显了传统基于丢包的拥塞控制在现代高带宽-延迟积(BDP)网络中面临的根本性挑战。
P51 恢复时间T和平均吞吐量的函数
P51. 令 (以 RTT 衡量)表示一个 TCP 连接将其拥塞窗口大小从 增加到 所需的时间间隔,其中 是最大拥塞窗口大小。请论证 是 TCP 平均吞吐量的一个函数。
题目解答
这是一个关于 TCP 拥塞控制(特别是拥塞避免阶段)中各参数之间关系的论证题。
核心论点: 确实是 TCP 平均吞吐量的一个函数。我们可以通过分别推导 和平均吞吐量()的表达式,然后将它们关联起来,从而证明这一点。
论证步骤:
-
分析时间间隔
- 题目描述的窗口大小从 增长到 的阶段,是 TCP(特指 TCP Reno/NewReno 模型)的拥塞避免 (Congestion Avoidance) 阶段。
- 在此阶段,TCP 的拥塞窗口(
cwnd)每个 RTT(Round Trip Time,往返时间)增加 1 MSS(Maximum Segment Size,最大报文段大小)。 - 我们需要
cwnd增长的量为: (以 MSS 为单位)。 - 由于每 1 个 RTT 才增长 1 MSS,那么增长 (MSS) 所需的 RTT 数量就是 次。
- 因此,总的时间间隔 (以秒为单位)等于 RTT 的次数乘以每次 RTT 的时长: (公式 1)
-
分析 TCP 平均吞吐量 (Average Throughput)
- 在拥塞避免阶段,
cwnd在 和 之间呈锯齿状线性增长。 - 我们可以估算这个周期的平均拥塞窗口大小为: (以 MSS 为单位)
- TCP 的平均吞吐量(,以 MSS/秒 为单位)可以定义为在一个 RTT 内平均发送的数据量(即平均窗口大小)除以 RTT 时长:
- 整理得到: (公式 2)
- 在拥塞避免阶段,
-
建立 与 的函数关系
- 我们的目标是证明 。我们可以通过联立公式 1 和公式 2 来实现。
- 从 公式 2 中,我们可以解出 :
- 现在,将这个 的表达式代入 公式 1 中:
- 化简上式,我们得到:
结论:
我们成功地推导出了 。
这个表达式清楚地表明,时间间隔 是最大窗口大小 和平均吞吐量 的函数。因此,论证成立。
As TCP’s average throughput is given by , so we know that,
Since between two consecutive packet losses, there are packets sent by the TCP sender, thus, . Thus, we find that , that is, is a function of .
2.3 P45 P46 TCP Reno和 TCP Cubic
2.3.1 题目翻译
P45. 再次考虑图 3.54。假设在 时刻,下一次发生拥塞丢失的发送速率(当然,TCP 发送方并不知道这一点)下降到 。展示 TCP Reno 和 TCP CUBIC 各自后续两个“轮次”(rounds)的演变。(提示:请注意,TCP Reno 和 TCP CUBIC 对拥塞丢失做出反应的时刻可能不再相同。)
P46. 再次考虑图 3.54。假设在 时刻,下一次发生拥塞丢失的发送速率增加到 。展示 TCP Reno 和 TCP CUBIC 各自后续两个“轮次”的演变。(提示:参见 P45 中的提示。)
2.3.2 解题分析与假设
要解答这两个问题,我们必须首先对图 3.54 中 时刻的状态做出关键假设,因为我们没有看到原图。
核心假设: 基于 TCP 拥塞控制的典型行为(如图 3.54 所示), 时刻是 TCP Reno 和 TCP CUBIC 同时 经历了拥塞丢失事件的时刻。
- 事件发生前( 之前): 两个协议的拥塞窗口 (cwnd) 都达到了 ,并触发了丢包。
- 事件发生后( 时刻,我们的分析起点): 两个协议都会减小其窗口:
- TCP Reno: 执行乘法减小 (Multiplicative Decrease)。它的
cwnd变为 。然后它进入“拥塞避免”阶段,开始线性(加法)增长。 - TCP CUBIC: 也执行乘法减小。它将 (即它的目标窗口)设置为 (刚刚导致丢包的值)。它的
cwnd变为 。 (beta) 是一个常数,通常设为 0.7。(我们将使用 进行分析)。因此,CUBIC 的cwnd变为 。然后它开始按照其**立方函数(S形)**增长。
- TCP Reno: 执行乘法减小 (Multiplicative Decrease)。它的
所以,在我们的分析开始时( 刚过):
- Reno:
cwnd= (线性增长) - CUBIC:
cwnd= (立方增长)
2.3.3 P45 解答:新瓶颈下降到
新条件: 任何协议的 cwnd 只要一达到 就会立即触发丢包。
2.3.3.1 第 1 轮演变
-
CUBIC:
- 它从 开始增长。
- 它的目标是原先的 ,所以它处于其立方曲线的“凹”形(缓慢增长)阶段。
- 然而,它非常接近新的丢包阈值 。
- 它会首先达到 并触发丢包。
- CUBIC 丢包事件(第 1 次):
cwnd降至 。它的新目标 被设置为 。
-
Reno:
- 它从 开始线性增长。
- 在 CUBIC 经历丢包时,Reno 的
cwnd仍在 和 之间(例如,可能在 处)。 - Reno 继续其缓慢的线性增长,最终(在 CUBIC 之后)也达到了 并触发丢包。
- Reno 丢包事件(第 1 次):
cwnd降至 。
2.3.3.2 第 2 轮演变
-
CUBIC (Round 2):
- 从 开始,向其新目标 进行立方增长。
- 达到 并丢包。
- CUBIC 丢包事件(第 2 次):
cwnd再次降至 。
-
Reno (Round 2):
- 从 开始,向 线性增长。
- 达到 并丢包。
- Reno 丢包事件(第 2 次):
cwnd再次降至 。
P45 结论: 两个协议都适应了更低的瓶颈。它们将以不同的时间点(异步)发生丢包。
- TCP Reno 将在一个较低的窗口范围(在 和 之间)振荡。
- TCP CUBIC 将在一个较高的窗口范围(在 和 之间)振荡,因此将获得比 Reno 更高的平均吞吐量。
2.3.4 P46 解答:新瓶颈上升到
新条件: cwnd 必须达到 才会触发丢包。
2.3.4.1 第 1 轮演变
-
Reno:
- 从 开始线性增长。
- 它将平稳地增长,经过原先的 点,一直增长到 才停止。
- Reno 丢包事件(第 1 次): 达到 后,
cwnd降至 。
-
CUBIC:
- 从 开始,向其旧目标 进行立方增长(凹形/慢速)。
- 当它达到 时,它并不会丢包。
- CUBIC 关键行为: 一旦 CUBIC 达到其先前记录的 ,它会进入“最大值探测”(max probing)阶段,切换到凸形(快速) 增长曲线,积极地探测新带宽。
- 这种凸形(快速)增长比 Reno 的线性增长快得多。
- 因此,CUBIC 将首先(远在 Reno 之前)达到新的 瓶颈并触发丢包。
- CUBIC 丢包事件(第 1 次): 达到 后,它将 更新为 。
cwnd降至 。
2.3.4.2 第 2 轮演变
-
Reno (Round 2):
- 从 开始,向 线性增长。
- 达到 并丢包。
- Reno 丢包事件(第 2 次):
cwnd再次降至 。
-
CUBIC (Round 2):
- 从 开始,向其新目标 进行立方增长(凹形/慢速阶段,因为它在目标 之下)。
- 达到 并丢包。
- CUBIC 丢包事件(第 2 次):
cwnd再次降至 。
P46 结论: 两个协议都成功地适应了更高的瓶颈带宽,但 CUBIC 的适应速度快得多。
- TCP Reno 将在 和 之间进行线性振荡。
- TCP CUBIC 将在 和 之间进行(S形)振荡。
- CUBIC 再次稳定在更高的窗口范围,从而获得更高的吞吐量。这展示了 CUBIC 在高带宽延迟(长肥)网络中优于 Reno 的设计目的。
P52 不公平的TCP
P52. 考虑一个简化的 TCP AIMD 算法,其中拥塞窗口大小以“报文段数量”而不是“字节”来衡量。在“加法增大”(AI)阶段,拥塞窗口大小在每个 RTT 内增加一个报文段。在“乘法减小”(MD)阶段,拥塞窗口大小减少一半(如果结果不是整数,则向下取整到最近的整数)。
假设有两个 TCP 连接 和 共享一条拥塞链路,其速率为 30 报文段/秒。假设 和 都处于拥塞避免阶段。连接 的 RTT 是 50 毫秒,连接 的 RTT 是 100 毫秒。假设当链路上的数据速率超过链路速率时,所有 TCP 连接都会经历数据报文段丢失。
a. 如果在 时刻, 和 的拥塞窗口都是 10 个报文段,那么在 1000 毫秒后,它们的拥塞窗口大小各是多少? b. 从长远来看,这两个连接会获得这条拥塞链路的相同份额的带宽吗?请解释。
题目解答
a. 1000 毫秒后的拥塞窗口大小
1. 确定丢包条件: 首先,我们必须根据给定的 RTT 和链路速率计算何时发生丢包。
- 连接 的 RTT
- 连接 的 RTT
- 链路最大速率 = 30 报文段/秒
一个连接的发送速率 是其拥塞窗口 除以其 : 。
- 的速率 (报文段/秒)
- 的速率 (报文段/秒)
总速率 。 根据题意,当总速率超过 30 报文段/秒时,发生丢包。 丢包条件: ,或者简化为: 。
2. 模拟 时刻():
- 初始状态:。
- 计算指标:。
- 并不大于 。
- 等一下,让我们检查原始速率: 报文段/秒。
- 。因此,在 时刻立即发生丢包。
3. 模拟丢包级联 (Loss Cascade): 丢包事件发生时,两个连接都会执行“乘法减小”。
- (第 1 次丢包): 状态 。 。
- 立即重新检查: 状态 。 。再次丢包!
- 立即重新检查: 状态 。 。再次丢包!
- 立即重新检查: 状态 。 。 不大于 。
- 级联停止。 在 时刻,窗口大小迅速崩溃并稳定在 。
4. 模拟 到 毫秒: 我们从 时的状态 开始。 每 50ms 增加 1, 每 100ms 增加 1。
- : 状态 。指标 = 3。(安全)
- :
- RTT 结束, 。
- 状态变为 。
- 检查指标:。 。丢包!
- 时状态为 。指标 = 。(安全)
- :
- RTT 结束 (50+50), 。
- RTT 结束 (0+100), 。
- 状态变为 。
- 检查指标:。 。丢包!
- 时状态为 。指标 = 2。(安全)
- :
- RTT 结束, 。
- 状态变为 。
- 检查指标:。 。丢包!
- 时状态为 。指标 = 2。(安全)
- :
- RTT 结束, 。
- RTT 结束, 。
- 状态变为 。
- 检查指标:。 。丢包!
- 状态重置为 。
5. 观察模式并得出结论: 系统陷入了一个非常快速的振荡循环中。
- 在每个 的时刻点(100, 200, …, 1000), 和 同时尝试增加窗口,导致状态变为 ,这立即引发丢包,使状态重置为 。
- 在每个 的时刻点(50, 150, …, 950), 尝试增加窗口,导致状态变为 ,这也立即引发丢包,使状态重置为 。
问题询问 1000 毫秒之后的窗口大小。
- 在 毫秒时,系统进入 状态,触发了一次丢包事件。
- 该事件处理完毕后(即“之后”),窗口大小被重置。
答案 (a): 在 1000 毫秒后,拥塞窗口大小为:
- 个报文段
- 个报文段
b. 长期带宽份额
答案 (b): 不,从长远来看,这两个连接不会获得相同的带宽份额。
解释: TCP 的 AIMD 机制在与具有不同 RTT 的连接共享瓶颈时,会表现出“RTT 偏见”(RTT bias)。
- 加法增大 (AI) 阶段: 两个连接都在拥塞避免阶段,即“每个 RTT 窗口大小+1”。
- 每 50ms 增加 1 个报文段。
- 每 100ms 增加 1 个报文段。
- 窗口增长速率: 增加其窗口的频率是 的两倍。
- 乘法减小 (MD) 阶段: 当发生丢包时,两个连接同时将其窗口减半。这是一个成比例的缩减,它并不会改变它们之间的相对不平衡。
- 恢复速度: 在丢包后,两个连接都返回 AI 阶段。由于 的窗口增长频率是 的两倍,它将更快地恢复其窗口大小。
- 长期结果: 这种“恢复更快”的特性会累积。 在每个 AIMD 周期中“抢占”带宽的能力都强于 。
结论: 一个 TCP 连接的平均吞吐量(带宽)与其 成反比关系(即 )。 由于 ,我们可以预期 获得的长期平均带宽大约是 的两倍。
(我们在 (a) 中看到的 状态是这种不公平性在由本题奇怪参数(极低带宽)导致的极端、简并情况下的体现。)
P56 长时间不用的TCP
P56. 在我们 3.7 节对 TCP 拥塞控制的讨论中,我们隐含地假设了 TCP 发送方总是有数据要发送。现在考虑这样一种情况:TCP 发送方在 时刻发送了大量数据,然后进入空闲状态(因为它没有更多数据要发送了)。TCP 保持空闲状态一段相对较长的时间,然后在 时刻又想发送更多数据。
在 时刻开始发送数据时,让 TCP 使用 时刻的 (拥塞窗口)和 (慢启动阈值)值有什么优点和缺点?你会推荐什么替代方案?为什么?
题目解答
这是一个关于 TCP 如何处理“陈旧”拥塞状态信息的问题。
1. 使用 时刻旧值的优缺点
优点:
- 快速启动(Ramp-up): 唯一的潜在优点是,如果(这是一个非常大的“如果”)从 到 期间网络路径的可用带宽恰好没有变化,那么 TCP 就可以立即以 时的高速率(由大的 决定)开始发送数据,跳过缓慢的慢启动过程。
缺点(非常严重):
- 陈旧的状态信息: 网络条件是动态变化的。“一段相对较长的时间”意味着 时刻的网络状态(如可用带宽、其他竞争流量等)到了 时刻几乎肯定已经失效了。
- 导致拥塞崩溃: 时刻的 可能非常大(例如 100 MSS)。如果在 时刻,由于新的竞争流量加入,链路的实际可用带宽已经变得很小(例如 10 MSS),此时 TCP 突然向网络中注入一个 MSS 的数据突发,将会立即压垮路径上的路由器缓冲区,导致大规模的数据包丢失。
- 对网络不友好: 这种突发的行为对网络中的其他 TCP 连接是“不友好”的,它会抢占所有带宽并导致其他连接也经历丢包。
- 性能适得其反: 这种大规模丢包将导致发送方超时(Timeout),并强制 TCP 将其 剧降至 1 MSS,并将 减半,进入一个非常缓慢的恢复过程。其最终结果远不如一开始就采用更保守的策略。
2. 推荐的替代方案及原因
推荐方案:慢启动重启 (Slow Start Restart)
我推荐的替代方案是:当 TCP 连接在空闲一段较长时间(通常定义为超过一个 RTO——重传超时时间)后,它不应该重用旧的 值。
相反,它应该:
- 将拥塞窗口 重置为 1 MSS(或者现代 TCP 中的一个较小的初始窗口 值,如 10 MSS)。
- 重新进入“慢启动”(Slow Start)阶段。
- (对于 :可以保留旧值,也可以将其降低。关键在于重置 。保留旧的 可以让慢启动阶段更快地过渡到拥塞避免阶段,但核心的 重置是必须的。)
原因:
- 安全性(核心原因): 时的 是一个“陈旧的、未经证实的”值。在长时间空闲后,TCP 必须假设网络路径的容量是未知的。将 重置为 1 MSS 是探测网络可用带宽的唯一安全的方法。
- 适应性: 该方案强制 TCP 重新探测和发现路径的当前可用容量,而不是盲目地依赖过时信息。这使得 TCP 能够适应网络负载的动态变化。
- 避免拥塞: 这种机制可以防止因发送一个基于陈旧 的巨大数据突发而导致的自发性拥塞崩溃。
P57
P57. 在这个问题中,我们来探究 UDP 或 TCP 是否提供了某种程度的端点认证。
a. 考虑一个服务器接收到一个 UDP 包中的请求,并用一个 UDP 包响应这个请求(例如,像 DNS 服务器所做的那样)。如果一个 IP 地址为 X 的客户端将其地址伪装成地址 Y,服务器会将其响应发送到哪里?
b. 假设一个服务器收到了一个源 IP 地址为 Y 的 SYN 包,在响应了一个 SYNACK 包之后,又收到了一个源 IP 地址为 Y 且带有正确确认号的 ACK 包。假设服务器选择了一个随机的初始序列号,并且没有“中间人”攻击,那么服务器能否确定该客户端确实在 Y(而不是在某个伪装成 Y 的其他地址 X)?
题目解答
a. UDP 的情况
服务器会将其响应发送到 IP 地址 Y。
解释: UDP 是一种无连接、无状态的协议。当服务器收到一个 UDP 请求包时,它只是简单地查看该数据包的 IP 头部以获取“源 IP 地址”和 UDP 头部以获取“源端口号”。
在这个场景中,数据包的源 IP 地址被伪装成了 Y。服务器并不知道客户端 X 的真实存在。它会认为这个请求就是来自 Y,因此它会构建一个响应包,并将这个响应包的目的 IP 地址设置为 Y(即它在请求包中看到的源 IP 地址)。
结论: 这表明 UDP 本身不提供任何端点认证。任何人都可以伪造一个源 IP 地址来发送 UDP 请求。
b. TCP 的情况
是的,服务器可以非常确定(can be certain) 该客户端确实在 Y。
解释: 这正是 TCP 的三次握手 (Three-Way Handshake) 机制提供的基础认证功能。
- 随机序列号 (ISN): 当服务器收到来自 Y 的 SYN 请求时,它会生成一个随机的初始序列号(ISN),我们称之为 。
- SYNACK 的发送: 服务器将这个 放在 SYNACK 包的序列号字段中,并将这个包发送到地址 Y。
- 攻击者的盲点: 伪装者 X 并不在地址 Y。由于题目排除了“中间人”攻击,攻击者 X 无法拦截或窃听这个发送到 Y 的 SYNACK 包。因此,攻击者 X 无法知道服务器生成的那个随机值 是多少。
- ACK 的验证: 要完成三次握手,客户端必须发回一个 ACK 包,其确认号(Acknowledgment Number)必须是 。
- 结论:
- 由于 是随机且不可预测的,攻击者 X 无法猜出这个正确的值。
- 因此,如果服务器收到了一个源地址为 Y 且包含正确确认号()的 ACK 包,它就可以高度确信,这个包的发送者一定是那个真正收到了 SYNACK 包的实体。
- 因为 SYNACK 包只被发送到了地址 Y,所以回应者必定在地址 Y。
结论: TCP 的三次握手提供了一种端点认证,它验证了客户端至少有能力接收发送到其声明的 IP 地址(Y)的数据包。
2 张渊的题
这次的题目都还很有意思
2.1 P37
Compare GBN, SR, and TCP (no delayed ACK). Assume that the timeout values for all three protocols are sufficiently long such that five consecutive data segments and their corresponding ACKs can be received (if not lost in the channel) by the receiving host (Host B) and the sending host (Host A) respectively. Suppose Host A sends five data segments to Host B, and the second segment (sent from A) is lost. In the end, all five data segments have been correctly received by Host B.
a. How many segments has Host A sent in total and how many ACKs has Host B sent in total? What are their sequence numbers? Answer this question for all three protocols.
b. If the timeout values for all three protocol are much longer than 5 RTT, then which protocol successfully delivers all five data segments in shortest time interval?
a) GoBackN:
- A sends 9 segments in total. They are initially sent segments 1, 2, 3, 4, 5 and later re-sent segments 2, 3, 4, and 5.
- B sends 8 ACKs. They are 4 ACKS with sequence number 1, and 4 ACKS with sequence numbers 2, 3, 4, and 5.
Selective Repeat:
- A sends 6 segments in total. They are initially sent segments 1, 2, 3, 4, 5 and later re-sent segments 2.
- B sends 5 ACKs. They are 4 ACKS with sequence number 1, 3, 4, 5. And there is one ACK with sequence number 2.
TCP:
- A sends 6 segments in total. They are initially sent segments 1, 2, 3, 4, 5 and later re-sent segments 2.
- B sends 5 ACKs. They are 4 ACKS with sequence number 2. There is one ACK with sequence numbers 6. Note that TCP always send an ACK with expected sequence number.
b) TCP. This is because TCP uses fast retransmit without waiting until time out.
2.2 P48
Consider that only a single TCP (Reno) connection uses one 10 Mbps link which does not buffer any data. Suppose that this link is the only congested link between the sending and receiving hosts. Assume that the TCP sender has a huge file to send to the receiver, and the receiver’s receive buffer is much larger than the congestion window. We also make the following assumptions: each TCP segment size is 1,500 bytes; the two-way propagation delay of this connection is 150 msec; and this TCP connection is always in congestion avoidance phase, that is, ignore slow start.
a. What is the maximum window size (in segments) that this TCP connection can achieve?
b. What is the average window size (in segments) and average throughput (in bps) of this TCP connection?
c. How long would it take for this TCP connection to reach its maximum window again after recovering from a packet loss?
a) Let denote the max window size measured in segments. Then, , as packets will be dropped if the maximum sending rate exceeds link capacity. Thus, we have , then is about 125 segments.
b) As congestion window size varies from to , then the average window size is (ceiling of 93.75) segments. Average throughput is .
c) When there is a packet loss, becomes , i.e., . seconds, as the number of RTTs (that this TCP connections needs in order to increase its window size from 62 to 125) is 63. Recall the window size increases by one in each RTT.
2.4 P54
Consider a modification to TCP’s congestion control algorithm. Instead of additive increase, we can use multiplicative increase. A TCP sender increases its window size by a small positive constant () whenever it receives a valid ACK. Find the functional relationship between loss rate and maximum congestion window . Argue that for this modified TCP, regardless of TCP’s average throughput, a TCP connection always spends the same amount of time to increase its congestion window size from to .
Note that represents the maximum window size. First we can find the total number of segments sent out during the interval when TCP changes its window size from up to and include . This is given by: We find , then .
Loss rate is given by:
The time that TCP takes to increase its window size from to is given by: which is clearly independent of TCP’s average throughput.
Note, TCP’s average throughput is given by:
Note that this is different from TCP which has average throughput: , where the square root of appears in the denominator.
2.5 P58
In this problem, we consider the delay introduced by the TCP slow-start phase. Consider a client and a Web server directly connected by one link of rate . Suppose the client wants to retrieve an object whose size is exactly equal to , where is the maximum segment size (MSS). Denote the round-trip time between client and server as RTT (assumed to be constant). Ignoring protocol headers, determine the time to retrieve the object (including TCP connection establishment) when
a.
b.
c. .
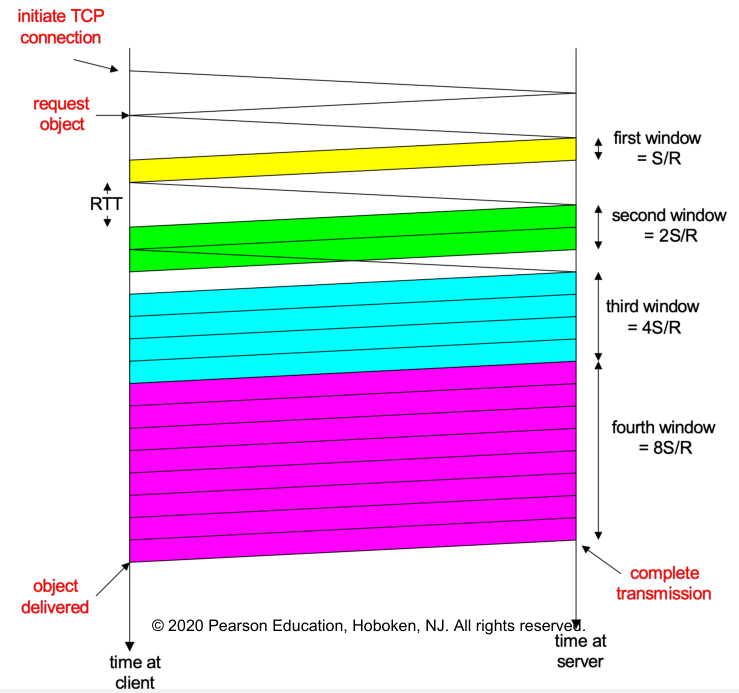
a) Referring to the figure below, we see that the total delay is
b) Similarly, the delay in this case is:
c) Similarly, the delay in this case is: