1 导论
前三章我们主要关注的是网络边缘的各种协议和应用,现在我们将进入网络的核心——网络层。
本课程的教材与旧版教材在章节安排上有一个显著的区别:它将网络层的内容分成了两个独立的章节。
- 第四章:网络层:数据平面 本章将首先介绍网络层的 数据平面 (Data Plane)。数据平面关注的是当一个数据包到达路由器时,路由器如何根据转发表将其从输入端口转发到正确的输出端口。这更多是本地的、具体的转发行为。
- 第五章:网络层:控制平面 下一章将介绍 控制平面 (Control Plane)。控制平面则关注的是网络宏观的、全局性的问题,即如何通过路由算法计算出路由表和转发表,从而确定数据包从源端到目的端的路径。
1.1 网络层服务
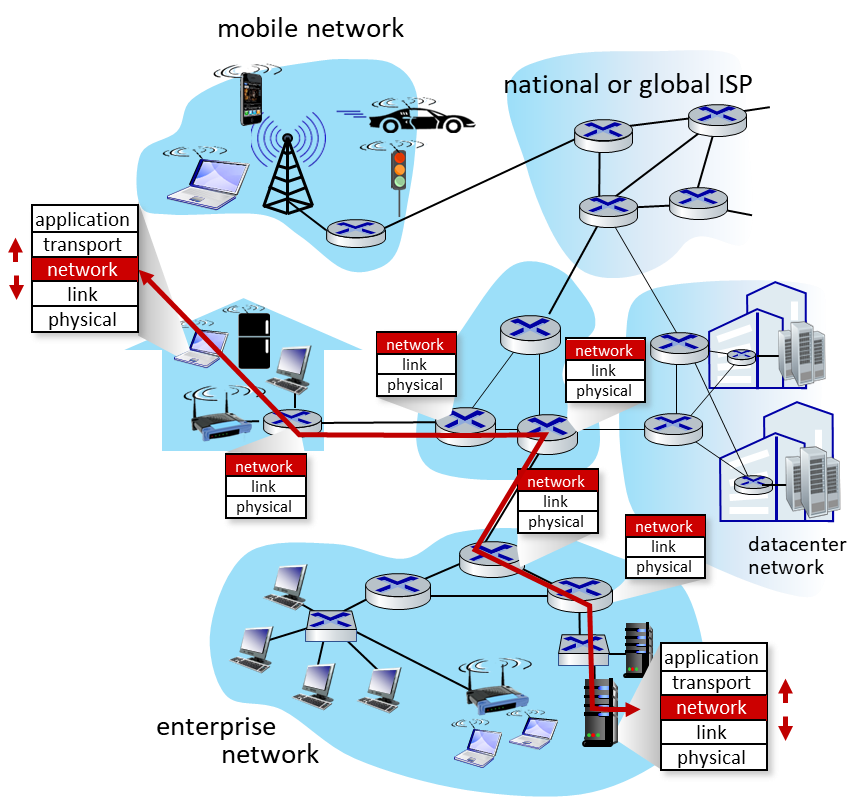
网络层最核心的服务,就是将一个报文段 (segment) 从发送方主机移动到接收方主机。这个过程可以分解为以下几个步骤:
- 发送端:在发送端,网络层接收来自传输层的报文段,并将其封装成 数据报 (datagram)。
- 中间过程:数据报经过网络中的一系列路由器,每个路由器都会检查其头部信息,以决定如何将其转发到下一个节点。
- 接收端:在接收端,网络层从数据报中提取出报文段,并将其交付给传输层。
- 在发送主机和接收主机对之间 传送 段 (segment)
- 在发送端将 段 封装到 数据报 中
- 在接收端,将段上交给传输层 实体
- 网络层协议存在于 每一个主机 和路由器
- 路由器检查每一个经过它的IP 数据报的头部
- 报是传输层封装好的分组
- 网络层在报的基础上加上首部就成了数据报
- 网络层的每个路由器都需要将分组传递到网络层解析后才能决定转发到哪个路由器
- “host-to-host communication”: transport segment from sending host to receiving host
- sender: encapsulates segments into datagrams (数据报), passes to link layer
- receiver: delivers segments to transport layer protocol
- network layer protocols in every Internet device: hosts, routers
- Routers (路由器):
- examines header fields in all IP datagrams passing through it
- moves datagrams from input ports to output ports to transfer datagrams along end-end path
1.2 网络层功能
功能不同于服务,服务是对外的结构,功能是内部实现的逻辑
网络层有两个最核心、最重要的功能:转发 (Forwarding) 和 路由 (Routing)。
网络层功能:
- 转发: 将分组从路由器的输入接口转发到合适的输出接口
- 转发是局部的,只是当前路由器决定接受到的分组往后传递给哪个路由器;属于数据平面
- 一般是硬件实现,只要几毫秒
- 路由: 使用路由算法来决定分组从发送主机到目标接收主机的路径
- 路由选择算法
- 路由选择协议
- 需要软件实现,一般需要几秒
路由是控制平面,转发是数据平面
- Data plane:
- local, per-router function
- determines how datagram arriving on router input port is forwarded to router output port
- Control plane
- network-wide logic
- determines how datagram is routed among routers along end-end path from source host to destination host
- two control-plane approaches:
- traditional routing algorithms: implemented in routers
- software-defined networking (SDN): implemented in (remote) servers
Routing table and forwarding table
A router has both routing table and forwarding table. What are their differences? Where are they stored respectively?
功能区别:路由表(RIB)位于控制平面,包含路由协议学到的所有路径并负责计算最佳路径;而转发表(FIB)位于数据平面,是根据路由表生成的精简优化版,专用于硬件高速转发数据包。
存储位置:路由表通常存储在主处理器的**内存(RAM)中;而转发表通常存储在接口线卡的专用高速硬件存储器(如 TCAM)**中。
1.3 数据平面和控制平面
- 数据平面
- 本地,每个路由器功能
- 决定从路由器输入端口到达的分组如何转发到输出端口
- 转发功能:
- 传统方式:基于目标 地址+转发表
- SDN方式:基于 多个字段 +流表
可以回过头来看看区别在哪
- 控制平面
- 网络范围内的逻辑
- 决定数据报如何在路由器之间 路由,决定数据报从源到目标主机之间的端到端路径
- 2个控制平面方法:
- 传统的路由算法: 在路由器中被实现(功能单一:根据目标的IP地址进行转发)
- software-defined networking (SDN): 在远程的服务器中实现(匹配很多字段,功能更多:泛洪、转发、修改字段)
1.3.1 数据平面
数据平面的主要功能是在每个路由器本地执行的,它决定如何将到达输入端口的数据报转发到相应的输出端口。这个过程也被称为“转发”或“交换”。
- 核心任务:将数据从输入链路转发到输出链路。
- 实现方式:基于转发表或流表进行。
- 特点:动作速度快,通常在纳秒级别完成。
1.3.2 控制平面
控制平面负责网络范围内的逻辑,它决定数据报如何在路由器之间进行路由,并最终确定从源主机到目的主机的端到端路径。
- 核心任务:计算并生成用于数据平面的转发表或流表。
- 实现方式:通过运行路由选择协议来实现。
- 特点:动作时间尺度更长(秒级),可以看作是网络的“大脑”。
1.3.3 传统路由方式 (Per-router Control)
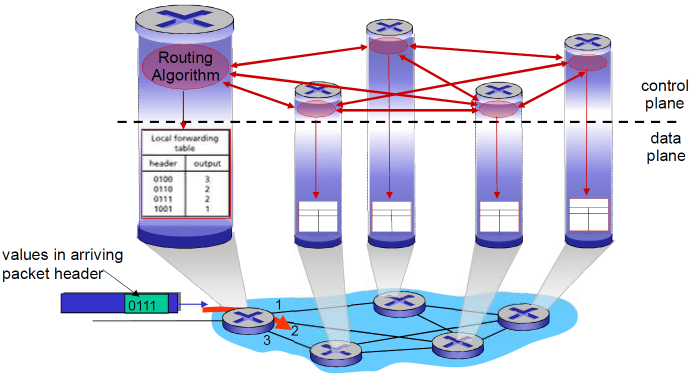
- 在这种方式下,每个路由器都包含一个路由算法组件。这些组件在所有路由器之间相互通信,共同计算出各自的转发表。这是一种分布式的、在每个路由器上独立进行计算的方法。
- 控制面和数据平面的功能一起实现,分布式计算转发表
- 缺点就是不好修改后续的路由协议
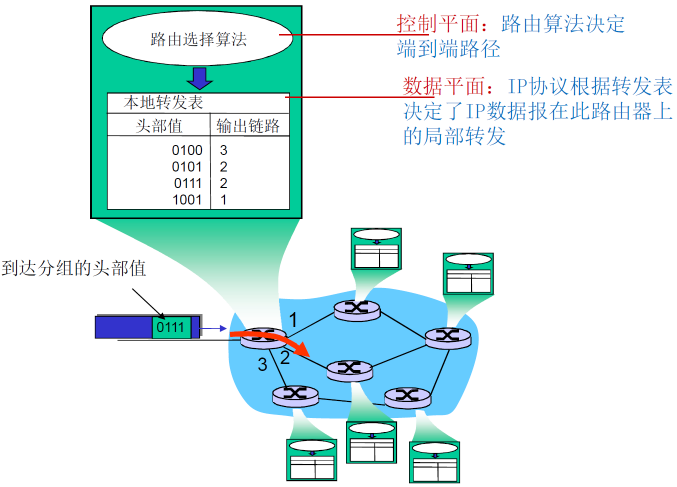
传统方式:每-路由器(Per-router)控制平面
对于TCP/IP网络来说:
- IP协议实现了数据层面的转发功能
- 路由选择协议实体的实现体现了控制层面的路由功能
控制平面的结果体现在路由表,路由表交给IP协议,IP协议对到来的分组转发
路由表是控制平面和数据平面的粘合机
缺点:
- 控制平面和数据平面紧耦合,在一个设备上实现
- 计算路由表是分布式的
更改路由协议非常很难
1.3.4 软件定义网络 (SDN, Software-Defined Networking)
SDN方式:逻辑集中的控制平面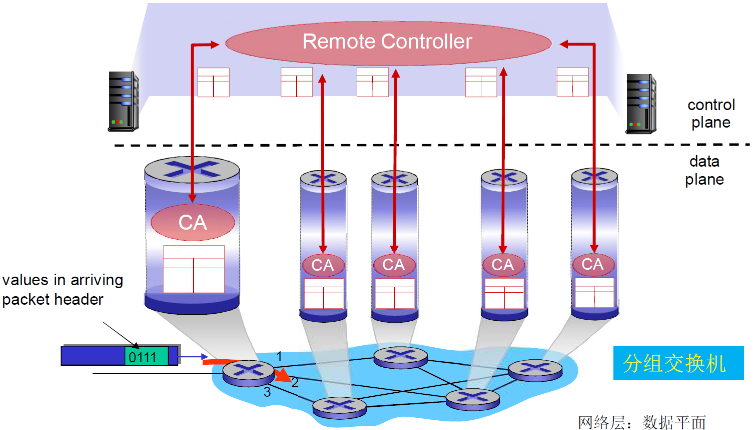
-
一个不同的(通常是远程的)控制器与本地控制代理(CAs) 交互
-
网络操作系统运行在集中的控制器上
-
在这种方式下,控制平面从路由器中分离出来,集中在一个远程的控制器 (Controller) 上。这个控制器拥有全局的网络视野,它计算出所有路由器的转发表,然后通过一个特定的协议将这些表分发下去。路由器本身只负责执行转发操作,变得更加简单。这种集中式的方法使得网络管理和编程更加灵活。
-
其可以提取发来的帧的一些字段(比如ip,如果是以太网的话会有mac地址,比如tcp的端口号等等)然后做修改
-
会有四个动作:转发,block,泛洪,修改某些字段
-
通过南向接口(一种特定的协议),由专属的网络操作系统,做多个计算的匹配和动作,将计算好的流表分发并安装到各个交换设备中。
1.4 网络服务模型
网络层为从发送主机到接收主机的“通道”提供了什么样的服务模型?我们可以从两个维度来考察:针对单个数据报的服务和针对数据报流的服务。
1.4.1 针对单个数据报的服务
- 可靠传送 (Reliable delivery):是否保证数据包一定能到达目的地?例如,互联网的IP协议提供的是“尽力而为 (Best-Effort)”服务,不保证可靠交付。
- 延迟保证 (Delay guarantee):是否能保证数据包在一定的时间内(例如40毫秒)到达?
1.4.2 针对数据报流的服务
- 保序数据报传送 (In-order datagram delivery):是否保证数据包按照发送的顺序到达接收端?
- 保证流的最小带宽 (Guaranteed minimum bandwidth):是否能保证一个数据流在任何时候都能获得一个最小的带宽?
- 分组之间的延迟抖动 (Timing between packets):是否能保持数据包之间的时间间隔?延迟的变化称为抖动 (Jitter),对于实时音视频等应用非常重要。
1.4.3 协议列举和网络层和传输层的区别
对于某些网络而言,网络层提供的第三个服务就是连接建立,包括连接的维持和关闭(之前的两个服务是路由和转发)
- 在某些网络提供有连接的网络,如ATM, frame relay, X.25 有连接:在分组传输之前,在两个主机之间,在通过一些 路由器所构成的路径上建立一个网络层连接; 涉及到路由器 面向连接不涉及路由器,仅仅是主机和主机之间
- 网络层和传输层连接服务区别:
- 网络层: 在2个主机之间,涉及到路径上的一些路由器 —— 有连接
- 传输层: 在2个进程之间,很可能只体现在端系统上 (TCP连接) —— 面向连接
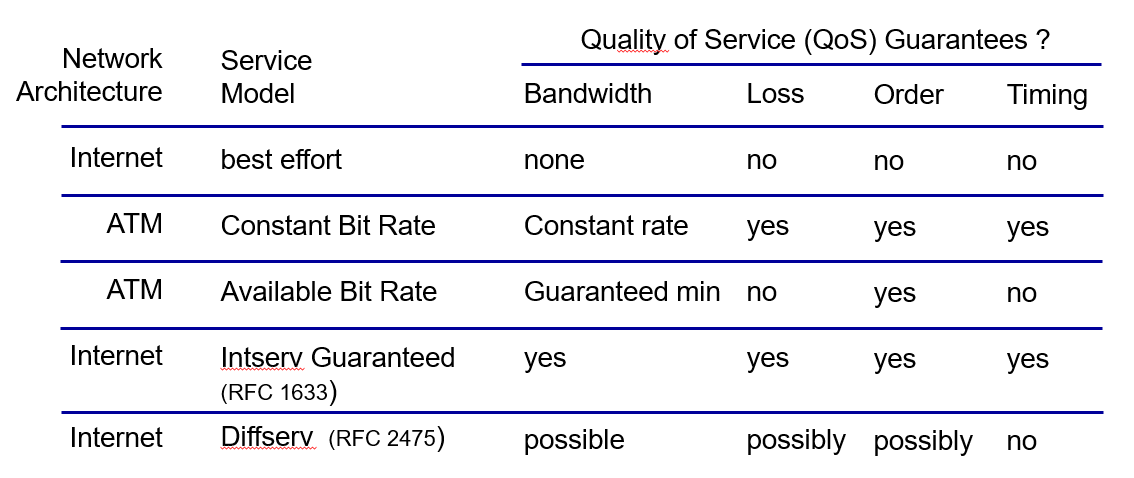
下表列出了一些典型的网络体系结构及其提供的服务模型。值得特别关注的是互联网 (Internet),它提供的网络层服务模型是尽力而为 (Best effort)。这意味着它不提供任何关于可靠性、时序、延迟或带宽的保证。
当这些具体的指标等于相应的值的时候,那么网络层提供的服务可以用术语 “service model(服务模型)“表示
| 网络结构 | 服务模型 | 丢包 | 保序 | 授时 | 延迟保证 | 带宽保证 | 拥塞反馈 |
|---|---|---|---|---|---|---|---|
| Internet | Best effort | No | No | No | No | No | No (via loss) |
| ATM | CBR | No | Yes | Yes | Yes | Yes | No |
| ATM | VBR | No | Yes | Yes | Yes | Yes | No |
| ATM | ABR | Guaranteed | Yes | No | No | Yes | Yes |
| ATM | UBR | No | Yes | No | No | No | No |
相比之下,ATM网络则提供了更丰富的服务模型,例如恒定比特率 (CBR) 和 可变比特率 (VBR),它们能够提供严格的带宽、时序和延迟保证。
当这些具体的指标等于相应的值的时候,那么网络层提供的服务可以用术语 “service model(服务模型)“表示
ATM: connection-oriented networking architecture/technology in 1990s, superseded by IP-based Internet IntServ (Integrated Services) : extension of Internet, specifies fine-grained QoS system, resource reservation based. Diffserv (differentiated services): coarse-grained version of IntServ, low-latency for voice/streaming traffic, best-effort for others
2 路由器组成
2.1 高层面路由器体系架构
首先,我们来了解一下通用路由器的基本体系结构。路由器的核心功能可以分为两大层面:
- 路由 (Routing):这属于控制平面的功能。路由器通过运行各种路由选择算法和协议,如RIP、OSPF、BGP等,来动态地学习网络的拓扑结构,并最终生成一张路由表。这张表指导数据包如何到达目的地。
- 转发 (Forwarding):这属于数据平面的功能。当一个数据报(即网络分组)从输入链路到达时,路由器会根据路由表中的信息,将其从合适的输出链路交换出去。这个过程就是分组的转发。
一个典型的路由器由四个主要部分组成:输入端口、输出端口、交换结构(Switch Fabric)和路由处理器(Routing Processor)。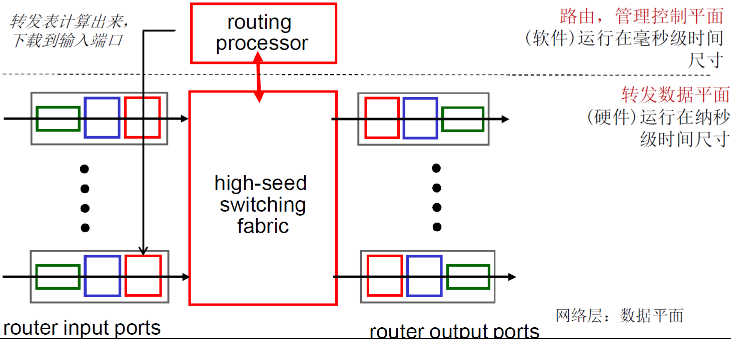
- 交换结构 (Fabric) 的作用是将输入端口接收到的分组,根据路由表指示,准确地交给对应的输出端口,完成一次局部的转发。
- 路由处理器 (Routing Processor) 是路由器的大脑,它运行着路由协议的实体(可以理解为正在运行的软件),通过执行路由选择算法来计算和维护路由表,实现了控制平面的功能。
- 图中的颜色代表了不同的网络层次:红色部分代表网络层,蓝色代表数据链路层,而绿色部分则代表物理层。
补充说明:在实际的路由器硬件中,输入端口和输出端口通常是集成在同一个物理接口上的,它既能接收数据也能发送数据。为了便于理解其工作原理,我们在这里将它们分开讨论。
2.2 入口接口的重要功能

decentralized switching:
-
using header field values, lookup output port using forwarding table in input port memory (“match plus action”)
-
goal: complete input port processing at ‘line speed’
-
input port queuing: if datagrams arrive faster than forwarding rate into switch fabric
-
destination-based forwarding: forward based only on destination IP address (traditional)
-
generalized forwarding: forward based on any set of header field values
2.2.1 最长前缀匹配
when looking for forwarding table entry for given destination address, use longest address prefix that matches destination address.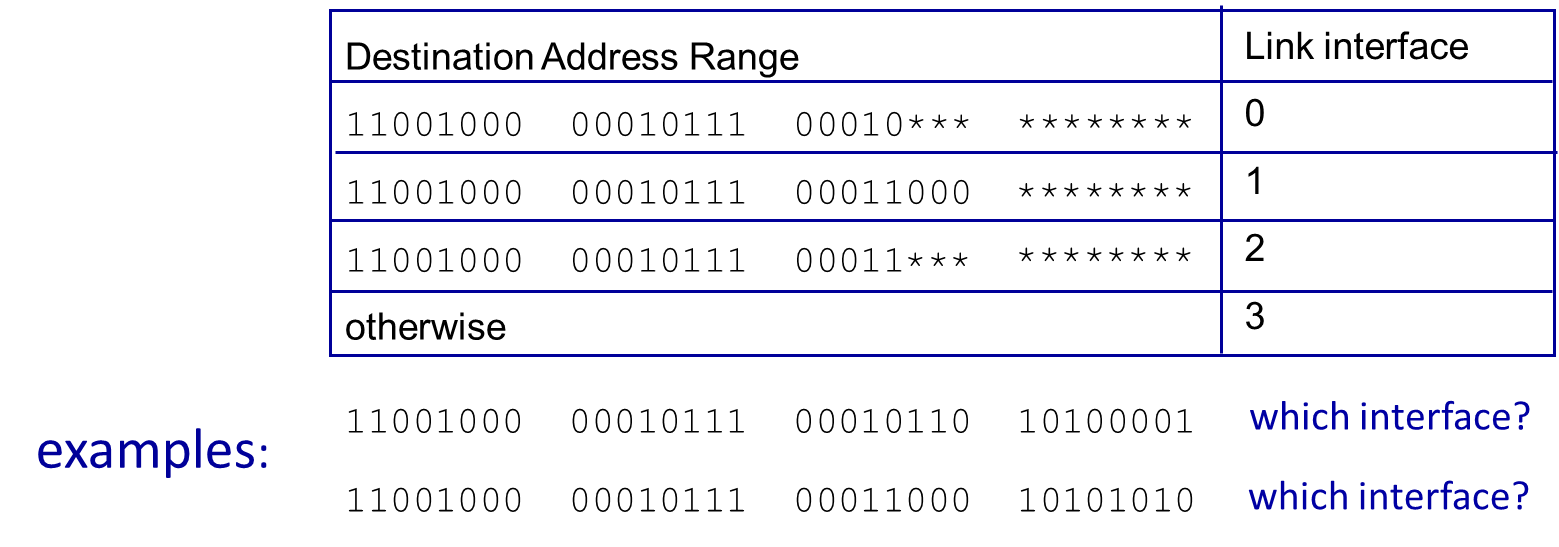
- we’ll see why longest prefix matching is used shortly, when we study addressing
- longest prefix matching: often performed using ternary content addressable memories (TCAMs)
- content addressable: present address to TCAM: retrieve address in one clock cycle, regardless of table size
- Cisco Catalyst: ~1M routing table entries in TCAM
最长前缀匹配
- 我们在学习编址时,很快就会明白为什么要使用最长前缀匹配
- 最长前缀匹配:通常借助三进制内容可寻址存储器(TCAMs)实现
- 内容可寻址:向TCAM提供地址,可在一个时钟周期内检索到地址,不受表大小影响
- 思科 Catalyst:TCAM中可存储约100万条路由表项
Ternary(三进制):由3个元素组成的数字系统,例如
0、1和*
2.3 交换结构 (Switch Fabric)
2.3.1 (1) 功能
交换结构的核心任务是将分组从输入缓冲区快速、高效地传输到正确的输出端口。
-
交换速率:这是衡量交换结构性能的关键指标,指分组可以从输入端传输到输出端的速率。
-
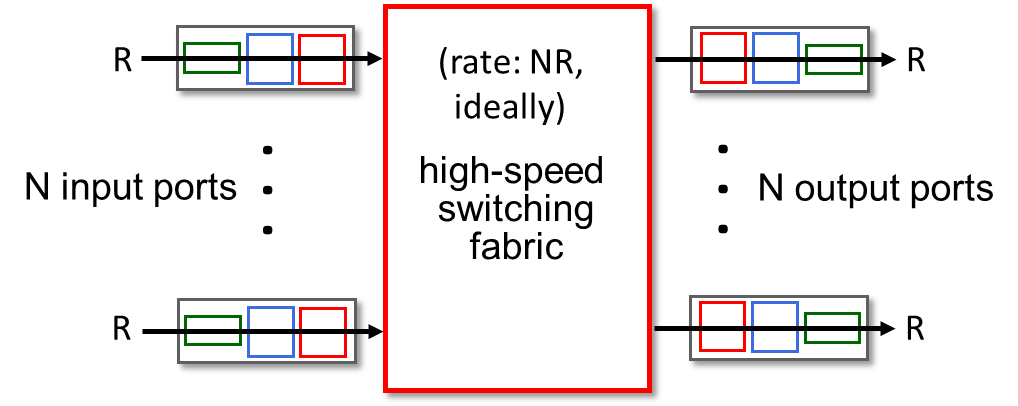
理想情况下,一个有N个端口的路由器的交换速率应该是单个端口线路速率的N倍,这样交换结构本身才不会成为性能瓶颈。【一般的单位是PPM,Packet per Minute】
-
transfer packet from input link to appropriate output link
-
switching rate: max rate at which packets can be transfer from inputs to outputs
- often measured as multiple of input/output line rate
- N inputs: switching rate N times line rate desirable
2.3.2 (2) 交换结构类型
主要有三种典型的交换机构实现方式: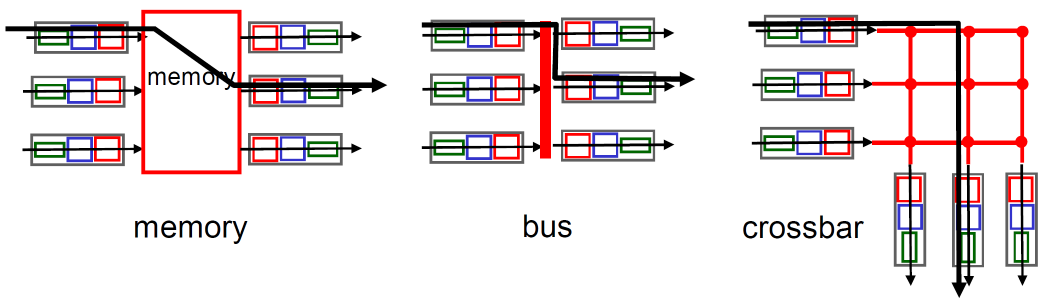
2.3.2.1 通过内存交换 Switching via memory
这是第一代路由器采用的方式,其工作流程类似于一台传统计算机。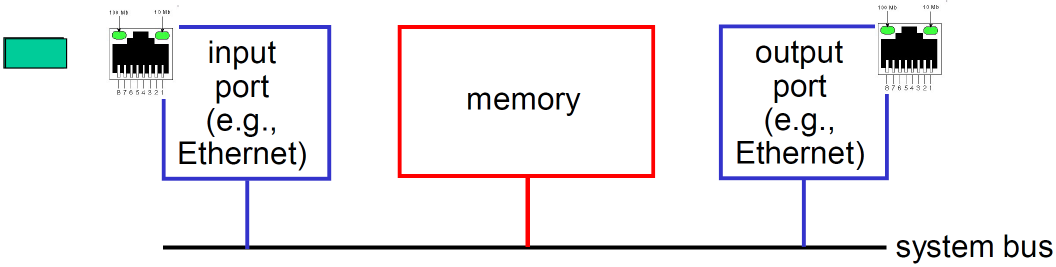
- 分组首先从输入端口被拷贝到CPU控制的系统内存中。
- CPU检查分组头部,查询路由表找到目标输出端口。
- 最后,CPU再将分组从内存拷贝到对应的输出端口缓冲区。
这种方式的主要瓶颈在于,每个分组都需要两次穿过系统总线(一次写入内存,一次读出内存),这极大地限制了转发速率。
2.3.2.2 通过总线交换 Switching via a bus
为了克服内存交换的瓶颈,出现了基于共享总线的交换方式。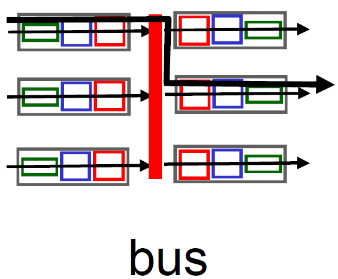
- 输入端口给分组附加一个内部的标签,指明其目标输出端口,然后将分组放到共享总线上。
- 所有的输出端口都能接收到这个分组,但只有与标签匹配的那个端口会真正地保存并处理这个分组。
- 这种方式下,一个分组只需经过一次总线,效率更高。
- 但因为总线是共享资源,同一时间只能传输一个分组,所以其交换速度仍然受限于总线带宽。像Cisco 1900和5600系列的路由器就采用了这种技术,对于一般的接入或企业级网络是足够的。( 但不适合区域或骨干网络)
2.3.2.3 通过互联网络 (Crossbar) 交换 Switching via interconnection network
这是一种更高级的交换方式,旨在克服总线带宽的限制,实现多个分组的并行转发。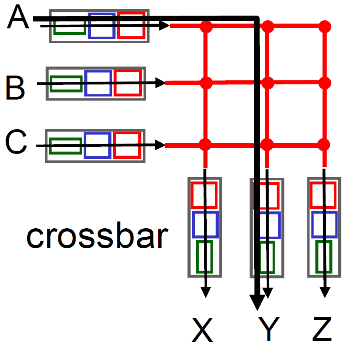
- Banyan(榕树)网络,crossbar(纵横)和其它的互联网络被开发,将多个处理器连接成多处理器
- 互联网络由一系列交叉点开关组成。当一个分组需要从输入端口A转发到输出端口Y时,控制器会闭合A和Y交叉处的开关,形成一条直接通路。
- 这种结构允许在不冲突的情况下,同时建立多条这样的通路(例如,A到Y和B到Z可以同时进行)。
- 然而如果来自两个不同的输入端口的两个分组的目的地为相同的输入端口,则一个分组必须在输入端等待,因为在某个时刻经过给定总线仅能够发送一个分组。
- 为了进一步提高效率,一些高级设计会将变长的数据报切分成固定长度的信元(cell),通过交换网络进行交换,简化了调度。Cisco 12000系列高端路由器就采用这种技术,交换速率可达60Gbps甚至更高。
- Crossbar, Clos networks, other interconnection nets initially developed to connect processors in multiprocessor
- multistage switch (Clos network): nxn switch from multiple stages of smaller switches
- exploiting parallelism:
- fragment datagram into fixed length cells on entry
- switch cells through the fabric, reassemble datagram at exit
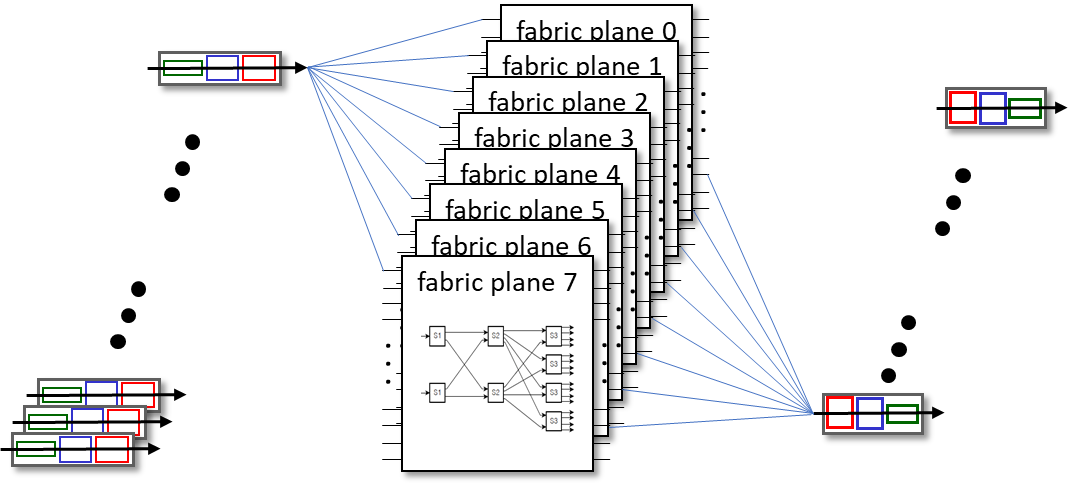
- scaling, using multiple switching “planes” in parallel:
- speedup, scaleup via parallelism
- Cisco CRS router:
- basic unit: 8 switching planes
- each plane: 3-stage interconnection network
- up to 100’s Tbps switching capacity
2.4 输入端口
2.4.1 (1) 功能
输入端口的处理流程涉及物理层、数据链路层和网络层。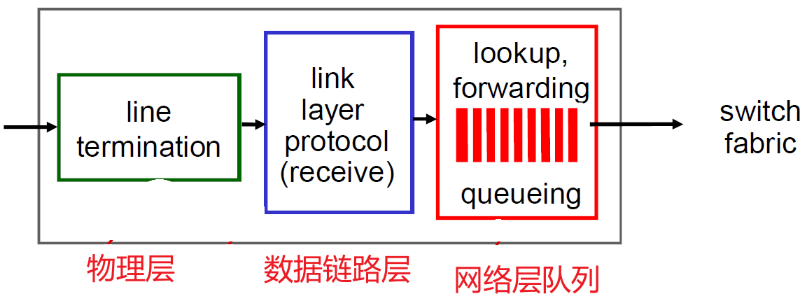
- 物理层:负责将物理链路上传输的模拟信号(如电信号或光信号)转换成数字信号,即比特流(0和1)。
- 数据链路层:接收到比特流后,它需要识别出数据帧的边界(帧头和帧尾),进行差错校验,并检查帧的目标MAC地址是否与本端口的MAC地址匹配。如果匹配,则将IP分组(数据报)从帧中提取出来。
- 网络层:从数据链路层接收到IP分组后,这些分组会在一个队列中进行排队,等待被转发。
在网络层,路由器会执行分布式交换,这一过程主要包括:
- 根据数据报头部的目标地址等信息,在转发表(通常由路由表生成并缓存于输入端口内存中)中查找匹配的条目,确定其应该被发往哪个输出端口。
- 传统路由器主要基于目标IP地址进行转发。而现代的SDN(软件定义网络)交换机则支持通用转发,可以基于数据报头部任意字段的组合来进行更灵活的转发决策。
2.4.2 (2) 缓存(队列)的目的
- Input port queuing can result from: 1) same output port contention, 2) HOL blocking.
- Head-of-the-Line (HOL) blocking: queued datagram at front of queue prevents others in queue from moving forward
- queueing delay and loss due to input buffer overflow!
输入端口设置缓存队列的主要目的是为了解决速率不匹配的问题。当分组到达的速率超过交换结构处理的速度时,就需要一个队列来临时存储这些分组。
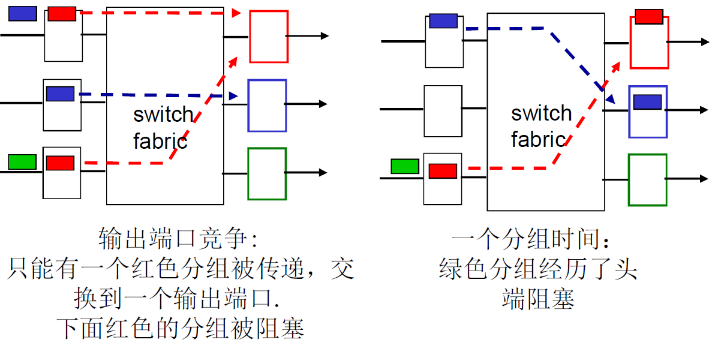
但这也会引发一些问题:
- 排队延迟和分组丢失:如果队列满了,新到达的分组就会被丢弃。
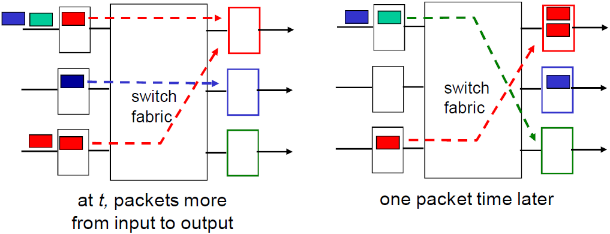
- 线路头阻塞 (Head-of-the-Line Blocking):当队列头部的分组因为其目标输出端口正忙而无法被转发时,它会阻塞住后面所有排队的分组,即使后面某些分组的目标输出端口是空闲的。
如图所示,两个红色的分组都想去往上方的同一个输出端口,形成竞争。下方输入端口的红色分组因为竞争失败而等待,它后面的绿色分组虽然目标端口空闲,但也被阻塞,无法前进。
2.5 输出端口
输出端口的功能与输入端口相对,它负责将分组再次封装成帧,并通过物理层发送出去。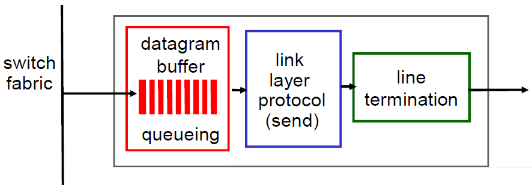
-
数据链路层:将分组分成帧
-
物理层:将bit转成物理信号传输
-
当来自交换结构的分组到达速率超过了物理链路的传输速率时(例如多个输入端口同时向一个输出端口发送数据),就需要输出端口缓存来暂存这些分组。
-
调度规则 (Scheduling Policy) 决定了从队列中选择哪个分组进行下一次传输。比如实时多媒体应用可能会优先传送
2.5.1 输出端口排队
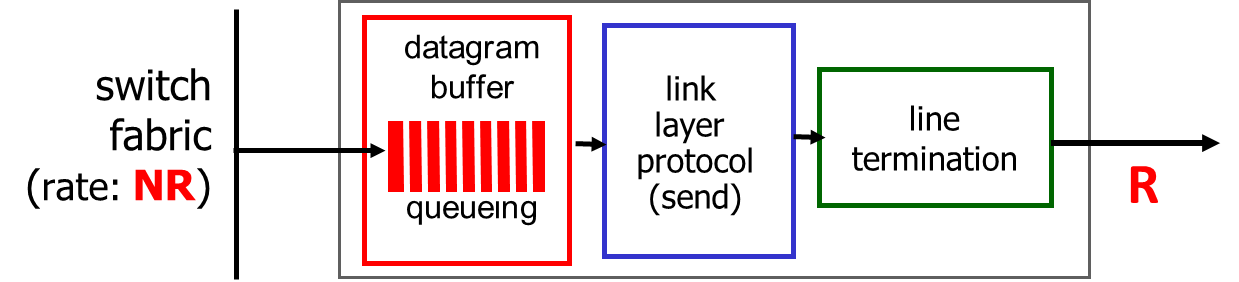
- Buffering required when datagrams arrive from fabric faster than link transmission rate. Drop policy: which datagrams to drop if no free buffers?
- Datagrams can be lost due to congestion, lack of buffers
- Scheduling discipline chooses among queued datagrams for transmission
-
Priority scheduling – who gets best performance, network neutrality
-
如果交换速率()是线路速率()的N倍(N是输入端口数),当多个输入同时向一个输出发送分组时,仍然可能导致输出端口的速率超过其物理链路的承载能力,从而产生排队。
-
这种排队会引入延迟,如果缓存被占满,后续到达的分组将会被丢弃。
-
2.5.1.1 需要多大的缓存?
关于需要多大的缓存,有一个经典的“拇指规则”(经验性规则),由RFC 3439提出:
平均缓存大小 = 典型的往返时间(RTT) × 链路容量(C)
-
RFC 3439 拇指规则(经验性规则):平均缓存大小=典型的RTT(例如:250ms)倍于链路容量C
- e.g., C = 10 Gpbs link
-
-
最近的一些推荐:有N(非常大)个流,缓存大小等于
2.5.2 调度机制 Buffer Management
调度机制决定了当链路空闲时,下一个被发送的分组是哪一个。 buffer management:
- drop: which packet to add, drop when buffers are full
- tail drop: drop arriving packet
- priority: drop/remove on priority basis
- marking: which packets to mark to signal congestion (ECN, RED)
RED = random early detection/drop/discard is a queuing mechanism for a router to actively avoid congestion. (can be used in conjunction with ECN)
2.5.2.1 ① FIFO (先进先出) first come, first served
这是最简单的调度策略,即按照分组到达的先后顺序进行发送。当队列已满时,需要一个丢弃策略来决定如何处理新到达的分组: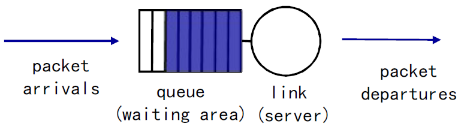
- 队尾丢弃 (Tail Drop):直接丢弃最新到达的分组。
- 优先权丢弃 (Priority Drop):根据分组的优先权来决定丢弃或移除队列中的某个分组。
- 随机丢弃 (Random Drop):随机选择一个队列中的分组进行丢弃。
2.5.2.2 ② 优先权调度 (Priority Queuing)
这种策略将分组分成多个类别,每个类别对应一个不同的优先权。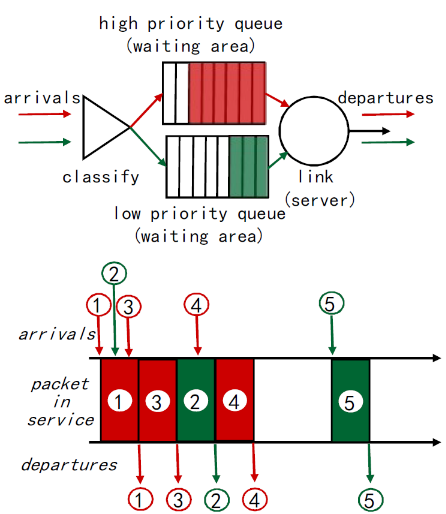
有红的不传绿的
- 发送时,调度器总是优先从最高优先级的队列中取出分组进行发送。
- 只有当所有高优先级队列都为空时,才会处理较低优先级的队列。
- 在同一个优先级的队列内部,通常仍然采用FIFO的顺序。
- 注意非抢占式优先权排队(non-preemptive priority queuing),就是虽然4的优先级高,但是2先发了就不能加队
2.5.2.3 ③ 轮询调度 (Round Robin, RR)
轮询调度同样将分组划分为不同的类别。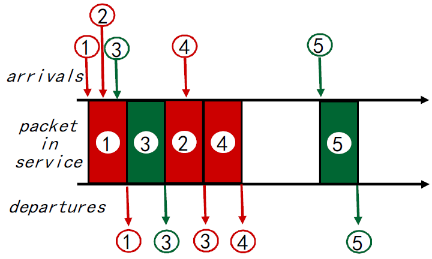
- 调度器会像扫描一样,循环地检视每一个队列。
- 每轮到某个类别的队列时,就从中取出一个分组发送,然后立即转向下一个类别的队列。这种方式保证了每个类别都能获得服务机会,避免了低优先级分组被“饿死”的情况。
2.5.2.4 ④ 加权公平排队 (Weighted Fair Queuing, WFQ)
WFQ可以看作是轮询调度的一种泛化和改进。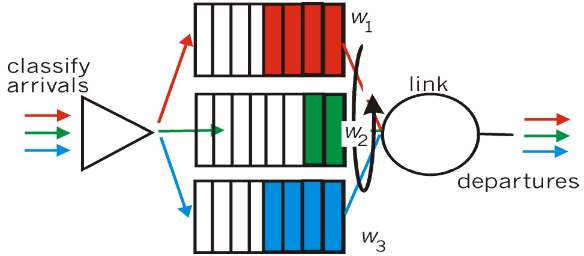
- 它同样对分组进行分类,但为每个类别分配了一个权重。
- 在任何一段时间内,每个队列获得的服务时间(或带宽)与其权重成正比。
- 这意味着,权重越高的类别,在每一轮循环中可以获得更多的服务量,从而实现了对不同类别流量的差分服务,保证了公平性。
3 4.3 IP协议
IP,即 Internet Protocol(互联网协议),是整个互联网运作的核心。
3.1 4.3.1 网络层协议组成及功能
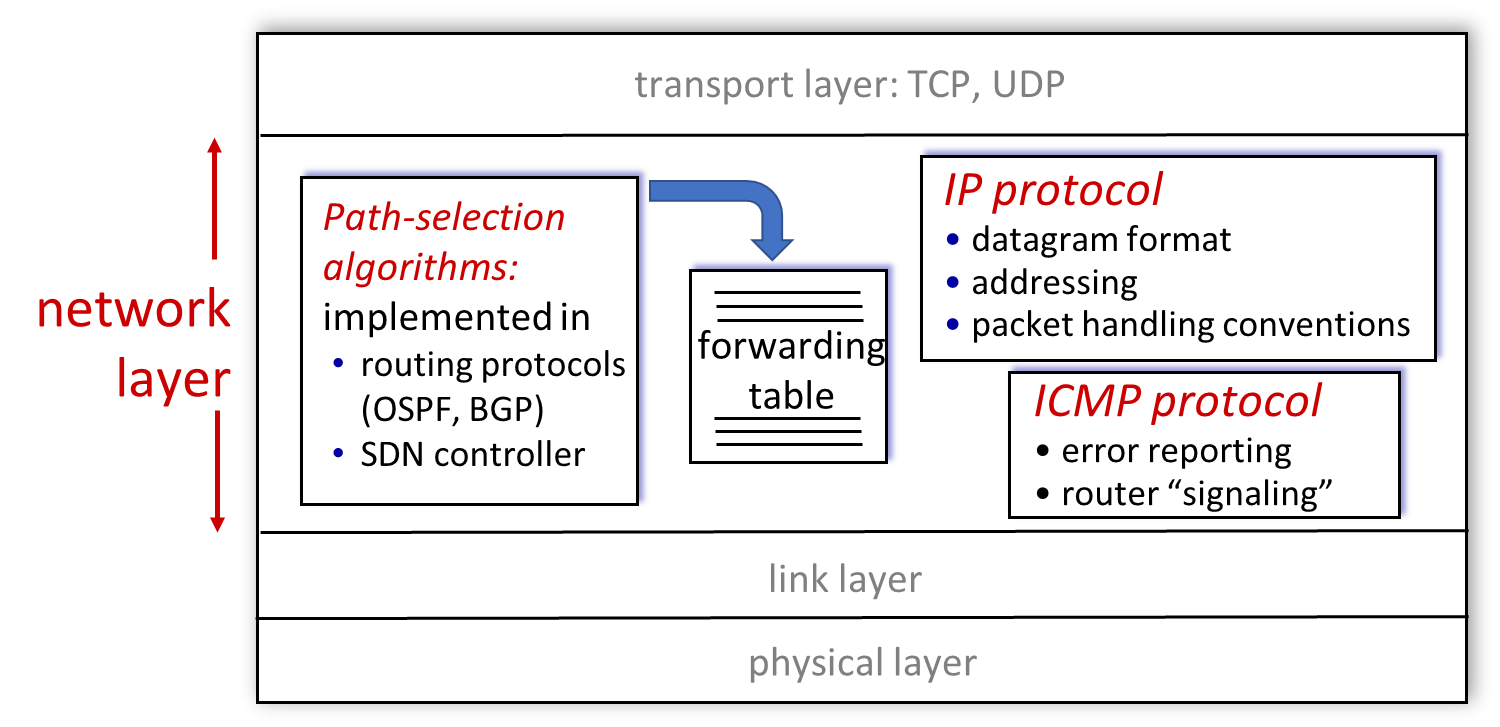
在主机和路由器中,网络层的功能由一组协同工作的协议共同完成。这些协议可以被划分为三个主要部分,共同支撑着网络层的数据转发和路由控制。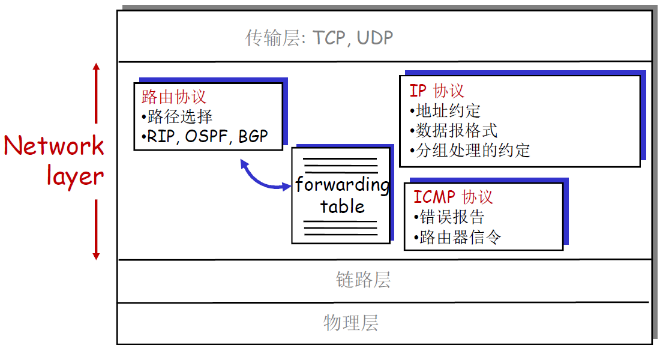
- 路由协议 (Routing Protocols):例如
RIP、OSPF、BGP等。这些协议负责实现网络层的控制平面功能。它们通过算法计算出最佳路径,并生成路由表(或称转发表),为数据包的转发提供决策依据。 - IP协议 (Internet Protocol):IP协议是数据平面的核心。它不负责路径的计算,而是根据路由协议已经生成的转发表,查询数据包头部的目标地址,然后进行匹配和转发。这是数据平面最核心的功能。
- ICMP协议 (Internet Control Message Protocol):这是一个信令协议。它用于在IP主机、路由器之间传递控制消息。例如,我们常用的
ping命令就是通过发送ICMP分组来测试网络的连通性和往返延迟。当路由器因为某些原因(如TTL耗尽)丢弃数据包时,也会向源主机发送一个ICMP错误报告。
补充知识
- ICMP分组本身不参与路由转发决策,它主要用于网络诊断和状态报告。
- ICMP协议的设计非常精简,它仅依赖于网络层即可工作,不需要上层协议(如TCP或UDP)的支持。
ping命令的本质就是发送和接收ICMP分组。
3.2 IP数据报格式
IP数据报由头部(Header)和数据(Data)两部分组成。头部包含了数据包转发所需的全部控制信息。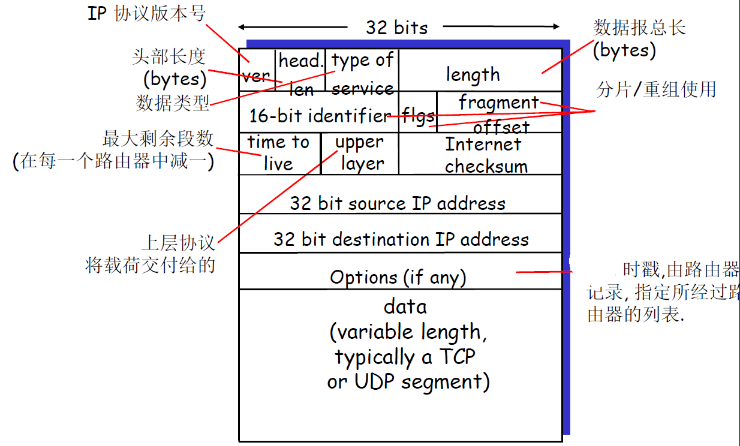
| 字段 | 说明 |
|---|---|
| ver (Version) | 4位,表示IP协议的版本号。对于IPv4,该值为 0100。 |
| head len (Header Length) | 4位,表示IP头部的长度,单位是4字节。常规头部长度为20字节(即5行),此时该值为5。由于存在可选项(Options),头部是变长的,这个字段用于确定数据部分的起始位置。【就是比如len是11,那你实际的头部长度是44】 |
| type of service | 8位,服务类型。最初设计用于为路由器的输出队列调度提供参考,但后来基本被废弃。 |
| length | 16位,表示整个IP数据报的总长度(头部 + 数据),单位是字节。 |
| 16-bit id, flags, fragment offset | 这三个字段共32位,用于IP数据报的分片与重组,后面会详细介绍。 |
| time to live (TTL) | 8位,生存时间。数据包每经过一个路由器,TTL值减1。当TTL减为0时,路由器会丢弃该包并向源主机发送一个ICMP超时消息,防止数据包在网络中无限循环。 |
| upper layer | 8位,上层协议。指明数据部分应交付给哪个传输层协议处理,例如TCP、UDP或ICMP。这个字段的值是一个协议号。 |
| Internet checksum | 16位,头部校验和。只对IP头部进行校验,以确保头部信息的正确性。而TCP和UDP的checksum是对他的数据包进行校验。需要注意的是由于每一跳里面TTL一定会变,所以你的checksum也要重新算 |
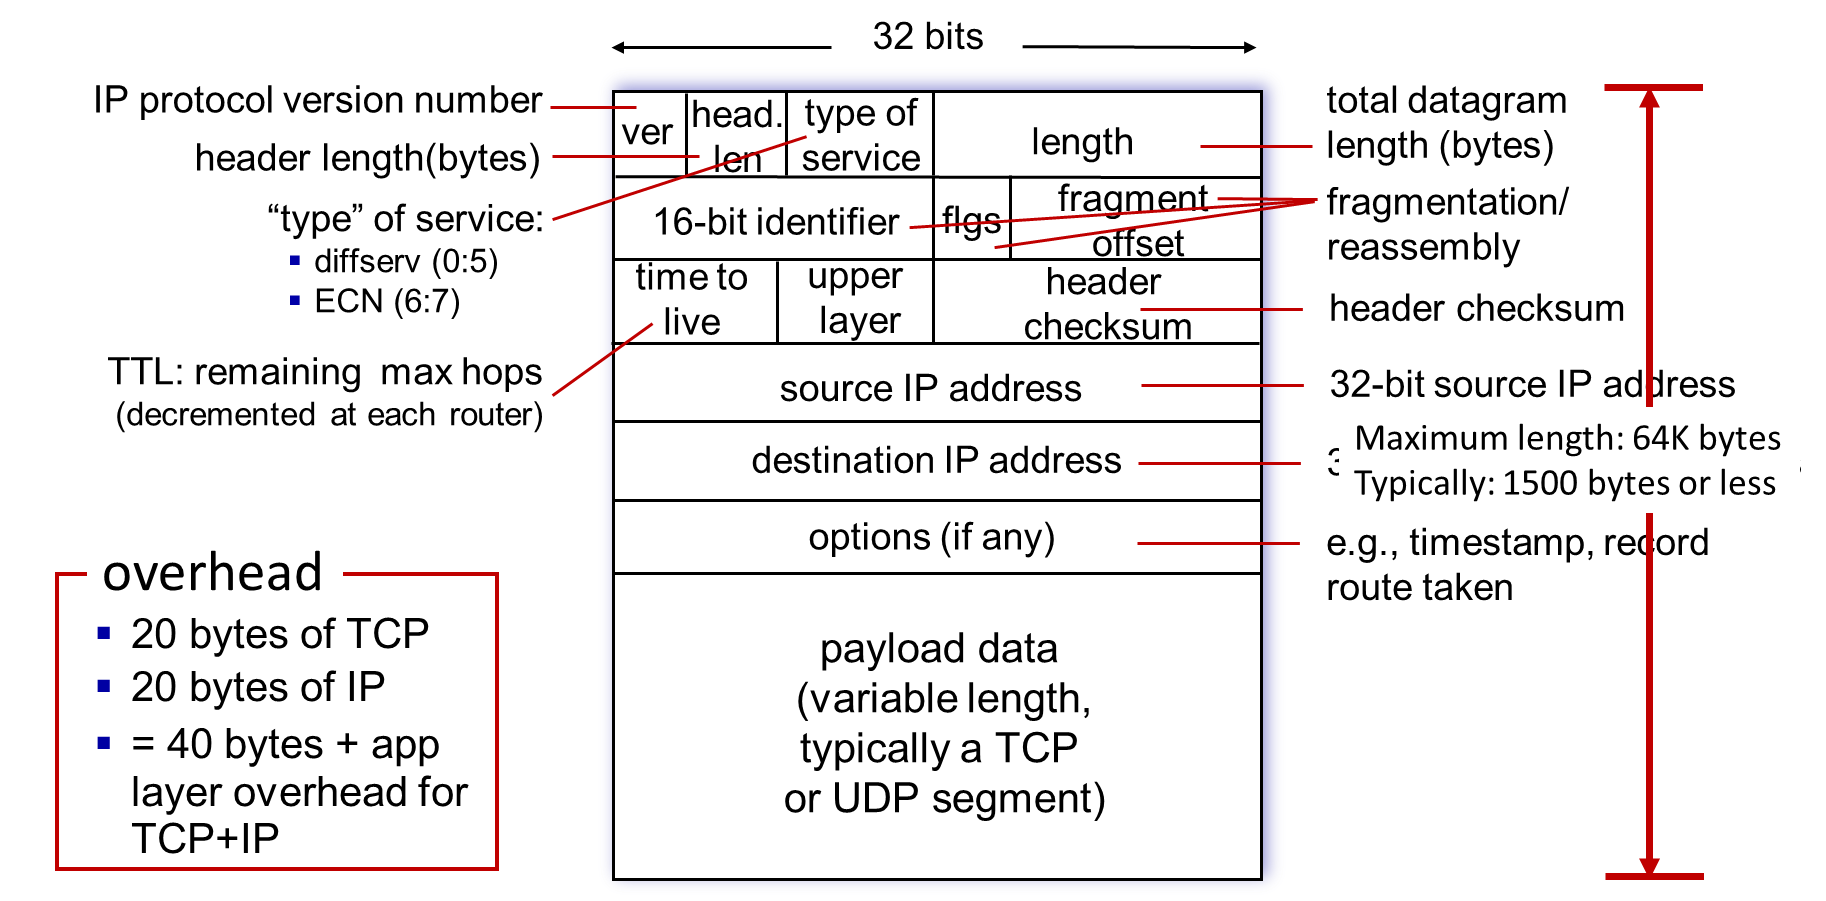
课堂提问:IP数据报传输一个TCP段时,总共的头部开销是多少?
- TCP头部固定开销:20 bytes
- IP头部固定开销:20 bytes
- 总开销 = 40 bytes + 应用层数据。
3.3 IP分片和重组 (Fragmentation & Reassembly)
不同的网络链路能够承载的数据帧大小不同,这个限制被称为MTU (Maximum Transmission Unit,最大传输单元)。MTU定义了链路层帧能承载的最大数据长度。
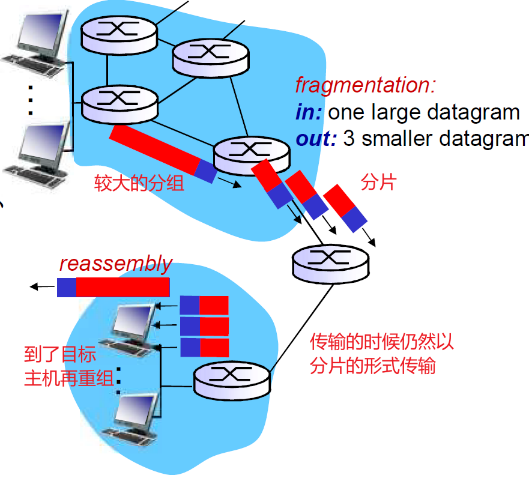
例如,以太网(Ethernet)的MTU通常是1500字节,而FDDI网络的MTU可以达到4000字节。当一个路由器连接了两种不同MTU的网络时,如果它从一个大MTU网络收到的数据包,需要转发到一个小MTU网络,就必须进行分片。
注意:这里所说的MTU是指IP数据报的总长度(IP头部 + 传输层头部 + 应用数据),而不是IP数据报的数据部分。
当一个大的IP数据报需要通过一个MTU较小的网络时,它会被分片 (fragmented)。
- 一个原始数据报被分割成多个更小的数据报片段。
- 所有片段共享相同的ID(
16-bit identifier),以表明它们来自同一个原始数据包。 - 每个片段通过偏移量(
fragment offset)字段来记录它在原始数据包中的相对位置。注意这个是以8字节为单位! - 除了最后一个分片,其他所有分片的标志位(
flags)中的 “More Fragments” 位会被设为1。最后一个分片的该标志位为0。
重组的过程只在最终的目标主机上进行。这样做是为了减轻中间路由器的负担,如果每个路由器都需要先重组再分片,会大大增加其处理压力。
当目标主机收到第一个分片时,会启动一个定时器。如果在定时器超时前仍未收到全部分片,那么已经收到的所有分片都将被丢弃。
3.3.1 分片计算例题
一个大小为4000字节的IP数据报(20字节头部 + 3980字节数据)需要通过一个MTU为1500字节的网络。如何分片?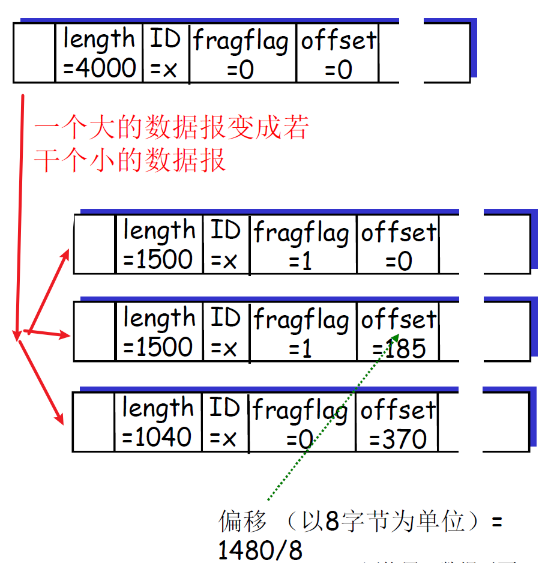
- 原始数据报: 总长4000B,数据部分3980B。
- 网络MTU: 1500B。这意味着每个分片的最大总长度不能超过1500B。
- 第一片 (Fragment 1)
- 头部:20字节(从原始包复制)。
- 数据:为了不超过MTU,数据部分最大为
1500 - 20 = 1480字节。 - 偏移量: 0 (因为是第一片)。
- 标志位: MF=1 (后面还有分片)。
- 第二片 (Fragment 2)
- 头部:20字节。
- 数据:同样承载1480字节。
- 偏移量:
1480 / 8 = 185。偏移量以8字节为单位,所以用前一片的数据长度除以8。 - 标志位: MF=1 (后面还有分片)。
- 第三片 (Fragment 3)
- 头部:20字节。
- 数据:剩余数据为
3980 - 1480 - 1480 = 1020字节。 - 偏移量:
(1480 + 1480) / 8 = 2960 / 8 = 370。 - 标志位: MF=0 (这是最后一片)。
在分片过程中,上层协议(如TCP)的头部信息被视为数据的一部分,它会被原封不动地复制到第一个分片的数据部分,后续分片则只包含原始数据报的数据部分。
3.4 IP编址及转发
3.4.1 IP地址概念
- IP address: 32-bit identifier associated with each host/router interface (接口)
- 255.255.255.255 for broadcasting
- 127.0.0.1 localhost/loopback
- interface: connection between host/router and physical link
- router’s typically have multiple interfaces
- host typically has one or two interfaces (e.g., wired Ethernet, wireless 802.11)
通常我们说“主机的IP”或“路由器的IP”是不精确的。一个IP地址准确来说是用来标识一个网络接口 (Interface) 的。
- 接口:是主机或路由器与物理链路的连接点。
- 一个路由器通常有多个接口,因为它连接着多个不同的网络。因此,一个路由器会有多个IP地址。否则无法进行转发。
- 主机也可能有多个接口(例如,同时连接有线网络和Wi-Fi),因此也可以有多个IP地址。也可以虚拟出来很多个网卡。
- 每一个IP地址都与一个特定的网络接口相关联。
- 如下,一个路由器插了3个网卡,就有三个点,分别接入三个网络
****
在一个网络内部,ip的怎么做分组和接收,IP编址。怎么由一个ip到另外一个ip等问题,后面会讲到
3.4.2 子网 (Subnets)
a. 子网的特点
- 什么是子网? 一个子网内所有设备接口的IP地址,其高位部分(网络部分)是相同的。
- 子网内的节点之间通信无需路由器介入,它们可以通过物理链路(例如,通过交换机,但是不需要通过路由器)直接相互到达,也就是“一跳可达”。
b. 如何划分子网
- 一个实用的方法是:将网络中每个设备的接口都“拔掉”,这样网络就会形成一个个相互隔离的“孤岛”。每一个这样的孤岛就是一个独立的子网。
- 在下图中,通过这种方法可以划分出三个纯粹的子网。但从外部网络的视角看,如果这三个子网的IP地址前缀(例如前三位字节)都相同,它们也可以被看作是一个更大的、统一的子网。这体现了网络的路由聚集和透明性。【这种也叫做纯子网】
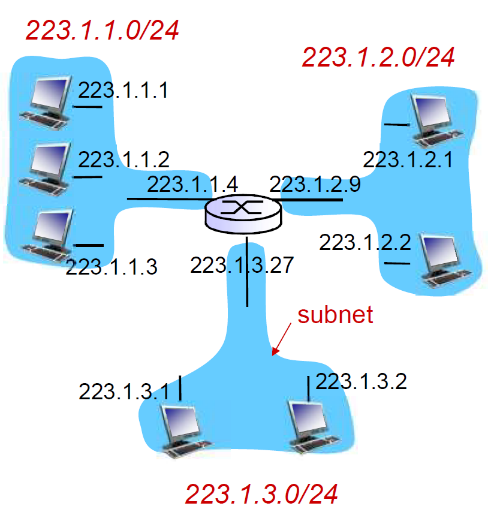
例题:下图中有几个子网?
答案:6个。 包括3个连接主机的局域网【纯子网】,以及连接路由器之间的3条点对点链路。每一条链路都是一个独立的子网。
- 路由器之间的也叫作子网,也是一条可达的
- 点到点的链路一般用于长途链路
- 多点连接—计算机局域网
3.4.3 IP 地址分类
3.4.3.1 基本分类【旧的方法】
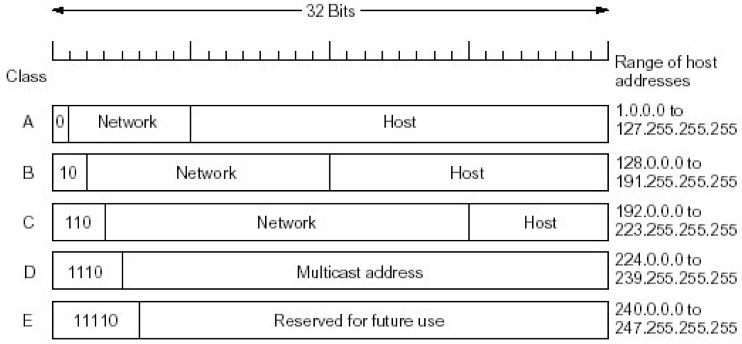
在 IP 地址的设定中,存在 A、B、C 三种主要的单播地址类型,它们的划分主要依据地址的第一个、前两个或前三个比特位。
- A 类地址:其地址空间总数为 。然而,全 0 和全 1 的网络号是保留不用的,因此实际可用的 A 类网络数量为 个。每个 A 类网络可以容纳极为庞大的主机数量,具体为 个主机。由于其巨大的主机容量,A 类地址非常稀少,并且早已被全部分配完毕。
- B 类地址:其前两位固定为
10。这类网络共有 个。同样地,减去两个保留的网络号后,其实际数量为 16382 个。每个 B 类网络可以支持 台主机。B 类网络同样规模巨大,通常适用于跨国公司等大型机构,目前也已被分配完毕。 - C 类地址:其前三位固定为
110。这类网络的数量非常庞大,总数超过 200 万个。每个 C 类网络可以容纳 台主机。这是我们日常接触最多的一类地址,例如常见的192.168.x.x就属于 C 类地址。
传统的 IP 地址分类方式有一个特点,即不需要子网掩码。通过判断地址的前几位(例如,A 类地址的第一位是 0),就可以直接确定其类别,并由此知道网络部分和主机部分的分界线。
- D 类地址:前缀是
1110,用于多播(multicast),也称为主播地址。 - E 类地址:前缀是
11110,为保留地址,为未来使用而预留。
| 分类 | IP类型 | 特点 | 网络数 | 每个网络的主机数 | 说明 |
|---|---|---|---|---|---|
| 单播 | A类 | 首位为0,7位网络号,24位主机号 | 126 ( = - 2 ) | 16 million ( = - 2) | A类网络是一个巨大的网络,因为每个网络的主机数目很多,但是A类网络只有126个,早已经被分完了 |
| 单播 | B类 | 前两位为10,14位网络号,16位主机号 | 16382 ( = - 2) | 64K ( = - 2) | 也很大,跨国公司等适用;等数目的但是也被分完了 |
| 单播 | C类 | 前三位为110,21位网络号,8位主机号 | 2 million ( = - 2) | 254 ( = - 2) | 一般使用的是这个网络,所以可以看到我们的值前缀一般都是192-224之内的网络,这些都是C类网络 |
| 主播 | D类 | 前缀为1110,用于多播(组播)地址 | |||
| 预留 | E类 | 前缀为1111,为未来使用而保留 |
注意:网络数和主机数都需要减2,因为全0和全1的地址有特殊用途,不能分配给具体设备。例如,主机号全0表示网络地址,全1表示广播地址。
3.4.3.2 特殊 IP 地址约定
IP 地址中有一些特殊的约定,用于表示特定的网络或主机。
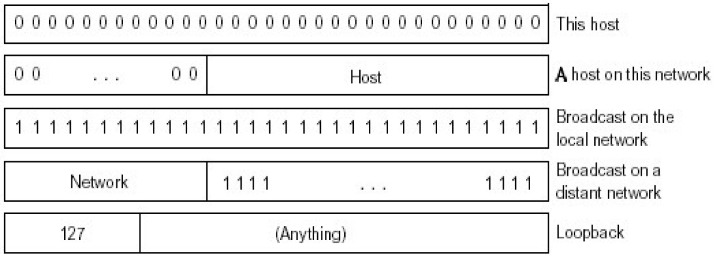
- 当主机部分全为 0 时,该地址代表的是网络本身。例如,
xxx.xxx.0.0表示一个网络。 - 当主机部分全为 1 时,该地址是广播地址,用于向该网络内的所有主机发送消息。
- 地址
0.0.0.0(32位全0) 表示本主机。 - 地址
255.255.255.255(32位全1) 是一个特殊的广播地址,代表本网络的所有节点,通常用于在本地网络内进行广播。 - 网络号为
127的地址段(例如127.0.0.1)是环回地址 (Loopback Address)。发送到此地址的数据包会直接从 IP 层返回到上层(TCP/UDP),而不会发送到外部网络。这常用于本地测试,例如ping 127.0.0.1就是在测试本机的网络协议栈是否正常工作。
3.4.3.3 内网 (专用) IP 地址
为了解决公网 IP 地址不足的问题,一部分 IP 地址空间被划分为专用地址,也称为内网地址。这些地址不会被分配为公网地址,因此不会与公网地址重复。
- 特点:专用地址只在局部网络(如家庭、公司内网)中有意义。路由器不会转发目标地址为专用地址的数据包,因此内网设备无法直接被公网访问。
- 专用地址范围:
- A 类:
10.0.0.0到10.255.255.255 - B 类:
172.16.0.0到172.31.255.255 - C 类:
192.168.0.0到192.168.255.255
- A 类:
10/8, 172.16/12, 192.168/16 prefixes
| IP类型 | 专用地址范围 | MASK |
|---|---|---|
| A类 | 10.0.0.0-10.255.255.255 | 255.0.0.0 |
| B类 | 172.16.0.0-172.31.255.255 | 255.255.0.0 |
| C类 | 192.168.0.0-192.168.255.255 | 255.255.255.0 |
因此,看到
192.168.x.x开头的地址,就可以确定它是一个内网IP,而不是公网IP。路由器看到了也不会向外转发。
路由的基本单位
路由器进行路由计算和传播时,其基本单位是网络,而不是单个IP地址。如果以全球个IP地址为单位进行路由,路由表的规模将是无法承受的。通过将具有相同网络前缀的IP地址聚合成一个网络进行路由,可以大大简化路由表的规模,这就是路由聚集 (Route Aggregation)。
3.4.4 CIDR (无类域间路由) Classless InterDomain Routing
CIDR: Classless InterDomain Routing (pronounced “cider”) is a method for allocating and routing IP addresses that replaced the older classful system:
- subnet portion of address of arbitrary length
- address format: a.b.c.d
/x, where x is # bits in subnet portion of address
为了解决 A、B、C 类地址划分过于僵化(要么太大浪费,要么太小不够用)的问题,无类域间路由 (Classless Inter-Domain Routing, CIDR) 应运而生。
解决问题:比如C类网络的host数太少了,CIDR可以按需分配
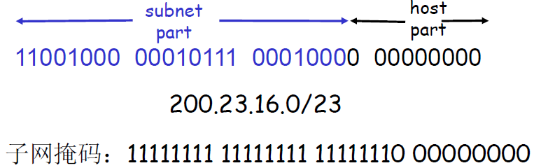
- 核心思想:CIDR 打破了固定的网络类别界限,允许在任意位置划分网络号和主机号,实现按需分配。
- 地址格式:采用
a.b.c.d/x的形式,其中x代表网络前缀的长度。例如,200.23.16.0/23表示前 23 位是网络号,剩下的32 - 23 = 9位是主机号。
这种灵活的划分方式使得网络管理者可以根据实际需要(如 1000 台设备)来申请大小合适的地址块(需要 10 位主机号,即 ),从而大大提高了 IP 地址的使用效率。
所以对剩下B类地址的划分都是采用无类域间路由的方式划分
3.4.4.1 子网掩码 (Subnet Mask)
为了在无类路由的环境下明确网络号和主机号的界限,引入了子网掩码。它是一个 32 位的二进制数,其中为 1 的位表示网络部分,为 0 的位表示主机部分。
- 表示方法:
- 点分十进制:如 C 类网络的默认子网掩码为
255.255.255.0。 - CIDR 表示法:用
/x表示前x位是网络部分。例如,/22就表示前 22 位是网络号。
- 点分十进制:如 C 类网络的默认子网掩码为
通过将一个 IP 地址和其子网掩码进行“与”运算,就可以得到该地址所在的网络号。
3.4.5 转发表与转发算法
路由器内部维护一张转发表来决定数据包的去向。
| 目标子网号 | 掩码 | 下一跳 | 接口 |
|---|---|---|---|
| 202.38.73.0 | 255.255.255.192 | IPx | Lan1 |
| 202.38.64.0 | 255.255.255.192 | IPy | Lan2 |
| … | … | … | … |
| Default | … | IPz | Lan0 |
转发算法:
- 路由器获取数据包的目标 IP 地址。
- 遍历转发表中的每一项,将目标 IP 地址与该项的掩码进行“与”运算。
- 如果运算结果与该项的“目标子网号”匹配,则按照该项指定的“接口”和“下一跳”地址转发数据包。
- 如果遍历完所有表项都未找到匹配项,则使用默认路由 (Default Gateway) 进行转发,这通常是网络的出口。
3.5 如何获得一个 IP 地址
That’s actually two questions:
- Q: How does a host get IP address within its network (host part of address)?
- Q: How does a network get IP address for itself (network part of address)
3.5.1 主机获取 IP 地址
主机可以通过两种方式获取 IP 地址:
- 手动配置:由网络管理员为设备静态分配一个固定的 IP 地址。配置时需要提供四项关键信息:IP 地址、子网掩码、默认网关 (Default Gateway) 和本地 DNS 服务器的 IP 地址。【win+intel】
- UNIX: /etc/rc.config
- Wintel: control-panel→network→configuration→tcp/ip→properties
- DHCP (动态主机配置协议):这是一种“即插即用”的方式。子网内需要有一台 DHCP 服务器,主机启动时可以自动从服务器获取上述四项网络配置信息,无需人工干预。
3.5.2 DHCP 工作流程 Dynamic Host Configuration Protocol
DHCP overview:
- host broadcasts DHCP discover msg [optional]
- DHCP server responds with DHCP offer msg [optional]
- host requests IP address: DHCP request msg
- DHCP server sends address: DHCP ack msg
DHCP 协议允许主机在加入网络时动态地获得 IP 地址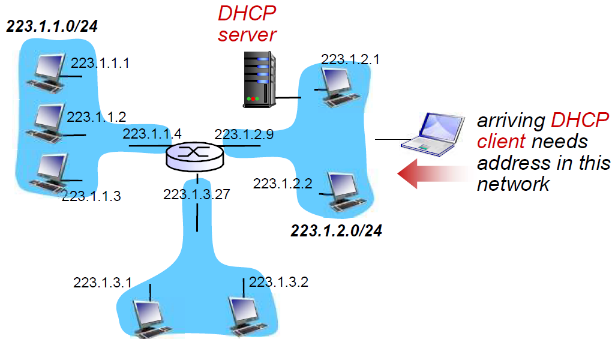
- 可以更新对主机在用IP地址的租用期-租期快到了
- 重新启动时,允许重新使用以前用过的IP地址
- 支持移动用户加入到该网络(短期在网)
其工作流程主要包括四个步骤,这四步通信都封装在 UDP 中,并且通常使用广播方式进行。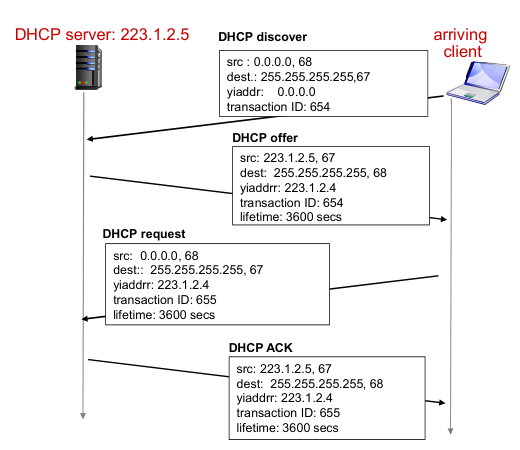
- lifetime:3600s表示3600s后会收回这个ip地址;3600s又要重新请求这个ip地址
- DHCP Discover (发现):新加入网络的主机广播一个“DHCP 发现”报文,询问网络中是否有可用的 DHCP 服务器。此时,由于主机还没有 IP,其源地址为
0.0.0.0,目标地址为255.255.255.255。使用UDP,端口号为67. - DHCP Offer (提供):收到发现报文的 DHCP 服务器会响应一个“DHCP 提供”报文,其中包含一个预分配给主机的 IP 地址及其他配置信息(如租用期)。其源地址为 DHCP 服务器的地址,目标地址为
255.255.255.255,因为他不知道是谁发来的。 - DHCP Request (请求):主机可能会收到多个服务器的 Offer。它会选择其中一个,并广播一个“DHCP 请求”报文,正式请求使用该地址。原地址是
0.0.0.0,目标地址是255.255.255.255 - DHCP ACK (确认):被选中的服务器最后会发送一个“DHCP 确认”报文,最终确认将该 IP 地址分配给该主机。【因为可能有很多个DHCP服务,所以要选一个确认】,其源地址为 DHCP 服务器的地址,目标地址为
255.255.255.255。其实我觉得是为了告诉局域网内的其他电脑
The two steps above can be skipped “if a client remembers and wishes to reuse a previously allocated network address”对于前两步,如果机器记得之前的IP的话,可以跳过
| 阶段 | 含义 | 源地址 | 目标地址 |
|---|---|---|---|
| 主机上限时 广播 “DHCP discover”报文 | 问一下有活着的DHCP服务器吗 | 0.0.0.0 32全0的本机地址,因为此时还没有分配ip地址 | 255.255.255.255 (32位全1的广播地址,因为不知道DHCP服务在哪) |
| DHCP服务器用“DHCP offer” 单播 提供报文响应 | DHCP服务器表明自己的存在; 并且包含分配给主机的关于ip的配套信息(包括那四项) | DHCP服务器的地址 | 255.255.255.255 也是全局广播,根据事务号来区分 |
| 主机 单播 请求IP地址:发送“DHCP request”报文 | 主机向DHCP服务器确定ip配置信息 | 0.0.0.0 也是表示自己的地址 | 255.255.255.255 也是广播 |
| DHCP服务器发送地址:“DHCP ack”报文 | DHCP把配置信息给主机 | DHCP服务器的地址 | 255.255.255.255 广播 |
全部都是广播,通过事务号来划分
DHCP can return more than just allocated IP address on subnet:
- address of first-hop router for client
- name and IP address of DNS sever
- network mask (indicating network versus host portion of address)
3.5.3 例子
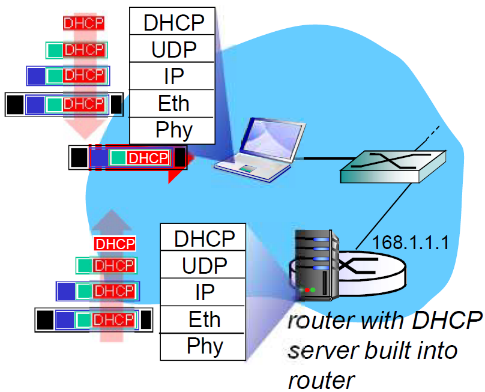
3.5.3.1 第一次握手:
- Connecting laptop will use DHCP to get IP address, address of first-hop router, address of DNS server.
- DHCP REQUEST message encapsulated in UDP, encapsulated in IP, encapsulated in Ethernet (以太网, 链路层协议技术)
- Ethernet frame broadcast (dest: FFFFFFFFFFFF) on LAN, received at router running DHCP server
- Ethernet demux’ed to IP demux’ed, UDP demux’ed to DHCP
- 客户端请求:
- 笔记本需要获取自己的IP地址、第一跳路由器地址、DNS服务器以及子网掩码:采用DHCP协议
- 笔记本发出的 DHCP请求 被封装在UDP段中,封装在IP数据报中,封装在以太网的帧中
- 以太网帧在局域网范围内广播(dest: FFFFFFFFFFFF)
被运行DHCP服务的路由器收到 - 在DHCP服务器中,以太网帧解封装成IP,IP解封装成UDP,解封装成DHCP
- DHCP服务端响应
- DHCP服务器生成DHCP ACK,包含客户端的IP地址,第一跳路由器的IP地址和DNS域名服务器的IP地址
- DHCP服务器封装的报文所在的帧转发到客户端,在客户端解封装成DHCP报文
- 客户端知道它自己的IP地址,DNS服务器的名字和IP地址,第一跳路由器的IP地址
3.5.3.2 第二次握手:客户端向特定的DHCP服务器确认
- DCP server formulates DHCP ACK containing client’s IP address, IP address of first-hop router for client, name & IP address of DNS server
- encapsulated DHCP server reply forwarded to client, demuxing up to DHCP at client
- client now knows its IP address, name and IP address of DNS server, IP address of its first-hop router
3.5.3.3 代码示例
/*request*/
Message type: Boot Request (1)
Hardware type: Ethernet
Hardware address length: 6
Hops: 0
Transaction ID: 0x6b3a11b7
Seconds elapsed: 0
Bootp flags: 0x0000 (Unicast)
Client IP address: 0.0.0.0 (0.0.0.0)
Your (client) IP address: 0.0.0.0 (0.0.0.0)
Next server IP address: 0.0.0.0 (0.0.0.0)
Relay agent IP address: 0.0.0.0 (0.0.0.0)
Client MAC address: Wistron_23:68:8a (00:16:d3:23:68:8a)
Server host name not given
Boot file name not given
Magic cookie: (OK)
Option: (t=53,l=1) DHCP Message Type = DHCP Request
Option: (61) Client identifier
Length: 7; Value: 010016D323688A;
Hardware type: Ethernet
Client MAC address: Wistron_23:68:8a (00:16:d3:23:68:8a)
Option: (t=50,l=4) Requested IP Address = 192.168.1.101
Option: (t=12,l=5) Host Name = "nomad"
Option: (55) Parameter Request List
Length: 11; Value: 010F03062C2E2F1F21F92B
1 = Subnet Mask; 15 = Domain Name
3 = Router; 6 = Domain Name Server
44 = NetBIOS over TCP/IP Name Server
/*reply*/
Message type: Boot Reply (2)
Hardware type: Ethernet
Hardware address length: 6
Hops: 0
Transaction ID: 0x6b3a11b7
Seconds elapsed: 0
Bootp flags: 0x0000 (Unicast)
Client IP address: 192.168.1.101 (192.168.1.101)
Your (client) IP address: 0.0.0.0 (0.0.0.0)
Next server IP address: 192.168.1.1 (192.168.1.1)
Relay agent IP address: 0.0.0.0 (0.0.0.0)
Client MAC address: Wistron_23:68:8a (00:16:d3:23:68:8a)
Server host name not given
Boot file name not given
Magic cookie: (OK)
Option: (t=53,l=1) DHCP Message Type = DHCP ACK
Option: (t=54,l=4) Server Identifier = 192.168.1.1
Option: (t=1,l=4) Subnet Mask = 255.255.255.0
Option: (t=3,l=4) Router = 192.168.1.1
Option: (6) Domain Name Server
Length: 12; Value: 445747E2445749F244574092;
IP Address: 68.87.71.226;
IP Address: 68.87.73.242;
IP Address: 68.87.64.146
Option: (t=15,l=20) Domain Name = "hsd1.ma.comcast.net."3.5.4 (3) ISP获取地址块
ICANN: Internet Corporation for Assigned Names and Numbers
国际通用的机构,专门管理Name(域名)和Number(ip)
一个ISP如何获得一个地址块?
向ICANN申请
- 分配地址
- 管理DNS
- 分配域名,解决冲突
3.6 IP 层次编址与路由聚合
为了减小全球互联网路由表的规模,路由聚合 (Route Aggregation) 技术至关重要。
3.6.1 路由聚合过程
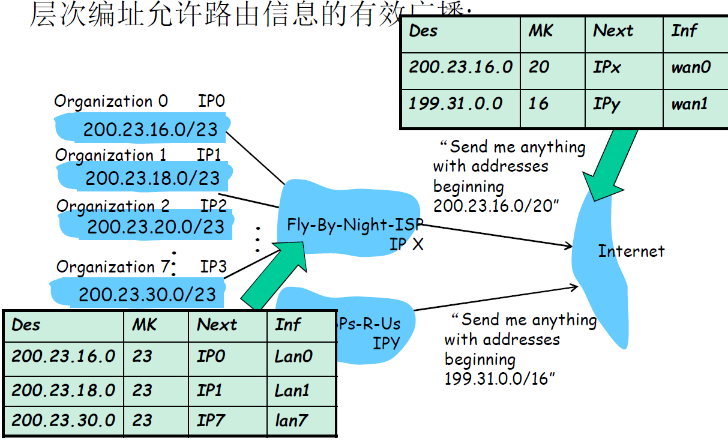
- 子网通告:一个组织内的各个子网(如 Organization 0-7)会向其上级路由器通告自己的网络前缀(例如,
200.23.16.0/23)。 - 聚合通告:上级路由器(机构总路由器)收集到这些来自内部子网的路由信息后,如果发现它们可以被聚合成一个更大的地址块(例如,8 个
/23的网络可以聚合成一个/20的网络200.23.16.0/20),它就会只向外部的 ISP 通告这个聚合后的、更短的前缀。 - 数据转发:当 ISP 的路由器收到一个目标地址属于这个
/20地址块的数据包时,它只需根据聚合路由将包发给机构的总路由器。总路由器再根据其内部更具体的路由表,将数据包转发到正确的子网。
3.6.2 最长前缀匹配原则
在路由聚合的环境下,可能会出现一个目标地址同时匹配多个路由表项的情况。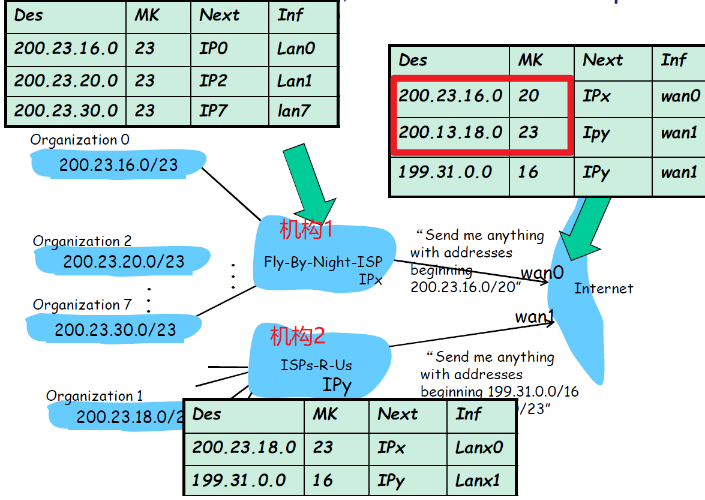
- 场景:假设 Organization 1 被Organization 2收购后,网络迁移到了别处,但仍保留其原始的 IP 地址块
200.23.18.0/23。它的新服务商会向互联网通告这个具体的/23路由。同时,它原来的上级 ISP 仍然在通告包含它的那个聚合路由/20。 - 匹配原则:当一个数据包的目的地址(如
200.23.18.7)同时匹配/20和/23两个路由时,路由器会遵循最长前缀匹配 (Longest Prefix Match) 原则,选择前缀更长、更具体的路由(即/23)进行转发。这是因为最长的匹配通常意味着最精确的路径。
匹配冲突时候,采取的是最长前缀匹配
3.7 IP addressing: last words …
3.7.1 Q: how does an ISP get block of addresses?
A: ICANN: Internet Corporation for Assigned Names and Numbers http://www.icann.org/
- allocates IP addresses, through 5 regional registries (RRs) (who may then allocate to local registries)
- manages DNS root zone, including delegation of individual TLD (.com, .edu , …) management
3.7.2 Q: are there enough 32-bit IP addresses?
- ICANN allocated last chunk of IPv4 addresses to RRs in 2011
- NAT (next) helps IPv4 address space exhaustion
- IPv6 has 128-bit address space
“Who the hell knew how much address space we needed?” Vint Cerf (reflecting on decision to make IPv4 address 32 bits long)
3.7.3 机构获取 IP 地址块
- 机构内部:一个大型机构(如大学)可以从其互联网服务提供商(ISP)那里获得一个大的地址块(例如,一个
/20的网络)。然后,机构可以根据内部需求(如不同的校区)将这个大地址块进一步划分为多个更小的子网(例如,8 个/23的网络)进行分配。 - ISP 获取地址:ISP 自身也需要从更高级别的机构获取地址块。全球的 IP 地址和域名由一个名为 ICANN (互联网名称与数字地址分配机构) 的组织统一管理和分配。
| 组织序号 | ip | ip地址(二进制) |
|---|---|---|
| Organization 0 | 200.23.16.0/23 | 11001000 00010111 0001 000 0 00000000 |
| Organization 1 | 200.23.18.0/23 | 11001000 00010111 0001 001 0 00000000 |
| Organization 2 | 200.23.20.0/23 | 11001000 00010111 0001 010 0 00000000 |
| … | ||
| Organization 7 | 200.23.30.0/23 | 11001000 00010111 0001 111 0 00000000 |
3.8 NAT:网络地址转换 (Network Address Translation)
3.8.1 原理
NAT 技术的核心在于解决 IP 地址短缺的问题。在一个本地网络(如家庭或公司局域网)中,所有设备使用的都是内网地址(例如 10.0.0.0/24),这些地址在互联网上是不可路由的。
当内网设备需要访问外部网络时,NAT 路由器会将其源 IP 地址和端口号替换为路由器自身拥有的、唯一的公网 IP 地址和一个新的端口号。
这个过程的本质是用一个外网端口号来代替内网 IP:端口号的组合。路由器会维护一张 NAT 转换表,记录下这种内外地址和端口的映射关系。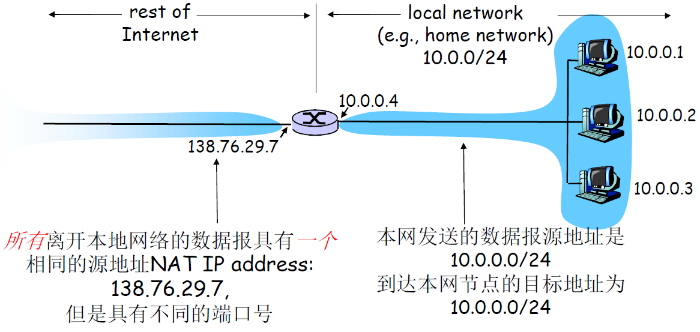
当外部服务器返回数据时,数据包的目标地址是 NAT 路由器的公网 IP 和那个新的端口号。路由器查阅转换表,根据映射关系,将目标地址和端口号再转换回原始的内网 IP 和端口号,从而将数据准确地转发给内网中正确的设备。
3.8.2 流程与优点
NAT 路由器的具体工作流程: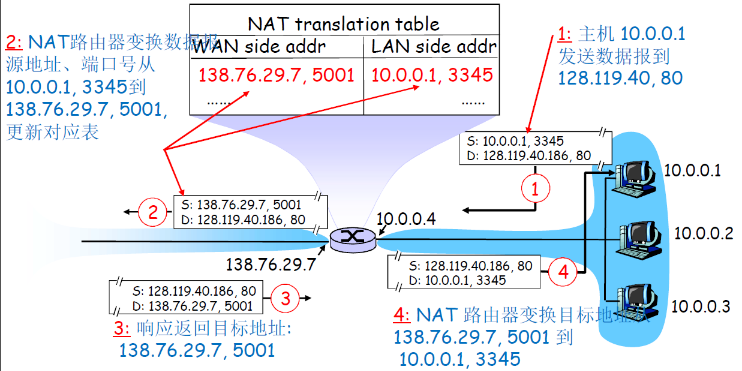
- 外出数据包: 将数据包的源 IP 地址和端口号,替换为 NAT 路由器的公网 IP 地址和一个新端口号。目标地址和端口则保持不变。
- 记录映射: 在 NAT 转换表中记住这个转换关系,即(源 IP, 源端口)与(NAT IP, 新端口)的映射对。
- 进入数据包: 根据转换表中的记录,将数据包的目标 IP 地址和端口号替换回原始的内网 IP 和端口号,然后转发给内网设备。
NAT 的主要优点:
- 节约成本: 整个局域网只需要一个公网 IP 地址,无需为每台设备都从 ISP 申请独立的 IP 地址,这极大地节省了费用。
- 便于管理: 可以在局域网内部自由更改设备地址,而无需通知外部网络。同样,如果更换了 ISP 导致公网 IP 变更,也无需修改内部设备的网络配置。
- 提升安全: 局域网内的设备不直接暴露在公网中,它们的地址对外部网络是不可见的,这在一定程度上提高了内部网络的安全性。
3.8.2.1 NAT 协议工作原理(以 TCP 为例):
- 过程: 当内网数据包向外发送时,NAT 网关将源 IP(私网)和源端口替换为公网 IP 和一个新的随机端口,并在 NAT 表中记录映射关系。回程包到达时,网关根据端口映射表将目的 IP 和端口还原为原始的私网地址发送回内网。
3.8.3 NAT 的争议与问题
尽管 NAT 应用广泛,但它也引发了一些争议。
- 违反了网络分层原则: 路由器作为第三层(网络层)设备,其核心功能是处理 IP 地址。但 NAT 技术却修改了第四层(传输层)的端口号信息,这被认为是“越权”操作。老师用了一个比喻:这就像一个团长拆开了师长的信,还修改了信的内容。
- 违背了端到端(end-to-end)原则: 该原则主张网络的复杂性应放在边缘节点,中间的网络设备应尽可能简单,仅负责转发。NAT 的存在破坏了这种透明的直接通信模式,使得外部主机无法主动发起与内网主机的连接。
- NAT 穿越问题:NAT 带来的一个核心问题是“NAT 穿越”:如果一个外部客户端需要连接到一个位于 NAT 路由器后面的内网服务器,应该如何操作?因为服务器的内网地址(如 10.0.0.1)对外部客户端是不可见的。
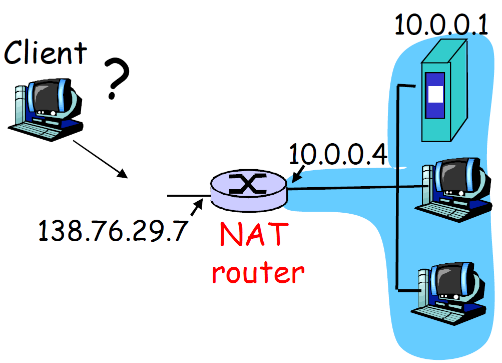
3.8.3.1 NAT 对 P2P 应用程序的影响:
- 影响: NAT 会阻碍 P2P 的直接连接。因为外网主机无法主动发起连接到处于 NAT 之后的内网主机(NAT 表中没有对应的入站映射),通常需要通过“打洞”技术或中继服务器(STUN/TURN)来解决穿越问题。
3.8.4 NAT 穿越问题
- 客户端需要连接地址为 10.0.0.1的服务器
- 服务器地址10.0.0.1 LAN本地地址 (客户端不能够使用其作为目标地址)
- 整网只有一个外部可见地址: 138.76.29.7
3.8.4.1 ① 静态配置 NAT
这是一种直接的解决方案。网络管理员可以在 NAT 路由器上手动配置一条静态映射规则。
例如,设置将所有访问路由器公网 IP 138.76.29.7 的 2500 端口的请求,都固定转发到内网服务器 10.0.0.1 的 25000 端口。这种方法简单有效,但缺乏灵活性。
3.8.4.2 ② UPnP / IGD 协议
UPnP(Universal Plug and Play,通用即插即用)的 IGD(Internet Gateway Device)协议提供了一种更为自动化的解决方案。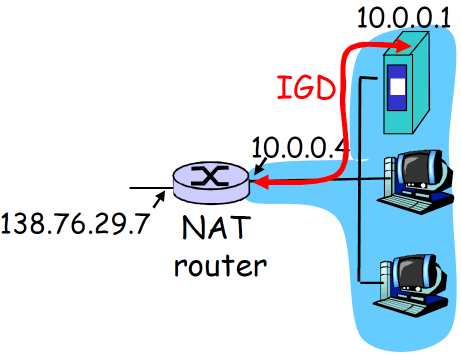
该协议允许内网中的主机动态地与 NAT 路由器通信,允许NATted主机可以:
- 获知网络的公共IP地址 (138.76.29.7)
- 列举存在的端口映射
- 增/删端口映射 (在租用时间内)
通过这种方式,内网服务器可以自动在路由器上“打洞”,将外部端口映射到自己身上,从而让外网用户能够访问。
i.e., 自动化静态NAT端口映射配置
3.8.4.3 ③ 中继 (Relaying)
这种方法被 Skype 等应用广泛使用。它的核心思想是引入一个公网上的“中继服务器”。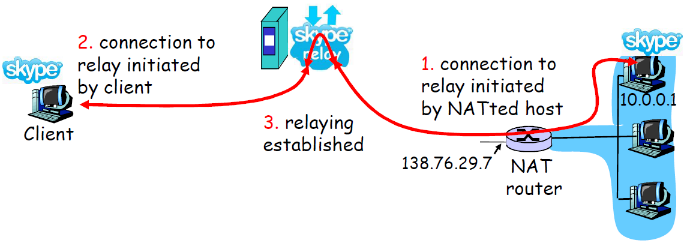
- 位于 NAT 后面的内网服务器主动与中继服务器建立连接。
- 外部的客户端也连接到这个中继服务器。
- 中继服务器扮演一个“桥梁”的角色,在客户端和内网服务器这两个连接之间转发数据。
这样,虽然客户端和服务器无法直接通信,但通过中继服务器这个中间人,也实现了间接的数据交换。
3.9 IPv6 协议
3.9.1 (1) IPv6 的目的与动机
IPv6 被设计出来的初始动机非常明确:解决 IPv4 地址空间即将耗尽的问题。IPv4 使用 32 位地址,理论上最多只有约 40 亿个地址,这在互联网早期看似足够,但后来证明远远不够用。
老师补充道,IPv5 并非 IPv4 的下一代,而是一个被废弃的实验性协议。
除了扩展地址空间,IPv6 还有其他重要动机:
- 简化头部格式,加速转发: IPv6 移除了一些字段(如头部校验和),并将一些功能(如分片)移出路由器,旨在减轻路由器的处理负担,提高转发效率。
- 更好地支持服务质量(QoS): 新增的“流标签”等字段为实现更高质量的网络服务提供了底层支持。
3.9.2 (2) IPv6 数据报格式
IPv6 的数据报头部是固定长度的 40 字节,这与 IPv4 的可变长度头部不同,有助于硬件进行更快速的处理。
最显著的变化是地址长度,从 IPv4 的 32 位(4 字节)扩展到了 128 位(16 字节),这提供了一个几乎用之不竭的地址空间。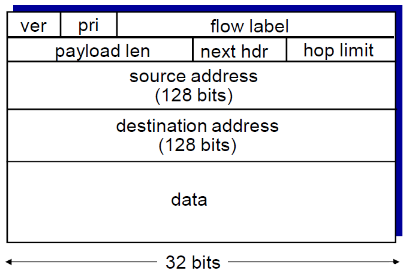
一个重要的改变是,IPv6 不允许中间路由器对数据包进行分片。如果一个分组太大超过了链路的 MTU,路由器会直接丢弃该分组,并向源主机发送一个 ICMPv6 的“分组太大”错误报告,由源主机负责将数据拆分成更小的分组重新发送。
IPv6 头部中的一些关键字段:
- Priority (优先级): 用于标识数据报在流中的优先级,可以与收费等非技术因素结合,实现差异化服务。
- Flow Label (流标签): 用于标识属于同一个“流”的一系列数据报。尽管“流”的概念没有被严格定义,但这个字段为网络处理相关数据包提供了便利。
- Next Header (下一个头部): 这个字段指明了紧跟在 IPv6 头部后面的数据类型,作用类似于 IPv4 的协议字段,用于指示上层协议是 TCP 还是 UDP。
与 IPv4 的其他变化:
- Checksum (校验和): 头部校验和被移除,以降低每一跳路由器的处理开销。
- Options (选项): 选项字段不再是基本头部的一部分,而是通过“NextHeader”字段以“TLV”(Type-Length-Value)格式来指明,使头部处理更高效。
- ICMPv6: 这是 ICMP 协议的新版本,
- 增加了新的报文类型,如“Packet Too Big”
- 并整合了多播组管理等功能。
- Hop Limit:就是IPv4里面的TTL
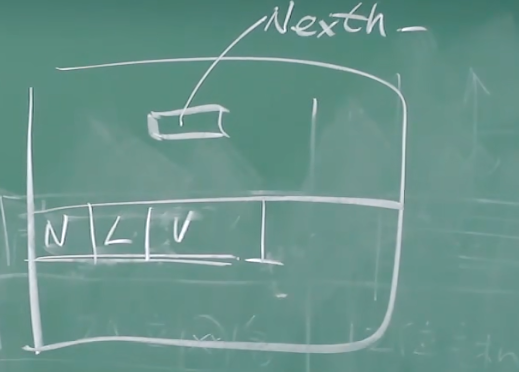
详细讲一下NextHeader
这里前面是40B的头部,然后NextHeader可以置顶上层的服务协议是TCP或者UDP;也可以再来一个NextHeader(在40B之后的位置)。会指定TLV(Type,Value,Len),所以这也是一种典型的TLV的形式的数据结构。也称为自解释的
3.9.3 (3) 从 IPv4 到 IPv6 的过渡:隧道技术
从 IPv4 全面升级到 IPv6 是一个漫长而复杂的过程,不可能在一夜之间完成(即不存在一个“flag day”)。因此,在过渡期内,IPv4 和 IPv6 网络必然会混合存在。
为了让孤立的 IPv6 网络能够通过庞大的 IPv4 骨干网进行通信,人们发明了隧道(Tunneling) 技术。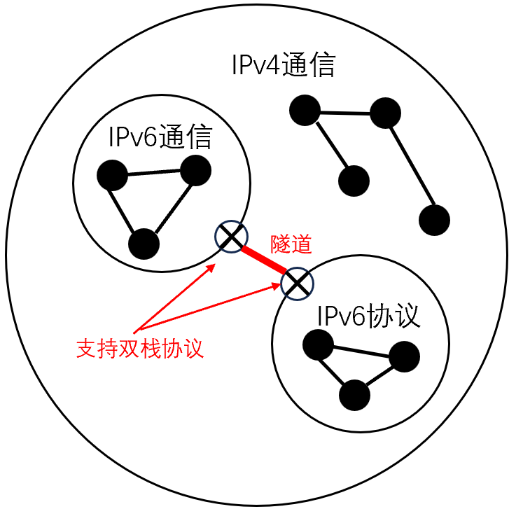
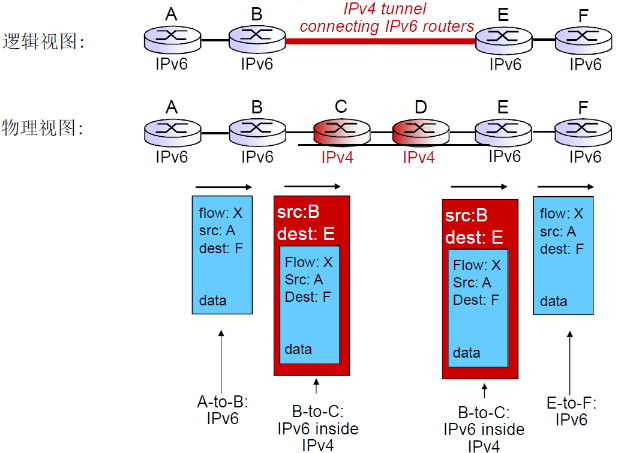
隧道的原理是将一个完整的 IPv6 数据报作为数据部分(Payload),封装到一个 IPv4 数据报中。
当一个 IPv6 分组需要从一个 IPv6“孤岛”发送到另一个 IPv6“孤岛”时,它首先到达支持双栈协议(同时支持 IPv4 和 IPv6)的边缘路由器。该路由器会将整个 IPv6 分组打包成一个 IPv4 分组的数据,然后在 IPv4 网络中进行传输。当这个 IPv4 分组到达目的 IPv6 网络的边缘路由器时,再被“解包”,恢复成原始的 IPv6 分组。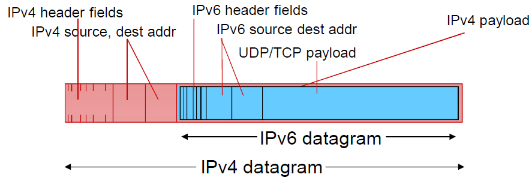
老师用了一个生动的比喻来形容这个过渡过程:最初,IPv6 网络就像是广阔的 IPv4 海洋中的几个小岛。随着时间的推移,IPv6 的部署范围越来越大,小岛不断扩张、合并,最终 IPv6 会成为大陆,而 IPv4 则可能变成其中的几个“小湖泊”。
3.9.4 (4) IPv6 的应用
IPv6 的部署是一个渐进的过程,预计还需要很长时间。尽管如此,它已经在逐步推广。例如,Google 的部分客户已经通过 IPv6 访问其服务,许多政府和大型机构的域也已支持 IPv6。
为什么这个过渡会如此漫长?老师解释说,更换底层协议就像是重建整栋房子的地基,而添加一个新的应用程序则仅仅像是给房子刷上一层新油漆。前者的成本和复杂性远高于后者,因此企业和运营商缺乏足够强的经济动机来快速完成这一转变。
4 SDN 控制平面
网络层功能:
- 转发: 对于从某个端口 到来的分组转发到合适的 输出端口
- 路由: 决定分组从源端 到目标端的路径
4.1 传统网络层及其问题
我们之前学习的几乎所有网络层知识都基于一种传统的工作方式,即每台网络设备(如路由器)都集成了数据平面与控制平面,并且控制平面是通过分布式的方法实现的。
4.1.1 传统方式:每路由器(Per-Router)的控制平面
在传统网络中,每个路由器内部都包含用于实现路由算法的元件。这些元件相互之间进行交互,共同构成了整个网络的控制平面。
这种控制平面是完全分布式的,逻辑决策由每一个路由器独立完成。这种设计虽然有其优点,但也导致了显著的管理难题。
- 垂直集成:在传统设备中,数据平面(负责转发数据包)和控制平面(负责决定路径)是紧密集成在一起的。
- 分布式实现:控制平面的功能,如运行路由协议(RIP, OSPF, BGP 等),是在每个设备上独立、分散地实现的。
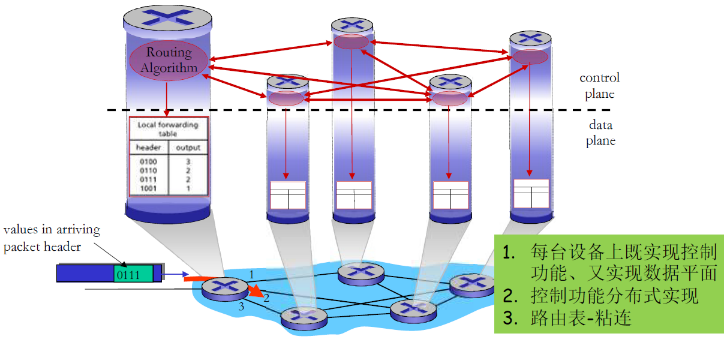
互联网网络设备:传统方式都是通过分布式,每台 备的方法来实现数据平面和控制平面功能
- 垂直集成: 每台路由器或其他网络设备 ,包括:
- 硬件、在私有的操作系统;
- 互联网标准协议(IP, RIP, IS-IS, OSPF, BGP)的私有实现
- 从上到下都由一个厂商提供(代价大、被设备上“绑架”“)
- 每个设备都实现了数据平面和控制平面的事情
- 控制平面的功能是分布式实现的
- 设备基本上只能(分布式升级困难)按照固定方式工作, 控制逻辑固化。
- 不同的网络功能需要不同的 “middleboxes”:防火墙、负载均衡设备、NAT boxes,.
- (数据+控制平面)集成>(控制逻辑)分布→固化
- 代价大;升级困难;管理困难等
4.1.2 传统网络设备的挑战
传统网络不仅有路由器,还充满了各种各样的“中间盒”(Middleboxes),例如防火墙、网络地址转换(NAT)、入侵检测系统(IDS)、负载均衡器等。这些设备都有其特定的网络功能。
这种模式带来了几个核心问题:
- 功能固化与设备繁多:每种网络功能都需要一个特定的硬件设备来实现。每台设备都集成了自己的控制和数据平面。当需要引入新功能时,就必须设计、实现并部署全新的硬件设备,导致网络中设备种类繁多。
- 管理困难:由于控制逻辑是分布在成千上万台设备上的,并且通常是私有厂商实现的,进行网络管理、配置和升级都变得异常困难和昂贵。一个配置错误就可能影响全网的运行。
- 创新缓慢:在这种垂直集成的封闭体系下,硬件、私有操作系统和私有协议实现都由单一厂商提供。这导致设备价格昂贵,用户被厂商“绑架”,并且严重阻碍了网络领域的创新。
网络维护员的薪资很高,因为要管理的网络设备很多,也很难
4.1.3 流量工程难题
流量工程(Traffic Engineering)是传统网络面临的一大挑战。由于IP路由是面向目标的(只关心如何到达目的地),我们很难对数据流的路径进行精细化控制。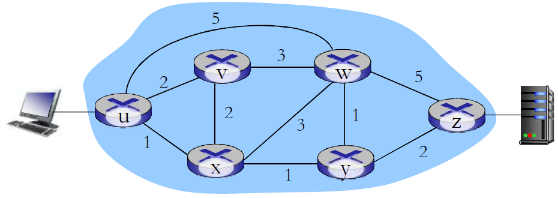
案例分析:
假设一个网络管理员希望:
- 指定路径:让从u到z的流量走
u-v-w-z路径,而从x到z的流量走x-w-y-z路径。在传统网络中,这几乎无法实现,因为路由算法(如LS或DV)仅根据链路的“代价”计算最短路径,无法为人为指定的路径服务。 - 负载均衡:将从u到z的流量同时分摊到
u-v-w-z和u-x-y-z两条路径上。这在传统IP路由体系下同样无法完成。 - 区别对待:对不同类型(如红色和蓝色)的流量采用不同的路由策略。这也是传统路由器基于目标的转发机制所不支持的。
这些问题的根源在于,传统网络的控制逻辑是固化和分布式的,缺乏一个全局的、可编程的视角来统一协调全网的流量。
4.2 SDN 概述:逻辑上集中的控制平面
为了解决传统网络的种种弊端,从2005年左右开始,业界开始重新思考网络控制平面的实现方式,最终催生了SDN。其核心思想是:将数据平面与控制平面分离,并对控制平面进行逻辑上的集中化管理。
4.2.1 (1) SDN 的核心思路
在SDN架构中,网络设备被简化为纯粹的数据平面设备,我们称之为“分组交换机”。这些交换机的唯一任务就是根据“流表”(Flow Table)来对数据包执行匹配和动作。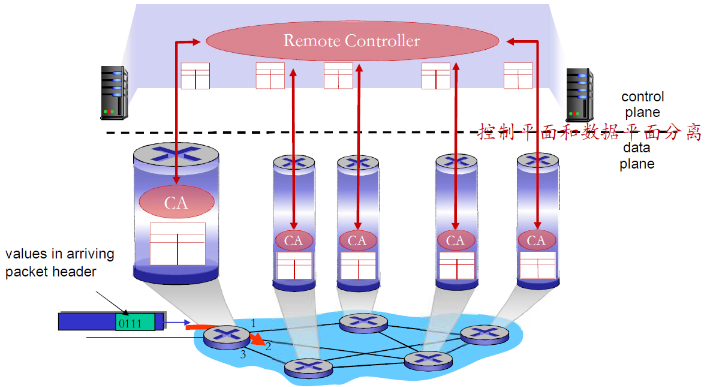
而复杂的控制逻辑则从交换机中剥离出来,集中在一个远程的、逻辑上集中的控制器(Controller)上。
- 数据平面:由简单的分组交换机组成,负责执行转发。
- 控制平面:由SDN控制器实现,负责计算和下发控制逻辑(即流表)。
- 交互:控制器通过一个开放的“南向接口”(Southbound API),与每个交换机上的控制代理(Control Agent, CA)进行通信,下发流表规则并收集网络状态。
4.2.2 (2) SDN 的优势
将控制平面与数据平面分离带来了革命性的变化:
- 开放与创新(水平集成):与传统设备的垂直集成不同,SDN实现了水平集成。交换机、控制器和网络应用可以由不同的厂商开发,通过开放的接口协同工作。这打破了厂商锁定,引入了竞争,极大地促进了产业生态的繁荣和创新。
- 集中管理与简化:控制器拥有全局的网络视野,可以集中计算和管理整个网络的行为。这使得网络管理变得前所未有的简单,可以有效避免因单点配置错误导致的全局问题。
- 网络可编程性:通过控制器,网络管理员或应用程序可以像编写软件一样对网络行为进行编程。这使得实现复杂的流量工程、负载均衡和安全策略变得轻而易举,也为未来各种新型网络功能的实现提供了无限可能。
4.2.3 (3) 类比:从大型主机到个人电脑(PC)的演变
SDN带来的变革,可以类比于计算机领域从封闭的大型主机(Mainframe)到开放的个人电脑(PC)的演变。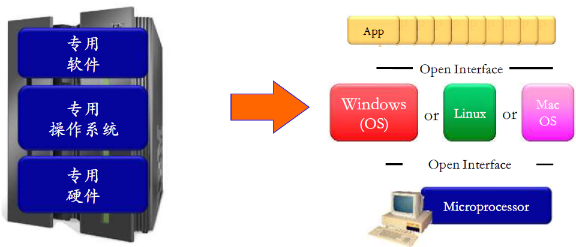
| 传统网络 (大型主机) | SDN (PC) |
|---|---|
| 垂直集成 | 水平集成 |
| 封闭、私有 | 开放接口 |
| 创新缓慢 | 快速创新 |
| 产业规模小 | 产业巨大 |
传统网络设备就像早期的IBM大型机,硬件、操作系统、软件全部由一家厂商包办。
而SDN则像PC生态,定义了开放的标准接口,使得不同厂商可以专注于硬件、操作系统或应用软件的开发,从而催生了巨大的产业和快速的技术创新。
4.2.4 (4) SDN 的四大特点
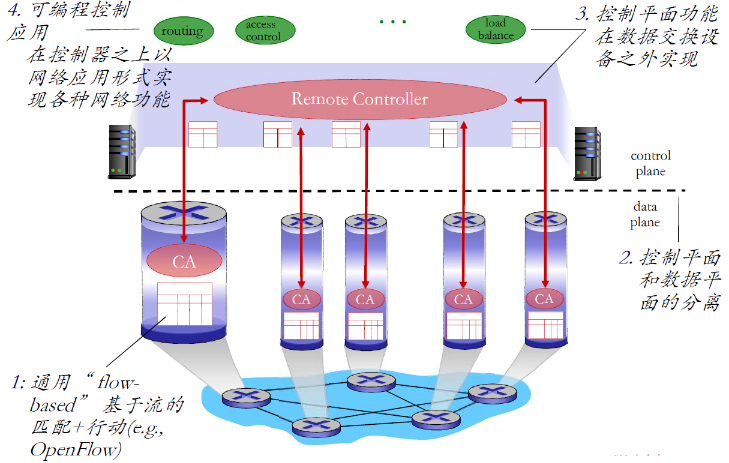
- 基于流的转发:网络设备的核心功能被统一抽象为对数据流的“匹配+行动”(Match+Action)。
- 控制与数据平面分离:这是SDN最核心的理念。
- 控制逻辑外部化:控制平面的功能在数据交换设备之外的控制器中实现。
- 网络可编程:网络功能以“网络应用”的形式运行在控制器之上,可以通过编程来实现。
4.3 5.3 SDN 架构详解
SDN的架构通常分为三个主要层面:数据平面、控制平面和应用平面。
4.3.1 (1) 数据平面:SDN 交换机
这是SDN架构的基础。SDN交换机是一种快速、简单的商业化交换设备,通常使用专用硬件来实现通用的转发功能。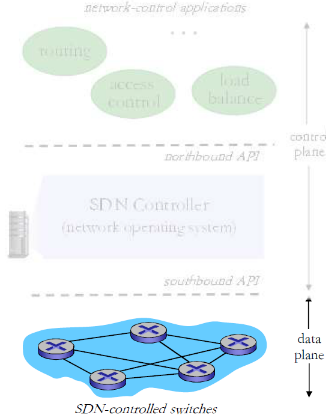
- 它内部维护一个由控制器计算和安装的流表。
- 它通过南向API(如OpenFlow协议)与控制器通信,接收流表规则并上报状态。这个API明确定义了交换机的哪些功能是可被外部控制的。
4.3.2 (2) 控制平面:SDN 控制器(网络操作系统)
SDN控制器是整个网络的大脑,也被称为网络操作系统(Network OS)。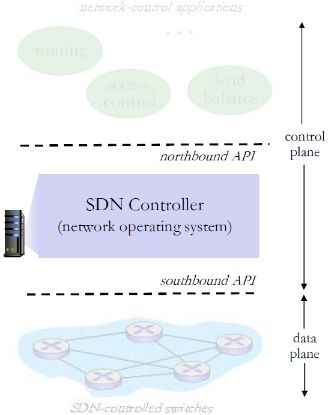
- 它通过南向API与所有交换机交互,维护全局的网络状态信息,如链路状态、拓扑结构等。
- 它通过北向API(Northbound API)向上层的网络应用提供服务,允许应用查询网络状态并下达控制指令。
- 尽管它是逻辑上集中的,但在实际部署中,为了性能、可扩展性和容错性,控制器通常采用物理上分布式的方式实现。
4.3.3 (3) 应用平面:网络控制应用
这是SDN架构的顶层,是实现具体网络功能的“大脑”。这些应用利用控制器提供的北向API服务,来实现各种高级网络逻辑。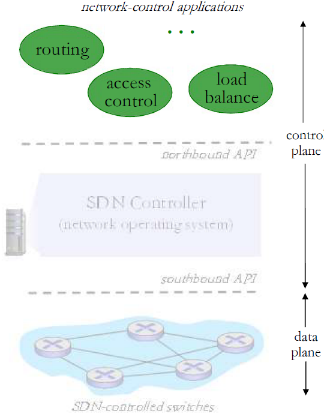
- 功能示例:路由、交换、防火墙、负载均衡等传统功能,都可以作为网络应用来实现。
- 开放性:这些应用可以由第三方开发者提供,与控制器和交换机的厂商无关,极大地丰富了网络的功能和生态。
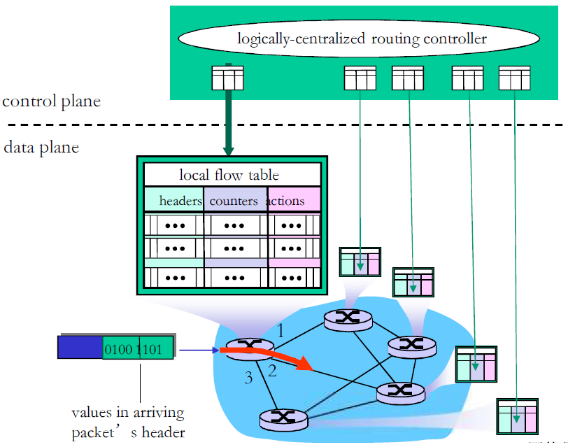
4.3.4 数据平面的流表
对于SDN来说,数据平面的就是流表
每个路由器包含一个流表(被逻辑上集中的控制器计算和分发)
4.4 5.4 OpenFlow 协议
通用flow-bascd基于流的匹配+行动(c.g,DpcnFlow)
OpenFlow,一种网络通信协议,属于 数据链路层 ,能够控制网上交换器或 路由器 的转发平面(forwarding plane),借此改变网络数据包所走的网络路径。
OpenFlow是目前最主流的南向接口协议,它定义了控制器与SDN交换机之间通信的标准。
4.4.1 OpenFlow:数据平面的抽象
OpenFlow就是数据平面的抽象
OpenFlow协议的核心是将交换机的转发功能抽象为对“流”(Flow)的处理。
- 流(Flow):由数据包头部的一系列字段值定义的一组数据包。例如,所有源IP为A、目的端口为80的数据包可以被定义为一个流。
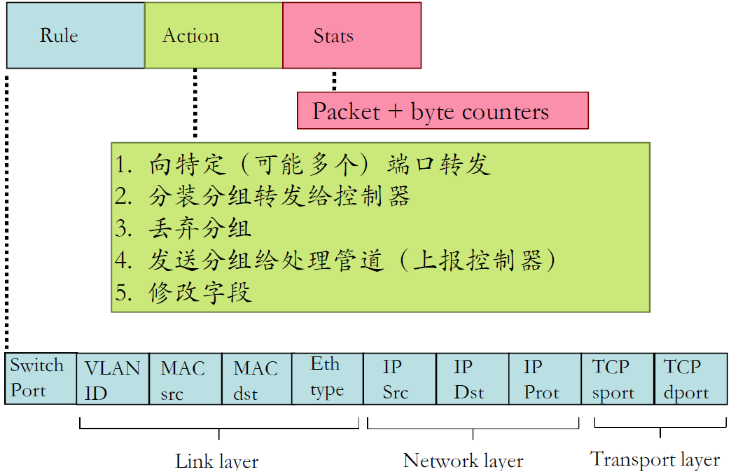
- 流表项(Flow Table Entry):每个流表项由三个部分组成:
- 匹配规则(Match Fields):定义了一个流,包含IP地址、MAC地址、端口号等多个头部字段。
- 行动(Action):定义了对匹配上的数据包要执行的操作,如转发到指定端口、丢弃、修改头部字段、或发送给控制器。
- 计数器(Counters):用于统计匹配该规则的数据包数量和字节数。
#bytes以及#packets - 优先级(Priority):几个模式匹配了,优先采用哪个,消除歧义
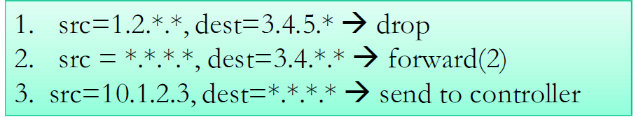
“匹配+行动”这一抽象模型具有极强的通用性,能够统一描述几乎所有网络设备的功能:
| 设备类型 | 匹配规则(Match) | 行动(Action) |
|---|---|---|
| 路由器 | IP目的地址(最长前缀匹配) | 从特定链路转发 |
| 交换机 | 目的MAC地址 | 转发或泛洪 |
| 防火墙 | IP地址和TCP/UDP端口号 | 允许或禁止 |
| NAT | IP地址和端口号 | 重写地址和端口 |
4.4.2 流表的表项结构
- Rule规则就是匹配规则
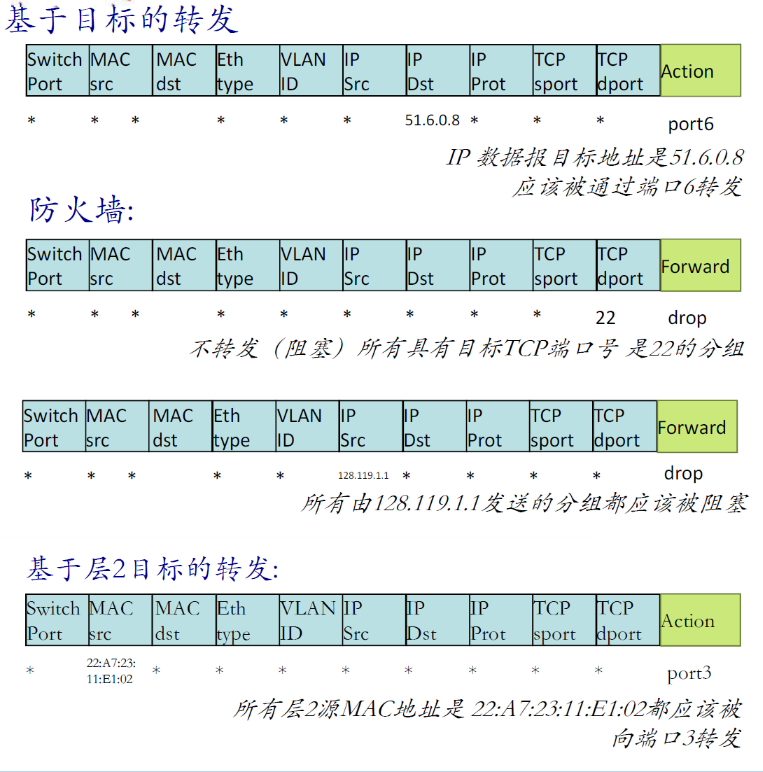
例子
4.4.3 (3) OpenFlow 协议消息
OpenFlow协议定义了控制器和交换机之间的交互消息类型:
- 控制器到交换机(Controller-to-Switch):
- Features:控制器查询交换机的特性。
- Configure:控制器配置交换机参数。
- Modify-State:控制器增、删、改流表中的条目。
- Packet-out:控制器直接指令交换机从特定端口发出一个数据包。这通常用于处理第一个到达但没有匹配规则的数据包。
- 交换机到控制器(Asynchronous):
- Packet-in:当一个数据包在流表中找不到任何匹配规则时,交换机会将该数据包封装在此消息中发送给控制器,请求处理指令。
- Flow-removed:当一个流表项因超时或被控制器删除时,通知控制器。
- Port status:当交换机端口状态发生变化(如链路断开)时,通知控制器。
4.4.4 SDN 工作流程示例:链路失效处理
下面我们通过一个实例来理解SDN的工作流程:
- 事件发生:交换机S1检测到其与S2之间的链路发生故障。
- 状态上报:S1通过OpenFlow的
Port status消息,将链路失效的状态上报给SDN控制器。 - 控制器更新状态:控制器收到消息后,更新其维护的网络信息库(如链路状态数据库)。
- 触发网络应用:链路状态的改变会触发在控制器上运行的路由应用(例如一个实现了Dijkstra算法的应用)。该应用之前已经向控制器“注册”,表示它关心网络拓扑的变化事件。
- 重新计算路径:路由应用从控制器获取最新的网络拓扑信息,重新运行Dijkstra算法,计算出新的最佳路径。
- 下发新流表:路由应用将计算出的新路径转化为具体的流表规则,通过控制器的北向API下发。
- 安装流表:控制器通过南向接口(OpenFlow),将这些新的流表规则安装到所有受影响的交换机(如S1)中。
至此,网络完成了对链路故障的自动适应和路径切换,整个过程无需人工干预。
4.4.5 主流 SDN 控制器
- OpenDaylight (ODL):一个功能强大、模块化的开源控制器,提供丰富的北向(REST API)和南向接口。
- ONOS (Open Network Operating System):另一个主流的开源控制器,专注于运营商网络,为大规模网络提供高性能、高可用性和可扩展性。
4.4.6 案例
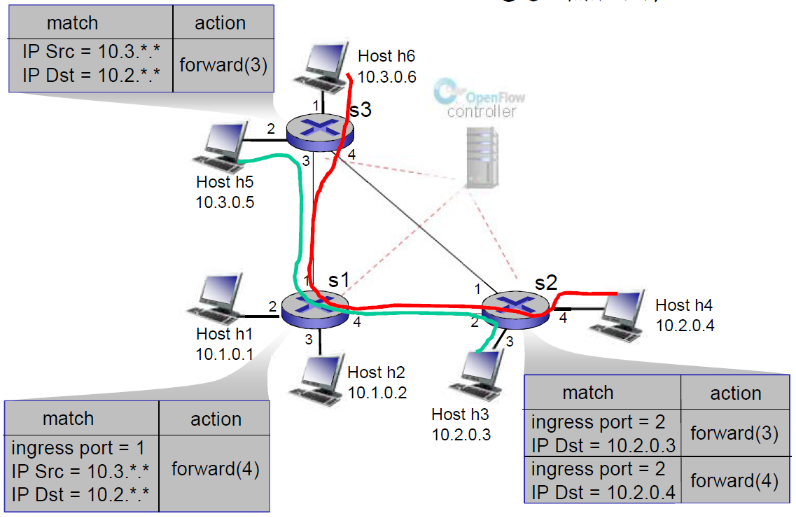
例子: 来自H5和H6的数据报应该被 发向H3 或者H4通过s1然后经由s2
4.5 5.5 SDN 面临的挑战
尽管SDN前景广阔,但它仍面临一些挑战:
- 可靠性与性能:逻辑上集中的控制器是网络的关键,其自身的可靠性、性能和可扩展性至关重要。如何构建一个健壮的分布式控制器系统是一个难题。
- 安全性与信任:控制器如何确保从交换机收到的状态信息是可信的,而不是被伪造的?这是一个关键的安全问题。
- 互操作性:如何满足网络中各种特殊任务的需求,并与现有网络协议良好协同。
- 可扩展性:SDN在单个自治系统(AS)内部部署已经比较成熟,但如何将其扩展到整个互联网范围,实现跨AS的协同控制,仍然是一个悬而未决的问题。
5 MiddleBox
5.1 Middleboxes (中间设备)
5.1.1 Middlebox (RFC 3234)
“any intermediary box performing functions apart from normal, standard functions of an IP router on the data path between a source host and destination host”
Other than forwarding or routing, 3 major types of services provided:
- NAT Translation
- Security Services
- Performance Enhancement

5.2 Middleboxes are evolving…
- initially: proprietary (closed) hardware solutions
- move towards “whitebox” hardware implementing open API
- move away from proprietary hardware solutions
- programmable local actions via match+action
- move towards innovation/differentiation in software
- network functions virtualization (NFV): programmable services over white box networking, computation, storage
- SDN: (logically) centralized control and configuration management often in private/public cloud
5.2.1 The IP hourglass in the “good old days”

5.2.2 The IP hourglass, at middle age

5.3 Architectural Principles of the Internet
5.3.1 RFC 1958
“Many members of the Internet community would argue that there is no architecture, but only a tradition, which was not written down for the first 25 years (or at least not by the IAB). However, in very general terms, the community believes that the goal is connectivity, the tool is the Internet Protocol, and the intelligence is end to end rather than hidden in the network.”
Three cornerstone beliefs:
- simple connectivity
- IP protocol: that narrow waist
- intelligence, complexity at network edge
5.3.2 The end-to-end argument
- some network functionality (e.g., reliable data transfer, congestion) can be implemented in network, or at network edge
 /file-20251230110519243.png)
- some network functionality (e.g., reliable data transfer, congestion) can be implemented in network, or at network edge
“The function in question can completely and correctly be implemented only with the knowledge and help of the application standing at the end points of the communication system. Therefore, providing that questioned function as a feature of the communication system itself is not possible. (Sometimes an incomplete version of the function provided by the communication system may be useful as a performance enhancement.)
We call this line of reasoning against low-level function implementation the “end-to-end argument.""
—— Saltzer, Reed, Clark 1981
5.3.3 Where’s the intelligence?
 /file-20251230110600730.png)