- 本章的5.2节为原理,即一些路由选择算法
- 5.3节为实现,具体的协议
1 导论
回顾:2个网络层功能:
-
转发:将分组从路由器的一数据平面个输入端口移到合适的输出端口
-
路由:确定分组从源到目标控制平面的路径
-
forwarding: move packets from router’s input to appropriate router output data plane
-
routing: determine route taken by packets from source to destination control plane
2种构建网络控制平面功能的方法:
- 每个路由器控制功能实现(传统)
- 逻辑上集中的控制功能实现(software defined networking)
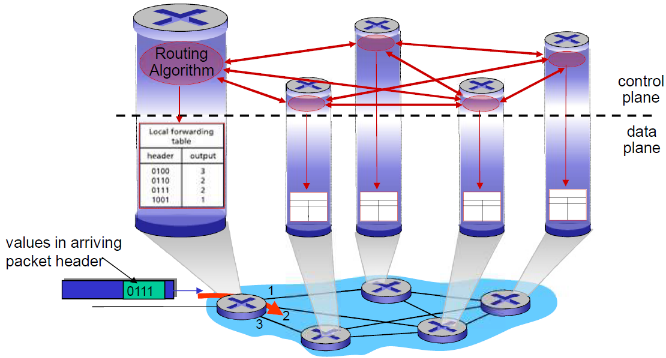
传统方式:每-路由器(Per-router)控制平面
在每一个路由器中的单独路由器算法元件,在控制平面进行 交互
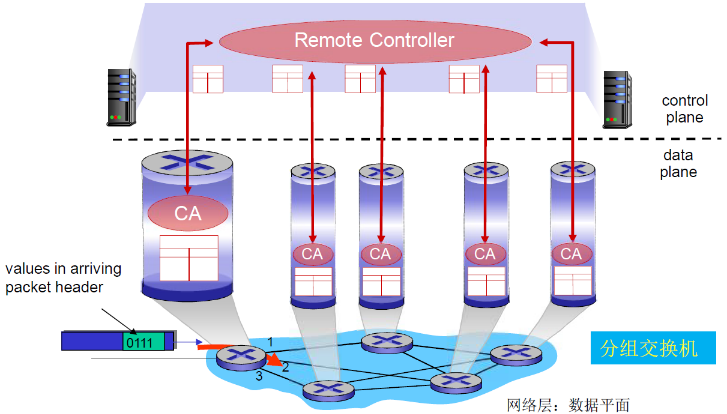
SDN方式:逻辑上集中的控制平面
一个不同的(通常是远程的)控制器与本地控制代理(CAs) 交互. 上发状态,下发流表
2 路由选择算法
2.1 引言:路由选择算法概述
本节课我们将学习传统的路由选择算法,主要包括两种:
- 链路状态算法 (Link State, LS)
- 距离矢量算法 (Distance Vector, DV)
学完算法后,我们会介绍互联网中基于这些算法的一些具体协议,例如RIP、OSPF、BGP等。算法相对抽象,而协议是算法的具体实现。
2.2 路由协议与路由概念
2.2.1 路由协议的目标
路由协议的目标是确定从源主机到目标主机之间,通过路由器网络的一条“较好”路径。“路径”指的是路由器(或等价于路由器)的序列。
什么是“较好”?
“较好”通常指满足特定指标的路径,例如:
- 代价最小 (Least cost)
- 最快 (Fastest)
- 最不拥塞 (Least congested)
- 指标:站数、延迟、费用、队列长度等, 或者是一些单纯指标的加权平均
路径的选择是一个网络中的核心问题,类似于网络界的 “Top-10” 挑战。
网络模型
我们可以将网络抽象为由节点(路由器)和边(链路)组成的图。例如,一个主机A想访问主机B,数据需要经过一系列的子网和路由器。
- 路径 (Path):数据包从源到目标所经过的路由器序列。
- 路由选择:在众多可能的路径中,根据某种指标(如跳数、延迟、费用等)选择一条最优或较优的路径。
2.2.2 路由(Route)的概念
路由的核心是找到一条从源节点到目标节点的较好路径,这里的节点通常指路由器或网络。
- 较好路径:根据设定的指标(如传输延迟、经过站点数、费用、队列长度等)衡量出的数值较小的路径。指标的选择反映了网络使用者对网络性能的期望。
- 最优路径:通常指源主机到目标主机之间的最低代价路径。路由器的主要功能之一就是找到这个最优路径。
- 路由计算单位:在互联网中,路由计算通常以网络(子网)为单位进行,而不是以单个主机为单位。这样做的原因是:
- 大大降低路由信息传输、计算和匹配的代价。IP地址数量庞大(IPv4约40多亿),为主机计算路由不现实。
- 前提是同一个网络内的所有节点地址前缀相同,且物理上聚集。
- 等价性:网络到网络的路由问题可以等价为路由器到路由器之间路由的问题。因为数据包到达目标网络所在的路由器,就相当于到达了目标网络。在网络内部,路由器到主机的数据传输由链路层解决。
因此,路由本质上是计算网络到其他网络如何走的问题。
2.3 网络的图抽象
2.3.1 图的表示
我们可以将计算机网络抽象成一个图 (Graph) 。
- 是路由器(节点)的集合。
- 是链路(边)的集合。连接路由器 u 和 v 的链路表示为 。
- 每条边 都有一个代价 (Cost) ,表示通过该链路传输数据的成本或指标。
路径代价
一条路径 的代价是路径上所有链路代价的总和:
边的代价衡量标准
边的代价 可以根据不同需求设定:
- 跳数 (Hop Count):代价为 1,表示经过一个路由器。目标是找到跳数最少的路径。
- 带宽 (Bandwidth):代价可以是链路带宽的倒数。目标是找到带宽最大的路径(即代价最小)。
- 拥塞情况 (Congestion):代价可以是链路拥塞程度的倒数。目标是找到最不拥塞的路径。
- 其他:也可以是延迟、费用等,或者是这些指标的加权平均。
选择何种代价标准取决于网络设计者希望优化的目标。
例子
- 图:
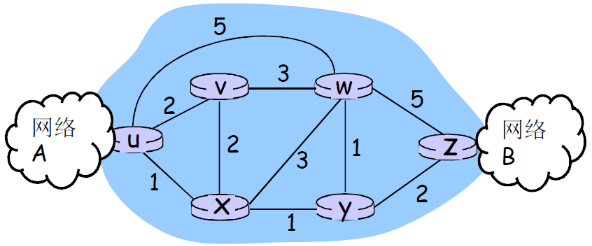
- = 路由器集合 =
- = 链路集合 = 边有 代价
核心问题
路由算法的核心问题是:给定一个源节点 u,找出从 u 到网络中所有其他节点 z 的最低代价路径。
2.3.2 最优化原则 (Optimality Principle)
汇集树 (Sink Tree)
对于网络中的任何一个节点(作为目标节点或汇集点 Sink),从所有其他节点到该节点的最优路径集合构成一棵树,称为汇集树。这棵树的根是目标节点。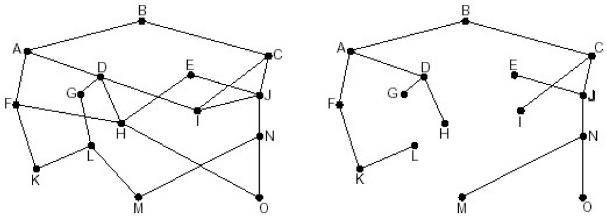
同样地,从一个源节点出发,到所有其他节点的最优路径集合也构成一棵以源节点为根的树(有时也叫源树或最短路径树)。
路由算法的目标
路由选择算法的任务就是为网络中的所有路由器(节点)找到并使用它们的汇集树(或源树)来确定转发路径。
- 输入:网络拓扑结构、所有边的代价、指定的源节点。
- 输出:源节点的汇集树(或最短路径树),用于构建路由表。
2.3.3 路由选择算法的原则
设计或评价一个路由选择算法时,通常考虑以下原则:
- 正确性 (Correctness) 和完整性 (Completeness):算法必须能正确地将分组一站一站地转发到目标站点。路由表必须包含到所有目标站点的路径信息,不能有没有处理方法的目标地址。
- 简单性 (Simplicity):算法在计算上应尽可能简单。过于复杂的算法虽然可能最优,但计算延迟大、开销高,可能不实用。获取路由信息不应增加过多的通信开销。
- 健壮性 (Robustness) 或鲁棒性:算法应能适应网络拓扑和通信量的变化。当网络拓扑(链路断开/恢复)或通信量(导致链路代价变化)发生改变时,算法应能快速适应,不向拥挤或断开的链路发送数据。
- 稳定性 (Stability):算法产生的路由不应频繁地摇摆或振荡。
- 公平性 (Fairness):算法对网络中的每一个站点都应公平对待,不应偏袒某些站点。
- 最优性 (Optimality):算法应能找到满足特定指标(如时间、费用等)的最优路径。但实际中,获取绝对最优的结果代价可能很高,因此有时选择次优(较优)路径也是可接受的。
2.4 路由算法的分类
路由算法可以从不同维度进行分类:
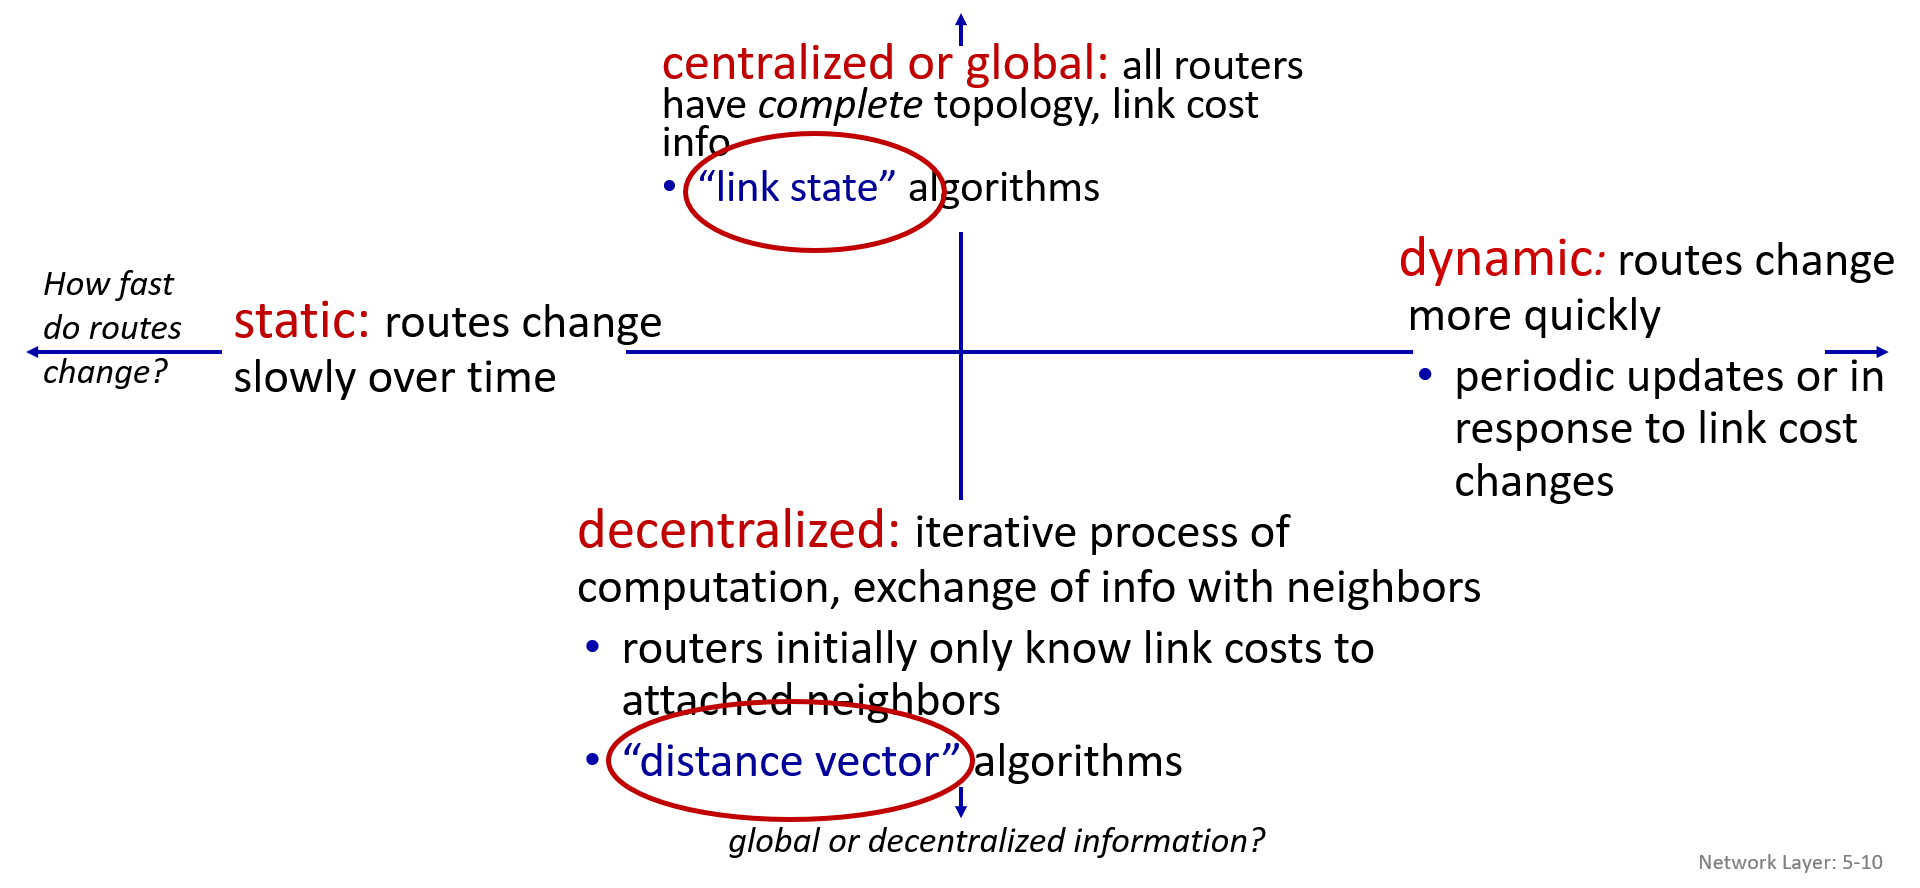
2.4.1 (1) 全局 vs. 局部信息
- 全局路由算法 (Global Routing Algorithm):
- 所有路由器都拥有关于整个网络的完整拓扑信息和所有链路的代价值。
- 例如:链路状态 (Link State, LS) 算法。
- 分布式/分散路由算法 (Decentralized Routing Algorithm):
- 每个路由器只知道与其直接物理连接的邻居路由器以及到这些邻居的链路代价值。
- 路由器通过与邻居迭代地交换路由信息,并进行计算,逐步获得到达更远目标的路由信息。
- 例如:距离矢量 (Distance Vector, DV) 算法。
2.4.2 (2) 静态 vs. 动态
- 静态路由算法 (Static Routing Algorithm):
- 路由随时间变化非常缓慢,通常由人工配置或离线计算得出。
- 也称为非自适应算法 (Non-adaptive Algorithm),不能适应网络拓扑和通信量的实时变化。
- 动态路由算法 (Dynamic Routing Algorithm):
- 路由会根据网络拓扑或链路代价的变化而快速调整。
- 通常会周期性地更新路由信息或在检测到变化时触发更新。
- 也称为自适应算法 (Adaptive Algorithm)。链路状态算法和距离矢量算法通常都属于动态算法。
2.5 链路状态路由选择算法 (Link State, LS)
链路状态算法本质上是在网络路由场景下应用 迪杰斯特拉 (Dijkstra) 算法。
2.5.1 基本思路
- 信息获取:每个节点(路由器)通过某种机制(如协议规定)获取整个网络的拓扑结构以及所有链路的代价信息。这是算法执行的前提,但获取过程本身不属于核心算法部分。
- 路径计算:每个节点独立地使用链路状态路由算法(即Dijkstra算法)计算出从自身到网络中所有其他节点的最优路径,形成一个以自身为根的最短路径树(汇集树)。
- 路由表生成:根据计算出的最优路径,生成该节点的路由表。
- 分组转发:当收到数据分组(Datagram)时,根据路由表进行转发。这一步属于数据平面的功能。
- centralized: network topology, link costs known to all nodes
- accomplished via “link state broadcast”
- all nodes have same info
- computes least cost paths from one node (“source”) to all other nodes
- gives forwarding table for that node
- iterative: after iterations, know least cost path to destinations
2.5.2 基本工作流程
链路状态路由的工作过程可以细分为以下步骤:
A. 获取网络拓扑和链路代价信息 (协议实现)
- 发现邻居:路由器启动后,向其所有接口发送HELLO分组,以发现与其直接相连的邻居路由器,并获知对方的网络地址(通常是全局唯一的标识符)。
- 测量到邻居的代价:通过发送ECHO分组并测量往返时间等方法,估算到每个邻居节点的链路代价(如延迟、开销)。
- 组装链路状态分组 (Link State Packet, LSP):每个路由器创建一个LSP,包含其自身标识、序列号、年龄(老化时间),以及其所有邻居的列表和到每个邻居的链路代价。
- 扩散(泛洪)LSP:将组装好的LSP通过泛洪 (Flooding) 的方式发送给网络中的所有其他路由器。通过这个过程,最终每个路由器都能获得网络中所有其他路由器产生的LSP,从而构建出完整的网络拓扑和链路代价图。
B. 计算最短路径并生成路由表 (Dijkstra 算法)
- 运行Dijkstra算法:每个路由器在本地,利用收集到的完整的网络拓扑和链路代价信息,运行Dijkstra算法,计算出从自身(源节点)到所有其他节点(目标节点)的最短路径。
- 每个节点独立计算。
- 这是一个迭代算法,第k步能确定到k个最近节点的最短路径。
- 生成路由表:根据Dijkstra算法计算出的最短路径树,提取出下一跳信息,生成路由表。
2.5.3 详细过程与泛洪机制
1. 发现邻居
- 路由器启动后,通过接口发送HELLO分组。
- 收到HELLO的邻居路由器回复应答,告知自己的身份标识。
- 在局域网 (LAN) 环境中,可能通过广播HELLO分组来发现同一网络内的其他路由器。有时会引入一个虚拟的“人工节点”来代表整个LAN。
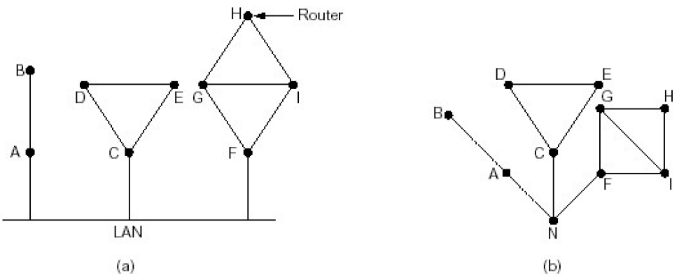
2. 测量到相邻节点的代价(延迟,开销)【测量链路代价】
- 常用实测法,如发送ECHO分组要求对方立即响应,通过测量往返时间(RTT)来估算延迟。
- 实测法,发送一个分组要求对方立即响应
- 回送一个ECHO分组
- 通过测量时间可以估算出延迟情况
3. 组装一个分组,描述相邻节点的情况【组装LSP】
- LSP包含发送者名称、序列号 (Sequence Number)、年龄 (Age) 和邻居列表(邻居ID及对应链路代价)。
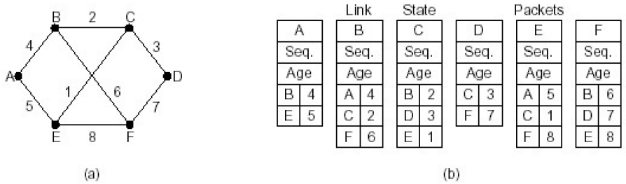
4. 将分组通过扩散的方法发到所有其它路由器【泛洪LSP】
泛洪(Flooding)的概念:老师解释说,泛洪就像发洪水一样。一个节点收到一个 LSP 后,会把它从除了接收端口之外的所有其他端口转发出去。这样一层一层地转发,最终能够确保网络中的所有节点都收到这个 LSP。
控制泛洪扩散的问题与机制
老师接着指出了简单泛洪可能存在的问题:如果网络中有环路,这种“你发给我,我发给你”的方式可能会没完没了,形成广播风暴,不断地重复发送,消耗网络资源。
因此,需要有机制来控制这种无穷的扩散。这里主要提到了两种机制:
- 顺序号 (Sequence Number)
- 目的:用来控制无穷扩散,区分新旧信息,避免重复处理。
- 工作方式:每个路由器都会记录它收到的 LSP 来自哪个源路由器以及对应的顺序号,形成一个(源路由器, 顺序号)的记录。当收到一个新的 LSP 时,会检查其顺序号。如果发现这个顺序号是重复的(之前收到过相同或更高的),或者是老的(比记录的要小),那么就不再向外扩散(转发)这个 LSP 了。
- 存在的问题:老师指出了仅靠顺序号存在几个具体问题:
- 循环使用问题:顺序号是有限的,用完了之后会从头开始(比如从0开始),这可能导致新的分组(序号小)被误认为是旧的分组。
- 路由器崩溃重启问题:如果一个路由器崩溃了,重启之后它的 LSP 顺序号可能会从 0 开始。这时它发出的新的 LSP,其序号可能比网络中残留的关于它的旧 LSP 的序号还要小,导致新的信息被错误地当作旧信息而丢弃。
- 序号出错问题:顺序号本身在传输或存储过程中可能发生错误。
- 年龄字段 (Age) - 解决顺序号问题的办法
- 目的:作为顺序号机制的补充,解决上述问题,确保旧的 LSP 最终能从网络中消失。
- 工作方式:
- 生成 LSP 时,设置一个初始的非零年龄值(类似于 IP 分组中的 TTL - Time To Live)。
- LSP 在网络中每经过一个时间段(或者像老师补充的,可能每经过一个路由器转发),其 Age 字段的值就减 1。
- 当一个 LSP 的 Age 字段减到 0 时,这个分组将被路由器抛弃,不再处理和转发。
- 效果:通过这种老化机制,即使存在顺序号的问题,过时的 LSP 也会因为年龄到期而被清除,从而保证了网络中信息的时效性。
补充:泛洪的可靠性 (虽然不在图片文字中,但老师紧接着讲了)
老师还补充说明了链路状态的泛洪过程通常是可靠的。这意味着需要确保 LSP 能够成功地传递给邻居。
- 确认机制 (ACK):当一个路由器(比如 A)向它的邻居(比如 C)发送一个 LSP 后,它会期望收到来自 C 的确认(ACK)。如果 A 没有在一定时间内收到 C 的 ACK,A 会重新向 C 发送这个 LSP。
- 同时A也会发给他的邻居并且期望他其他的邻居也会返回给他ACK
- 状态记录:路由器会维护关于 LSP 泛洪状态的信息,比如从哪个邻居收到了某个 LSP,需要向哪些邻居转发,以及需要等待哪些邻居的 ACK。
通过这些机制(顺序号、年龄字段、可靠确认),链路状态算法确保了每个路由器最终都能获得整个网络的、相对较新的、一致的拓扑和链路代价信息,为后续运行 Dijkstra 算法计算最短路径打下基础。
- 可靠泛洪:链路状态的泛洪通常是可靠的。使用确认 (ACK) 机制。路由器向邻居发送LSP后,期望收到邻居的ACK。如果未收到,会重传。
- 数据结构:路由器通常维护一个数据结构来跟踪从哪个邻居收到了LSP、需要向哪些邻居转发、需要等待哪些邻居的ACK等状态信息。
- 关于扩散分组的数据结构
- ✓ Source :从哪个节点收到LS分组
- ✓ Seq,Age:序号,年龄
- ✓ Send flags:发送标记,必须向指定的哪些相邻站点转发LS分组
- ✓ ACK flags:本站点必须向哪些相邻站点发送应答
- ✓ DATA:来自source站点的LS分组
节点B的数据结构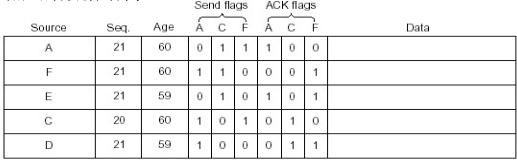
5. 运行Dijkstra算法
- 这是路由计算的核心步骤。
2.5.4 LS 算法的应用
- OSPF (Open Shortest Path First):广泛应用于互联网内部网关协议 (IGP),是一种典型的LS协议。
- IS-IS (Intermediate System to Intermediate System):另一种LS协议,常用于大型服务提供商的互联网主干网络中。
2.5.5 Dijkstra 算法详解
① 符号标记
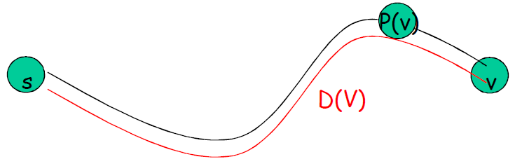
- : 节点 i 到节点 j 的链路代价。如果 i 和 j 不直接相邻,则初始代价为 。
- : 从源节点 s 到节点 v 的当前已知的最短路径代价。
- : 从源节点 s 到节点 v 的当前最短路径上的前序节点(即 v 的父节点)。
- : 已经找到从源节点 s 出发的最短路径的节点集合(永久节点集合)。
② 节点标记与分类
- 节点标记: 每个节点 v 关联一个二元组 ,例如 (3, B) 表示当前找到的从源到 v 的最短路径代价是 3,其前序节点是 B。
- 节点分类:
- 永久节点 (Permanent Node): 集合 中的节点,表示已经确定了从源节点到这些节点的最短路径。
- 临时节点 (Tentative Node): 不在 中的节点,表示尚未确定从源节点到这些节点的最短路径,当前的 只是一个临时的估计值。
③ 算法流程
- 初始化:
- 将源节点 s 加入永久节点集合 ,即 。
- 对于源节点 s,其代价 。
- 对于所有与 s 直接相邻的节点 v,设置 , 。
- 对于所有与 s 不直接相邻的节点 v,设置 。
- 所有非源节点初始时都是临时节点。
- 迭代循环 (选择 + 更新): 重复以下步骤,直到所有节点都加入 。
- 选择: 从所有临时节点中,选取一个当前路径代价 最小的节点 w。
- 将 w 加入永久节点集合 。
- 更新: 对于刚刚加入 的节点 w 的所有临时邻居节点 v:
- 比较:通过 w 到达 v 的路径代价 是否小于当前记录的到 v 的路径代价 。
- 如果 ,则更新 v 的标记:,并且 。这表示找到了一条经过 w 到达 v 的更短路径。
- 如果 ,则 v 的标记保持不变。
④ 算法示例
 (教师在黑板上演示了Dijkstra算法在一个具体网络图上的执行过程,从源节点A开始,逐步确定到其他节点B, C, D, E, F, G, H的最短路径代价和前序节点,最终构建出以A为根的最短路径树。)
- 初始化: , D(A)=0. D(B)=2, p(B)=A; D(G)=6, p(G)=A; 其他 D = .
- Step 1: 选择 B (D=2) 加入 . 更新 E: D(E)=min(, 2+7)=9, p(E)=B. 更新 F: D(F)=min(, 2+4)=6, p(F)=B. 更新 C: D(C)=min(, 2+3)=5, p(C)=B.
- Step 2: 选择 F (D=4) 加入 . 更新 E: D(E)=min(9, 4+2)=6, p(E)=F. 更新 G: D(G)=min(6, 4+2)=6, 不变. 更新 H: D(H)=min(, 4+4)=8, p(H)=F.
- Step 3: 选择 C (D=5) 加入 . 更新 D: D(D)=min(, 5+2)=7, p(D)=C.
- Step 4: 选择 G (D=5) 加入 . 更新 H: D(H)=min(8, 5+1)=6, p(H)=G. (注意这里G的代价是5,不是6,教师笔误,但修正了H的代价)
- Step 5: 选择 E (D=6) 加入 . 更新 C: D(C)=min(9, 6+3)=9, 不变. 更新 D: D(D)=min(7, 6+2)=8, 不变.
- Step 6: 选择 H (D=6) 加入 . 更新 D: D(D)=min(7, 6+2)=8, 不变.
- Step 7: 选择 D (D=7) 加入 .
- 所有节点都已加入 , 算法结束。
最终的最短路径树和路由表可以从各节点的 (D, p) 标记中得出。
2.5.6 性能和问题讨论
2.5.6.1 算法复杂度
- 设网络中有 n 个节点。
- 简单的实现中,每次迭代需要查找所有临时节点中代价最小的那个,这需要 时间。共进行 n 次迭代。更新邻居的操作总共涉及所有边,约为 。如果使用邻接矩阵,每次迭代更新邻居可能需要 。总复杂度约为 。
- 使用更有效的数据结构(如二叉堆或斐波那契堆)来存储和查找最小代价的临时节点,可以将复杂度优化到 或 ,对于稀疏图接近 。
2.5.7 可能的震荡问题 (Oscillation)
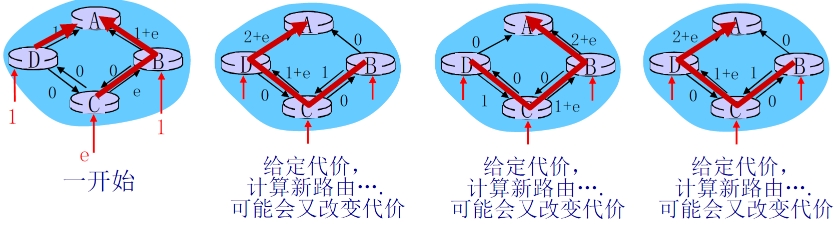
- 如果链路代价 是动态变化的,并且依赖于链路上承载的流量(例如,代价与拥塞程度成正比),那么 LS 算法(以及基于它的路由)可能会导致路由震荡。
- 示例场景:假设两条路径初始代价不同,所有流量都选择低代价路径。这导致低代价路径变得拥塞,代价升高;原高代价路径变为空闲,代价降低。下一次路由计算时,所有流量又会切换到当前代价较低的路径,导致该路径拥塞,如此反复。流量在两条(或多条)路径之间来回摆动。
- 这种震荡会影响网络性能的稳定性。实际协议如 OSPF 通常采用一些机制来缓解或避免此类问题,例如不频繁地更新代价或使用更复杂的代价计算方法。
-
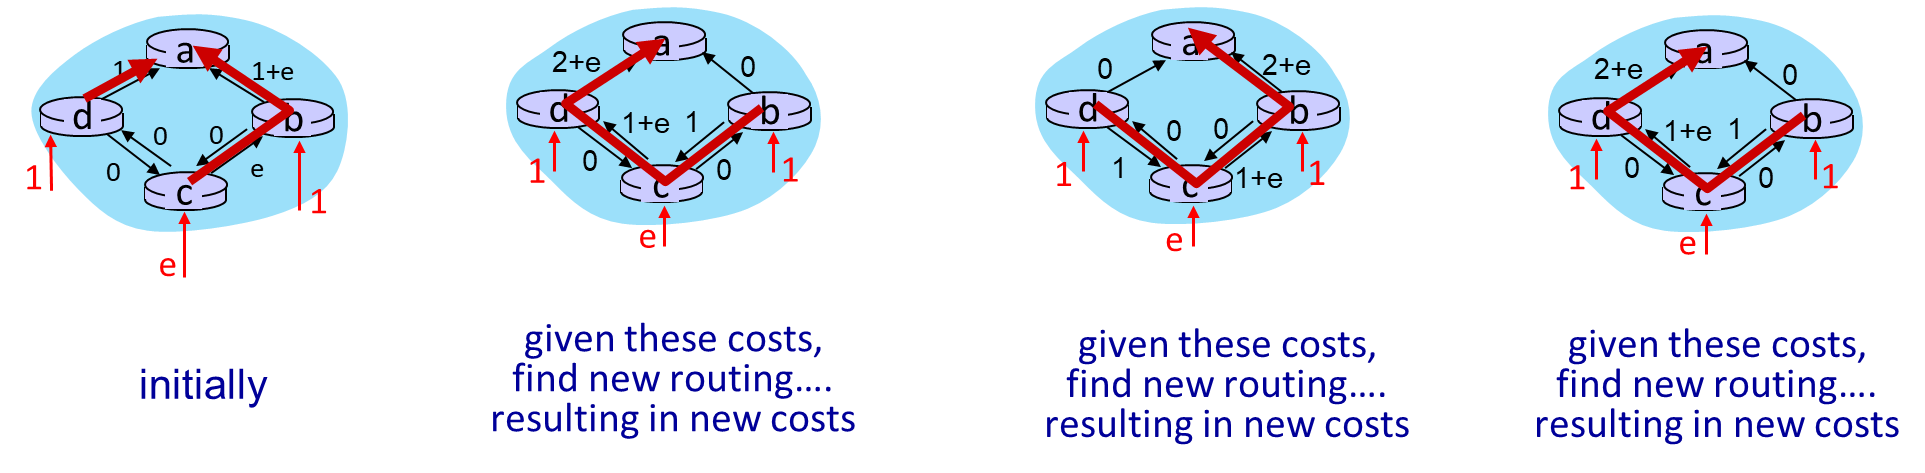
when link costs depend on traffic volume, route oscillations possible
-
sample scenario:
- routing to destination a, traffic entering at d, c, e with rates 1, e (<1), 1
- link costs are directional, and volume-dependent
-
Oscillations can occur in ANY routing algorithm that uses a congestion or delay-based metric.
-
Damages of oscillations:
- Poor stability and utilizations of network resources (“every one likes stable algorithm”)
- Increased route updates → router overload
- Long delay and packet drops
- Interference with TCP’s monitoring of RTT and estimation of Timeout Interval
-
How to prevent?
- No congestion/delay-based metric? ☹ Violates the goal of avoiding high-delay links
- Ensure routers run LS at different time, e.g. each router randomizes the time it sends out LS advertisement.
2.6 距离矢量路由 (Distance Vector Routing)
2.6.1 距离矢量路由 (DV) 简介
距离矢量路由(Distance Vector Routing) 算法是互联网中两种主要的路由选择算法之一,与之前讨论的链路状态(LS)算法并列。该算法由Bellman(1957年)和Ford-Fulkerson(1962年)分别提出,是一种分布式的算法。
它在早期的互联网协议中得到了广泛应用,例如ARPANET中的RIP协议,以及DECnet、Novell、AppleTalk等网络技术。
2.6.2 DV算法的基本思想
距离矢量算法的核心思想是,每个路由器(节点)都以自己为中心来维护和更新其路由表。这个过程主要分为三个步骤:
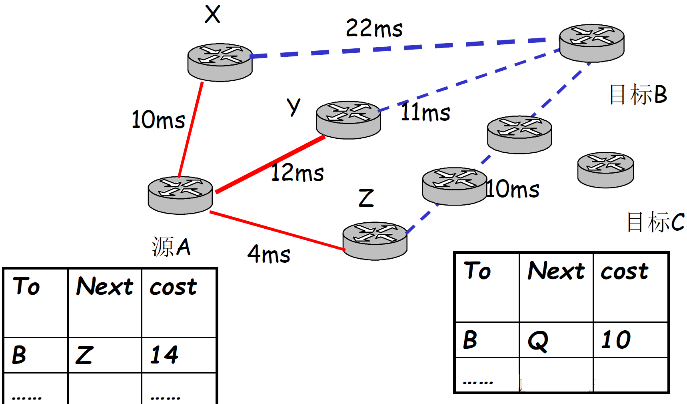
- 维护路由表:每个路由器都会维护一个路由表,记录了到达网络中各个目标(Destination/To)的最小代价(Cost)以及实现该最小代价路径的下一跳(Next Hop)。
| 目标 (To) | 下一跳 (Next) | 代价 (Cost) |
|---|---|---|
| A | Z | 14 |
| … | … | … |
-
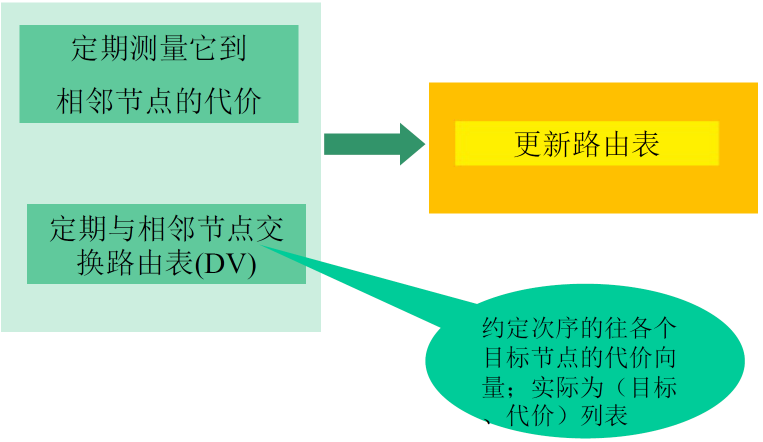
与邻居交换信息:路由器会定期地或者在路由信息发生变化时,与它直接相连的邻居交换彼此的路由表信息。这种交换的信息被称为“距离矢量”。
-
更新路由表:路由器根据从邻居那里获得的路由信息,结合自己本地的测量数据,重新计算并更新自己的路由表。
2.6.3 路由表的更新流程
路由表的更新遵循一个关键原则:通过比较不同路径的代价来寻找最优路径。
-
代价的获取:路径的代价(Cost)可以是多种衡量标准,如跳数(hops)、延迟(delay) 或 队列长度。节点到其直接相邻节点的代价可以通过实际测量获得。
-
信息更新逻辑:
- 首先,节点A通过实测得到它到各个相邻站点的直接代价。
- 接着,A会从它的每个邻居那里接收到它们各自声称的、到达最终目标站点B的代价。
- A会计算出经过每个邻居到达B的总代价。总代价 = (A到邻居的代价) + (邻居到B的代价)。
- 最后,A在所有计算出的路径中,找到一个总代价最小的路径。然后,它将这个最小代价以及对应的邻居(作为下一跳节点)更新到自己的路由表中。这个计算过程会对网络中所有的目标节点都执行一遍。
2.6.3.1 算法实例分析:例子1
我们通过一个具体的例子来理解DV算法的工作过程。
假设当前节点是 J,它的相邻节点有 A、I、H、K。
- 首先,J通过实际测量得到它到这四个邻居的延迟分别是 8ms, 10ms, 12ms, 6ms。
- 同时,J通过与邻居交换距离矢量(DV),获得了它们各自到目标节点 G 的延迟,分别为 18ms, 31ms, 6ms, 31ms。
- 接下来,J计算经过每个邻居到达G的总延迟:
- 通过 A 到达 G 的延迟为:8 + 18 = 26ms
- 通过 I 到达 G 的延迟为:10 + 31 = 41ms
- 通过 H 到达 G 的延迟为:12 + 6 = 18ms
- 通过 K 到达 G 的延迟为:6 + 31 = 37ms
- 比较这四个值,J发现通过H到达G的延迟最小,为18ms。
- 因此,J更新自己的路由表,将到达目标G的表项更新为:下一跳是H,代价为18ms。
这个过程会对J路由表中所有其他的目标节点重复进行,除了节点J本身。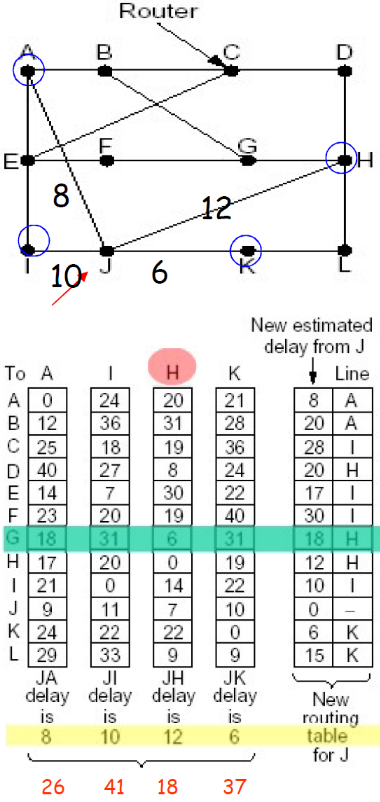
2.6.4 核心算法
2.6.4.1 Bellman-Ford 方程
距离矢量算法的数学基础是贝尔曼-福特(Bellman-Ford)方程,这是一种动态规划的应用。
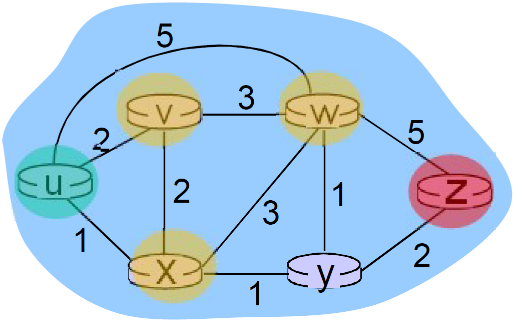
该方程定义如下: 设 是从节点x到节点y的最小路径代价。
那么,
其中,v 是x的所有邻居节点, 是从x到邻居v的链路代价, 是邻居v声称的、它自己到目标y的最小代价。这个公式的含义是,x到y的最小代价,等于“x到某个邻居v的代价”加上“v到y的最小代价”之和的最小值。
举例说明: 在一个网络中,节点u有三个邻居v、x、w,目标是z。 已知:
根据方程, 代入数值: 计算结果表明,u到z的最小代价是4,并且实现这个最小代价的下一跳节点是x。
2.6.4.2 核心思路总结
-
每个节点x维护一个对所有目标y的最小代价估计值 ,这构成了它的距离矢量 。
-
每个节点x知道它到所有邻居v的直接链路代价 。
-
每个节点x会接收并保存其所有邻居v的距离矢量 。
-
当一个节点x从邻居那里接收到更新的DV时,它会使用Bellman-Ford方程重新计算并更新自己的距离矢量 。
-
这个过程不断迭代,最终每个节点的估计值 会收敛于实际的最小代价值 。
-
each node:
- wait for (change in local link cost or msg from neighbor)
- recompute DV estimates using DV received from neighbor
- if DV to any destination has changed, notify neighbors
-
iterative, asynchronous: each local iteration caused by:
- local link cost change
- DV update message from neighbor
-
distributed, self-stopping: each node notifies neighbors only when its DV changes
- neighbors then notify their neighbors – only if necessary
- no notification received, no actions taken!
2.6.4.3 算法特点
距离矢量算法是异步的、分布式的和迭代的。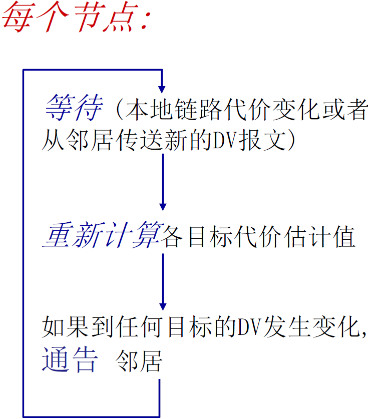
- 异步和迭代:每次本地的计算是由特定事件触发的,例如本地链路代价发生了变化,或者从邻居那里收到了更新的距离矢量(DV)消息。
- 分布式:每个节点只在它自身的距离矢量发生改变后,才会向其邻居通告。邻居收到通告后,再决定是否需要更新并通知它们的邻居。信息是一步步在网络中传播的。
2.6.4.4 算法收敛过程:例子
在一个由x, y, z三个节点组成的网络中,我们可以通过一个时空图来观察距离矢量算法的收敛过程。图中横坐标是时间,纵坐标是各个节点的路由表。初始时,每个节点只知道到自己和邻居的距离。随着时间的推移和距离矢量的交换,各个节点的路由表会经过数次迭代,最终稳定下来,达到一个所有节点都拥有正确路由信息的状态。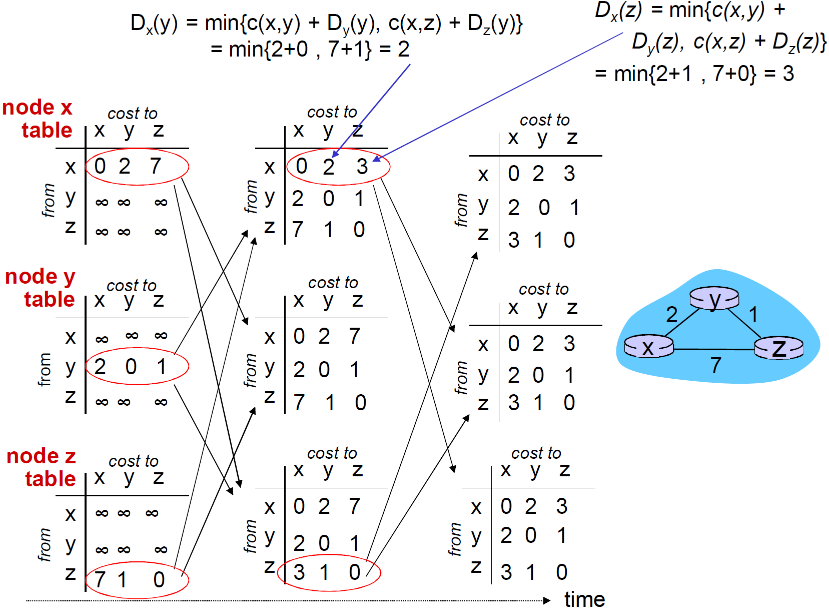
2.6.5 DV算法的扩散 State information diffusion (扩散) in DV algorithm
 /file-20251230114154483.png)
2.6.6 DV算法的问题:无穷计数
距离矢量算法有一个显著的特点:好消息传得快,坏消息传得慢。
2.6.6.1 好消息传得快
- 好消息:指网络中出现更优的路径,例如有新的路由器接入或某条路径变得更短。好消息的传播速度是每一个交换周期前进一个路由器。
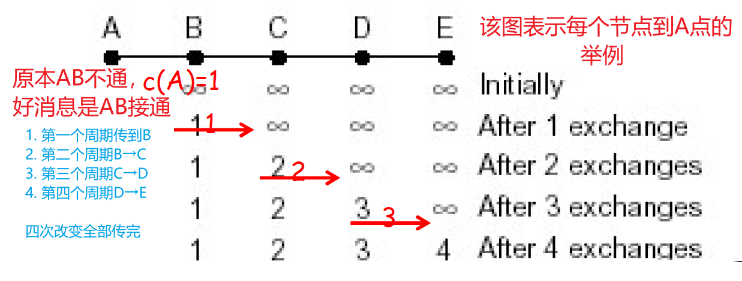
 /file-20251230114422411.png)
2.6.7 坏消息传的慢和无穷计数
- 坏消息与无穷计算问题:坏消息指网络中某条链路失效。坏消息的传播速度非常慢,这会导致“无穷计算问题”(Count-to-Infinity Problem)。
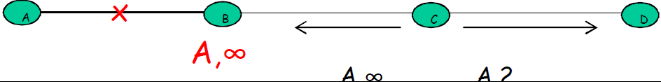
 /file-20251230114438703.png)
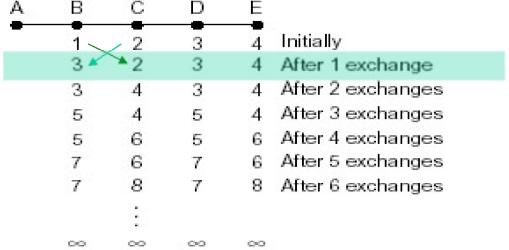
例子:在 A-B-C 的链式网络中,B通过A到达目标,代价为2;C通过B到达目标,代价为3。当A-B之间的链路断开时:
- B无法直接到达A,但此时它从C那里获得信息:“C可以到达A,代价为2”。B并不知道C的路径需要经过自己。
- 因此,B错误地更新自己的路由,认为可以通过C到达A,代价变为3(B到C为1,C到A为2)。
- 在下一次交换中,B告诉C它到A的路径代价是3。C收到后,便将自己到A的代价更新为4(C到B为1,B到A为3)。
- 这个错误的信息会在B和C之间来回传递,代价不断增加(3, 4, 5, 6…),形成一个路由环路,直到代价达到无穷大,这个问题才最终解决。
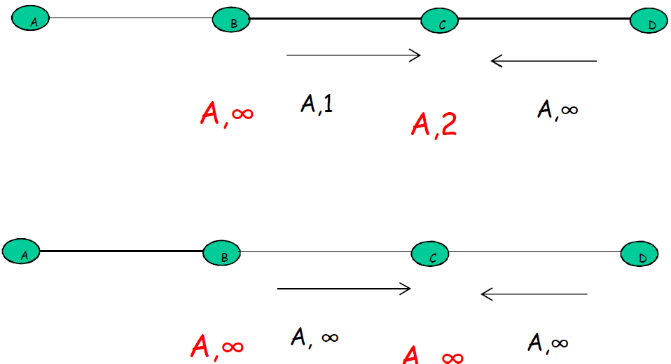
2.6.7.1 解决方案:水平分裂,课本是毒性翻转【poisoned reverse】
为了解决无穷计算问题,可以使用水平分裂(Split Horizon)算法。
原理:如果一个节点(如C)得知到达某个目标(A)的路径需要经过它的邻居(B),那么C在向B发送自己的距离矢量时,就不会包含关于A的路由信息(或者说,它会告诉B,它到达A的代价是无穷大)。
- 当然对于其他的邻居还是正常告诉
- 注意只是直接下一跳的时候才会通告为,否则还是正常通告
作用:这种方法可以有效避免上述的B-C之间的路由环路,让坏消息(链路断开)能够更快地传播。
2.6.7.2 水平分裂方法的局限性
- 局限性:然而,在某些更复杂的拓扑结构下(例如存在环路),水平分裂算法仍然可能会失效,无法完全解决无穷计算问题。
例子
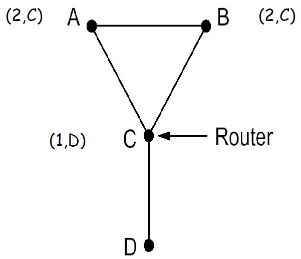
- A,B到D的距离为2, C到D的距离为1
- 如果C-D路径失败
- C获知到D为INF,从A,B获知到D的距离为INF,因此C认为D不可达
- A从C获知D的距离为INF,但从B处获知它到D的距离为2,因此A到B的距离为3,从B走
- B也有类似的问题
- 经过无限次之后,A和B都知道到D的距离为INF
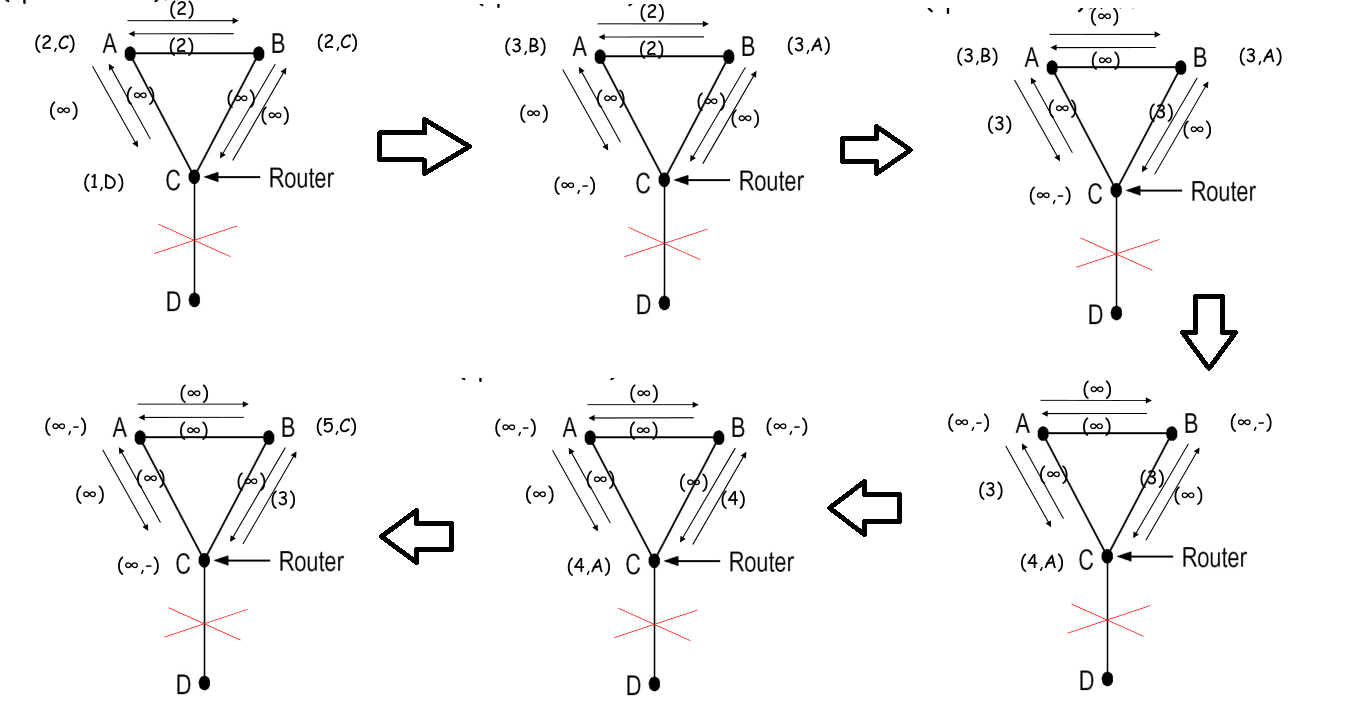
根据您提供的材料和拓扑图,毒性逆转(Poisoned Reverse)虽然解决了两个节点之间的直接路由环路(A-B-A),但在涉及三个或更多节点的环状拓扑(如 A-B-C 组成的三角形)中,它仍然存在局限性,无法完全避免“计数到无穷”(Count-to-Infinity)问题。
以下是对该局限性的详细推导和步骤解析:
1. 初始状态(正常工作时)
假设所有链路代价均为 1:
- C 路由器:直接连接 D,距离 。
- A 路由器:通过 C 到达 D,距离 。
- 毒性逆转行为:因为 A 经过 C 到达 D,所以 A 告诉 C:“我到 D 的距离是 ”。
- 对 B 的广播:因为 A 不经过 B 到达 D,所以 A 告诉 B:“我到 D 的距离是 2”。
- B 路由器:通过 C 到达 D,距离 。
- 毒性逆转行为:因为 B 经过 C 到达 D,所以 B 告诉 C:“我到 D 的距离是 ”。
- 对 A 的广播:因为 B 不经过 A 到达 D,所以 B 告诉 A:“我到 D 的距离是 2”。
2. 链路失效瞬间:C-D 路径中断
当 C 到 D 的链路突然断开:
- C 的检测:C 发现到 D 的直接路径消失,代价变为 。
- C 更新路由:C 检查其邻居 A 和 B 传来的信息。
- 由于之前 A 和 B 都对 C 实施了“毒性逆转”,C 接收到的信息是:A 到 D 是 ,B 到 D 也是 。
- 因此,C 确认 D 不可达,并将此消息广播给 A 和 B。
3. 产生局限性的核心:错误路径的连锁反应
这是计数到无穷开始的关键步骤,请注意 A 和 B 之间的信息误导:
- A 收到 C 的更新:
- A 发现原先经过 C 的路径(代价 2)失效了。
- A 寻找替代路径。它记起 B 曾经广播过:“我(B)到 D 的距离是 2”。
- 关键点:B 在广播给 A 时没有毒性逆转,因为 B 之前是走 C 的,不是走 A 的。
- A 的错误决策:A 认为可以改走 B。于是 A 更新:。
- 此时,A 告诉 B:“我到 D 的距离是 ”(因为现在 B 是 A 的下一跳),但 A 会告诉 C:“我到 D 的距离是 3”。
- B 收到 C 的更新:
- B 发现经过 C 的路径失效。
- B 同样寻找替代路径。如果此时 B 刚好收到了 A 最新的更新(距离 3),或者还存着 A 之前的旧更新(距离 2)。
- B 的错误决策:B 认为可以改走 A。
- 假设 B 采用了 A 更新后的距离 3,则 B 更新:。
- B 告诉 A:“我到 D 的距离是 ”,告诉 C:“我到 D 的距离是 4”。
- 迭代递增(计数到无穷):
- A 接着收到 B 的新代价(4),认为通过 B 到达 D 的距离变成了 。
- B 接着收到 A 的新代价(5),认为通过 A 到达 D 的距离变成了 。
- 如此反复,距离不断增加,直到达到协议规定的“无穷大”定义值(例如 RIP 协议中的 16)。
4. 总结:为什么毒性逆转在这里失效了?
毒性逆转的逻辑是:“如果你通过我走,我就告诉你这条路不通。”
- 失效原因:在三角形拓扑中,A 认为 D 的路径是通过 C 的,所以只对 C 进行了毒性逆转(欺骗)。但 A 对 B 诚实地汇报了距离 2。
- 后果:当 C 这条真正的出路断开时,A 和 B 手里都握着对方提供的、基于旧情况的“诚实”数据。
- 本质:毒性逆转只能防止两个节点之间的直接相互欺骗(A-B 环路),但无法防止三个节点形成的环状依赖(A 以为找 B 能通,B 以为找 A 能通,而两者都不知道原本赖以生存的 C-D 链路已经断了)。
2.7 LS 算法与 DV 算法的比较
| 性能指标 | 链路状态 (LS) 算法 | 距离矢量 (DV) 算法 | 优胜者 |
|---|---|---|---|
| 消息复杂度 | 节点向全网泛洪链路信息,消息量为 O(nE)。 | 仅与邻居交换信息,但交换的是完整的距离矢量(路由表)。 | DV |
| 收敛时间 | 计算复杂度为 O(n²),收敛速度快,不易产生震荡。 | 收敛较慢,可能存在路由环路和无穷计算问题。 | LS |
| 健壮性 | 单个节点故障只会广播错误的链路信息,影响范围较小,每个节点独立计算路由。 | 单个节点故障可能通告全局性的错误路径,错误信息会扩散至全网。 | LS |
Neither algorithm is an oblivious winner, both algorithms are used in the Internet.
3 自治系统内部的路由选择
3.1 路由算法与路由协议概览
3.1.1 Making routing scalable (可扩展)
我们之前介绍了两种路由选择算法:距离矢量(DV)算法和链路状态(LS)算法。这些是理论上的算法。
our routing study thus far - idealized
- all routers identical
- network “flat” … not true in practice
scale: billions of destinations:
- can’t store all destinations in routing tables!
- routing table exchange would swamp links!
administrative autonomy:
- Internet: a network of networks
- each network admin may want to control routing in its own network
3.1.2 Internet approach to scalable routing
aggregate routers into regions known as “autonomous systems” (AS, 自治系统) (a.k.a. “domains” 域)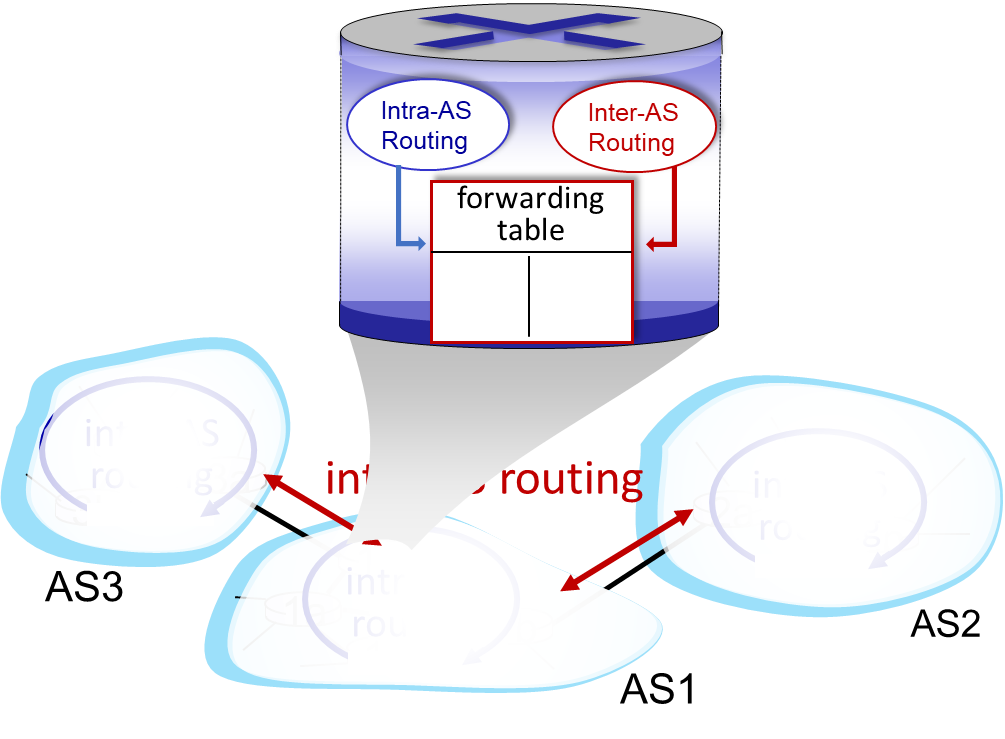
互联网的路由选择分为两个层面:
- 内部网关协议 (Intra-AS):在同一个自治系统(AS)内部使用的协议。
- 外部网关协议 (Inter-AS):在不同自治系统之间使用的协议。
forwarding table configured by intra-and inter-AS routing algorithms
- intra-AS routing determine entries for destinations within AS
- inter-AS & intra-AS determine entries for external destinations
3.1.3 Intra-AS
intra-AS (aka “intra-domain”): routing among within same AS (“network”)
- all routers in AS must run same intra-domain protocol
- routers in different AS can run different intra-domain routing protocols
- gateway router: at “edge” of its own AS, has link(s) to router(s) in other AS’es
3.1.4 Inter-AS routing: routing within an AS
inter-AS (aka “inter-domain”): routing among AS’es
- gateways perform inter-domain routing (as well as intra-domain routing)
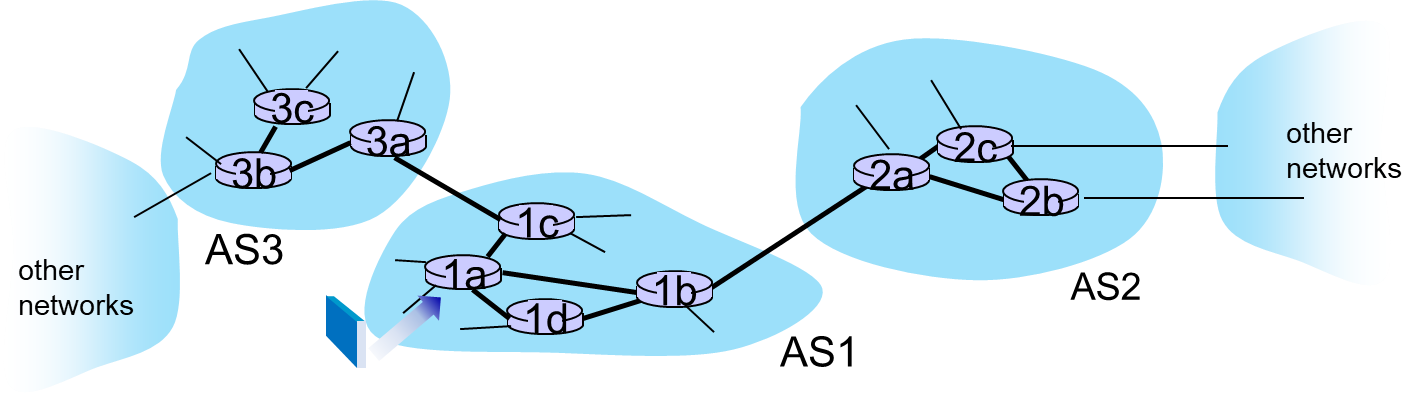
- suppose router in AS1 receives datagram destined outside of AS1:
- router should forward packet to gateway router in AS1, but which one?
- AS1 inter-domain routing must:
- learn which destinations reachable through AS2, which through AS3
- propagate this reachability info to all routers in AS1
most common intra-AS routing protocols:
- RIP: Routing Information Protocol [RFC 1723]
- classic DV: DVs exchanged every 30 secs
- no longer widely used
- EIGRP: Enhanced Interior Gateway Routing Protocol
- DV based
- formerly Cisco-proprietary for decades (became open in 2013 [RFC 7868])
- OSPF: Open Shortest Path First [RFC 2328]
- link-state routing
- IS-IS protocol (ISO standard, not RFC standard) essentially same as OSPF
我们首先介绍内部网关协议,主要有两种:RIP 和 OSPF。一个基于距离矢量算法,一个基于链路状态算法。
3.2 1. RIP (Routing Information Protocol)
RIP(路由信息协议)是内部网关协议中较早的一个。
3.2.1 RIP 的基本特性
它在1982年于 BSD-UNIX 操作系统中实现,是一种基于距离矢量(DV)算法的协议。
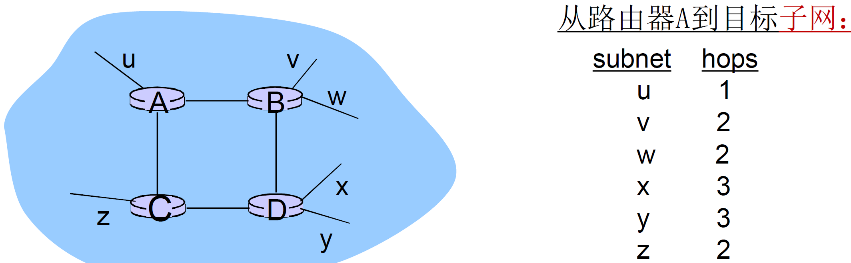
- 代价(Metric):RIP 使用“跳数”(Hop Count)作为代价。每经过一个路由器,跳数加1。
- 最大跳数:它允许的最大跳数为 15。
- 不可达:如果一个目标的跳数达到 16,则被认为是一个不可达的目标。
3.2.2 RIP 的通告 (Advertisements)
RIP 路由器之间会周期性地交换它们的距离矢量信息,这称为“通告”。
- 交换周期:每隔 30 秒,路由器会向其所有邻居发送自己的距离矢量通告。
- 通告内容:每个通告(报文)中,最多可以包含 25 个目标子网的路由信息。
每个条目会包含:
- 目标网络(子网):要去往的目的地。【理论只用传代价,但是实践好像都要传】
- 跳数(代价):到达该目的地需要多少跳。
这个25条的限制说明 RIP 只适用于小型网络。互联网上的路由表有几十万甚至上百万个条目,RIP 无法处理如此大的规模。
3.2.3 RIP 示例:路由表更新
我们来看一个 RIP 工作的例子。假设有路由器 A, B, C, D,以及一些子网 w, x, y, z。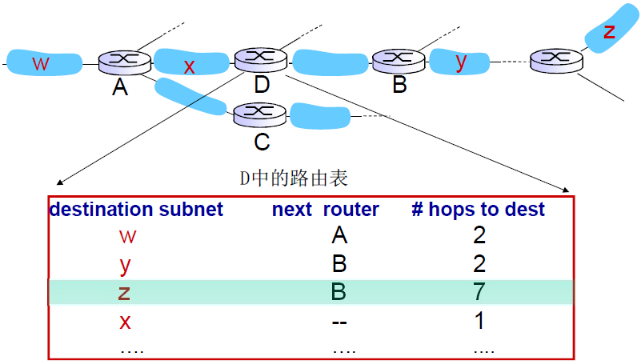
初始状态(D 的路由表):
- 到
w:下一跳 A,跳数 2 - 到
y:下一跳 B,跳数 2 - 到
x:直连,跳数 1 - 到
z:下一跳 B,跳数 7
路由更新: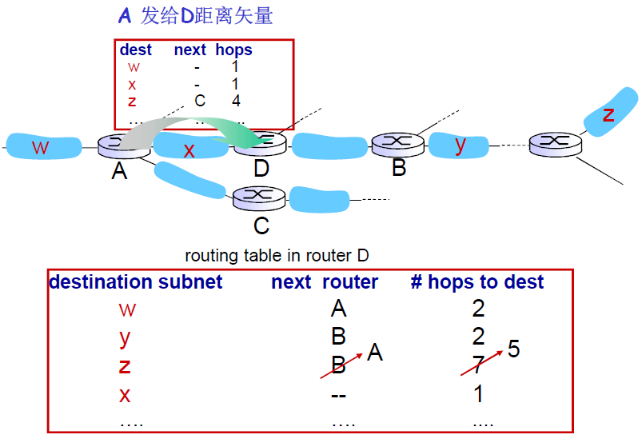
- 路由器 A 向 D 发送了它的距离矢量通告。
- 在这个通告中,A 声明它到达子网
z的跳数是 4。 - D 收到此通告后,会重新计算路径:
- D 知道它到 A 的跳数是 1。
- 通过 A 到达
z的总跳数将是1 (D到A) + 4 (A到z) = 5。
- D 比较新路径和旧路径:
- 新路径(经 A)到
z的跳数是 5。 - 旧路径(经 B)到
z的跳数是 7。
- 新路径(经 A)到
- 由于 5 < 7,D 决定更新它的路由表。
- 更新后(D 的路由表):
- 到
z:下一跳 A,跳数 5
- 到
3.2.4 RIP:链路失效与恢复
RIP 通过超时机制来检测链路或邻居失效。
- 失效检测:如果一个路由器在 180 秒内(即 6 个 30 秒周期)都没有收到某个邻居的通告,它就认为该邻居或连接该邻居的链路已经失效了。
- 路由更新:该路由器会将其路由表中所有经由该失效邻居的路径置为无效(例如,跳数设为 16)。
- 信息传播:然后,它会立即向其他邻居发送新的路由通告,告知这一变化。这个失效信息会像涟漪一样在网络中传播开。
为了防止在路由信息变化时产生“乒乓回路”(ping-pong loops)问题,RIP 使用了如毒性逆转(Poison Reverse) 和 水平分裂(Split Horizon) 等技术。
3.2.5 RIP 的实现方式
一个有趣的点是 RIP 的实现方式。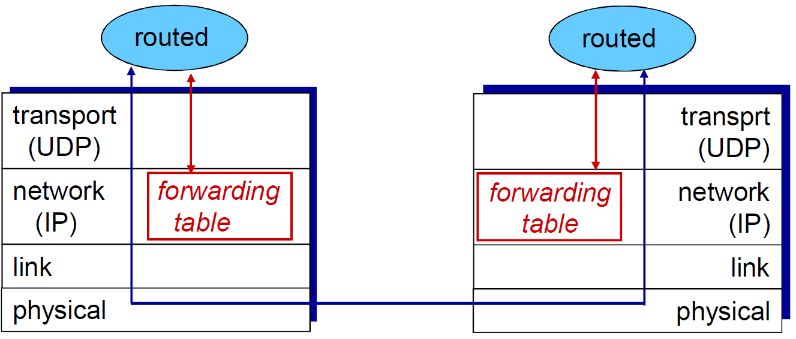
- 它在操作系统中是作为一个应用层进程(守护进程,Daemon)来实现的,通常被称为
routed。 - 它使用 UDP 报文来发送和接收路由通告。
这意味着,RIP 作为一个网络层功能的协议,其实现却是在应用层,并且依赖传输层的 UDP 服务来完成它的工作。
- RIP是网络层的 协议
- RIP协议使用了进程的方式实现
- 并且使用了传输层的UDP报文
3.3 OSPF (Open Shortest Path First)
OSPF(开放最短路径优先)是目前更常用、更强大的一个内部网关协议。
3.3.1 OSPF 的基本特性
- “Open”(开放):它是一个公开的标准,任何人都可以根据标准来实现,这保证了不同厂商设备间的互操作性。
- 算法:OSPF 使用的是链路状态(LS)算法。
- 工作流程:
- 每个路由器向 AS 内的所有其他路由器“泛洪”(Flooding)它的链路状态(LS)分组。【直接使用IP而不是用TCP/UDP】
- 通过这种方式,每个路由器都能收集到所有信息,从而在本地构建出整个 AS 的完整网络拓扑图。
- 每个路由器独立地运行 Dijkstra 算法,计算出从自己出发到所有其他节点的最短路径树【汇集树】。
- 路由通告
- 报文封装:OSPF 的路由通告是直接封装在 IP 数据报中的,它不使用 UDP 或 TCP。
- 携带内容:我是谁,我传输的是第几个版本,TTL;我的邻居和到他们的代价
- IS-IS路由协议:几乎和OSPF一样
3.3.2 OSPF 的高级特性(相对 RIP 的优势)
OSPF 相比 RIP 提供了许多高级功能:
- “open”: publicly available
- classic link-state
- each router floods OSPF link-state advertisements (directly over IP rather than using TCP/UDP) to all other routers in entire AS
- multiple link costs metrics possible: bandwidth, delay
- each router has full topology, uses Dijkstra’s algorithm to compute forwarding table
- security: all OSPF messages authenticated (to prevent malicious intrusion)
- 安全:OSPF 报文可以被认证,以防止恶意路由器注入错误的路由信息。
- 多路径:允许保留多条代价相同的最短路径。这可以用于在多条路径上进行负载均衡。
- 多指标(TOS):OSPF 可以为同一条链路根据不同的服务类型(Type of Service, TOS) 设置不同的代价。
- 例如,一条卫星链路,对于“尽力而为”的服务(如发邮件)可以设为低代价,但对于“实时”服务(如视频会议)可以设为高代价(因为延迟大)。【我可以按照不同的指标来设置代价】
- 网络管理员可以根据不同的服务需求计算出不同的最优路径。
- 多播支持:OSPF 有一个内置扩展叫 MOSPF (Multicast OSPF),它使用相同的拓扑数据库来支持多播路由。
- Multicast OSPF(MOSPF)使用相同的拓扑数据库,就像在OSPF中一样【了解即可即可】
- 层次化:OSPF 支持在大型网络中进行层次化路由。
3.3.3 OSPF 层次化路由
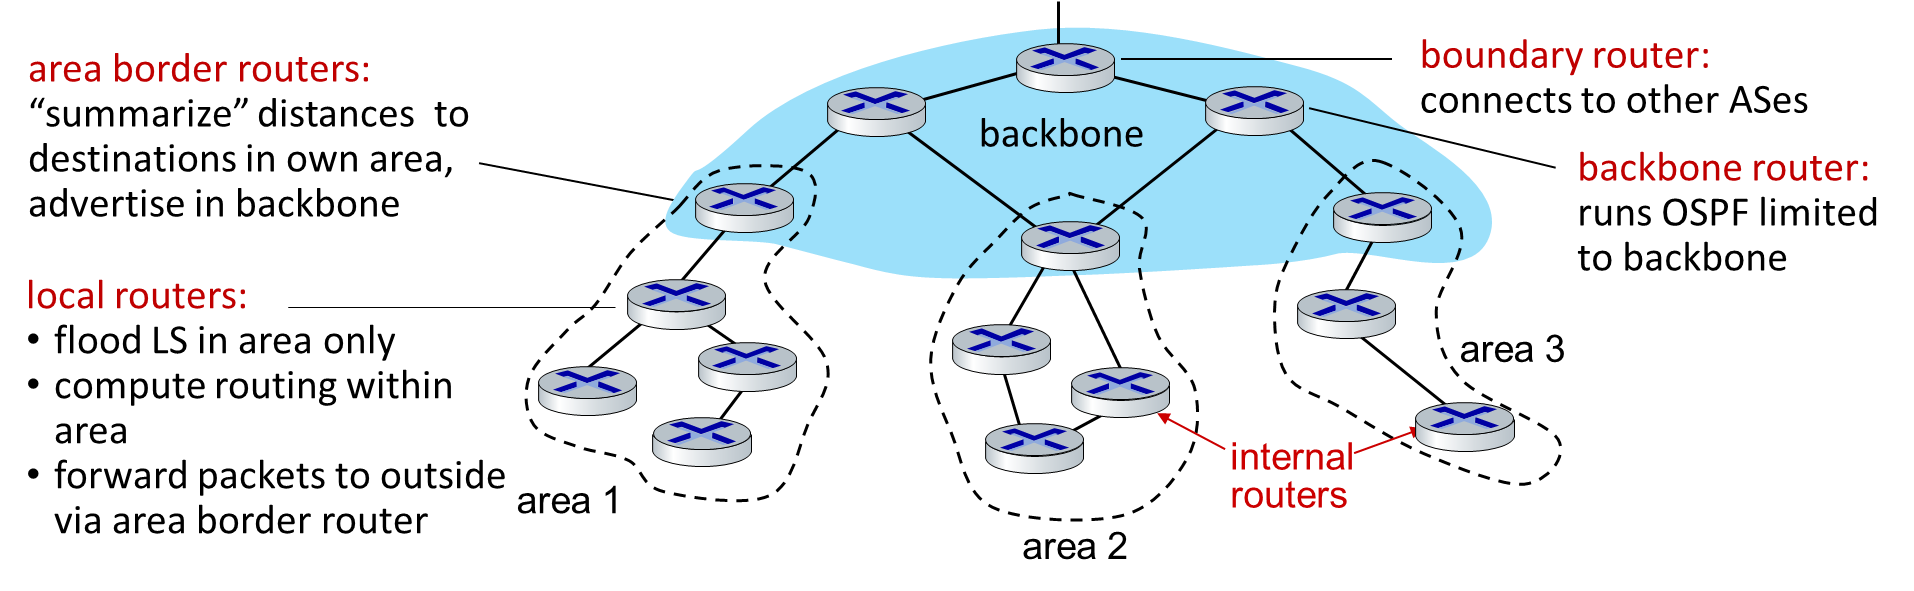
当一个自治系统(AS)规模非常大时,在整个 AS 内部泛洪链路状态信息的开销会变得无法承受。OSPF 通过将 AS 划分为多个**“区域”(Area)**来解决这个问题。
- 区域划分:AS 被划分为一个特殊的骨干区域(Backbone Area 0) 和若干个普通区域(Area 1, Area 2…)。
- 路由器角色:
- 区域内部路由器(Internal routers):完全位于一个普通区域内部。
- 区域边界路由器(Area Border Routers, ABRs):连接一个或多个普通区域到骨干区域。
- 骨干路由器(Backbone routers):位于骨干区域(Area 0)的路由器(包括 ABR)。
- AS 边界路由器(ASBRs):连接本 AS 到其他 AS 的路由器。
层次化的工作方式:
- 区域内(Intra-Area):
- 链路状态(LS)通告只在所属的区域内部泛洪。
- 每个路由器只知道自己所在区域的完整拓扑。
- 区域间(Inter-Area):
- 如果一个包的目的地在另一个区域,它首先被路由到本区域的一个 ABR。
- ABR 通过**骨干区域(Area 0)**将包路由到目标区域的 ABR。
- 目标区域的 ABR 再在区域内将包转发到最终目的地。
信息汇总:
- ABR 会将其所在区域的路由信息进行“汇总”,然后只将汇总后的摘要信息通告给骨干区域。
- 这样,骨干区域和其他区域的路由器就不需要知道其他区域内部的详细拓扑,大大减少了路由信息的数量和计算的复杂度。
这种两级的层次结构(本地区域和骨干区域)极大地提高了 OSPF 的可扩展性。
Hierarchical OSPF
- two-level hierarchy: local area, backbone.
- link-state advertisements flooded only in area, or backbone
- each node has detailed area topology; only knows direction to reach other destinations
4 5.3 互联网中的路由协议
4.1 路由层次
4.1.1 (1) 平面路由及其问题
一个平面的路由
在之前的讨论中(如LS和DV算法),我们假设网络中的所有路由器地位都相同,处于同一个“平面”上。这意味着:
- 所有路由器都知道网络中其他所有路由器或子网的存在及其可达性。
- 路由信息(如链路状态或距离矢量)需要在所有路由器之间交换。
- 所有路由器运行相同的路由算法来计算路径。
平面路由的问题
当网络规模变得非常大时(例如整个互联网),平面路由会遇到严重问题:
- 规模问题:
- 存储、传输和计算开销巨大:在包含数百万节点的网络中,每个路由器都需要存储海量的路由信息。距离矢量(DV)算法可能难以收敛,且在收敛过程中链路状态的变化会导致大量的重新计算和消息传递。链路状态(LS)算法需要泛洪(Flooding)巨大的LS分组,存储开销大,并且最短路径计算(如Dijkstra)的复杂度很高(例如,百万节点的平方是万亿级别),计算代价难以承受。
- 管理问题:
- 管理复杂性:互联网由许多不同的组织(网络所有者)管理,每个组织都希望按照自己的方式管理其网络,例如选择特定的路由策略或度量。
- 网络细节隐藏:组织通常希望隐藏自己网络的内部结构和细节,不希望外部网络了解其内部拓扑。
- 互联需求:尽管希望自治管理和隐藏细节,各个网络仍然需要相互连接并交换路由信息以实现全球互通。
4.1.2 (2) 层次路由的实现
为了解决平面路由的问题,互联网采用了层次路由(Hierarchical Routing)的架构。
自治系统 (AS)
互联网被划分成许多自治系统(Autonomous Systems, AS)。一个AS通常是由一个组织(如ISP、大学、大公司)管理的一组路由器和网络的集合。
- 每个AS有全球唯一的AS号(ASN)。
- 一个ISP可能包含一个或多个AS。
两级路由层次
路由过程被分为两个层次:
-
AS内部路由 (Intra-AS Routing):
- 在同一个AS内部,所有路由器运行相同的内部路由协议,也称为内部网关协议 (IGP)。
- 目标是确定AS内部各节点之间的最佳路径。
- 不同的AS可以运行不同的IGP。
- 常见的IGP有:RIP (Routing Information Protocol), OSPF (Open Shortest Path First), IGRP (Interior Gateway Routing Protocol - Cisco私有协议)。
- 网关路由器:位于AS边缘,负责连接到其他AS的路由器。它们既运行AS内部的IGP,也参与AS间的路由协议。
- 这个层次主要关注性能,力求在AS内部快速、高效地转发数据包。
-
AS间路由 (Inter-AS Routing):
- 在不同的AS之间,网关路由器运行外部网关协议 (EGP) 来交换路由信息。
- 目标是确定跨越多个AS到达目标网络的路径。
- 互联网目前事实上的标准EGP是BGP (Border Gateway Protocol)。
- 这个层次允许AS之间根据策略(例如经济、安全或政治因素)来选择路由,而不仅仅是基于最短路径或最低成本。
- 它解决了大规模网络下的规模和管理问题。
4.1.3 (3) 层次路由的优点
层次路由有效地解决了平面路由面临的问题:
- 解决了规模问题:
- AS内部规模可控:IGP只需处理AS内部有限数量的路由器和链路,计算和存储开销大大降低。如果一个AS变得太大,可以将其分割成更小的AS。
- AS间路由规模简化:在AS间路由的层面,每个AS可以被视为一个抽象的节点。增加一个新的AS,对于其他AS来说,只是增加了一个新的目标节点(或表项),说明如何到达这个新增的AS。这使得AS间的路由规模增长可控,扩展性强,网络规模增大时性能不会急剧下降。
- 解决了管理问题:
- 自治管理:每个AS可以独立选择和配置其内部的IGP,根据自己的需求进行管理。
- 网络细节隐藏:AS内部的拓扑结构和路由细节不需要向外部透露,增强了网络的安全性和管理的灵活性。
4.2 边界网关协议 BGP
BGP (Border Gateway Protocol) 是当前互联网中用于自治系统(AS)之间的事实上的标准路由协议【是约定俗成的协议】,它是一种外部网关协议 (EGP)。
4.2.1 (1) 基本思路
BGP为每个AS提供了以下核心功能:
- 获取可达信息 (eBGP):通过外部BGP (eBGP) 会话,从相邻的AS获取关于哪些子网(网络前缀)可以通过它们到达的信息。
- 分发可达信息 (iBGP):通过内部BGP (iBGP) 会话,将从eBGP邻居那里获得的可达信息传播给AS内部的所有路由器。
- 路径选择:根据获得的可达信息和本地配置的路由策略,为到达各个目标子网选择最佳路径,并将该路径信息放入转发表。
- BGP (Border Gateway Protocol): the de facto inter-domain routing protocol
- “glue that holds the Internet together”
- allows subnet to advertise its existence, and the destinations it can reach, to rest of Internet: “I am here, here is who I can reach, and how”
- BGP provides each AS a means to:
- eBGP: obtain subnet reachability information from neighboring ASes
- iBGP: propagate reachability information to all AS-internal routers.
- determine “good” routes to other networks based on reachability information and policy
路径矢量协议
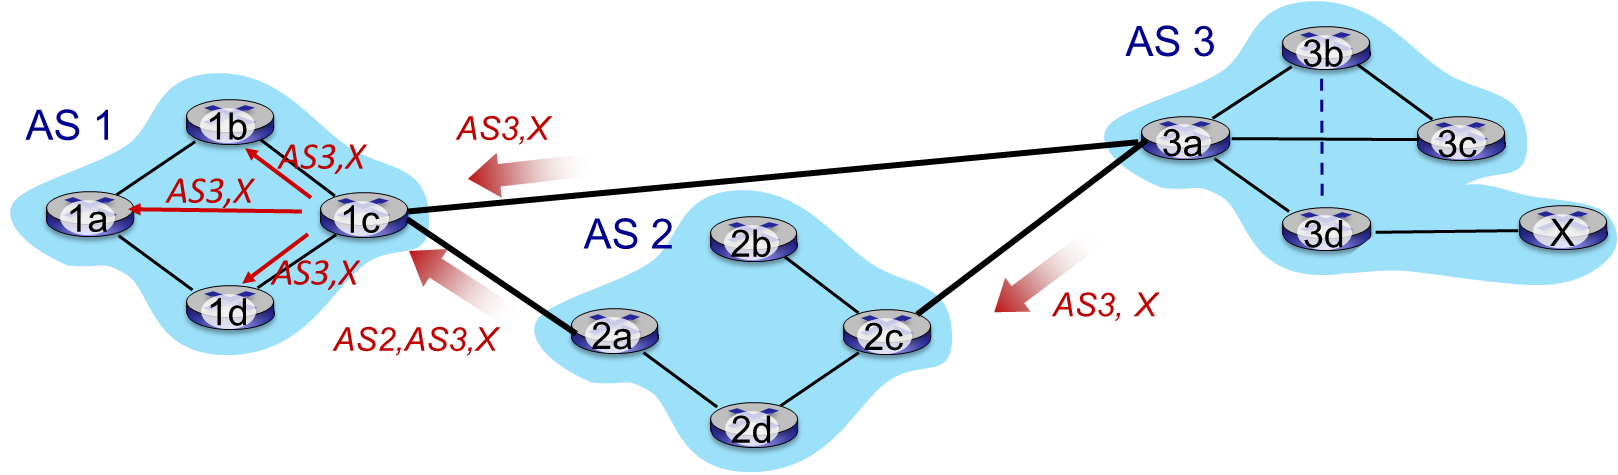
BGP本质上是一种路径矢量 (Path Vector) 协议,它是距离矢量 (DV) 算法的一种演进。
- BGP路由器通告的不仅仅是到达目标网络的距离(跳数),而是到达目标网络的完整路径,即所经过的AS序列(AS-PATH)。
- 例如,一个路由器通告它可以到达子网X,并且路径是
AS2, AS3, X,这意味着要到达X,需要先经过AS2,再经过AS3。 - 通过包含完整的AS路径信息,BGP可以有效地检测和避免路由环路。如果一个路由器收到的路径通告中包含了它自己的AS号,就知道这是一个环路,会丢弃该通告。这解决了传统DV算法中的无穷计数(count-to-infinity)问题。
4.2.2 eBGP 与 iBGP 连接
- eBGP连接:建立在位于不同AS中的路由器之间。通常,这些路由器是物理上直接相连的邻居。【如下一小节图中红虚线,这里是TCP链接。
1c和2a都是网关】 - iBGP连接:建立在位于同一个AS内部的路由器之间。这些路由器不需要物理直连。为了确保AS内部所有路由器都收到外部路由信息,通常AS内部的所有BGP路由器会建立一个全连接 (full mesh) 的iBGP会话,或者使用路由反射器 (Route Reflector) 来简化连接拓扑。【如下一小节图中灰色的虚线】
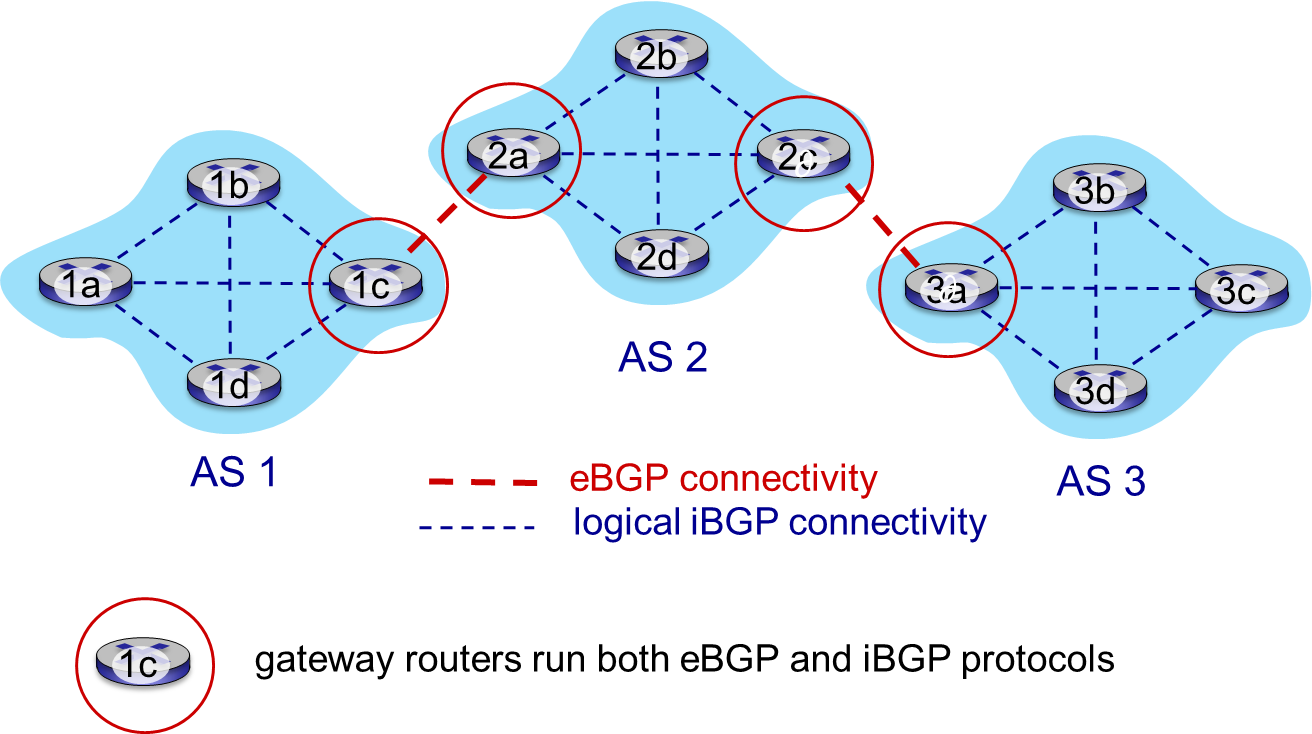
AS内部的路由器(包括网关路由器和内部路由器)通常同时运行IGP(如OSPF)和iBGP。IGP用于计算AS内部的最短路径,iBGP用于分发外部路由信息。
4.2.3 协议基本概念与路径通告示例
4.2.3.1 BGP会话 (Session)
- 两个BGP路由器(称为对等体 Peers)之间通过建立一个半永久的TCP连接来交换BGP路由信息(BGP报文)。TCP保证了路由信息的可靠传输。
- 通告向不同目标子网前缀的“路径”(BGP是一个“路径矢量”协议)
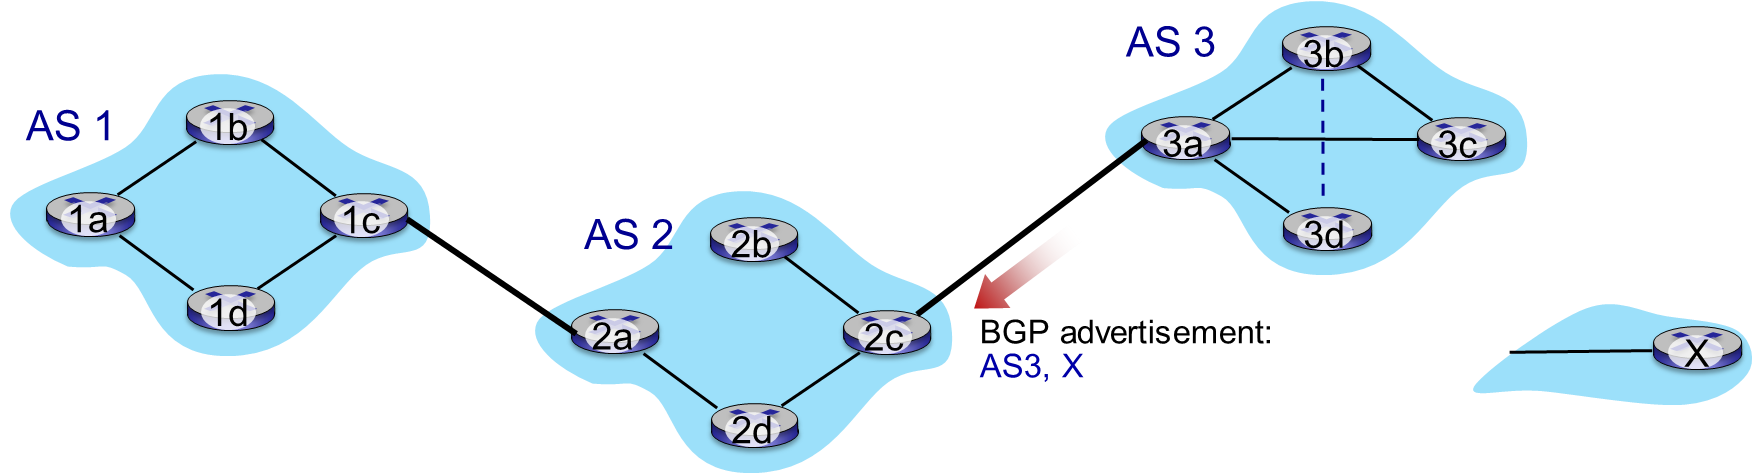
- BGP session: two BGP routers (“peers”) exchange BGP messages over semi-permanent TCP connection:
- advertising paths to different destination network prefixes (BGP is a “path vector” protocol)
- “Semi-permanent” means the connection will remain live for a long time.
- when AS3 gateway 3a advertises path to AS2 gateway 2c:
- AS3 promises to AS2 it will forward datagrams towards X
4.2.4 通告距离
4.2.4.1 路径通告 (Path Advertisement)举例1
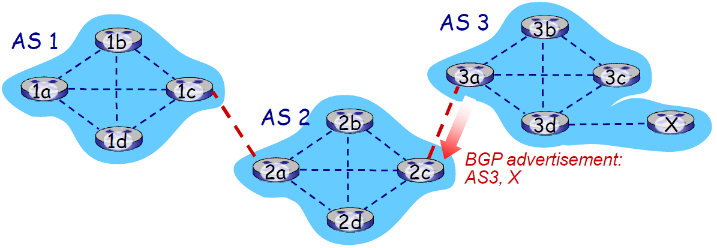
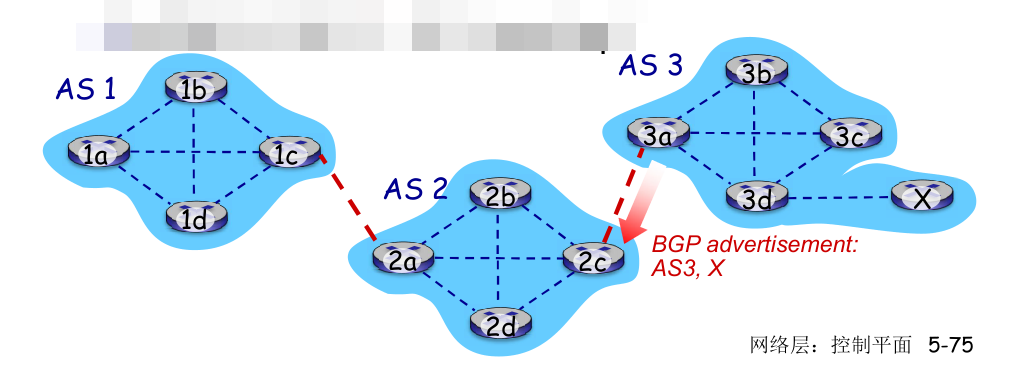
- 当AS3网关路由器3a向AS2的网关路由器2c通告路径:AS3,X
- 3a参与AS内路由运算,知道本AS所有子网X信息
- 语义上:AS3向AS2承诺,它可以向子网X转发数据报
- 3a是2c关于X的下一跳(next hop)
AI详细版本:
当一个AS(例如AS3)想要向外通告它所连接的子网(例如X)的可达性时,会发生以下过程:
- AS3内部:AS3的网关路由器(例如3a)通过其内部运行的IGP(如OSPF)学习到其内部可以到达子网X。
- eBGP通告 (AS3 → AS2):路由器3a通过eBGP会话向相邻AS(AS2)的网关路由器(例如2c)发送一个关于X的路径通告。这个通告包含了路径信息
AS3, X。- 语义:AS3向AS2承诺,它可以帮助将数据包转发到子网X。
- 下一跳 (Next Hop):对于路由器2c来说,到达X的下一跳是路由器3a的接口IP地址。
- iBGP传播 (AS2内部):路由器2c收到这个通告后,根据AS2的输入策略 (Import Policy) 决定是否接受这条路由。如果接受,它会通过iBGP会话将这个路径信息
AS3, X传播给AS2内部的所有其他BGP路由器(包括网关路由器2a)。 - eBGP通告 (AS2 → AS1):网关路由器2a收到来自2c的iBGP通告后,根据AS2的输出策略 (Export Policy) 决定是否将这条路由通告给相邻的AS(AS1)。如果决定通告,它会通过eBGP会话向AS1的网关路由器(例如1c)发送路径通告。在发送之前,2a会将自己的AS号 (AS2) 添加到路径的最前面。因此,1c收到的路径信息是
AS2, AS3, X。- 下一跳 (Next Hop):对于路由器1c来说,到达X的下一跳是路由器2a的接口IP地址。
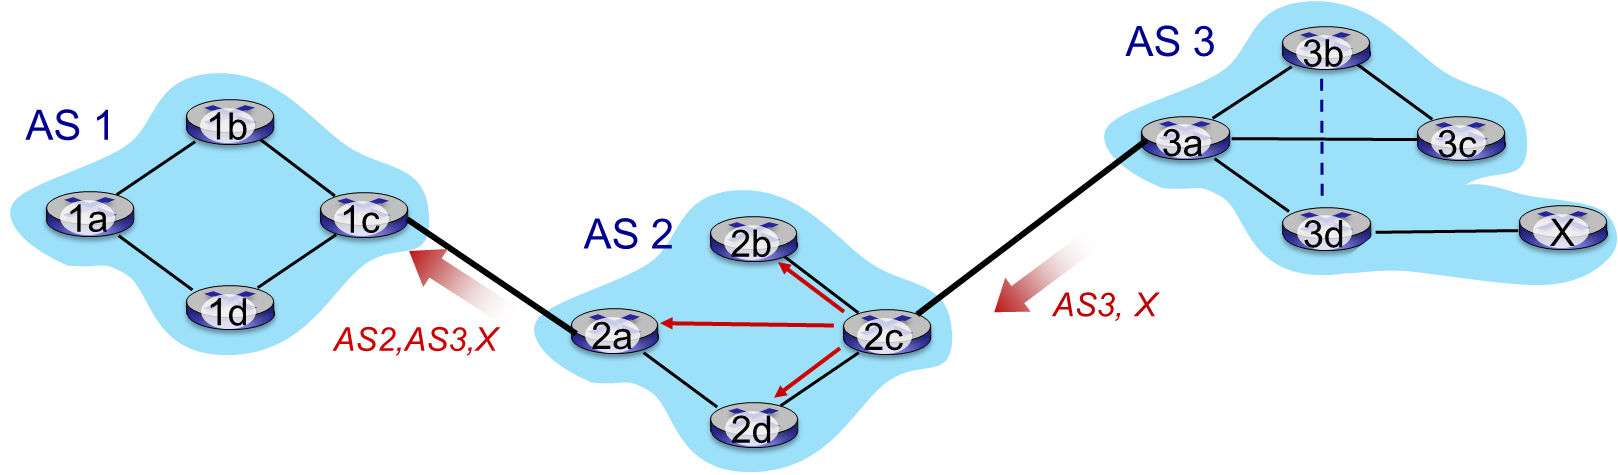
- AS2 router 2c receives path advertisement AS3,X (via eBGP) from AS3 router 3a
- based on AS2 policy, AS2 router 2c accepts path , propagates (via iBGP) to all AS2 routers
- based on AS2 policy, AS2 router 2a advertises (via eBGP) path AS2, AS3, X to AS1 router 1c
4.2.4.2 BGP path advertisement (more)
gateway router may learn about multiple paths to destination:
- AS1 gateway router 1c learns path AS2,AS3,X from 2a
- AS1 gateway router 1c learns path AS3,X from 3a
- based on policy, AS1 gateway router 1c chooses path AS3,X and advertises path within AS1 via iBGP
4.2.5 (4) BGP 属性与报文
4.2.5.1 Path attributes and BGP routes(English)
- BGP advertised route: prefix + attributes
- prefix: destination being advertised
- two important attributes:
- AS-PATH: list of ASes through which prefix advertisement has passed【这个也是用来避免回环的重要参数,当 BGP 路由器将路由发布到其他 AS 时,会将自己的 AS 号添加到路由条目的
AS_PATH列表开头。】 - NEXT-HOP: IP address of the internal-AS gateway router to next-hop AS
- AS-PATH: list of ASes through which prefix advertisement has passed【这个也是用来避免回环的重要参数,当 BGP 路由器将路由发布到其他 AS 时,会将自己的 AS 号添加到路由条目的
- policy-based routing:
- gateway receiving route advertisement uses import policy to accept/decline path (e.g., never route through AS Y). //“what I take”
- AS policy also determines whether to advertise path to other neighboring Ases// “what I give”
4.2.5.2 路径属性 (Path Attributes)
- 当通告一个子网前缀时,通告包括 BGP 属性
prefix + attributes= “route”
BGP在通告一个网络前缀(子网)时,会附带一系列属性,这些属性用于路径选择和策略执行。重要的属性包括:
- AS-PATH:按顺序列出了通告所经过的AS号。AS 67 AS 17
- 用途:检测路由环路;作为路径选择的一个重要依据(通常选择AS跳数最少的路径)。
- 规则:当一个路径通告通过eBGP从一个AS传到另一个AS时,发送方AS会将其自身的ASN预置 (prepend) 到AS-PATH列表的最前面。
- NEXT-HOP:指示到达目标前缀需要经过的下一个AS的入口路由器的IP地址。

- 规则:通常是发送eBGP通告的邻居路由器的接口IP地址。当路径在AS内部通过iBGP传播时,NEXT-HOP属性通常保持不变。
- 如上图,对于AS1来说的
NEXT-HOP
- 其他属性:例如本地偏好值 (Local Preference),用于在AS内部表达对不同出口路径的偏好;MED (Multi-Exit Discriminator) 等,用于更精细的策略控制。
4.2.5.3 BGP报文
BGP使用TCP来交换四种主要类型的报文:
- OPEN:用于建立BGP邻居关系(会话),协商参数和进行身份验证。
- UPDATE:用于通告新的可达路径信息,或撤销先前通告的不可达路径。这是BGP最主要的报文类型,包含了路径属性。
- KEEPALIVE:在没有UPDATE消息时周期性发送,用于确认TCP连接仍然活跃。如果长时间未收到KEEPALIVE或UPDATE,则认为连接中断。也用于对OPEN请求的确认。
- NOTIFICATION:用于报告BGP相关的错误(如报文格式错误、认证失败等),并通常会导致BGP会话被关闭。
- BGP messages exchanged between peers over TCP connection【就是说BGP是在TCP上的,而且会是半永久链接的,因为会保持很长时间】
- BGP messages:
- OPEN: opens TCP connection to remote BGP peer and authenticates sending BGP peer
- UPDATE: advertises new path (or withdraws old)
- KEEPALIVE: keeps connection alive in absence of UPDATES; also ACKs OPEN request
- NOTIFICATION: reports errors in previous msg; also used to close connection
4.2.6 (5) 转发表表项的确定
路由器(无论是网关路由器还是内部路由器)最终需要根据收集到的BGP路由信息和内部IGP信息来填充自己的转发表 (Forwarding Table)。这个过程结合了AS间路由(BGP)和AS内部路由(IGP):
- BGP路径选择:路由器可能会收到多条到达同一个目标前缀X的BGP路径。它需要根据一系列规则(后面会讲)选择最佳的BGP路径。这条最佳路径包含了AS-PATH和NEXT-HOP等属性。
- 确定下一跳网关:选出的最佳BGP路径会指明一个NEXT-HOP IP地址。这个地址通常是相邻AS的入口路由器(对于eBGP学到的路由)或者是本AS内的一个出口网关路由器(对于iBGP学到的路由)。
- IGP查找内部路径:路由器使用其内部运行的IGP(如OSPF)来查找到达步骤2中确定的NEXT-HOP IP地址的最短路径。
- 设置转发表项:最终,在转发表中为目标前缀X创建的表项,其出接口 (Outgoing Interface) 将是步骤3中找到的内部最短路径的第一跳接口。
4.2.6.1 ** 转发表表项选择示例**:
【这里的选择只是示例性的】
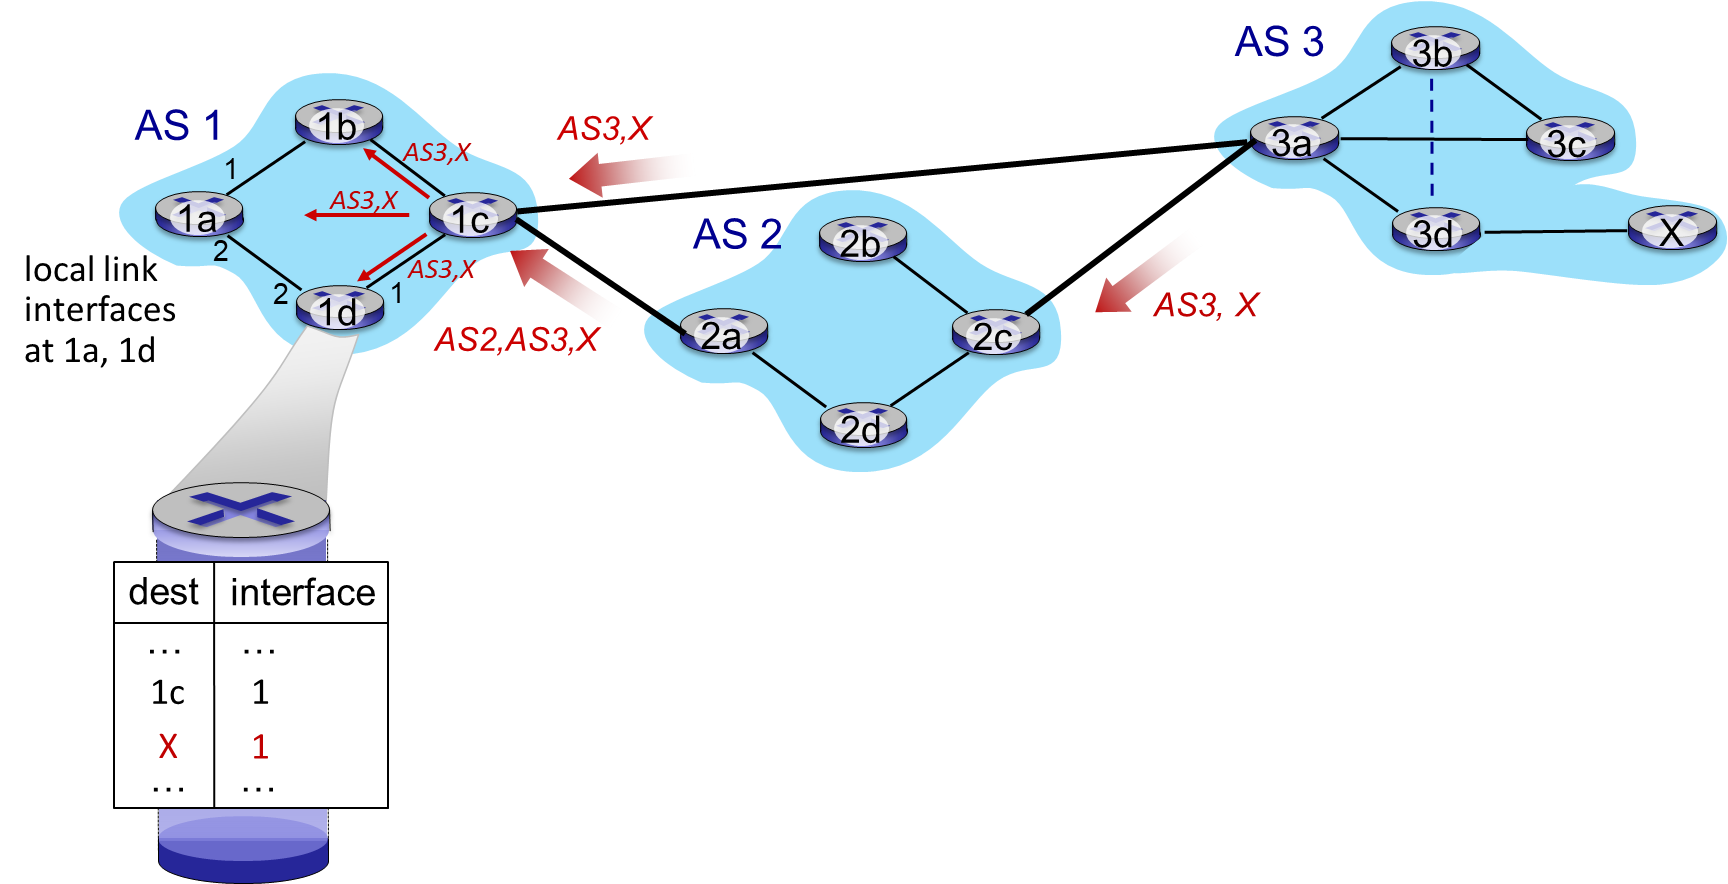
-
recall: 1a, 1b, 1d learn via iBGP from 1c: “path to X goes through 1c”
-
at 1d: OSPF intra-domain routing: to get to 1c, use interface 1
-
at 1d: to get to X, use interface 1
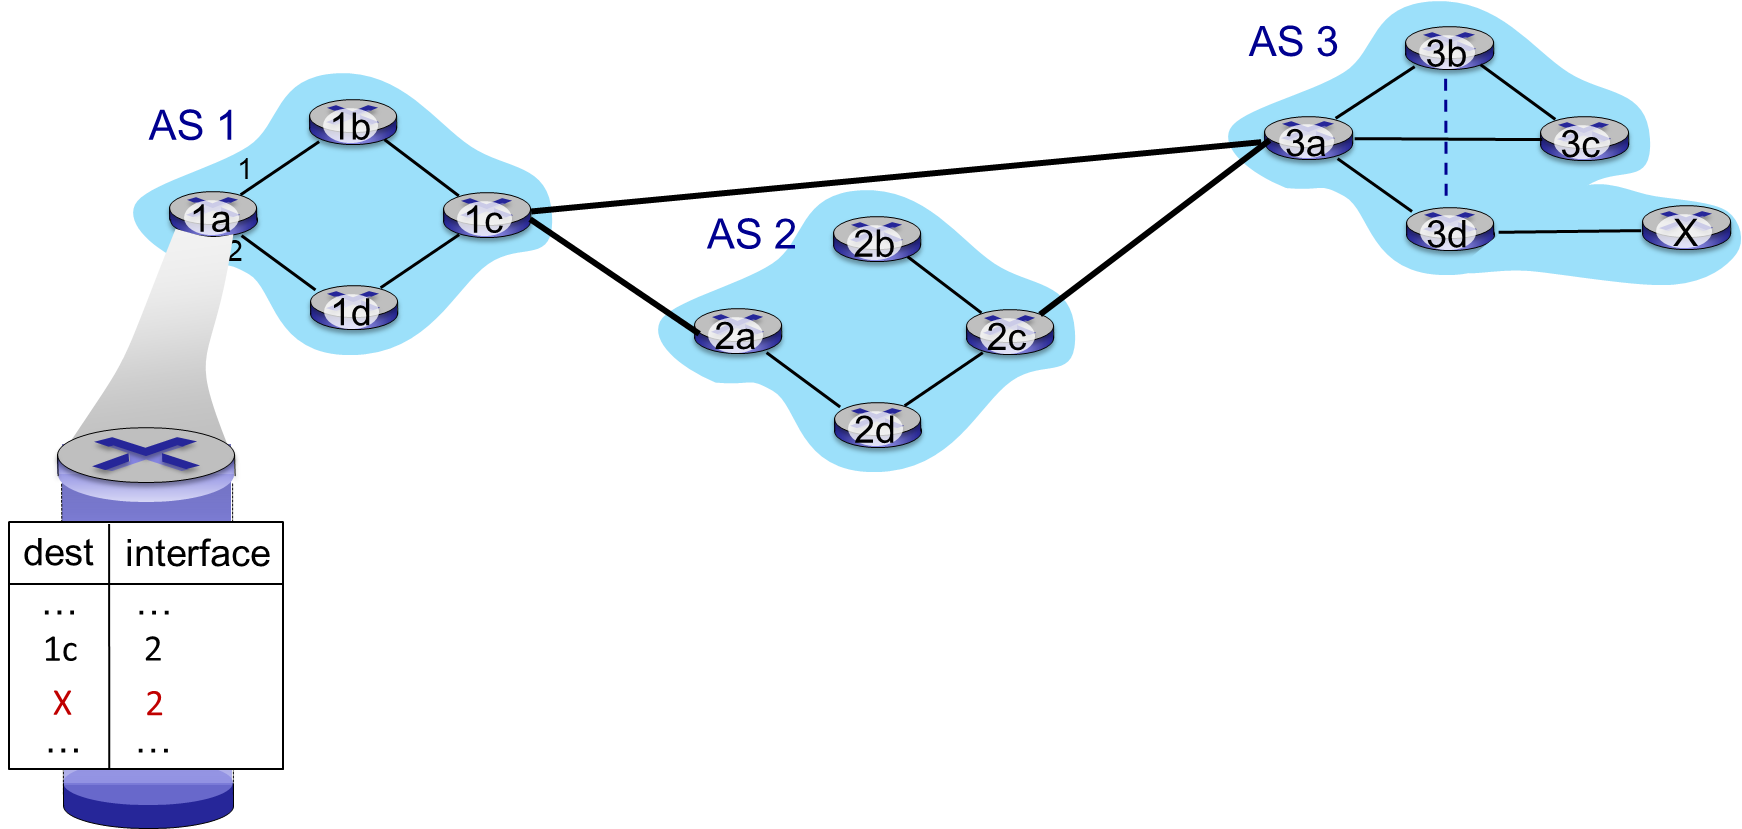
- at 1a: OSPF intra-domain routing: to get to 1c, use interface 2
- at 1a: to get to X, use interface 2
4.2.7 BGP 路径选择
4.2.7.1 网关路由器路径选择
- 基于策略的路由:
- 当一个网关路由器接收到了一个路由通告, 使用输入策略来接受或过滤(
accept/decline.)- 过滤原因例1:不想经过某个AS,转发某些前缀的分组
- 过滤原因例2:已经有了一条往某前缀的偏好路径
- 策略也决定了是否向它别的邻居通告收到的这个路由信息
- 当一个网关路由器接收到了一个路由通告, 使用输入策略来接受或过滤(
当一个路由器(特别是网关路由器)收到多条到达同一个目标前缀X的路径通告时,它必须选择其中一条作为最佳路径。BGP路径选择过程遵循一个定义好的决策流程,按顺序应用一系列规则,直到只剩下一条路径: 【不一定选择代价最小的,会综合考量】
- AS1 网关路由器1c从2a学习到路径:AS2,AS3,X
- AS1网关路由器1c从3a处学习到路径AS3,X(此时收到了两条到达X的路径)
- 基于策略,AS1路由器1c 选择了路径:AS3,X ,而且通过iBGP告诉所有AS1内部的路由器
4.2.7.2 子网内路由器路径选择
- 本地偏好值 (Local Preference):选择具有最高本地偏好值的路径。这是一个可以在AS内部设置的属性,用于指示哪个出口路径更受偏好(通常数值越大越优先)。这个规则优先于其他所有规则,主要用于实现AS的路由策略。
- 最短AS-PATH:选择AS-PATH属性中包含最少AS数量的路径。这类似于DV算法中的跳数最少原则,但作用于AS级别。
- 最近的NEXT-HOP路由器 (Hot Potato Routing):如果有多条路径具有相同的最短AS-PATH长度,路由器会选择NEXT-HOP IP地址在AS内部距离最近(根据IGP计算的成本最低)的那条路径。【下面的热土豆路由】
- 附加判据:如果以上规则仍然无法区分,还有其他更细致的规则,例如比较BGP路由器的ID等,作为最终的决胜局规则。
4.2.8 通过通告路径执行策略
BGP的一个核心特点是允许AS执行复杂的路由策略,这些策略通常基于商业关系(客户、提供商、对等体)。策略主要通过选择性地通告或不通告路由来实现。
4.2.8.1 示例:Transit Traffic Policy
假设ISP B是ISP A和ISP C的提供商,而A和C之间是对等 (Peering) 关系或者没有直接关系。W是A的客户,X是B的客户。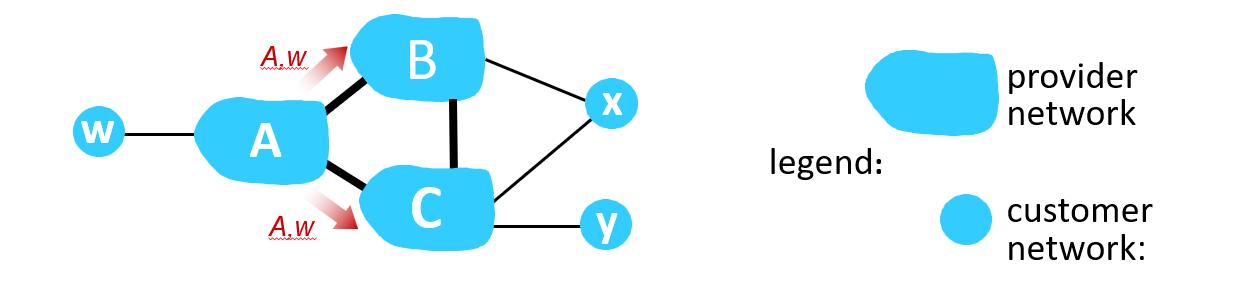
- A向B通告路径
Aw。B向A通告路径Bx。 - B通常不会将从A学到的路径
Aw再通告给C。为什么?因为如果B通告了,C就可能选择路径CBAw来访问W,这意味着B需要为A和C之间传输过境流量 (Transit Traffic)。通常ISP只愿意为其客户(如X)或者从其客户那里来的流量提供传输服务,而不愿意免费为其他ISP(特别是竞争对手或对等体)传输过境流量。 - 通过不通告
Aw给C,B阻止了CBAw路径的形成,从而避免了成为A和C之间的过境网络。这导致C可能无法知道CBAw这条路径的存在,它可能会选择其他路径(如CAw)到达W。这体现了每个AS看到的网络拓扑可能是不完整的,并且是受策略影响的。
ISP only wants to route traffic to/from its customer networks (does not want to carry transit traffic between other ISPs – a typical “real world” policy)
- A advertises path Aw to B and to C
- B chooses not to advertise BAw to C!
- B gets no “revenue” for routing CBAw, since none of C, A, w are B’s customers
- C does not learn about CBAw path
- C will route CAw (not using B) to get to w
4.2.8.2 示例:Multi-homed Customer Policy
客户网络X同时连接到ISP B和ISP C(称为多宿 (Multi-homed))。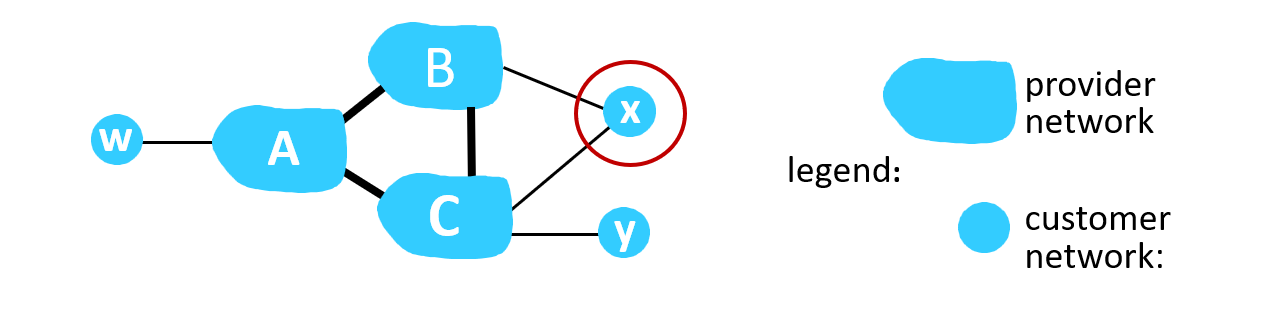
- X可以向B和C都通告自己的网络前缀(例如Xw)。
- 但是,X通常不希望成为B和C之间的过境网络。也就是说,X不希望B通过路径
BXw把流量发给X,然后X再通过路径Xw把流量发给C。 - 为了实现这一点,X在向B通告路径
Xw时,不会把从C学到的其他路由信息包含进去;同样,向C通告时,也不会包含从B学到的信息。
ISP only wants to route traffic to/from its customer networks (does not want to carry transit traffic between other ISPs – a typical “real world” policy)
- A,B,C are provider networks
- x,w,y are customer (of provider networks)
- x is dual-homed: attached to two networks
- policy to enforce: x does not want to route from B to C via x
- .. so x will not advertise to B a route to C
4.2.8.3 Hot potato routing
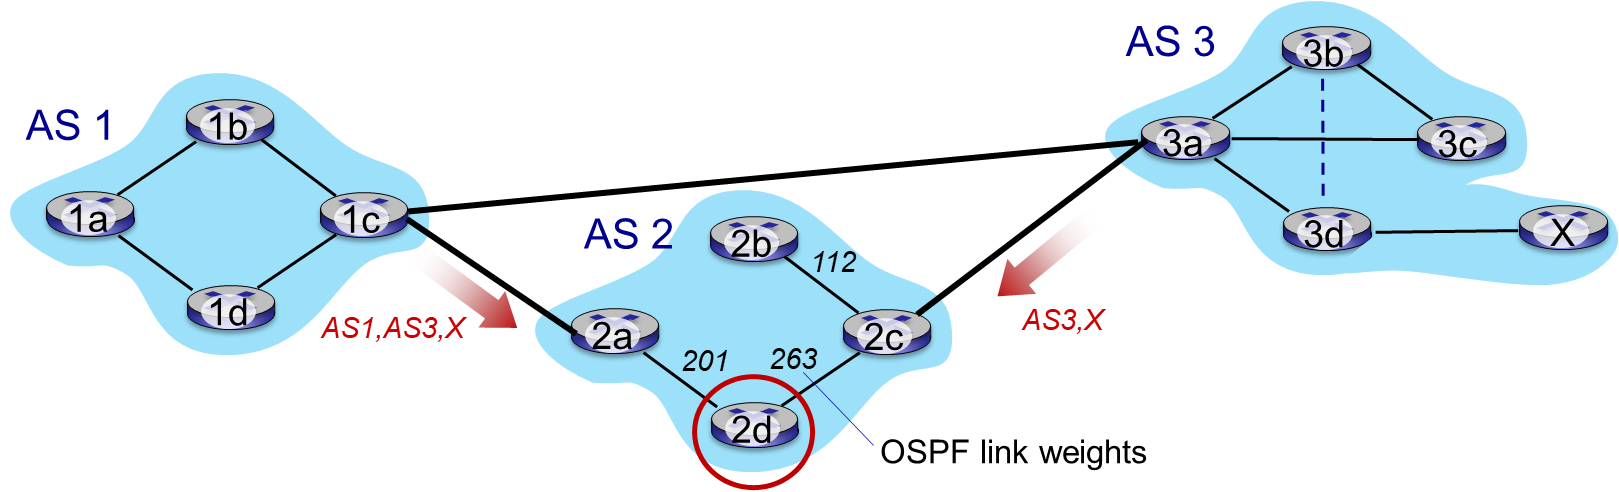
- 2d learns (via iBGP) it can route to via 2a or 2c
- hot potato routing: choose local gateway that has least intra-domain cost (e.g., 2d chooses 2a, even though more AS hops to ): don’t worry about inter-domain cost!
- 热土豆路由 (Hot Potato Routing):这个策略的核心思想是尽快将数据包“扔出”自己的AS,减少自己在内部传输数据包的负担,即使选择的外部路径(AS跳数)可能不是全局最优的。
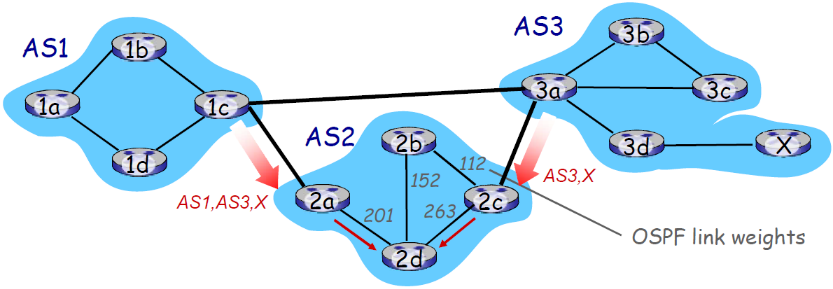
- 示例:路由器2d通过iBGP从2a和2c都收到了到达X的路径,假设它们的AS-PATH长度和本地偏好都一样。2d会计算自己通过内部IGP到达2a的成本和到达2c的成本。如果到达2a的成本更低,即使通过2c的AS路径更短,2d也会选择通过2a转发数据包。
- (就是2c和2a都是网关路由器,2d到达2a的代价最小,因此给2a传递,尽管2c的整体跳数要小)
4.2.9 IP任播
- 就是说可以在不同的AS里面放不同的CDN服务器让用户可以快速指向最近的CDN服务器
- 甚至可以用来给13个根服务器弄
4.3 网关协议:内部 vs 外部
总结一下内部网关协议 (IGP) 和外部网关协议 (EGP/BGP) 的主要区别:
| 特点 | 内部网关协议 (IGP: RIP, OSPF, IGRP) | 外部网关协议 (EGP: BGP),还有思科自有的协议 |
|---|---|---|
| 关注点 | 性能:在AS内部快速、高效地收敛和路由。 | 策略:AS之间根据商业关系、成本、安全等策略选择和通告路由,性能是次要考虑。 |
| 规模 | 处理AS内部的规模,通常规模有限。如果AS过大,可以通过层次化(如OSPF区域)或分割AS来解决。 | 处理整个互联网的规模,需要高度的可扩展性。通过AS路径等机制简化了规模问题。 |
| 策略 | Intra-AS:通常假设AS内部是一个单一的管理域,不需要复杂的策略。 | **Inter-AS:**策略是核心功能,用于控制路由信息的传播和路径的选择。【会有政治和经济策略】 |
| 运行范围 | 在单个AS内部运行。 | 在不同AS之间运行(eBGP)以及在AS内部传播外部路由信息(iBGP)。 |
规模:
- AS间路由必须考虑规模问题,以便支持全网的数据转发
- AS内部路由规模不是一个大的问题
- 如果AS 太大,可将此AS分成小的AS;规模可控
- AS之间只不过多了一个点而已
- 或者AS内部路由支持层次性,层次性路由节约了表空间, 降低了更新的数据流量
5 SDN 控制平面
5.1 SDN 简介
我们之前讨论过,互联网的网络层可以有两种工作模式。一种是传统方式,另一种是未来非常有希望的,即 SDN(Software-defined networking,软件定义网络)的模式。
我们先来回顾一下传统方式。
5.1.1 传统方式:每路由器 (Per-router) 控制平面
在传统方式中,控制平面和数据平面是垂直集成的。如下图所示,路由算法(控制平面)和转发表(数据平面)都实现在同一个路由器内部。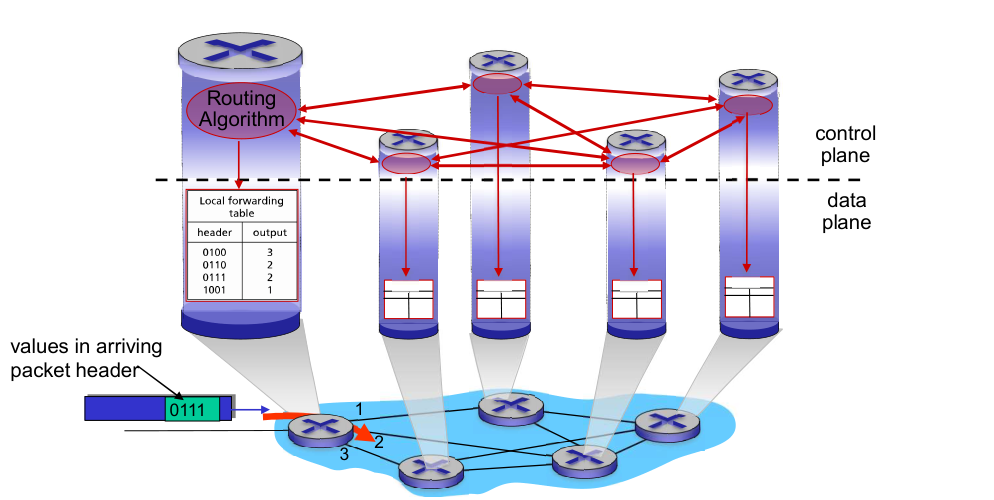
每个路由器中都包含路由算法元件,它们在控制平面上进行交互,计算出转发表。这种方式存在很多问题,我们在 5.1 节已经介绍过了。
5.1.2 SDN 方式:逻辑上集中的控制平面
SDN 采用了一种不同的架构。它将控制平面和数据平面分离。
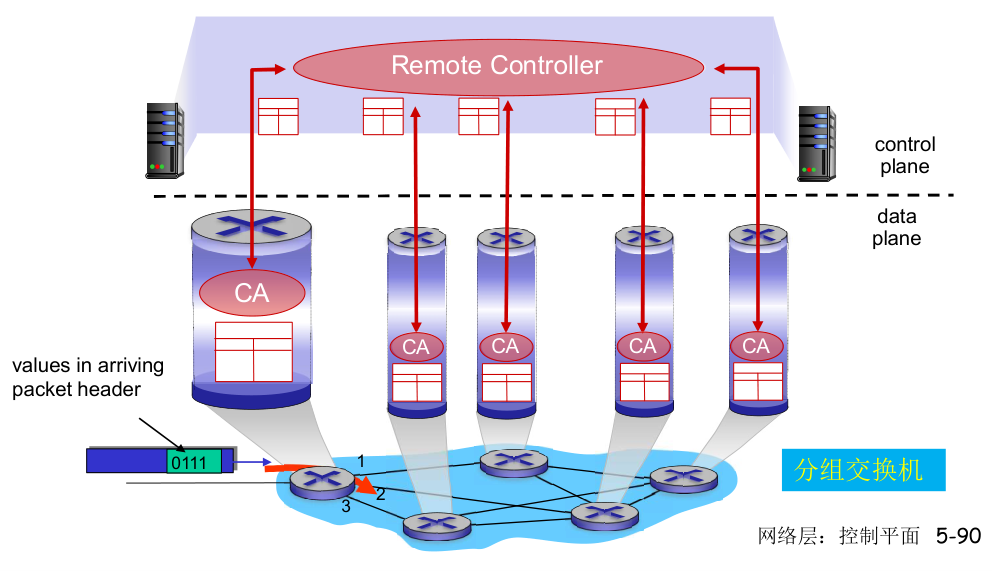
数据平面仍然由路由器(在 SDN 中常称为“交换机”)组成。但控制平面被抽离出来,形成一个逻辑上集中、通常是远程的控制器。
这个控制器通过一个定义的接口(即“南向接口”)与网络中的交换机进行交互。交换机上的“控制代理”(CA)负责与控制器通信,上报本地状态,并接收控制器下发的流表。
5.2 为何需要逻辑上集中的控制平面?
5.2.1 (1) 传统方式的弊端
我们在 5.1 节介绍 SDN 时已经见过这个幻灯片,所以我们会讲得比较快一些。
SDN 是一个仍在发展中的技术,我们只需要对它是什么以及它的大致工作原理有初步的掌握即可。
我们前面学过的几乎所有网络层功能,都是采用控制平面和数据平面垂直集成的方式,并且控制平面是通过分步式的方法去实现的。这带来了很多问题:
- 管理困难:网络中有各种各样的网络设备,配置复杂。
- 功能实现困难:采用分步式方法去实现路由等网络功能,本身就非常难,而且效率低下。
- 不利于生态发展:这种紧耦合的模式不便于促进整个网络生态的创新和发展。
传统方式下,垂直集成、分步式实现的控制平面存在诸多弊端。
5.2.2 (2) SDN 带来的优势
从 2005 年之后,出现了一种新的工作方式,即 SDN。
- 网络管理更加容易:通过集中的控制器,可以避免路由器配置错误,对基于信流的弹性更好。
- 开放的南向接口:基于开放的接口(如 OpenFlow API),允许我们拥有可编程的路由器。
- 集中式“编程”更容易:集中计算流表,然后分发到各个交换机。这比在每个独立的路由器上分别运行分步式的算法要简单得多。
- 控制平面的开放实现:催生了非私有的控制器实现。
- 新的竞争生态:带来了新的发展机遇。
5.2.3 (3) 类比:主机架到 PC 的演变
我们可以用一个类比来理解这个变革。
- 传统网络如同主机架:过去的计算机(如大型机)采用的是专用软件、专用操作系统和专用硬件。这种垂直集成的体系是封闭的,私有的,不利于创新,导致整个产业规模很小。
- SDN 如同 PC 革命:PC 的出现带来了变革。它定义了开放的接口,使得不同的厂商可以分别生产微处理器、操作系统(如 Windows, Linux, Mac OS)和应用程序(App)。
这种水平集成的开放接口,促进了快速创新,使得产业巨大。SDN 正在对网络领域做着类似的事情。
5.2.4 (4) 解决传统难题:流量工程
SDN 还能解决一些传统网络非常棘手的难题,例如流量工程(Traffic Engineering)。
传统网络的困境:
假设我们希望网络中的流量分开走:从 w 到 z 的流量走 w-x-y-z 路径,而从 x 到 y 的流量走 x-u-v-y 路径,以实现负载均衡。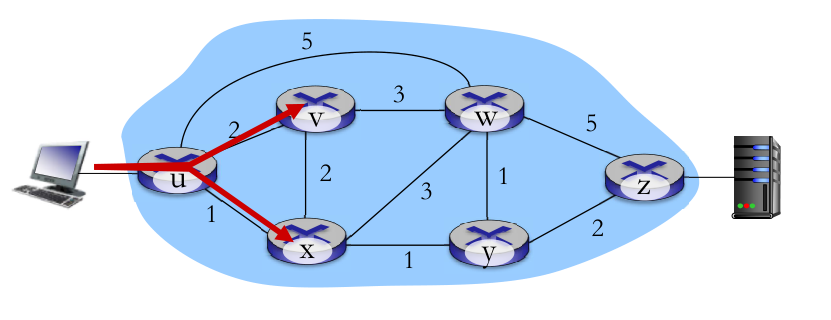
在传统 IP 路由中,这是极其困难甚至不可能的。因为 IP 路由算法(如 OSPF)只根据“目标地址”来决定下一跳。它无法区分“从 w 来的,要去 z”和“从 x 来的,要去 y”的流量(如果它们经过同一个路由器)。
即便我们使用 MPLS 或调整链路代价(权值),也无法在控制平面上实现这种基于源和目的的精细化分流。
SDN 的解决方案: 在 SDN 架构下,这变得非常容易。控制器可以定义非常精细的流表规则。这个规则不再仅仅基于“目标 IP”,而是可以基于多个头部字段的组合,例如:
- 源 IP 地址
- 目标 IP 地址
- 源端口号
- 目标端口号
- …等等
控制器可以下发这样两条规则:
{源IP=w, 目的IP=z}的流,从 x 端口转发。{源IP=x, 目的IP=y}的流,从 u 端口转发。
这样就轻松实现了流量的分流。
5.3 SDN 的四个关键特征
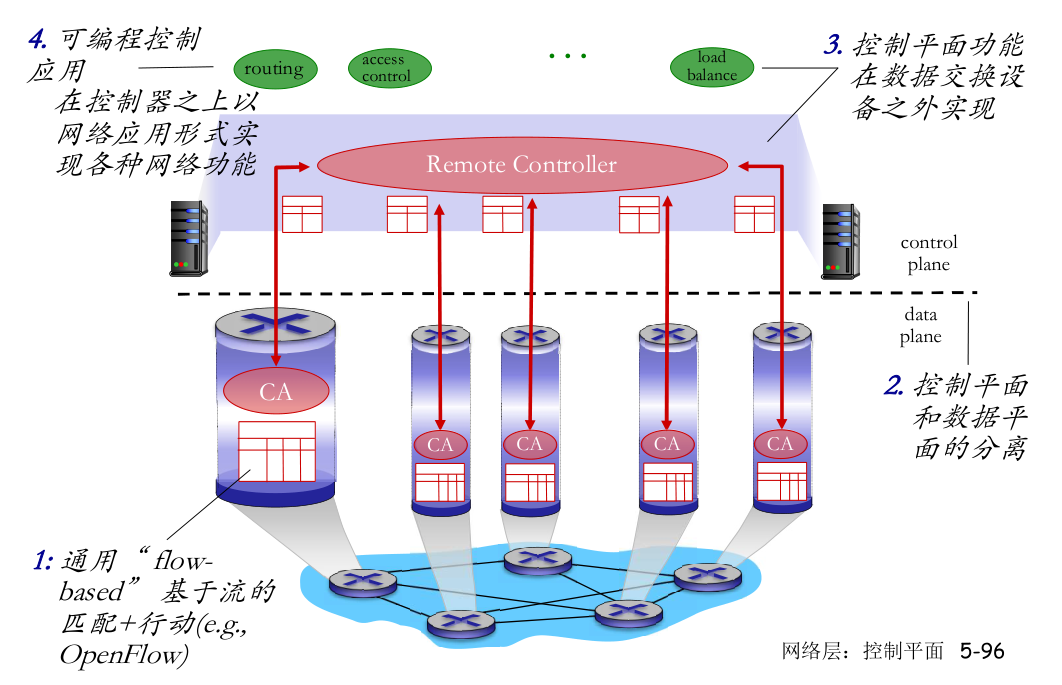
- 基于流 (Flow-based) 的转发: SDN 交换机中的转发表不再是简单的“目标地址 → 输出端口”,而是“流表”。流由数据包的多个头部字段定义。转发是一种“匹配+行动”(Match + Action)的抽象:匹配流表中的字段,然后执行相应的动作(如转发、丢弃、泛洪、修改字段等)。OpenFlow 是实现这种“通用转发”的典型标准。
- 控制平面和数据平面分离: 数据平面(交换机)和控制平面(控制器/网络 OS)是物理分离的。它们之间通过“南向接口”协议(如 OpenFlow)进行通信。
- 逻辑上集中的控制功能: SDN 控制器(或网络 OS)是一个逻辑上集中的实体。它维护着全网的状态,并为上层应用提供一个集中的网络视图。交换机只负责执行控制器下发的流表。
- 网络可编程: 网络功能是通过运行在控制器之上的“网络应用”来实现的。这些应用通过控制器的“北向接口”(NBI)来编程和控制网络行为,使得网络不再是僵化的。
5.4 SDN 架构
一个完整的 SDN 架构包含三个主要组件:数据平面交换机、SDN 控制器和控制应用。
5.4.1 (1) 数据平面交换机
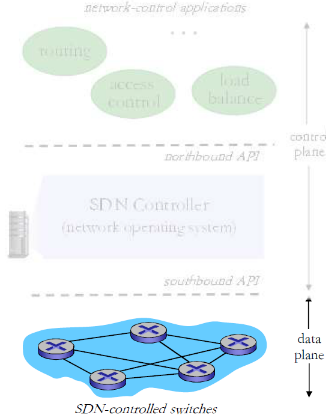
- 功能:这是网络的转发设备,功能是快速、简单。它们通常是商业化的交换设备,采用硬件来实现通用的“匹配+行动”转发功能。
- 流表:交换机中的流表是由上层的控制器计算并安装的。
- 南向 API:交换机通过南向 API(如 OpenFlow 协议)与控制器通信。这个 API 定义了控制器可以访问和控制交换机的哪些功能,也定义了两者之间的通信协议。
5.4.2 (2) SDN 控制器 (网络 OS)
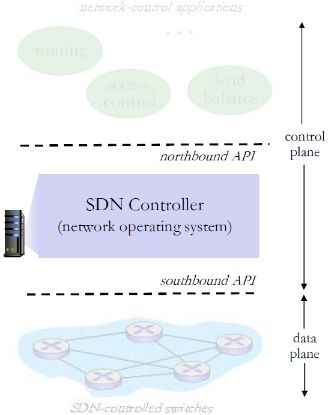
- 功能:控制器是网络的“大脑”。
- 状态维护:它通过南向接口从交换机收集信息,维护全网的状态,如链路状态、设备信息、服务统计等。
- 接口:它通过“北向 API”和上层的网络控制应用交互,通过“南向 API”和下层的网络交换机交互。
- 实现:控制器在逻辑上是集中的。但在实际实现中,为了保证高性能、可扩展性、容错性和鲁棒性,通常会采用分布式系统的方法来实现(例如,一个控制器集群)。
5.4.3 (3) 控制应用
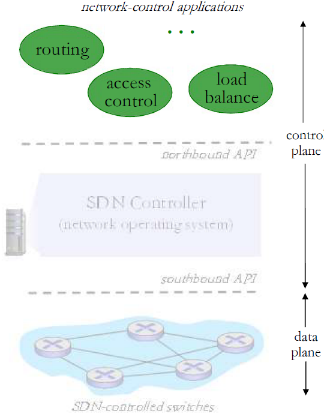
- 功能:这是控制器真正的“大脑”,也就是软件程序。它们利用控制器北向 API 提供的服务来实现具体的网络功能。【在北向接口之上】
- 例子:这些应用可以实现传统路由器的交换机功能、接入控制(防火墙)、负载均衡以及其他各种自定义功能。
- 非绑定性 (Unbundling):这是 SDN 带来的一个重要变革。这些控制应用可以由第三方提供。应用的厂商、控制器的厂商和交换机的厂商可以完全不同。这打破了传统网络设备厂商的垂直垄断,引入了新的竞争和创新生态。
5.5 SDN 控制器组成
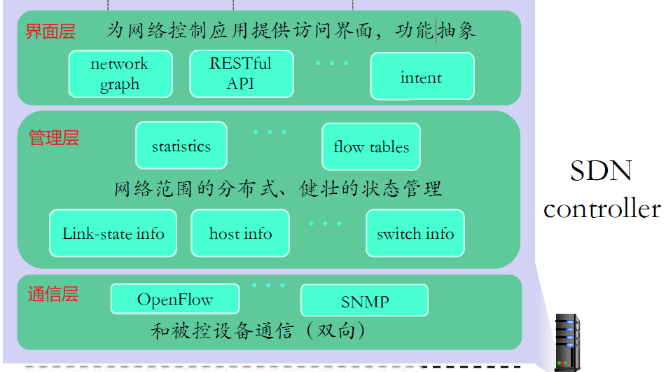
SDN 控制器内部通常也分层:
| 层级 | 说明 |
|---|---|
| 界面层 (北向) | 为上层的网络控制应用提供抽象的北向 API。【北向接口还在定义中】 |
| 管理层 (核心) | 负责网络范围的状态管理。它维护网络链路、交换设备和服务状态,通常是一个分布式数据库。 |
| 通信层 (南向) | 负责 SDN 控制器和 SDN 交换机之间进行通信。这一层也是可扩展的,除了 OpenFlow,也可以支持 SNMP 等其他协议。 |
5.6 OpenFlow 协议
5.6.1 (1) 介绍
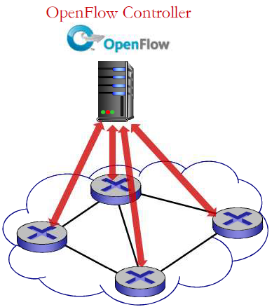
- OpenFlow 是控制器和 SDN 交换机之间交互的协议之一(南向接口协议)。
- 它通常采用 TCP 来交换报文,加密是可选的。
- 可以查询分组交换机的状态,也可以配置分组交换机
5.6.2 (2) 报文类型
OpenFlow 定义了 3 种报文类型:
- 控制器 → 交换机
- 异步(交换机 → 控制器)
- 对称 (misc):用于建立连接、心跳检测等,如 Hello, Echo request/reply。
| 报文类型 | 说明 |
|---|---|
| 特性 | 控制器 查询 交换机特性,交换机应答 |
| 配置 | 交换机查询/设置交换机的配置参数 |
| 修改状态 | 增加删除修改OpenFlow表中的流表 |
| packet-out | 控制器可以将分组通过特定的端口发出 |
| 分组进入 | 将分组(和它的控制)传给控制器,见来自控制器的packet-out报文 |
| 流移除 | 在交换机上删除流表项 |
| 端口状态 | 通告控制器端口的变化 |
5.6.2.1 一些关键的控制器到交换机的报文:
| 报文类型 | 说明 |
|---|---|
Features | 控制器查询交换机的特性和能力,交换机进行应答。 |
Configure | 控制器查询或设置交换机的配置参数。 |
Modify-State | 核心报文。用于增加、删除、修改 OpenFlow 表中的流表项。 |
Packet-out | 控制器可以通过这个报文,指示交换机将一个特定的分组(数据包)从特定的端口发送出去。 |
- 特性:控制器查询交换机特性,交换机应答
- 配置:交换机查询/设置交换机的配置参数
- 修改状态:增加删除修改OpenFlow表中的流表
- packet-out:控制器可以将分组通过特定的端口发出
5.6.2.2 一些关键的交换机到控制器的报文 (异步):
| 报文类型 | 说明 |
|---|---|
Packet-in | 核心报文。当一个分组到达交换机,但在流表中找不到任何匹配项时,交换机会将该分组(或其头部)封装在 Packet-in 报文中发送给控制器,询问如何处理。 |
Flow-removed | 当交换机上的某个流表项因超时或被删除时,通知控制器。 |
Port-status | 当交换机端口状态发生变化时(如链路断开或接通),主动通告控制器。 |
- 分组进入: 将分组(和它的控制)传给控制器,见来自控制器的packet-out报文
- 流移除: 在交换机上删除流表项
- 端口状态: 通告控制器端口的变化
补充:幸运的是,网络管理员不需要自己去手动创建和发送这些流表报文。这些复杂的操作是由运行在控制器上的“网络应用”(App)自动运算和配置的。
5.6.3 (3) 数据交互案例
我们来看一个 SDN 网络中数据交互的具体例子:
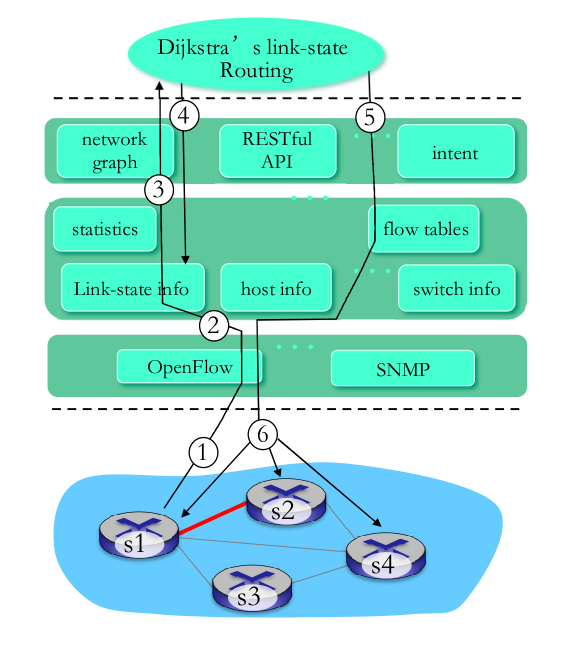
- 事件发生和上报状态:交换机 S1 发现一条链路失效。S1 采用 OpenFlow 的
Port-status(端口状态)报文,主动通告控制器链路变化。 - 控制器更新状态:SDN 控制器接收到该报文,立即更新其维护的链路状态信息库(数据库)。
- 触发应用:一个实现了 Dijkstra 路由算法的网络应用被调用。为什么?因为这个应用在之前已经向控制器注册过,它关心“链路状态变化”这类事件。
- 计算新路由:Dijkstra 应用访问控制器中的网络拓扑信息和最新的链路状态,重新计算出新的路由。
- 更新流表:该应用与控制器中的“流表计算元件”交互,计算出需要更新的流表。
- 下发流表:控制器最终采用 OpenFlow 的
Modify-State报文,在相关的交换机上安装这些新的流表项。
之后,网络就按照新的流表来转发数据了。
5.7 主流的 SDN 控制器
5.7.1 (1) OpenDaylight (ODL) 控制器
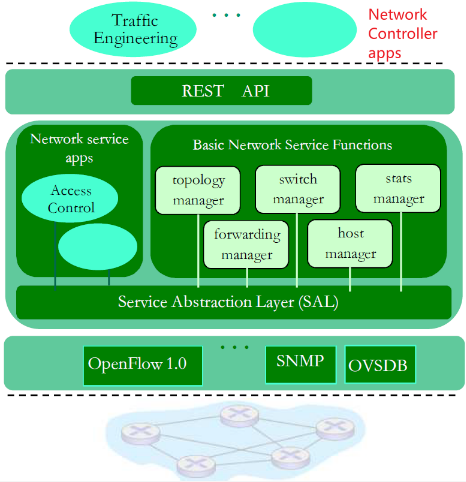
- ODL(以 Lithium 版本为例)是一个主流的控制器。
- 它的网络应用可以运行在 SDN 控制器内部,也可以运行在外部。
- 它有一个核心的“服务抽象层”(SAL),用于和内部及外部的应用/服务进行交互。
5.7.2 (2) ONOS 控制器
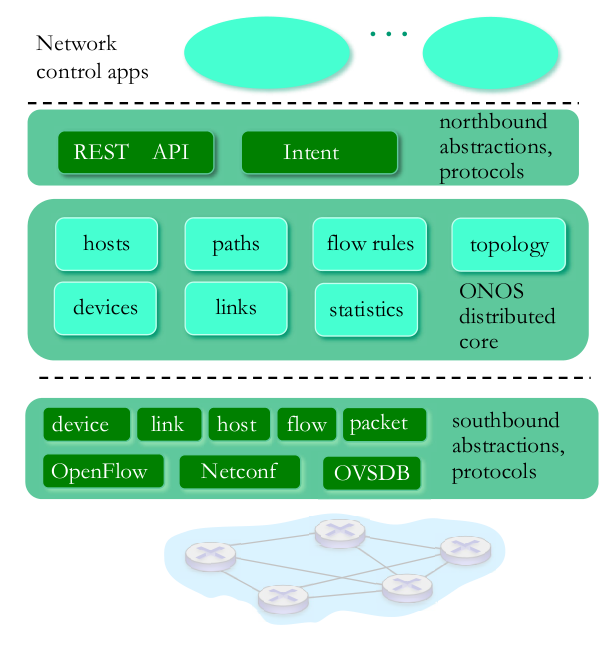
- ONOS 是另一个主流控制器,它通常将控制应用和控制器分离(应用在外部)。
- 意图框架 (Intent Framework):ONOS 的一个特色是提供了“意图框架”。这是一种服务的高级规范,允许管理员描述“什么”(What)是需要的(例如:我需要 A 和 B 之间 100M 的带宽),而不是“如何”(How)去做(例如:在 S1 上设置流表 X,在 S2 上设置流表 Y)。
- 分布式核心:ONOS 非常注重其分布式核心,以此来提高服务的可靠性、性能和可扩展性。
5.8 SDN 面临的挑战
SDN 虽然带来了很多好处,但也面临着新的挑战:
- 强化控制平面:控制平面必须是一个可信、可靠、高性能、安全的分布式系统。
- 失效的鲁棒性:当控制器或链路出现故障时,网络不能瘫痪。这需要利用强大的分布式系统理论来保证。
- 可信任与安全:必须从一开始就铸造在架构中。
- 满足特殊任务的需求:网络和协议需要满足各种特殊需求,例如实时性、超高可靠性(如工业控制)、超高安全性(如金融)。
- 网络范围的扩展性:这是目前一个巨大的挑战。SDN 目前在一个AS(自治系统,如一个运营商内部)部署是可行的,但如何将其扩展到互联网络范围(即整个互联网),实现全网部署,是一个亟待解决的问题。
6 ICMP(老师没讲)
6.1 概念和报文格式
(Internet Control Message Protocol)因特网控制报文协议
- 由主机、路由器、网关用于传达网络层控制信息
- 错误报告:主机不可到达、网络、端口、协议
- Echo 请求和回复(ping)
- ICMP处在网络层,但是是 在IP协议 的上面:ICMP消息由IP数据报承载(并且IP头部信息的上方协议也包含ICMP)
- ICMP 报文:
- 类型、编码、加上IP数据报的头8B(第一个导致该ICMP报文的IP数据报)
 /file-20251230152052745.png)
- 类型、编码、加上IP数据报的头8B(第一个导致该ICMP报文的IP数据报)
- used by hosts and routers to communicate network-level information
- error reporting: unreachable host, network, port, protocol
- echo request/reply (used by ping)
- network-layer “above” IP:
- ICMP messages carried in IP datagrams
- ICMP message: type, code plus the entire header and first 8 bytes of IP datagram payload causing error
| Type | Code | description |
|---|---|---|
| 0 | 0 | echo reply (ping) |
| 3 | 0 | dest. network unreachable |
| 3 | 1 | dest host unreachable |
| 3 | 2 | dest protocol unreachable |
| 3 | 3 | dest port unreachable |
| 3 | 6 | dest network unknown |
| 3 | 7 | dest host unknown |
| 4 | 0 | source quench (congestion control - not used) |
| 8 | 0 | echo request (ping) |
| 9 | 0 | route advertisement |
| 10 | 0 | router discovery |
| 11 | 0 | TTL expired |
| 12 | 0 | bad IP header |
6.2 工作流程
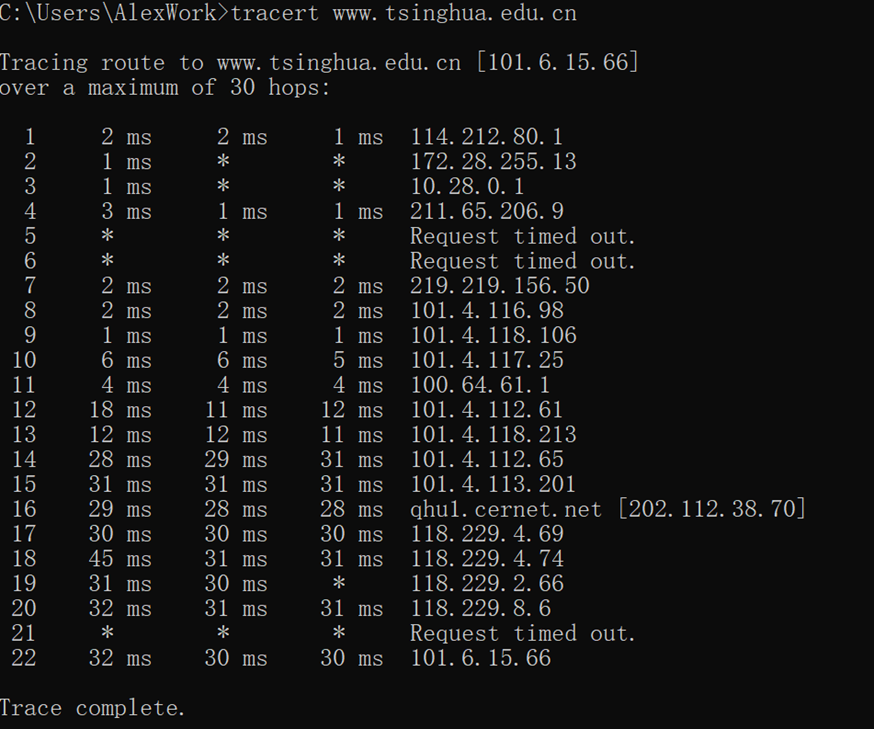
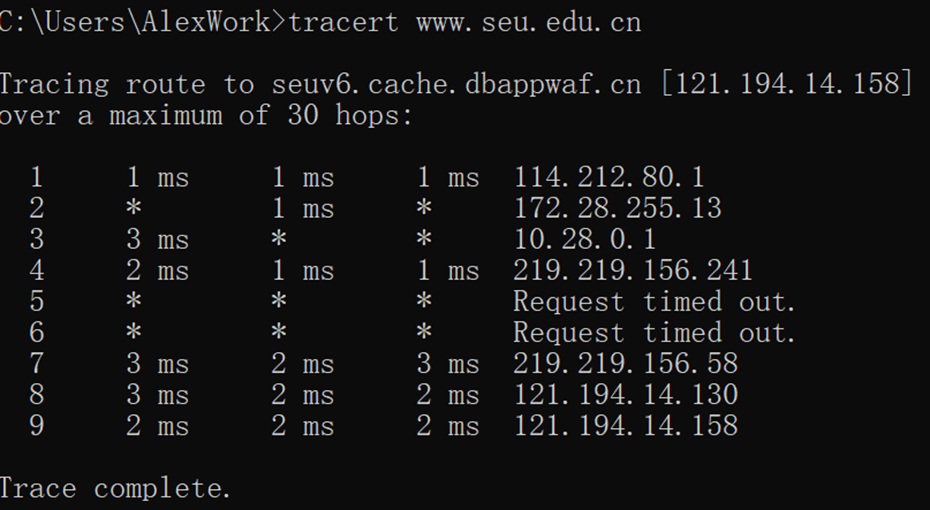
- 源主机发送一系列UDP段给目标主机
- 第一个:TTL =1
- 第二个: TTL=2, etc.
- 一个不可达的端口号
- 当第n个数据报到达第n个路由器
- TTL = 0,路由器抛弃数据报
- 然后发送一个给源的ICMP报文(type 11, code 0)
- 报文包括了路由器的名字和IP地址
- 当ICMP报文到达,源端计算RTT
- 对于一个nTraceroute做3次
- 停止的判据
- UDP 段最终到达目标主机
- 目标返回给源主机ICMP “端口不可达”报文(type 3, code 3)
- 当源主机获得这个报文时,停止
- source sends sets of UDP segments to destination
- set has TTL =1, set has TTL=2, etc.
- datagram in th set arrives to nth router:
- router discards datagram and sends source ICMP message (type 11, code 0)
- ICMP message possibly includes name of router & IP address
- when ICMP message arrives at source: record RTTs
stopping criteria:
- UDP segment eventually arrives at destination host
- destination returns ICMP “port unreachable” message (type 3, code 3)
- source stops
6.2.1 Example

7 网络管理和SNMP(略)
7.1 定义
自治系统(autonomous systems, aka “network”): 1000多个 相互的软件和硬件部件
其他复杂系统也需要被监视和控制: 如喷气飞机、核电站
“网络管理”包括了硬件、软件和人类元素的设置,综合和协 调,以便监测,测试,轮询,配置,分析,评价和控制网络 和网元资源,用合理的成本满足实时性,运行能和服务质量 的要求;
7.2 网络管理功能
| 类型 | 说明 |
|---|---|
| 性能管理 | 性能(利用率、吞吐量)量化、测量、报告、分析和控制不同网络部件的性能 涉及到的部件:单独部件(网卡,协议实体),端到端的路径 |
| 故障管理 | 记录、检测和响应故障; 性能管理为长期监测设备性能 故障管理:突然发生的强度大的性能降低,强调对故障的响应 |
| 配置管理 | 跟踪设备的配置,管理设备配置信息 |
| 账户管理 | 定义、记录和控制用户和设备访问网络资源 限额使用、给予使用的收费,以及分配资源访问权限 |
| 安全管理 | 定义安全策略,控制对网络资源的使用 |
7.3 5.7.3 网络管理架构
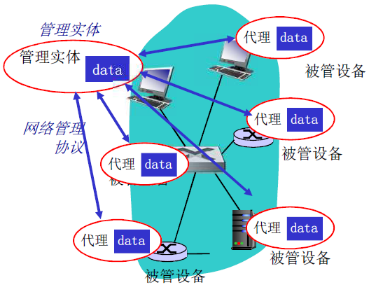
- 被管设备包含若干被管对象它们的数据被收集在Management Information Base (MIB)
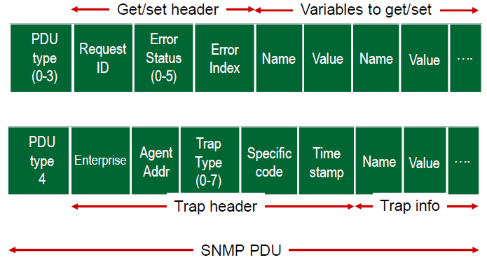
7.4 5.7.4 SNMP协议
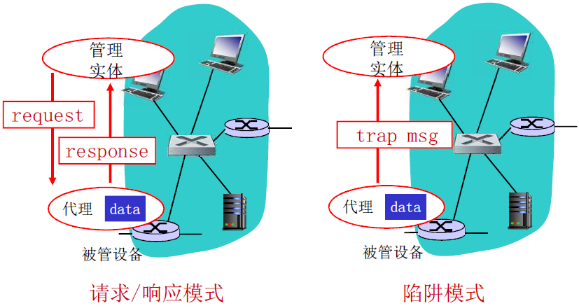
| 报文类型 | 功能 |
|---|---|
| GetRequest GetNextRequest GetBulkRequest | 管理实体-代理: “给我数据”(instance,next in list, block) |
| InformRequest | 实体-实体: 给你MIB值 |
| SetRequest | 实体-代理: set MIB value |
| Response | 代理-实体: 值,对请求的响应 |
| Trap | 代理-实体: 异常事件的报告 |